


דירוג מהיר ואמין ב-Datastore
דירוג: בעיה פשוטה אבל קשה מאוד
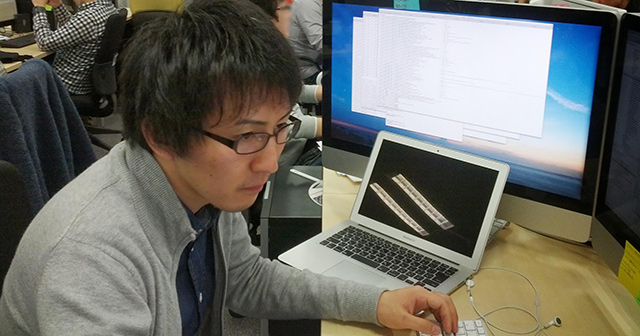
טומואקי סוזוקי (Tomoaki Suzuki) (איור 1), מהנדס מוביל ב-App Engine ב-Applibot, ניסה לפתור בעיה נפוצה מאוד אך קשה מאוד שכל שירות גיימינג גדול נתקל בה: דירוג.
Applibot היא אחת מספקיות האפליקציות החברתיות הגדולות ביפן. הייחודיות של החברה היא הידע והניסיון הרב שלה בבניית שירותי משחקים חברתיים עם יכולת הרחבה גבוהה ב-Google App Engine, פלטפורמה כשירות (PaaS) מבית Google. החברה נהנית מהיתרונות של הפלטפורמה, והצליחה לנצל הזדמנויות עסקיות בשוק משחקי הרשתות החברתיות, לא רק ביפן אלא גם בארצות הברית. אפשר לראות את ההצלחה של התכונה הזו ב-Applibot. Legend of the Cryptids (איור 2), אחד מהמשחקים הכי גדולים שלהם, הגיע למקום הראשון בקטגוריית המשחקים של Apple AppStore בצפון אמריקה באוקטובר 2012. סדרת Legend רשמה 4.7 מיליון הורדות. משחק נוסף, Gang Road, הגיע למקום הראשון בדירוג סך המכירות של AppStore ביפן בדצמבר 2012.
המשחקים האלה הצליחו להתרחב בצורה חלקה ולטפל בתנועת הגולשים הגדלה. חברת Applibot לא נאלצה להתאמץ כדי לבנות אשכולות מורכבים של שרתים וירטואליים או מסדי נתונים עם חלוקה אופקית. הם ניצלו את היכולות של App Engine והשיגו ביעילות יכולת התאמה לסדרי גודל שונים וזמינות.
עם זאת, לא קל לפתור את הבעיה של דירוג שחקנים עדכני, לא ל-Tomoaki, וכנראה לא לכל מפתח, במיוחד לא בהיקף כזה. הדרישות פשוטות:
- למשחק שלכם יש מאות אלפי שחקנים (או יותר!).
- הניקוד של השחקן משתנה בכל פעם שהוא נלחם באויבים (או מבצע פעילויות אחרות).
- אתם רוצים להציג את הדירוג העדכני של השחקן בדף של פורטל אינטרנט.
איך מחושב הדירוג?
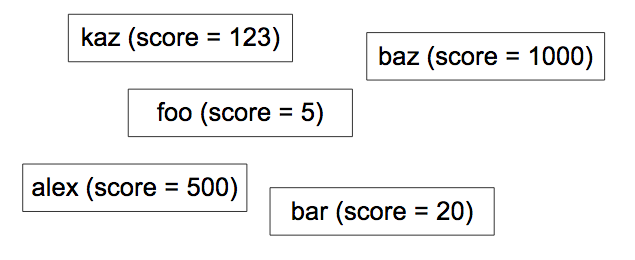
קל לקבל דירוג אם לא מצפים שהוא יהיה גם מהיר וגם ניתן להרחבה. לדוגמה, אפשר להריץ את השאילתה הבאה:
SELECT count(key) FROM Players WHERE Score > YourScore
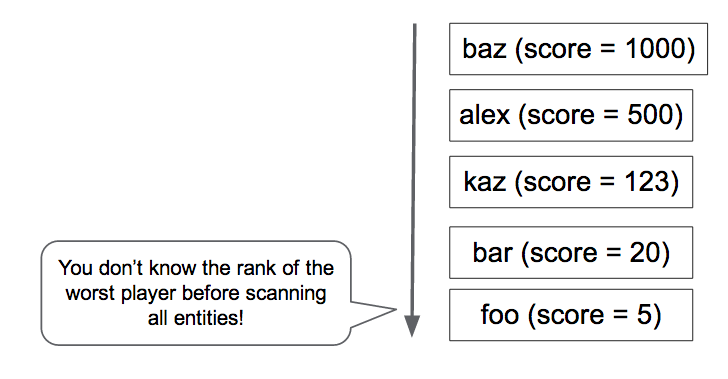
השאילתה הזו סופרת את כל השחקנים עם ציון גבוה יותר משלכם (איור 4). אבל האם רוצים להריץ את השאילתה הזו לכל בקשה מדף הפורטל? כמה זמן זה ייקח כשיש מיליון שחקנים?
טומואקי יישם את הגישה הזו בהתחלה, אבל לקח כמה שניות לקבל כל תשובה. התהליך היה איטי מדי, יקר מדי והביצועים שלו הלכו והתדרדרו ככל שהיקף השימוש גדל.
לאחר מכן, טומואקי ניסה לשמור נתוני דירוג ב-Memcache. השיטה הזו מהירה, אבל לא אמינה. יכול להיות שערכים ב-Memcache יימחקו בכל שלב, ולפעמים שירות Memcache עצמו לא יהיה זמין. כשמשתמשים בשירות דירוג שמסתמך רק על ערכי מפתח בזיכרון, קשה לשמור על עקביות וזמינות.
כפתרון זמני, טומואקי החליט להוריד את רמת השירות. במקום לחשב את הדירוג לכל בקשה, הוא הגדיר משימה מתוזמנת שסורקת ומעדכנת את הדירוג של כל שחקן פעם בשעה. כך, בקשות מדף הפורטל יכולות לקבל את דירוג השחקן באופן מיידי, אבל יכול להיות שהדירוג יהיה עד שעה אחת.
בסופו של דבר, טומואקי חיפש הטמעה של דירוג מתמשך, מהיר וניתן להרחבה, שיכולה לקבל 300 בקשות לעדכון ניקוד בשנייה ולקבל דירוג לכל שחקן תוך מאות אלפיות השנייה. כדי למצוא פתרון, טומואקי פנה לקאז סאטו, ארכיטקט פתרונות (SA) ומנהל חשבונות טכני (TAM) בצוות Google Cloud Platform, שמוקצה ל-Applibot במסגרת חוזה תמיכה ברמת פרימיום.
דרך מהירה לפתרון בעיות
הרבה לקוחות גדולים או שותפים של Google Cloud Platform, כמו Applibot, נרשמים לחוזה תמיכה ברמת פרימיום. במסגרת חוזה התמיכה הזה, בנוסף לתמיכה מסביב לשעון מצוות תמיכת הלקוחות של Cloud ולתמיכה עסקית מצוות המכירות של Cloud, Google מקצה לכל לקוח מנהל חשבונות טכני (TAM).
מנהל ה-TAM מייצג את הלקוח מול צוות ההנדסה של Google, שאחראי על בניית תשתית הענן בפועל. מנהלי TAM מבינים את המערכת והארכיטקטורה של הלקוח בפירוט, וכשהם מעלים מקרה קריטי, הם משתמשים בידע וברשת שלהם כנציגי הנדסה של Google בחברה כדי לפתור את הבעיה. מנהלי הלקוחות הטכניים יכולים להעביר בעיות לטיפול של אדריכלי פתרונות בצוות או למהנדסי תוכנה בצוות Cloud Platform. תמיכה ברמת פרימיום היא הדרך המהירה ביותר למצוא פתרון ב-Google Cloud Platform.
קאז, מנהל ה-TAM שתומך ב-Applibot, ידע שהדירוג הוא בעיה קלאסית אבל קשה לפתרון בכל שירות מבוזר שניתן להרחבה. הוא התחיל לבדוק את ההטמעות המוכרות לדירוג ב-Google Cloud Datastore ובמאגרי נתונים אחרים מסוג NoSQL, כדי למצוא פתרון שיענה על הדרישות של Applibot.
מחפשים אלגוריתם O(log n)
הפתרון הפשוט לשאילתה מחייב סריקה של כל השחקנים עם ציון גבוה יותר כדי לספור את הדירוג של שחקן אחד. מורכבות הזמן של האלגוריתם הזה היא O(n), כלומר הזמן שנדרש לביצוע השאילתה גדל באופן יחסי למספר השחקנים. בפועל, המשמעות היא שהאלגוריתם לא ניתן להרחבה. במקום זאת, אנחנו צריכים אלגוריתם O(log n) או אלגוריתם מהיר יותר, שבו הזמן יגדל רק באופן לוגריתמי ככל שמספר השחקנים יגדל.
אם למדתם פעם קורס במדעי המחשב, יכול להיות שאתם זוכרים שאלגוריתמים של עצים, כמו עצים בינאריים, עצים אדומים-שחורים או B-Trees, יכולים לבצע חיפוש של רכיב במורכבות זמן של O(log n). אפשר להשתמש באלגוריתמים של עצים גם כדי לחשב ערך מצטבר של טווח רכיבים, כמו ספירה, מקסימום/מינימום וממוצע, על ידי שמירת הערכים המצטברים בכל צומת של ענף. באמצעות הטכניקה הזו, אפשר להטמיע אלגוריתם דירוג עם ביצועים של O(log n).
קאז מצא הטמעה של אלגוריתם דירוג מבוסס-עץ בקוד פתוח ל-Datastore, שנכתב על ידי מהנדס Google: Google Code Jam Ranking Library.
הספרייה הזו מבוססת על Python וכוללת שתי שיטות:
-
SetScoreכדי להגדיר את הניקוד של שחקן. -
FindRankכדי לקבל את הדירוג של ציון מסוים.
כשיוצרים ומעדכנים זוגות של שחקן וניקוד באמצעות השיטה SetScore, ספריית הדירוג של Code Jam יוצרת עץ N-ary1. לדוגמה, נניח שיש עץ שלישוני שיכול לספור את מספר השחקנים עם ציונים בטווח 0 עד 80 (איור 5). הספרייה מאחסנת את צומת הבסיס, שמכיל שלושה מספרים, כישות אחת. כל מספר מייצג את מספר השחקנים עם ניקוד בטווחים המשניים 0 עד 26, 27 עד 53 ו-54 עד 80, בהתאמה. לצומת הבסיס יש צומת משני לכל טווח, שמכיל בתורו שלושה ערכים של שחקנים בטווחים המשניים של הטווח המשני. ההיררכיה צריכה לכלול ארבע רמות כדי לאחסן את מספר השחקנים עבור 81 ערכי ניקוד שונים.
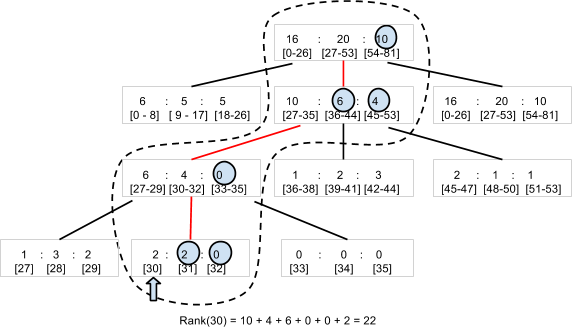
כדי לקבוע את הדירוג של שחקן עם ציון של 30, הספרייה צריכה לקרוא רק ארבע ישויות – הצמתים שמוקפים בעיגול בקו המקווקו בתרשים – כדי לספור את מספר השחקנים עם ציון גבוה מ-30. אם יש 22 שחקנים 'יותר טובים' בארבע ישויות, דירוג השחקן הוא 23.
באופן דומה, קריאה ל-SetScore צריכה לעדכן רק ארבע ישויות. גם אם יש לכם מספר גדול של תוצאות שונות, הגישה ל-Datastore תגדל רק ב-O(log n) ולא תושפע ממספר השחקנים. בפועל, בספריית הדירוג של Code Jam נעשה שימוש ב-100 (במקום 3) כמספר ברירת המחדל של הערכים לכל צומת, ולכן צריך לגשת רק לשני ישויות (או לשלוש, אם טווח הניקוד גדול מ-100,000).
קאז השתמש בכלי הפופולרי לבדיקת עומסים Apache JMeter כדי לבצע בדיקת עומסים בספריית הדירוג של Code Jam, ואישר שהספרייה מגיבה במהירות. הפונקציות SetScore ו-FindRank יכולות לסיים את העבודה שלהן תוך מאות אלפיות השנייה באמצעות אלגוריתם של עץ N-ary, שפועל במורכבות זמן של O(log n).
מגבלת העדכונים בו-זמנית מגבילה את המדרגיות
עם זאת, במהלך בדיקות העומס, קאז גילה מגבלה קריטית בספריית הדירוג של Code Jam. היכולת שלו להתרחב מבחינת קצב העברת הנתונים של העדכונים הייתה נמוכה למדי. כשהוא הגדיל את העומס לשלושה עדכונים בשנייה, הספרייה התחילה להחזיר שגיאות של ניסיון חוזר של טרנזקציה. היה ברור שהספרייה לא יכולה לעמוד בדרישה של Applibot ל-300 עדכונים בשנייה. הוא יכול לטפל רק בכ-1% מהתפוקה הזו.
למה זה קורה? הסיבה לכך היא העלות של שמירה על העקביות של העץ. ב-Datastore, צריך להשתמש בקבוצת ישויות כדי להבטיח מודל עקביות חזק כשמעדכנים כמה ישויות בטרנזקציה. אפשר לקרוא על כך במאמר איזון בין עקביות חזקה ועקביות סופית באמצעות Google Cloud Datastore. ספריית הדירוג של Code Jam משתמשת בקבוצת ישויות אחת כדי להכיל את העץ כולו, וכך לוודא שהספירות באלמנטים של העץ יהיו עקביות.
עם זאת, לקבוצת ישויות ב-Datastore יש מגבלת ביצועים. Datastore תומך רק בטרנזקציה אחת לשנייה בקבוצת ישויות. בנוסף, אם קבוצת ישויות זהה משתנה בעסקאות מקבילות, סביר להניח שהן ייכשלו ותצטרכו לנסות שוב. ספריית הדירוג של Code Jam עקבית מאוד, טרנזקציונלית ומהירה למדי, אבל היא לא תומכת בנפח גבוה של עדכונים בו-זמניים.
הפתרון של צוות Datastore: צבירת משרות
קאז נזכר שמהנדס תוכנה בצוות Datastore הזכיר טכניקה להשגת תפוקה גבוהה בהרבה מאשר עדכון אחד לשנייה בקבוצת ישויות. אפשר לעשות את זה על ידי צבירה של קבוצת עדכונים לעסקה אחת, במקום לבצע כל עדכון כעסקה נפרדת. עם זאת, מכיוון שהעסקה כוללת מספר גדול של עדכונים, כל עסקה אורכת זמן רב יותר, מה שמגדיל את הסיכוי להתנגשות מעסקאות מקבילות.
בתגובה לבקשה של קאז, צוות Datastore התחיל לדון בבעיה הזו והמליץ לנו לשקול להשתמש ב-Job Aggregation, אחד מדפוסי העיצוב שמשמשים עם Megastore.
Megastore הוא שכבת האחסון הבסיסית של Datastore, והוא מנהל את העקביות והטרנזקציות של קבוצות ישויות. המגבלה של עדכון אחד בשנייה נובעת מהשכבה הזו. מהנדסים משתמשים ב-Megastore באופן נרחב בשירותים שונים של Google, ולכן הם אוספים ומשתפים שיטות מומלצות ודפוסי עיצוב בתוך החברה כדי לבנות מערכת עקבית עם יכולת התאמה באמצעות מאגר הנתונים NoSQL הזה.
הרעיון הבסיסי של Job Aggregation הוא להשתמש בשרשור יחיד כדי לעבד קבוצה של עדכונים. מכיוון שיש רק שרשור אחד ורק טרנזקציה אחת פתוחה בקבוצת הישויות, לא יהיו כשלים בטרנזקציות בגלל עדכונים בו-זמניים. אפשר למצוא רעיונות דומים במוצרי אחסון אחרים, כמו VoltDb ו-Redis.
עם זאת, יש חיסרון בדפוס של צבירת משימות: הוא משתמש רק בשרשור אחד כדי לצבור את כל העדכונים, וזה מגביל את המהירות שבה אפשר לשלוח את העדכונים ל-Datastore. לכן, היה חשוב לקבוע אם Job Aggregation יכול לעמוד בדרישת התפוקה של Applibot של 300 עדכונים בשנייה.
צבירת משרות לפי תור משיכה
על סמך ההמלצות של צוות Datastore, קאז כתב קוד Proof of Concept (הוכחת היתכנות) שמשלב את התבנית Job Aggregation עם ספריית הדירוג Code Jam. ה-PoC כולל את הרכיבים הבאים:
- קצה קדמי: מקבל בקשות של משתמשים ומוסיף אותן כמשימות לתור משיכה (pull queue).
SetScore - תור משיכה: מקבל ומחזיק את
SetScoreבקשות העדכון מהקצה הקדמי. - קצה עורפי: מריץ לולאה אינסופית עם שרשור יחיד ששולף את בקשות העדכון מהתור ומבצע אותן באמצעות ספריית הדירוג של Code Jam.
ה-PoC יוצר תור משימות מסוג pull, שהוא סוג של תור משימות ב-App Engine שמאפשר למפתחים להטמיע עובד אחד או יותר שצורכים את המשימות שנוספו לתור. לשרת העורפי (backend instance) יש שרשור יחיד בלולאה אינסופית שממשיכה לשלוף כמה שיותר משימות (עד 1,000) מהתור. השרשור מעביר כל בקשת עדכון לספריית הדירוג של Code Jam, שמבצעת אותן כקבוצה בטרנזקציה אחת. יכול להיות שהטרנזקציה תהיה פתוחה למשך שנייה או יותר, אבל מכיוון שיש שרשור יחיד שמניע את הספרייה ואת Datastore, אין התנגשות ואין בעיה של שינוי מקביל.
מופע ה-Backend מוגדר כמודול, תכונה של App Engine שמאפשרת למפתחים להגדיר מופע של אפליקציה עם מאפיינים שונים. ב-PoC הזה, שרת ה-Backend (backend instance) מוגדר כמופע של שינוי גודל ידני. רק מופע אחד כזה פועל בכל רגע נתון.
קאז ביצע בדיקת עומס של ה-PoC באמצעות JMeter. הוא אישר שה-PoC הצליח לעבד 200 בקשות SetScore בשנייה, עם קבוצות של 500 עד 600 עדכונים לכל עסקה. הצבירה של המשרות עובדת!
חלוקת תורים (Queue Sharding) לביצועים יציבים
אבל קאז גילה בעיה נוספת. כשהוא המשיך להריץ את הבדיקה במשך כמה דקות, הוא ראה שתפוקת תור המשיכה משתנה מעת לעת (איור 6). במיוחד כשהוא המשיך להוסיף בקשות לתור עם 200 משימות בשנייה במשך כמה דקות, התור הפסיק פתאום להעביר משימות לשרת העורפי, וזמן האחזור של כל משימה גדל באופן משמעותי.
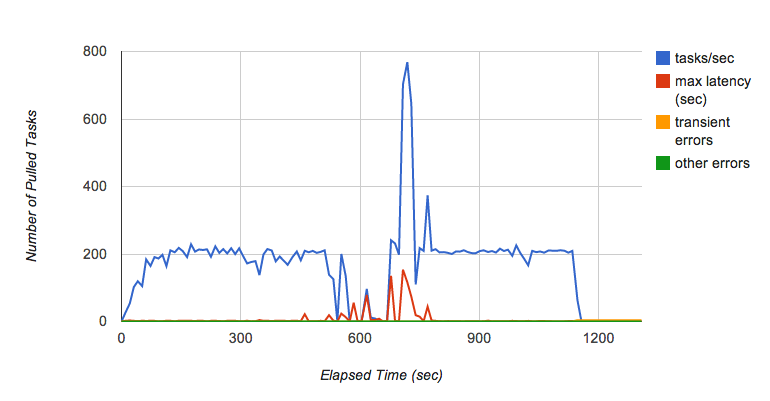
קאז התייעץ עם צוות Task Queue כדי להבין למה זה קורה. לפי צוות Task Queue, זו התנהגות מוכרת בהטמעה הנוכחית של תור למשיכת נתונים, שמסתמכת על Bigtable כשכבת העקביות שלה. כש-tablet ב-Bigtable גדל יותר מדי, הוא מתפצל לכמה tablets. בזמן שהטאבלט מפצל את המשימות, הן לא מועברות, ולכן יש תנודות בביצועים כשהתור מקבל משימות בקצב גבוה. הצוות של Task Queue פועל לשיפור מאפייני הביצועים האלה.
מייקל טאנג, ארכיטקט פתרונות, המליץ על פתרון עקיף באמצעות חלוקת תור להמתנה. במקום להשתמש רק בתור אחד, הוא הציע לפזר את העומס על כמה תורים. אפשר לאחסן כל תור בשרת טאבלטים שונה של Bigtable כדי למזער את ההשפעה של פיצול טאבלטים ולשמור על קצב עיבוד משימות גבוה. בזמן שבתור אחד מתבצע פיצול, תורים אחרים ממשיכים לפעול, והחלוקה לשברי טבלה מקטינה את העומס על כל תור, כך שפיצול של טאבלט מתרחש בתדירות נמוכה יותר.
הלולאה של שרת עורפי (backend instance) משופר מבצעת את האלגוריתם הבא:
- השכרת
SetScoreמשימות מ-10 תורים. - מבצעים קריאה ל-
SetScoresעם המשימות. - מוחקים את המשימות שהושכרו מהתורים.
בשלב 1, כל תור מספק עד 1,000 משימות, כשכל משימה מכילה שם של שחקן וציון. אחרי צבירת כל זוגות הנתונים של שחקן וניקוד במילון, בשלב 2 מועבר אצווה של עדכונים לשיטה SetScores של ספריית הדירוג של Code Jam, שפותחת טרנזקציה כדי לאחסן אותם ב-Datastore. אם לא הייתה שגיאה בהפעלת השיטה, בשלב 3 המערכת מוחקת את המשימות שהושכרו מהתורים.
אם יש שגיאה או כיבוי לא צפוי של הלולאה או של מופע הבק-אנד, משימות העדכון נשארות בתורי המשימות, כך שאפשר לעבד אותן כשהמופע מופעל מחדש. במערכת ייצור, יכול להיות שיש עוד בק-אנד שפועל כטיימר מפקח (watchdog) במצב המתנה, ומוכן להשתלט אם המכונה הראשונה תיכשל.
הפתרון המוצע: פועל ב-300 עדכונים לשנייה באופן רציף2
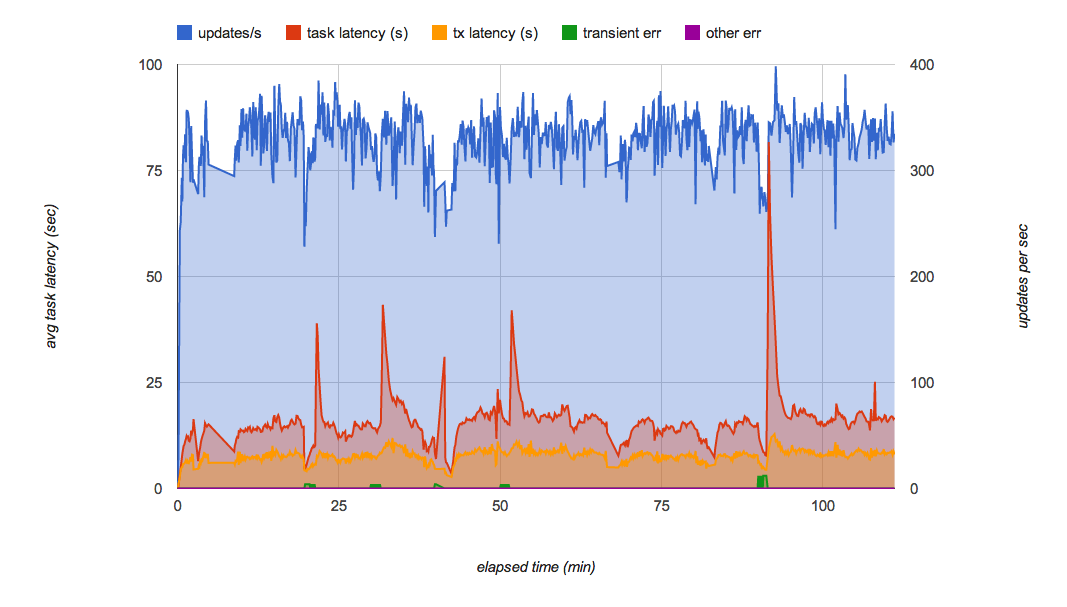
איור 7 מציג את תוצאת בדיקת העומס של ההטמעה הסופית של ה-PoC עם חלוקת התור. הוא ממזער את התנודות בביצועים בתורים ויכול לתמוך ב-300 עדכונים בשנייה במשך כמה שעות. בדרך כלל, כל עדכון מוחל על Datastore תוך כמה שניות מרגע קבלת הבקשה.
הפתרון הזה עומד בכל הדרישות המקוריות של Applibot:
- המשחק ניתן להרחבה כדי לתמוך בעשרות אלפי שחקנים.
- העדכונים מתבצעים בעסקאות ב-Datastore, ולכן הם עקביים ומתבצעים באופן רציף.
- מהיר מספיק כדי לטפל ב-300 עדכונים בשנייה.
בעזרת תוצאות בדיקת העומס וקוד ה-PoC, קאז הציג את הפתרון לטומואקי ולמהנדסים אחרים ב-Applibot. טומואקי מתכנן לשלב את הפתרון במערכת הייצור שלו, מצפה לקצר את זמן האחזור של עדכון נתוני הדירוג משעה לכמה שניות, ומקווה לשפר באופן משמעותי את חוויית המשתמש.
סיכום של עץ הדירוג עם צבירת משרות
לפתרון המוצע יש כמה יתרונות וחיסרון אחד:
יתרונות:
- מהירה:
FindRankהשיחה נמשכת כמה מאות אלפיות השנייה או פחות. - מהיר:
SetScoreרק משגר משימה, שעוברת עיבוד בשרת העורפי תוך כמה שניות. - עקביים מאוד ונשמרים ב-Datastore.
- הדירוגים מדויקים.
- אפשר לשחק עם כל מספר של שחקנים.
חסרון:
- יש מגבלה על קצב העברת הנתונים (throughput) (כ-300 עדכונים לשנייה בהטמעה הנוכחית).
הפתרון הזה משתמש בתבנית Job Aggregation, ולכן הוא מסתמך על שרשור יחיד כדי לצבור את כל העדכונים. כדי להשיג קצב העברה גבוה מ-300 עדכונים לשנייה עם עוצמת המעבד הנוכחית של מופעי App Engine וביצועי Datastore, נדרשת עבודה נוספת או מורכבות גבוהה יותר.
פתרון שניתן להרחבה בקלות רבה יותר באמצעות עץ עם שברי נתונים
אם אתם צריכים קצב עדכון גבוה עוד יותר, יכול להיות שתצטרכו לפצל את עץ הדירוג. תצטרכו ליצור כמה הטמעות של המערכת שלמעלה – קבוצה של תורים שכל אחד מהם מפעיל מודול backend שמעדכן את עץ הדירוג שלו.
בדרך כלל, אין צורך לתאם בין העצים. במקרה הפשוט ביותר, כל עדכון SetScore נשלח באופן אקראי לתור. אם יהיו שלושה עצים כאלה, שלכל אחד מהם יש קבוצת ישויות Datastore משלו ושרת קצה עורפי משלו, התפוקה הצפויה של העדכונים תהיה גדולה פי שלושה. החיסרון הוא שהפונקציה FindRank צריכה לשלוח שאילתה לכל עץ דירוג כדי לקבל את הדירוג של הציון, ואז לסכם את הדירוג מכל עץ כדי למצוא את הדירוג בפועל, ולכן התהליך ייקח קצת יותר זמן. אפשר לצמצם באופן משמעותי את זמן השאילתה של FindRank על ידי שמירת ישויות ב-Memcache.
הגישה הזו דומה לגישה המוכרת של שימוש במונים מחולקים: כל מונה מוגדל באופן עצמאי, והסכום הכולל מחושב רק כשצריך אותו בלקוח.
לדוגמה, אם יש שלושה עצים, הפונקציה FindRank(865) עשויה למצוא את שלושת הדירוגים 124, 183 ו-156, שמציינים שבכל עץ יש את המספר המתאים של ציונים גבוהים מ-865. המספר הכולל של הציונים שגבוהים מ-865 הוא 124 + 183 + 156 = 463.
הגישה הזו לא מתאימה לכל סוגי האלגוריתמים מבוזרים, אבל מכיוון שדירוג הוא בעצם בעיה של ספירה קומוטטיבית, היא אמורה להתאים לבעיות דירוג של נפח גדול.
פתרונות נוספים שניתנים להרחבה באמצעות גישות משוערות
אם האפליקציה שלכם דורשת יכולת הרחבה יותר מאשר דיוק בדרגות, ויכולה לסבול רמה מסוימת של חוסר דיוק או קירוב, תוכלו לבחור בגישות סטוכסטיות כמו:
- מאגרי מידע עם שאילתות גלובליות
- שיטת ספירה עם אובדן נתונים
- Frugal Streaming
כל הגישות המשוערות האלה הן וריאציות של רעיון אחד: איך אפשר לצמצם את נפח האחסון של נתוני הדירוג על ידי התפשרות מסוימת על דיוק הדירוג?
Buckets with Global Query הוא פתרון חלופי שהוצע על ידי צוות Datastore ואלכס איימיס, מנהל לקוח טכני. אלכס הטמיע PoC שמבוסס על הרעיון של צוות Datastore וערך ניתוח ביצועים מקיף. הוא הוכיח ש-Buckets with Global Query הוא פתרון דירוג ניתן להרחבה עם פגיעה מינימלית בדיוק הדירוג, והוא יכול להתאים לאפליקציות שדורשות תפוקה גבוהה יותר מאשר ספריית הדירוג של Code Jam. תיאור מפורט ותוצאות הבדיקה מופיעים בנספח.
שיטת הספירה עם אובדן נתונים והזרמה חסכונית הן מה שנקרא אלגוריתמים אונליין ואלגוריתמים להזרמה, שבהם אפשר להשתמש באחסון קטן מאוד בזיכרון כדי לחשב הערכה סטוכסטית של המשתמשים שמדורגים במקומות הראשונים מתוך זרם של צמדי נתונים של שחקנים וניקוד. האלגוריתמים האלה מתאימים לאפליקציות שדורשות חביון נמוך מאוד ורוחב פס גבוה מאוד, כמו אלפי עדכונים בשנייה, עם דיוק וכיסוי מוגבלים יותר של תוצאות הדירוג. לדוגמה, אם רוצים לוח בקרה בזמן אמת שמציג את 100 מילות המפתח המובילות שהוקלדו בפיד של רשת חברתית, האלגוריתמים האלה יכולים לעזור.
סיכום
דירוג הוא בעיה קלאסית, אבל קשה לפתור אותה אם נדרש שהאלגוריתם יהיה ניתן להרחבה, עקבי ומהיר. במאמר הזה תיארנו איך צוותי TAM של Google עבדו בשיתוף פעולה הדוק עם הלקוח ועם צוותי ההנדסה של Google כדי להתמודד עם האתגר ולספק פתרון שיכול לקצר את זמן האחזור של עדכון הדירוג משעה לכמה שניות. תבניות העיצוב שהתגלו בתהליך – Job Aggregation ו-Queue Sharding – יכולות לשמש גם לפתרון בעיות נפוצות בעיצובים של מערכות אחרות שמבוססות על Datastore, שנדרשים בהן מאות עדכונים בשנייה עם מודל עקביות חזק.
הערות
- ספריית הדירוג של Code Jam מקבלת פרמטר בשם branching factor (מקדם הסתעפות) שמציין כמה ציונים כל ישות תחזיק. כברירת מחדל, הספרייה משתמשת ב-100 כפרמטר. במקרה כזה, ציונים בטווח של 0 עד 9,999 יישמרו ב-100 ישויות כצאצאים של צומת הבסיס. אם אתם צריכים לטפל במגוון רחב יותר של ציונים, אתם יכולים לשנות את מקדם ההתפצלות לערך גבוה יותר כדי לבצע אופטימיזציה של מספר הגישות לישויות.
- כל נתוני הביצועים שמתוארים במאמר הזה הם ערכים מדגמיים לצורך עיון, והם לא מבטיחים ביצועים מוחלטים של App Engine, Datastore או שירותים אחרים.
נספח: קטגוריות עם פתרון שאילתות גלובלי
כמו שצוין בקטע איך מקבלים דירוג, עלות השאילתה של מסד הנתונים לכל בקשת דירוג היא גבוהה. בגישה החלופית הזו, המערכת מקבלת מעת לעת את ספירת כל הניקודים, מחשבת את הדירוג של הניקודים שנבחרו ומספקת את נקודות הנתונים האלה לשימוש בחישוב הדירוגים של שחקנים מסוימים. הטווח הכולל של הציונים מחולק ל'קטגוריות'. כל קטגוריה מאופיינת על ידי טווח משנה של ציונים ומספר השחקנים עם ציונים בטווח הזה. על סמך הנתונים האלה, אפשר למצוא את הדירוג של כל ציון בקירוב. הקטגוריות האלה דומות לצומת ברמה העליונה בעץ הדירוג, אבל במקום לרדת לצמתים מפורטים יותר, האלגוריתם הזה מבצע אינטרפולציה רק בתוך קטגוריה.
השליפה של הדירוג על ידי משתמשים מהקצה הקדמי מופרדת מחישוב הדירוג בקטגוריות בבק-אנד, כדי לצמצם את הזמן שנדרש למציאת הדירוג. כשמתקבלת בקשה לדירוג של שחקן, המערכת מאתרת את קבוצת הדירוג המתאימה על סמך הניקוד של השחקן. הקטגוריה כוללת גבול עליון של דירוג ומספר השחקנים בקטגוריה. כדי לאמוד את הדירוג של השחקנים בתוך קטגוריות, נעשה שימוש באינטרפולציה לינארית בתוך הקטגוריות. בבדיקות שלנו, הצלחנו לקבל את הדירוג של השחקן בפחות מ-400 אלפיות השנייה באופן עקבי, עבור הלוך ושוב מלא של HTTP. העלות של שיטת FindRank לא תלויה במספר השחקנים באוכלוסייה.
חישוב הדירוג של ציון נתון
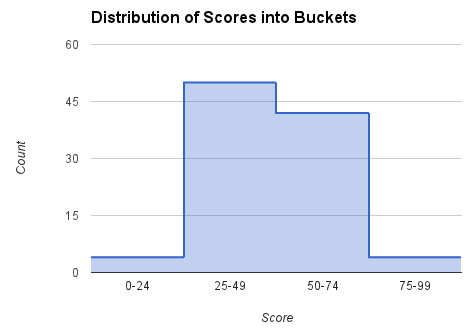
הספירה והדירוג העליון ביותר (כלומר, הדירוג הגבוה ביותר האפשרי בקבוצה הזו) מתועדים לכל קבוצה. לציונים שבין הגבולות של הציון הנמוך והציון הגבוה בדלי מסוים, אנחנו משתמשים באינטרפולציה לינארית כדי להעריך את הדירוג. לדוגמה, אם הציון של השחקן הוא 60, נבדוק את הדלי [50, 74], נשתמש בספירה (מספר השחקנים או הציונים בדלי) (42) ובדירוג העליון ביותר (5) כדי לחשב את דירוג השחקן באמצעות הנוסחה הבאה:
rank = 5 + (74 - 60)*42/(74 - 50) = 30
חישוב הספירה והטווח של כל דלי
ברקע, באמצעות משימת cron או תור משימות, המערכת מחשבת את הערכים של כל קטגוריה ושומרת אותם על ידי מעבר על כל הקטגוריות. אנחנו קוראים לזה שאילתה גלובלית, כי היא מחשבת את הפרמטרים שנדרשים להערכת הדירוגים על ידי בדיקת הניקוד של כל השחקנים. בהמשך מופיע קוד לדוגמה ב-Python שמבצע את הפעולה הזו לפי הניקוד בטווח [low_score, high_score] לכל דלי.
next_upper_rank = 1
for b in buckets:
  count = GetCountInRange(b.low_score, b.high_score)
  b.count = count
  b.upper_rank = next_upper_rank
  b.put()
  next_upper_rank += count
השיטה GetCountInRange() סופרת כל שחקן עם ציונים בטווח שמכוסה על ידי הקטגוריה. מכיוון ש-Datastore שומר על אינדקס ממוין של ציוני השחקנים, אפשר לחשב את המספר הזה בצורה יעילה.
כדי למצוא את הדירוג של שחקן מסוים, אפשר להשתמש בקוד שמוצג למטה.
b = GetBucketByScore(score)
rank = RankInBucket(b, score)
return rank + b.upper_rank - 1
השיטה GetBucketByScore(score) מאחזרת את הקטגוריה שמכילה את הניקוד שצוין. השיטה RankInBucket() מבצעת אומדן של הדירוג בתוך הקטגוריה. הדירוג של השחקן הוא סכום הדירוג העליון של הקבוצה, והדירוג בתוך הקבוצה הספציפית שכוללת את הניקוד של השחקן. צריך להחסיר 1 מהתוצאה כי הדירוג העליון ביותר של הדלי העליון יהיה 1, והדירוג של השחקן העליון בדלי מסוים יהיה גם 1.
המאגדים מאוחסנים גם ב-Datastore וגם ב-Memcache. כדי לחשב את הדירוג, המערכת קוראת את הדליים מ-Memcache (או מ-Datastore, אם הנתונים חסרים ב-Memcache). במימוש שלנו של האלגוריתם הזה, השתמשנו בספריית הלקוח Python NDB שמשתמשת ב-Memcache כדי לשמור במטמון נתונים שמאוחסנים ב-Datastore.
מכיוון שמשתמשים בדליים (או בשיטות אחרות) כדי לייצג את הנתונים בצורה קומפקטית, הדירוגים שמתקבלים לא מדויקים. הדירוגים בתוך משבצת משוערים באמצעות אינטרפולציה לינארית. אפשר להשתמש בשיטות אינטרפולציה אחרות ומדויקות יותר כדי לקבל קירוב טוב יותר בתוך הדלי, כמו נוסחת רגרסיה.
עלות
העלות של מציאת דירוג ועדכון הניקוד של שחקן היא O(1), כלומר לא תלויה במספר השחקנים.
העלות של עבודת שאילתה עם אחזור נתונים גלובלי היא O(Players) * תדירות עדכון המטמון.
העלות של חישוב נתוני הקטגוריות במשימת ה-Backend קשורה גם למספר הקטגוריות, כי מתבצעת שאילתת ספירה לכל קטגוריה. שאילתת הספירה מותאמת לשימוש בשאילתה עם מפתחות בלבד, אבל גם במקרה כזה צריך לאחזר את רשימת המפתחות המלאה.
יתרונות
השיטה הזו מהירה מאוד גם לעדכון הניקוד של שחקן וגם למציאת הדירוג של ניקוד מסוים. למרות שהתוצאות מבוססות על עבודה ברקע, אם הניקוד של שחקן משתנה, הדירוג ישתנה מיד בכיוון המתאים. הסיבה לכך היא האינטרפולציה שנעשה בה שימוש בתוך הדלי.
החישוב של הדירוג הכי גבוה בדלי מתבצע ברקע באמצעות משימה מתוזמנת, ולכן אפשר לעדכן את הניקוד של השחקן בלי לסנכרן את נתוני הדלי. לכן, הגישה הזו לא מגבילה את קצב העדכון של ניקוד השחקנים.
חסרונות
צריך לקחת בחשבון את הזמן שנדרש כדי לספור את הניקוד של כל השחקנים, לחשב את הדירוגים הגלובליים ולעדכן את הקטגוריות. בבדיקות שלנו, עם אוכלוסייה של עשרה מיליון שחקנים, הזמן היה 8 דקות ו-34 שניות במערכת הבדיקה שלנו ב-App Engine. השיטה הזו מהירה יותר מהשיטה שבה מחשבים את הדירוג של כל שחקן, אבל החיסרון שלה הוא שהיא נותנת קירוב של הציונים בכל קבוצה. לעומת זאת, אלגוריתם העץ מחשב את 'טווח הדליים' (הצומת העליון בעץ) באופן מצטבר כל כמה שניות, אבל הוא מורכב יותר להטמעה והתפוקה שלו מוגבלת.
בכל המקרים, הזמן של FindRank תלוי גם באחזור מהיר של נתונים (bucket או צמתי עץ) מ-Memcache. אם הנתונים נמחקים מ-Memcache, צריך לאחזר אותם מ-Datastore ולשמור אותם במטמון כדי שיהיו זמינים לבקשות הבאות של FindRank.
דיוק
רמת הדיוק של שיטת הדלי תלויה במספר הדליים, במיקום של השחקן ובפיזור של הציונים. באיור 9 מוצגים תוצאות המחקר שלנו לגבי הדיוק של הערכות הדירוג עם מספרים שונים של קטגוריות.
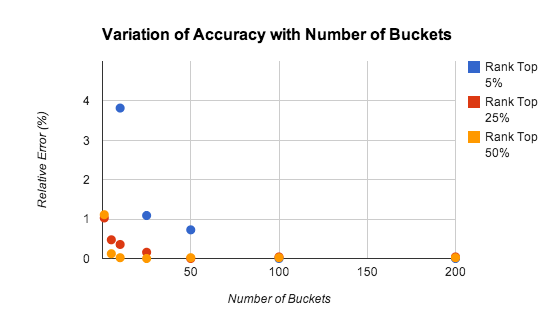
הבדיקות בוצעו עבור אוכלוסייה של 10,000 שחקנים עם ציונים שמפוזרים באופן אחיד בטווח [0-9999]. השגיאה היחסית היא בערך 1% גם אם יש רק 5 קטגוריות.
רמת הדיוק יורדת אצל שחקנים עם דירוג גבוה, בעיקר כי חוק המספרים הגדולים לא חל כשבוחנים רק את הציונים הגבוהים ביותר. במקרים רבים, מומלץ להשתמש באלגוריתם מדויק יותר כדי לשמור על הדירוגים של אלף או אלפיים השחקנים המובילים. הבעיה מצטמצמת באופן משמעותי, כי יש פחות שחקנים למעקב, ושיעור העדכונים המצטבר נמוך יותר בהתאם.
בדוגמה שלמעלה, השימוש במספרים אקראיים עם התפלגות אחידה, שבה פונקציית ההתפלגות המצטברת היא לינארית, מעודד שימוש באינטרפולציה לינארית בתוך הדלי, אבל האינטרפולציה בתוך הדליים פועלת היטב לכל התפלגות צפופה של ציונים. איור 10 מציג את הדירוג המשוער והדירוג בפועל עבור התפלגות ציונים שהיא בקירוב נורמלית.
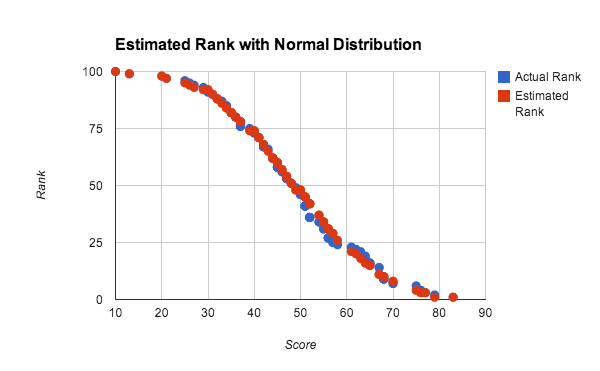
בניסוי הזה, השתמשנו באוכלוסייה של 100 שחקנים כדי לבדוק את רמת הדיוק עם מערך נתונים קטן. כל ציון נוצר על ידי חישוב הממוצע של 4 מספרים רנדומליים בין 0 ל-100, שמהווה קירוב להתפלגות נורמלית של ציונים. הדירוג המשוער חושב באמצעות שיטת השאילתות הגלובלית עם אינטרפולציה לינארית ב-10 קטגוריות. אפשר לראות שגם במערכי נתונים קטנים מאוד ובהתפלגויות לא אחידות, התוצאות טובות מאוד.