


איזון בין עקביות חזקה ועקביות סופית ב-Datastore
איך מספקים חוויית משתמש עקבית ומשתמשים במודל של עקביות סופית כדי להרחיב את השימוש במערך נתונים גדול
במאמר הזה נסביר איך אפשר להשיג מודל עקביות חזק כדי לספק חוויית משתמש חיובית, ואיך אפשר להשתמש במודל העקביות ההדרגתי של Datastore כדי לטפל בכמויות גדולות של נתונים ומשתמשים.
המאמר הזה מיועד לאדריכלי תוכנה ולמהנדסים שרוצים ליצור פתרונות ב-Datastore. כדי לעזור לקוראים שמכירים יותר מסדי נתונים רלציוניים מאשר מערכות לא רלציוניות כמו Datastore, במסמך הזה מצוינים מושגים מקבילים במסדי נתונים רלציוניים. ההנחה במסמך הזה היא שיש לכם היכרות בסיסית עם Datastore. הדרך הקלה ביותר להתחיל להשתמש ב-Datastore היא ב-Google App Engine, באמצעות אחת מהשפות הנתמכות. אם עדיין לא השתמשתם ב-App Engine, מומלץ קודם לקרוא את המדריך לתחילת העבודה ואת הקטע אחסון נתונים באחת מהשפות האלה. למרות שנעשה שימוש ב-Python בדוגמאות של קטעי קוד, לא נדרש ידע ב-Python כדי להבין את המסמך הזה.
הערה: בקטעי הקוד במאמר הזה נעשה שימוש בספריית הלקוח Python DB ל-Datastore, שכבר לא מומלצת. למפתחים שיוצרים אפליקציות חדשות מומלץ מאוד להשתמש בספריית הלקוח NDB, שיש לה כמה יתרונות בהשוואה לספריית הלקוח הזו, כמו שמירת ישויות במטמון באופן אוטומטי באמצעות Memcache API. אם אתם משתמשים כרגע בגרסה ישנה יותר של ספריית הלקוח של DB, כדאי לקרוא את המדריך להעברת נתונים מ-DB ל-NDB.
תוכן עניינים
NoSQL and Eventual Consistency
Eventual Consistency in Datastore
Ancestor Query and Entity Group
Limitations of Entity Group and Ancestor Query
Alternatives to Ancestor Queries
Minimizing Time to Achieve Full Consistency
Conclusion
Additional Resources
NoSQL ועקביות סופית
מסדי נתונים לא רלציוניים, שנקראים גם מסדי נתונים NoSQL, צצו בשנים האחרונות כחלופה למסדי נתונים רלציוניים. Datastore הוא אחד ממסדי הנתונים הלא רלציוניים הנפוצים ביותר בתעשייה. בשנת 2013, Datastore עיבד 4.5 טריליון טרנזקציות בחודש (פוסט בבלוג של Google Cloud Platform). הוא מספק למפתחים דרך פשוטה לאחסון נתונים ולגישה אליהם. מיפוי הסכימה הגמישה לשפות תסריט ולשפות מונחות-אובייקט מתבצע באופן טבעי. בנוסף, Datastore מספק מספר תכונות שמסדי נתונים רלציוניים לא מתאימים לספק בצורה אופטימלית, כולל ביצועים גבוהים בקנה מידה גדול מאוד ומהימנות גבוהה.
מפתחים שמורגלים יותר במסדי נתונים רלציוניים עלולים להתקשות בתכנון מערכת שמסתמכת על מסדי נתונים לא רלציוניים, כי יכול להיות שחלק מהמאפיינים והשיטות של מסדי נתונים לא רלציוניים לא מוכרים להם. מודל התכנות של Datastore הוא פשוט, אבל חשוב להיות מודעים למאפיינים האלה. מודל עקביות הדרגתי הוא אחד מהמאפיינים האלה, והנושא העיקרי של המסמך הזה הוא תכנות למודל עקביות הדרגתי.
מהי עקביות סופית?
מודל עקביות הדרגתי הוא הבטחה תיאורטית שאם לא יבוצעו עדכונים חדשים לישות, כל הקריאות של הישות יחזירו בסופו של דבר את הערך המעודכן האחרון. מערכת שמות הדומיינים (DNS) באינטרנט היא דוגמה מוכרת למערכת עם מודל עקביות הדרגתי. שרתי DNS לא בהכרח משקפים את הערכים העדכניים ביותר, אלא הערכים נשמרים במטמון ומשוכפלים בספריות רבות באינטרנט. לוקח זמן לשכפל ערכים ששונו לכל הלקוחות והשרתים של DNS. עם זאת, מערכת ה-DNS היא מערכת מוצלחת מאוד שהפכה לאחד היסודות של האינטרנט. הוא זמין מאוד והוכח כי הוא ניתן להרחבה באופן משמעותי, ומאפשר חיפושי שמות ביותר ממאה מיליון מכשירים באינטרנט כולו.
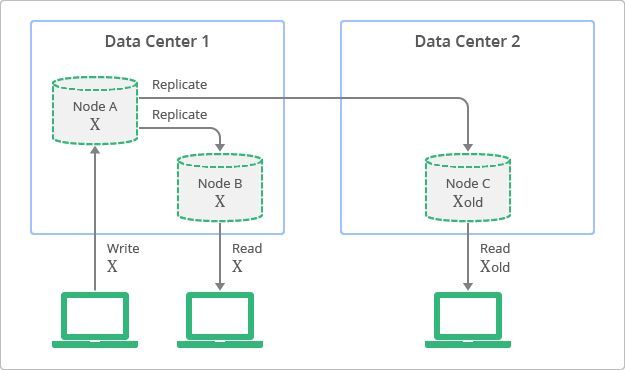
איור 1 ממחיש את הרעיון של רפליקציה עם מודל עקביות הדרגתי. התרשים מראה שעותקים תמיד זמינים לקריאה, אבל יכול להיות שחלק מהעותקים לא יהיו עקביים עם הכתיבה האחרונה בצומת המקורית, בנקודת זמן מסוימת. בתרשים, צומת א' הוא הצומת המקורי, וצומת ב' וצומת ג' הם העותקים.
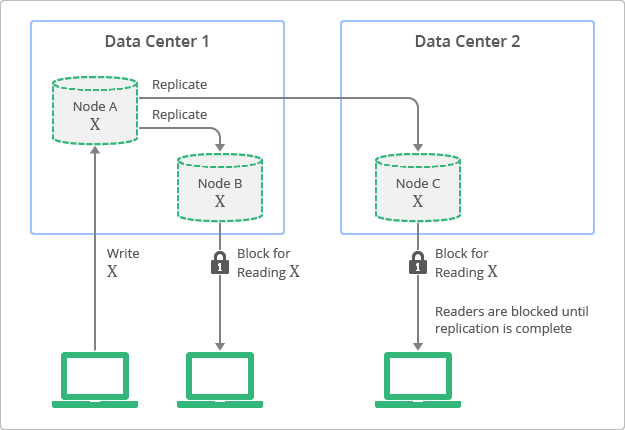
לעומת זאת, מסדי נתונים רלציוניים מסורתיים תוכננו על בסיס הרעיון של מודל עקביות חזק, שנקרא גם עקביות מיידית. כלומר, הנתונים שיוצגו מיד אחרי העדכון יהיו עקביים לכל מי שצופה בישות. המאפיין הזה היה הנחת יסוד עבור הרבה מפתחים שמשתמשים במסדי נתונים רלציוניים. עם זאת, כדי להשיג מודל עקביות חזק, המפתחים צריכים להתפשר על המדרגיות ועל הביצועים של האפליקציה שלהם. במילים פשוטות, הנתונים צריכים להיות נעולים במהלך העדכון או תהליך השכפול, כדי לוודא שאין תהליכים אחרים שמעדכנים את אותם נתונים.
איור 2 מציג תצוגה מושגית של טופולוגיית הפריסה ותהליך השכפול עם מודל עקביות חזק. בתרשים הזה אפשר לראות שלעותקים תמיד יש ערכים שתואמים לצומת המקור, אבל אי אפשר לגשת אליהם עד שהעדכון מסתיים.
איזון בין עקביות חזקה לעקביות סופית
מסדי נתונים לא רלציוניים הפכו פופולריים לאחרונה, במיוחד באפליקציות אינטרנט שדורשות מדרגיות וביצועים גבוהים עם זמינות גבוהה. מסדי נתונים לא רלציוניים מאפשרים למפתחים לבחור איזון אופטימלי בין מודל עקביות חזק למודל עקביות הדרגתי לכל אפליקציה. כך המפתחים יכולים ליהנות מהיתרונות של שני העולמות. לדוגמה, מידע כמו 'לדעת מי ברשימת החברים שלך מחובר לאינטרנט בזמן נתון' או 'לדעת כמה משתמשים סימנו לייק לפוסט שלך' הם תרחישי שימוש שלא נדרש בהם מודל עקביות חזק. אפשר לספק מדרגיות וביצועים לתרחישי השימוש האלה באמצעות מודל עקביות הדרגתי. תרחישי שימוש שבהם נדרש מודל עקביות חזק כוללים מידע כמו 'האם משתמש סיים את תהליך החיוב' או 'מספר הנקודות ששחקן הרוויח במהלך סשן קרב'.
כדי להכליל את הדוגמאות שצוינו, תרחישי שימוש עם מספרים גדולים מאוד של ישויות מצביעים לעיתים קרובות על כך שמודל עקביות הדרגתי הוא המודל הטוב ביותר. אם יש מספר גדול מאוד של תוצאות בשאילתה, יכול להיות שהכללה או אי-הכללה של ישויות ספציפיות לא ישפיעו על חוויית המשתמש. מצד שני, תרחישי שימוש עם מספר קטן של ישויות והקשר מצומצם מצביעים על כך שנדרש מודל עקביות חזק. חוויית המשתמש תושפע כי ההקשר יאפשר למשתמשים לדעת אילו ישויות צריך לכלול או להחריג.
לכן חשוב למפתחים להבין את המאפיינים הלא-רלציוניים של Datastore. בקטעים הבאים נסביר איך אפשר לשלב בין מודלים של מודל עקביות הדרגתי ומודל עקביות חזק כדי לבנות אפליקציה עם יכולת הרחבה, זמינות גבוהה וביצועים גבוהים. במקרה כזה, עדיין תעמדו בדרישות העקביות שנועדו להבטיח חוויית משתמש חיובית.
עקביות סופית ב-Datastore
כשנדרש תצוגת נתונים עקבית מאוד, צריך לבחור את ה-API הנכון. בטבלה 1 מוצגים סוגים שונים של ממשקי API לשאילתות ב-Datastore והמודלים התואמים של עקביות.
|
Datastore API |
קריאה של ערך הישות |
קריאה של אינדקס |
|---|---|---|
|
מודל עקביות הדרגתי |
מודל עקביות הדרגתי |
|
|
לא רלוונטי |
מודל עקביות הדרגתי |
|
|
מודל עקביות חזק |
מודל עקביות חזק |
|
|
חיפוש לפי מפתח (get()) |
מודל עקביות חזק |
לא רלוונטי |
שאילתות Datastore ללא ישות אב נקראות שאילתות גלובליות והן מיועדות לעבודה עם מודל עקביות הדרגתי. ההגדרה הזו לא מבטיחה מודל עקביות חזק. שאילתה גלובלית עם מפתחות בלבד היא שאילתה גלובלית שמחזירה רק את המפתחות של ישויות שתואמות לשאילתה, ולא את ערכי המאפיינים של הישויות. שאילתא לגבי ישות אב מגדירה את היקף השאילתה על סמך ישות אב. בקטעים הבאים מוסבר בהרחבה על כל התנהגות עקבית.
עקביות סופית בקריאת ערכי ישויות
למעט שאילתות של ישויות אב, יכול להיות שערך מעודכן של ישות לא יהיה גלוי מיד כשמבצעים שאילתה. כדי להבין את ההשפעה של מודל עקביות הדרגתי כשקוראים ערכי ישויות, כדאי לעיין בתרחיש שבו לישות Player יש מאפיין Score. לדוגמה, נניח שהערך של הניקוד הראשוני הוא 100. אחרי זמן מה, ערך הניקוד מתעדכן ל-200. אם מריצים שאילתה גלובלית והיא כוללת את אותה ישות Player בתוצאה, יכול להיות שהערך של המאפיין Score של הישות שמוחזרת לא ישתנה ויופיע כ-100.
ההתנהגות הזו נובעת מהשכפול בין שרתי Datastore. השכפול מנוהל על ידי Bigtable ו-Megastore, הטכנולוגיות הבסיסיות של Datastore (בקטע מקורות מידע נוספים יש פרטים נוספים על Bigtable ו-Megastore). השכפול מתבצע באמצעות אלגוריתם Paxos, שמחכה באופן סינכרוני עד שרוב העותקים יאשרו את בקשת העדכון. הרפליקה מתעדכנת בנתונים מהבקשה אחרי פרק זמן מסוים. התקופה הזו בדרך כלל קצרה, אבל אין הבטחה לגבי האורך שלה בפועל. אם שאילתה מופעלת לפני שהעדכון מסתיים, יכול להיות שהיא תקרא את הנתונים הישנים.
ברוב המקרים, העדכון יגיע לכל העותקים במהירות רבה. עם זאת, יש כמה גורמים שעלולים להאריך את הזמן שנדרש להשגת עקביות. הגורמים האלה כוללים אירועים שמתרחשים במרכזי נתונים וכוללים מעבר של מספר גדול של שרתים בין מרכזי נתונים. בגלל השונות של הגורמים האלה, אי אפשר לספק דרישות זמן חד-משמעיות להשגת עקביות מלאה.
בדרך כלל, הזמן שנדרש לשאילתה כדי להחזיר את הערך האחרון הוא קצר מאוד. עם זאת, במקרים נדירים שבהם זמן האחזור של השכפול עולה, יכול להיות שהזמן יהיה ארוך יותר. צריך לתכנן בקפידה אפליקציות שמשתמשות בשאילתות גלובליות של Datastore כדי לטפל במקרים האלה בצורה חלקה.
כדי להימנע מהתופעה של מודל עקביות הדרגתי בקריאת ערכי ישויות, אפשר להשתמש בשאילתה של מפתחות בלבד, בשאילתא לגבי ישות אב או בחיפוש לפי מפתח (השיטה get()). בהמשך נדון בסוגים השונים של השאילתות.
עקביות סופית בקריאת אינדקס
יכול להיות שאינדקס עדיין לא יעודכן כשמריצים שאילתה גלובלית. המשמעות היא שגם אם תוכלו לקרוא את ערכי המאפיינים העדכניים של הישויות, יכול להיות שהרשימה של הישויות שכלולה בתוצאת השאילתה תסונן על סמך ערכי אינדקס ישנים.
כדי להבין את ההשפעה של מודל עקביות הדרגתי על קריאת אינדקס, נדמיין תרחיש שבו ישות חדשה, Player, מוכנסת ל-Datastore. לישות יש מאפיין, Score, עם ערך התחלתי של 300. מיד אחרי ההוספה, מריצים שאילתה של מפתחות בלבד כדי לאחזר את כל הישויות עם ערך Score שגדול מ-0. אחרי ההוספה, אתם מצפים שהישות Player תופיע בתוצאות השאילתה. יכול להיות שבמקום זאת, באופן לא צפוי, תגלו שהיישות Player לא מופיעה בתוצאות. המצב הזה יכול לקרות כשטבלת האינדקס של מאפיין הניקוד לא מתעדכנת עם הערך החדש שהוזן בזמן ההפעלה של השאילתה.
חשוב לזכור שכל השאילתות ב-Datastore מופעלות מול טבלאות אינדקס, אבל העדכונים בטבלאות האינדקס הם אסינכרוניים. כל עדכון של ישות מורכב למעשה משני שלבים. בשלב הראשון, שלב האישור, מתבצעת כתיבה ליומן העסקאות. בשלב השני, הנתונים נכתבים והאינדקסים מתעדכנים. אם שלב השמירה מצליח, מובטח שגם שלב הכתיבה יצליח, אבל יכול להיות שהוא לא יקרה באופן מיידי. אם תבצעו שאילתה על ישות לפני שהאינדקסים יעודכנו, יכול להיות שתראו נתונים שעדיין לא עקביים.
כתוצאה מתהליך דו-שלבי זה, יש עיכוב בזמן עד שהעדכונים האחרונים לישויות נראים בשאילתות גלובליות. בדומה למודל עקביות הדרגתי של ערכי ישויות, בדרך כלל יש עיכוב קצר, אבל הוא יכול להיות ארוך יותר (אפילו דקות או יותר בנסיבות חריגות).
אותו הדבר יכול לקרות גם אחרי עדכונים. לדוגמה, נניח שעדכנתם ישות קיימת, Player, עם ערך מאפיין חדש Score של 0, והפעלתם את אותה שאילתה מיד לאחר מכן. הייתם מצפים שהישות לא תופיע בתוצאות השאילתה כי ערך הניקוד החדש של 0 יגרום להחרגה שלה. עם זאת, בגלל אותו אופן פעולה של עדכון אינדקס אסינכרוני, עדיין יכול להיות שהישות תיכלל בתוצאה.
כדי להימנע משימוש במודל עקביות הדרגתי בקריאת אינדקס, צריך להשתמש בשאילתא לגבי ישות אב או בשיטת חיפוש לפי מפתח. אי אפשר למנוע את ההתנהגות הזו באמצעות שאילתה עם מפתחות בלבד.
עקביות גבוהה בקריאת ערכים ואינדקסים של ישויות
ב-Datastore יש רק שני ממשקי API שמספקים תצוגה עקבית מאוד לקריאת ערכי ישויות ואינדקסים: (1) שיטת החיפוש לפי מפתח ו-(2) שאילתא לגבי ישות אב. אם הלוגיקה של האפליקציה דורשת עקביות חזקה, המפתח צריך להשתמש באחת מהשיטות האלה כדי לקרוא ישויות מ-Datastore.
Datastore מיועד במיוחד לספק מודל עקביות חזק בממשקי ה-API האלה. כשמתקשרים לאחד מהם, Datastore יבצע ניקוי של כל העדכונים שממתינים באחת מהרפליקות ובטבלאות האינדקס, ואז יבצע את החיפוש או את שאילתת האב. לכן, הערך האחרון של הישות, שמבוסס על טבלת האינדקס המעודכנת, תמיד יוחזר עם ערכים שמבוססים על העדכונים האחרונים.
החיפוש לפי מפתח, בניגוד לשאילתות, מחזיר רק ישות אחת או קבוצה של ישויות שצוינו על ידי מפתח או קבוצה של מפתחות. כלומר, שאילתא לגבי ישות אב היא הדרך היחידה ב-Datastore לעמוד בדרישה של מודל עקביות חזק יחד עם דרישה של סינון. עם זאת, שאילתות של צאצאים לא פועלות בלי לציין קבוצת ישויות.
שאילתא לגבי ישות אב וקבוצת ישויות
כמו שצוין בתחילת המסמך הזה, אחד היתרונות של Datastore הוא שמפתחים יכולים למצוא איזון אופטימלי בין מודל עקביות חזק למודל עקביות הדרגתי. ב-Datastore, קבוצת ישויות היא יחידה עם מודל עקביות חזק, תכונות של טרנזקציות ומקומיות. באמצעות קבוצות ישויות, מפתחים יכולים להגדיר את היקף מודל העקביות החזק בין הישויות באפליקציה. כך האפליקציה יכולה לשמור על עקביות בתוך קבוצת הישויות, ובו-זמנית להשיג רמת ביצועים גבוהה, זמינות גבוהה ויכולת הרחבה גבוהה כמערכת שלמה.
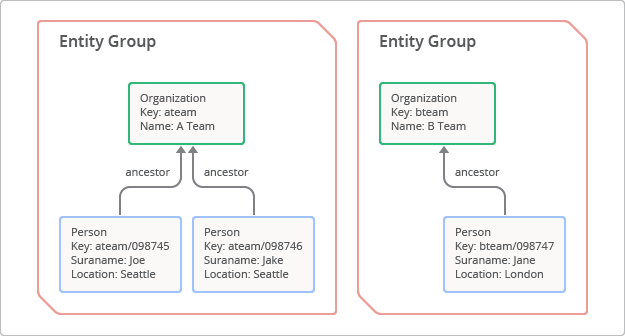
קבוצת ישויות היא היררכיה שמורכבת מישות בסיסית (root) ומהצאצאים או מהיורשים שלה.[1] כדי ליצור קבוצת ישויות, מפתח מציין נתיב של ישות אב, שהוא למעשה סדרה של מפתחות אב שמופיעים לפני מפתח הבן. איור 3 ממחיש את הרעיון של קבוצת ישויות. במקרה הזה, לישות שורש עם המפתח ateam יש שני צאצאים עם המפתחות ateam/098745 ו-ateam/098746.
בתוך קבוצת הישות, המאפיינים הבאים מובטחים:
-
עקביות חזקה
- שאילתא לגבי ישות אב בקבוצת הישויות תחזיר תוצאה עקבית מאוד. כך, הוא משקף את הערכים העדכניים ביותר של הישות, מסוננים לפי מצב האינדקס העדכני ביותר.
-
תכונות של עסקאות
- על ידי סימון עסקה באופן פרוגרמטי, קבוצת הישויות מספקת מאפייני ACID (אטומיות, עקביות, בידוד ועמידות) בעסקה.
-
Locality
- ישויות בקבוצת ישויות מאוחסנות במקומות קרובים פיזית בשרתי Datastore, כי כל הישויות ממוינות ומאוחסנות לפי הסדר הלקסיקוגרפי של המפתחות. כך אפשר לבצע סריקה מהירה של קבוצת הישויות באמצעות שאילתא לגבי ישות אב, עם מינימום פעולות קלט/פלט.
שאילתא לגבי ישות אב היא סוג מיוחד של שאילתא שמופעלת רק על קבוצת ישויות שצוינה. היא פועלת בעקביות גבוהה. מאחורי הקלעים, Datastore מוודא שכל השכפולים והעדכונים של האינדקסים שבהמתנה יוחלו לפני ביצוע השאילתה.
דוגמה לשאילתת אב
בקטע הזה מוסבר איך להשתמש בפועל בקבוצות ישויות ובשאילתות של ישויות אב. בדוגמה הבאה, נתייחס לבעיה של ניהול רשומות נתונים של אנשים. נניח שיש לנו קוד שמוסיף ישות מסוג מסוים, ואחריו מיד שאילתה על אותו סוג. הדוגמה הבאה של קוד Python ממחישה את הרעיון הזה.
# Define the Person entity
class Person(db.Model):
    given_name = db.StringProperty()
    surname = db.StringProperty()
    organization = db.StringProperty()
# Add a person and retrieve the list of all people
class MainPage(webapp2.RequestHandler):
    def post(self):
        person = Person(given_name='GI', surname='Joe', organization='ATeam')
        person.put()
        q = db.GqlQuery("SELECT * FROM Person")
        people = []
        for p in q.run():
            people.append({'given_name': p.given_name,
                        'surname': p.surname,
                        'organization': p.organization})
הבעיה בקוד הזה היא שברוב המקרים, השאילתה לא תחזיר את הישות שנוספה בהצהרה שמעליה. מכיוון שהשאילתה מופיעה בשורה שאחרי ההוספה, האינדקס לא יעודכן כשהשאילתה תופעל. עם זאת, יש גם בעיה בתוקף של תרחיש השימוש הזה: האם באמת יש צורך להחזיר רשימה של כל האנשים בדף אחד ללא הקשר? מה קורה אם יש מיליון אנשים? הדף יחזיר תשובה אחרי זמן רב מדי.
אופי תרחיש השימוש מצביע על כך שכדאי לספק הקשר מסוים כדי לצמצם את השאילתה. בדוגמה הזו, ההקשר שבו נשתמש יהיה הארגון. אם נעשה את זה, נוכל להשתמש בארגון כקבוצת ישויות ולהריץ שאילתא לגבי ישות אב, וכך לפתור את בעיית העקביות. הדוגמה הבאה מציגה קוד Python.
class Organization(db.Model):
    name = db.StringProperty()
class Person(db.Model):
    given_name = db.StringProperty()
    surname = db.StringProperty()
class MainPage(webapp2.RequestHandler):
    def post(self):
        org = Organization.get_or_insert('ateam', name='ATeam')
        person = Person(parent=org)
        person.given_name='GI'
        person.surname='Joe'
        person.put()
        q = db.GqlQuery("SELECT * FROM Person WHERE ANCESTOR IS :1 ", org)
        people = []
        for p in q.run():
            people.append({'given_name': p.given_name,
                        'surname': p.surname})
הפעם, כשישות האב מצוינת ב-GqlQuery, השאילתה מחזירה את הישות שנוספה זה עתה. אפשר להרחיב את הדוגמה כדי להציג פירוט על אדם מסוים על ידי שליחת שאילתה לגבי השם של האדם עם ישות האב כחלק מהשאילתה. לחלופין, אפשר לשמור את מפתח הישות ואז להשתמש בו כדי לבצע חיתוך לפי מפתח.
שמירה על עקביות בין Memcache לבין Datastore
אפשר גם להשתמש בקבוצות של ישויות כיחידה לשמירה על עקביות בין רשומות Memcache לבין ישויות Datastore. לדוגמה, נניח שאתם סופרים את מספר האנשים בכל צוות ומאחסנים אותם ב-Memcache. כדי לוודא שהנתונים שבמטמון עקביים עם הערכים העדכניים ב-Datastore, אפשר להשתמש במטא-נתונים של קבוצת ישויות. הנתונים של המטא-נתונים מחזירים את מספר הגרסה האחרונה של קבוצת ישויות שצוינה. אפשר להשוות את מספר הגרסה למספר שמאוחסן ב-Memcache. באמצעות השיטה הזו, אפשר לזהות שינוי בכל אחת מהישויות בקבוצת הישויות כולה על ידי קריאה ממערך אחד של מטא-נתונים, במקום לסרוק את כל הישויות הנפרדות בקבוצה.
מגבלות של קבוצת ישויות ושאילתת ישויות אב
הגישה של שימוש בקבוצות ישויות ובשאילתות של ישויות אב היא לא פתרון קסם. בפועל, יש שני אתגרים שמקשים על יישום הטכניקה באופן כללי, כמו שמפורט בהמשך.
- יש מגבלה של עדכון אחד בשנייה לכל קבוצת ישויות.
- אי אפשר לשנות את הקשר בין קבוצות הישויות אחרי שיוצרים את הישות.
מגבלת כתיבה
אתגר חשוב הוא שהמערכת צריכה להיות מתוכננת כך שתכיל את מספר העדכונים (או העסקאות) בכל קבוצת ישויות. המגבלה הנתמכת היא עדכון אחד בשנייה לכל קבוצת ישויות.[2] אם מספר העדכונים צריך לחרוג מהמגבלה הזו, יכול להיות שקבוצת הישויות תהווה צוואר בקבוק בביצועים.
בדוגמה שלמעלה, כל ארגון עשוי להזדקק לעדכן את הרשומה של כל אדם בארגון. נניח שיש 1,000 אנשים בצוות, וכל אחד מהם יכול לעדכן נתונים בנכס כלשהו פעם בשנייה. כתוצאה מכך, יכול להיות שיהיו עד 1,000 עדכונים בשנייה בקבוצת הישויות, וזה לא אפשרי בגלל מגבלת העדכונים. הדוגמה הזו ממחישה את החשיבות של בחירת עיצוב מתאים לקבוצת ישויות, שמתחשב בדרישות הביצועים. זה אחד האתגרים במציאת האיזון האופטימלי בין מודל עקביות הדרגתי למודל עקביות חזק.
אי אפשר לשנות את הקשרים בין קבוצות ישויות
אתגר נוסף הוא חוסר היכולת לשנות את הקשרים בין קבוצות ישויות. הקשר בין קבוצות הישויות נוצר באופן סטטי על סמך שמות המפתחות. אי אפשר לשנות את ההגדרה הזו אחרי שיוצרים את היישות. האפשרות היחידה שזמינה לשינוי הקשר היא למחוק את הישויות בקבוצת ישויות וליצור אותן מחדש. הבעיה הזו מונעת מאיתנו להשתמש בקבוצות של ישויות כדי להגדיר באופן דינמי היקפים אד-הוקיים לצורך עקביות או טרנזקציות. במקום זאת, היקף העקביות והטרנזקציות קשור קשר הדוק לקבוצת הישויות הסטטיות שהוגדרה בזמן העיצוב.
לדוגמה, נניח שרוצים לבצע העברה בנקאית בין שני חשבונות בנק. תרחיש עסקי כזה מחייב מודל עקביות חזק ושימוש בטרנזקציות. עם זאת, אי אפשר לקבץ את שני החשבונות לקבוצת ישויות אחת ברגע האחרון, או להסתמך על חברת אם גלובלית. קבוצת הישויות הזו תיצור צוואר בקבוק במערכת כולה, שימנע את הביצוע של בקשות אחרות להעברה בנקאית. לכן אי אפשר להשתמש בקבוצות ישויות בצורה הזו.
יש דרך חלופית להטמיע העברה בנקאית בצורה זמינה וניתנת להרחבה. במקום להציב את כל החשבונות בקבוצת ישויות אחת, אפשר ליצור קבוצת ישויות לכל חשבון. כך תוכלו להשתמש ב עסקאות כדי לוודא שמתבצעים עדכונים של ACID בשני חשבונות הבנק. טרנזקציות הן תכונה של Datastore שמאפשרת ליצור קבוצות של פעולות עם מאפייני ACID לעד 25 קבוצות ישויות. שימו לב שבתוך עסקה, צריך להשתמש בשאילתות עם עקביות חזקה, כמו חיפושים לפי מפתח ושאילתות של צאצאים. מידע נוסף על הגבלות בנושא עסקאות זמין במאמר עסקאות וקבוצות ישויות.
חלופות לשאילתות לגבי ישות אב
אם כבר יש לכם אפליקציה קיימת עם מספר גדול של ישויות שמאוחסנות ב-Datastore, יכול להיות שיהיה לכם קשה לשלב בהמשך קבוצות של ישויות בתרגיל של שינוי מבנה הקוד. כדי לעשות את זה, צריך למחוק את כל הישויות ולהוסיף אותן במסגרת קשר גומלין של קבוצת ישויות. לכן, כשמבצעים מידול נתונים ב-Datastore, חשוב לקבל החלטה לגבי עיצוב קבוצת הישויות בשלב מוקדם של עיצוב האפליקציה. אחרת, יכול להיות שתהיו מוגבלים בשינוי מבנה הקוד לאפשרויות אחרות כדי להשיג רמה מסוימת של עקביות, כמו שאילתה של מפתחות בלבד ואחריה חיפוש לפי מפתח, או באמצעות Memcache.
שאילתה גלובלית של מפתחות בלבד ואחריה חיפוש לפי מפתח
שאילתה גלובלית עם מפתחות בלבד היא סוג מיוחד של שאילתה גלובלית שמחזירה רק מפתחות בלי ערכי המאפיינים של הישויות. מכיוון שהערכים המוחזרים הם רק מפתחות, השאילתה לא כוללת ערך של ישות עם בעיית עקביות אפשרית. שילוב של שאילתה גלובלית עם מפתחות בלבד ושיטת חיפוש יקרא את הערכים האחרונים של הישות. עם זאת, חשוב לציין ששאילתה גלובלית עם מפתחות בלבד לא יכולה לשלול את האפשרות שאינדקס עדיין לא יהיה עקבי בזמן השאילתה, ולכן יכול להיות שישות לא תאוחזר בכלל. יכול להיות שהתוצאה של השאילתה תתבסס על סינון של ערכים ישנים באינדקס. לסיכום, מפתח יכול להשתמש בשאילתה עם אחזור נתונים גלובלי של מפתחות בלבד, ואחריה בחיפוש לפי מפתח בלבד, רק אם דרישה של האפליקציה מאפשרת שערך האינדקס עדיין לא יהיה עקבי בזמן השאילתה.
שימוש ב-Memcache
שירות Memcache הוא נדיף, אבל יש לו עקביות חזקה. לכן, על ידי שילוב של חיפושים ב-Memcache ושאילתות ב-Datastore, אפשר לבנות מערכת שתמזער את בעיות העקביות ברוב המקרים.
לדוגמה, נניח שיש אפליקציית משחק שמנהלת רשימה של ישויות מסוג Player, שלכל אחת מהן יש ניקוד שגדול מאפס.
- בבקשות להוספה או לעדכון, צריך להחיל אותן על רשימת ישויות הנגן ב-Memcache וגם ב-Datastore.
- לגבי בקשות לשאילתות, קוראים את רשימת ישויות Player מ-Memcache ומריצים שאילתה עם מפתחות בלבד ב-Datastore אם הרשימה לא נמצאת ב-Memcache.
הרשימה שמוחזרת תהיה עקבית כל עוד הרשימה שנשמרה במטמון נמצאת ב-Memcache. אם הרשומה הוצאה מהזיכרון או ששירות Memcache לא זמין באופן זמני, יכול להיות שהמערכת תצטרך לקרוא את הערך משאילתת Datastore, שעשויה להחזיר תוצאה לא עקבית. אפשר להשתמש בטכניקה הזו בכל אפליקציה שמאפשרת מידה קטנה של חוסר עקביות.
יש כמה שיטות מומלצות לשימוש ב-Memcache כשכבת מטמון ל-Datastore:
- כדי לשמור על העקביות בין הערך ב-Memcache לבין הערך ב-Datastore, צריך לזהות חריגים ושגיאות ב-Memcache. אם מתקבלת חריגה כשמעדכנים את הרשומה ב-Memcache, צריך לוודא שהרשומה הישנה ב-Memcache לא תקפה. אחרת, יכול להיות שיהיו ערכים שונים לישות (ערך ישן ב-Memcache וערך חדש ב-Datastore).
- מגדירים תקופת תפוגה לרשומות ב-Memcache. מומלץ להגדיר תקופות קצרות לתפוגה של כל רשומה כדי לצמצם את הסיכוי לחוסר עקביות במקרה של חריגים ב-Memcache.
- כדי לעדכן את הרשומות של בקרת בו-זמניות, משתמשים בתכונה השוואה והגדרה. כך תוכלו לוודא שעדכונים בו-זמניים של אותו רשומה לא יפריעו זה לזה.
מעבר הדרגתי לקבוצות ישויות
ההצעות שמופיעות בקטע הקודם רק מפחיתות את הסיכוי להתנהגות לא עקבית. הדרך הכי טובה לעצב את האפליקציה כשנדרש מודל עקביות חזק היא על סמך קבוצות ישויות ושאילתות לגבי ישויות אב. עם זאת, יכול להיות שלא יהיה אפשר להעביר אפליקציה קיימת, מה שעשוי לכלול שינוי של מודל נתונים קיים ושל לוגיקת האפליקציה משאילתות גלובליות לשאילתות של צאצאים. אחת הדרכים לעשות זאת היא באמצעות תהליך מעבר הדרגתי, כמו זה שמתואר בהמשך:
- לזהות את הפונקציות באפליקציה שדורשות מודל עקביות חזק ולקבוע להן סדרי עדיפויות.
- לכתוב לוגיקה חדשה לפונקציות insert() או update() באמצעות קבוצות ישויות בנוסף ללוגיקה הקיימת (ולא במקומה). כך, פונקציה מתאימה יכולה לטפל בכל הוספה או עדכון חדשים בקבוצות ישויות חדשות ובישויות ישנות.
- לשנות את הלוגיקה הקיימת של פונקציות קריאה או שאילתה. שאילתות של צאצאים מופעלות קודם אם קיימת קבוצת ישויות חדשה לבקשה. מריצים את השאילתה הגלובלית הישנה כהיגיון חלופי אם קבוצת הישויות לא קיימת.
האסטרטגיה הזו מאפשרת מעבר הדרגתי ממודל נתונים קיים למודל נתונים חדש שמבוסס על קבוצות ישויות, ומצמצמת את הסיכון לבעיות שנגרמות כתוצאה ממודל עקביות הדרגתי. בפועל, הגישה הזו תלויה בתרחישי שימוש ספציפיים ובדרישות להחלתה על מערכת בפועל.
חזרה למצב מוגבל
בשלב הזה, קשה לזהות באופן אוטומטי מצב שבו העקביות של אפליקציה ירדה. עם זאת, אם בדרכים אחרות תגיעו למסקנה שהעקביות של אפליקציה מסוימת נפגמה, יכול להיות שאפשר יהיה להטמיע מצב מוגבל שאפשר להפעיל או להשבית כדי להשבית אזורים מסוימים בלוגיקה של האפליקציה שדורשים מודל עקביות חזק. לדוגמה, במקום להציג תוצאת שאילתה לא עקבית במסך של דוח חיוב, יכול להיות שתוצג הודעת תחזוקה לגבי המסך הספציפי הזה. כך שאר השירותים באפליקציה יכולים להמשיך לפעול, וכתוצאה מכך, ההשפעה על חוויית המשתמש מצטמצמת.
צמצום הזמן להשגת עקביות מלאה
באפליקציה גדולה עם מיליוני משתמשים או טרה-בייט של ישויות Datastore, יכול להיות ששימוש לא הולם ב-Datastore יוביל לירידה בעקביות. דוגמאות לשיטות כאלה:
- מספור עוקב במפתחות של ישויות
- יותר מדי אינדקסים
השיטות האלה לא משפיעות על אפליקציות קטנות. עם זאת, כשהאפליקציה גדלה מאוד, שיטות העבודה האלה מגדילות את הסיכוי שיידרך זמן רב יותר כדי להגיע לעקביות. לכן, עדיף להימנע מהן בשלבים הראשונים של עיצוב האפליקציה.
תבנית אנטי #1: מספור רציף של מפתחות ישויות
לפני שחרור App Engine SDK 1.8.1, Datastore השתמש ברצף של מזהים מספריים קטנים עם דפוסים עוקבים בדרך כלל כשמות המפתחות שנוצרו אוטומטית כברירת מחדל. בחלק מהמסמכים, המדיניות הזו נקראת 'מדיניות מדור קודם' ליצירת ישויות שלא צוין להן שם מפתח של אפליקציה. המדיניות הקודמת הזו יצרה שמות של מפתחות ישויות עם מספור עוקב, למשל 1000, 1001, 1002. עם זאת, כפי שצוין קודם, Datastore מאחסן ישויות לפי הסדר הלקסיקוגרפי של שמות המפתחות, כך שהישויות האלה כנראה יאוחסנו באותם שרתי Datastore. אם אפליקציה מושכת נפח תנועה גדול מאוד, המספור העוקב הזה עלול לגרום לריכוז של פעולות בשרת מסוים, מה שעלול להוביל לזמן אחזור ארוך יותר לצורך עקביות.
ב-App Engine SDK 1.8.1, Datastore הציג שיטה חדשה למספור מזהים עם מדיניות ברירת מחדל שמשתמשת במזהים מפוזרים (ראו את התיעוד reference). מדיניות ברירת המחדל הזו יוצרת רצף אקראי של מזהים באורך של עד 16 ספרות, שמפוזרים באופן אחיד בקירוב. בעזרת המדיניות הזו, סביר להניח שהתנועה של האפליקציה הגדולה תתחלק טוב יותר בין קבוצה של שרתי Datastore, והזמן שיידרש כדי להבטיח עקביות יתקצר. מומלץ להשתמש במדיניות ברירת המחדל, אלא אם האפליקציה שלכם מחייבת תאימות למדיניות הקודמת.
אם אתם מגדירים במפורש שמות של מפתחות לישויות, תוכנית השמות צריכה להיות מתוכננת כך שתאפשר גישה לישויות באופן שווה בכל מרחב השמות של המפתחות. במילים אחרות, אל תרכזו את הגישה בטווח מסוים, כי המפתחות מסודרים לפי הסדר הלקסיקוגרפי של שמות המפתחות. אחרת, יכולה להתעורר אותה בעיה כמו במקרה של מספור עוקב.
כדי להבין את חלוקת הגישה הלא אחידה במרחב המפתחות, אפשר לעיין בדוגמה שבה ישויות נוצרות עם שמות מפתחות עוקבים, כמו שמוצג בקוד הבא:
p1 = Person(key_name='0001')
p2 = Person(key_name='0002')
p3 = Person(key_name='0003')
...
דפוס הגישה של האפליקציה עשוי ליצור 'נקודה חמה' בטווח מסוים של שמות המפתחות, למשל גישה מרוכזת לישויות מסוג Person שנוצרו לאחרונה. במקרה כזה, לכל המפתחות שהגישה אליהם תכופה יהיו מזהים גבוהים יותר. העומס עלול להתרכז בשרת Datastore ספציפי.
לחלופין, כדי להבין את הפיזור השווה במרחב המפתחות, כדאי להשתמש במחרוזות ארוכות ואקראיות לשמות המפתחות. הדוגמה הבאה ממחישה את זה:
p1 = Person(key_name='t9P776g5kAecChuKW4JKCnh44uRvBDhU')
p2 = Person(key_name='hCdVjL2jCzLqRnPdNNcPCAN8Rinug9kq')
p3 = Person(key_name='PaV9fsXCdra7zCMkt7UX3THvFmu6xsUd')
...
עכשיו יש פיזור של ישויות מסוג Person שנוצרו לאחרונה במרחב המפתחות ובכמה שרתים. ההנחה היא שיש מספר גדול מספיק של ישויות מסוג Person.
תבנית אנטי #2: יותר מדי אינדקסים
ב-Datastore, עדכון אחד של ישות יוביל לעדכון של כל האינדקסים שהוגדרו לסוג הישות הזה. אם אפליקציה משתמשת בהרבה אינדקסים בהתאמה אישית, עדכון אחד יכול לכלול עשרות, מאות או אפילו אלפי עדכונים בטבלאות האינדקס. באפליקציה גדולה, שימוש מוגזם באינדקסים מותאמים אישית עלול להגדיל את העומס על השרת ולהגדיל את זמן האחזור כדי להשיג עקביות.
ברוב המקרים, מוסיפים אינדקסים מותאמים אישית כדי לתמוך בדרישות כמו תמיכת לקוחות, פתרון בעיות או משימות של ניתוח נתונים. BigQuery הוא מנוע שאילתות עם יכולת התאמה רחבה במיוחד, שיכול להריץ שאילתות אד-הוק על מערכי נתונים גדולים בלי להסתמך על אינדקסים מוכנים מראש. הוא מתאים יותר לתרחישי שימוש כמו תמיכת לקוחות, פתרון בעיות או ניתוח נתונים שדורשים שאילתות מורכבות, מאשר Datastore.
אחת מהשיטות המומלצות היא לשלב בין Datastore לבין BigQuery כדי לעמוד בדרישות עסקיות שונות. משתמשים ב-Datastore לעיבוד עסקאות אונליין (OLTP) שנדרש ללוגיקה של אפליקציות ליבה, וב-BigQuery לעיבוד אנליטי אונליין (OLAP) לפעולות בקצה העורפי. יכול להיות שיהיה צורך להטמיע תהליך רציף של ייצוא נתונים מ-Datastore ל-BigQuery כדי להעביר את הנתונים שנדרשים לשאילתות האלה.
בנוסף להמלצה להשתמש ביישום חלופי של אינדקסים מותאמים אישית, מומלץ גם לציין במפורש מאפיינים שלא נכללים באינדקס (ראו מאפיינים וסוגי ערכים). כברירת מחדל, Datastore יוצר טבלת אינדקס שונה לכל מאפיין שאפשר להוסיף לאינדקס של סוג ישות. אם יש לכם 100 נכסים מסוג מסוים, יהיו 100 טבלאות אינדקס לסוג הזה, ו-100 עדכונים נוספים בכל עדכון של ישות. לכן, מומלץ להגדיר נכסים כלא מסונכרנים עם האינדקס, אם אפשר, אם הם לא נדרשים לתנאי שאילתה.
בנוסף לצמצום הסיכוי לעלייה בזמני העקביות, האופטימיזציות האלה של האינדקסים עשויות להוביל לצמצום משמעותי של עלויות האחסון ב-Datastore באפליקציה גדולה שמשתמשת באינדקסים באופן אינטנסיבי.
סיכום
מודל עקביות הדרגתי הוא רכיב חיוני במסדי נתונים לא רלציוניים, שמאפשר למפתחים למצוא איזון אופטימלי בין מדרגיות, ביצועים ועקביות. חשוב להבין איך לאזן בין עקביות סופית למודל עקביות חזק כדי לעצב מודל נתונים אופטימלי לאפליקציה. ב-Datastore, השימוש בקבוצות של ישויות ובשאילתות לגבי ישויות אב הוא הדרך הכי טובה להבטיח מודל עקביות חזק בטווח של ישויות. אם האפליקציה לא יכולה לשלב קבוצות של ישויות בגלל המגבלות שתיארנו קודם, אפשר לשקול אפשרויות אחרות כמו שימוש בשאילתות עם מפתחות בלבד או ב-Memcache. באפליקציות גדולות, כדאי להשתמש בשיטות מומלצות כמו שימוש במזהים מפוזרים וצמצום האינדוקס כדי לקצר את הזמן שנדרש להשגת עקביות. יכול להיות שיהיה חשוב גם לשלב את Datastore עם BigQuery כדי לעמוד בדרישות העסקיות של שאילתות מורכבות, וכדי לצמצם ככל האפשר את השימוש באינדקסים של Datastore.
מקורות מידע נוספים
במקורות המידע הבאים אפשר לקרוא מידע נוסף על הנושאים שמופיעים במסמך הזה:
- Google App Engine: אחסון נתונים
- סקירה כללית של Datastore
- הבלוג של Google Cloud Platform
- Cloud SQL
- שימוש ב-Python App Engine עם Cloud SQL
- Bigtable: מערכת אחסון מבוזרת לנתונים מובְנים
- השקנו את App Engine 1.5.2 SDK
- Megastore: Providing Scalable, Highly Available Storage for Interactive Services
[1] אפשר ליצור קבוצת ישויות גם על ידי ציון רק מפתח אחד של ישות הבסיס או ישות אם, בלי לאחסן את הישויות בפועל של הבסיס או האב, כי כל הפונקציות של קבוצת הישויות מיושמות על סמך קשרים בין מפתחות.
[2] המגבלה הנתמכת היא עדכון אחד לשנייה לכל קבוצת ישויות מחוץ לעסקאות, או עסקה אחת לשנייה לכל קבוצת ישויות. אם אתם צוברים כמה עדכונים לעסקה אחת, אתם מוגבלים לגודל עסקה מקסימלי של 10MB ולשיעור כתיבה מקסימלי של שרת Datastore.