


Neste documento, descrevemos as ferramentas e os arquivos que podem ser usados para monitorar e resolver problemas de cargas de trabalho em lote do Serviço Gerenciado para Apache Spark.
Resolver problemas de cargas de trabalho no console do Google Cloud
Quando um job em lote falha ou tem um desempenho ruim, uma primeira etapa recomendada é abrir a página Detalhes do job (Detalhes do lote) clicando no ID do job do lote na guia Spark sem servidor da página Jobs no console do Google Cloud .
Usar a guia "Resumo": seu hub de solução de problemas
A guia Resumo, que é selecionada por padrão quando a página Detalhes do job em lote é aberta, mostra métricas críticas e registros filtrados para ajudar você a fazer uma avaliação inicial rápida da integridade do lote. Após essa avaliação inicial, é possível realizar uma análise mais detalhada usando ferramentas mais especializadas disponíveis na página Detalhes do job em lote, como a interface do Spark, a Análise de registros e o Gemini Cloud Assist.
Destaques das métricas de lote
As guias Resumo e Monitoramento na página Detalhes do job em lote incluem gráficos que mostram valores importantes de métricas de carga de trabalho em lote. Os gráficos de métricas são preenchidos após a conclusão e oferecem uma indicação visual de possíveis problemas, como contenção de recursos, desvio de dados ou pressão de memória.
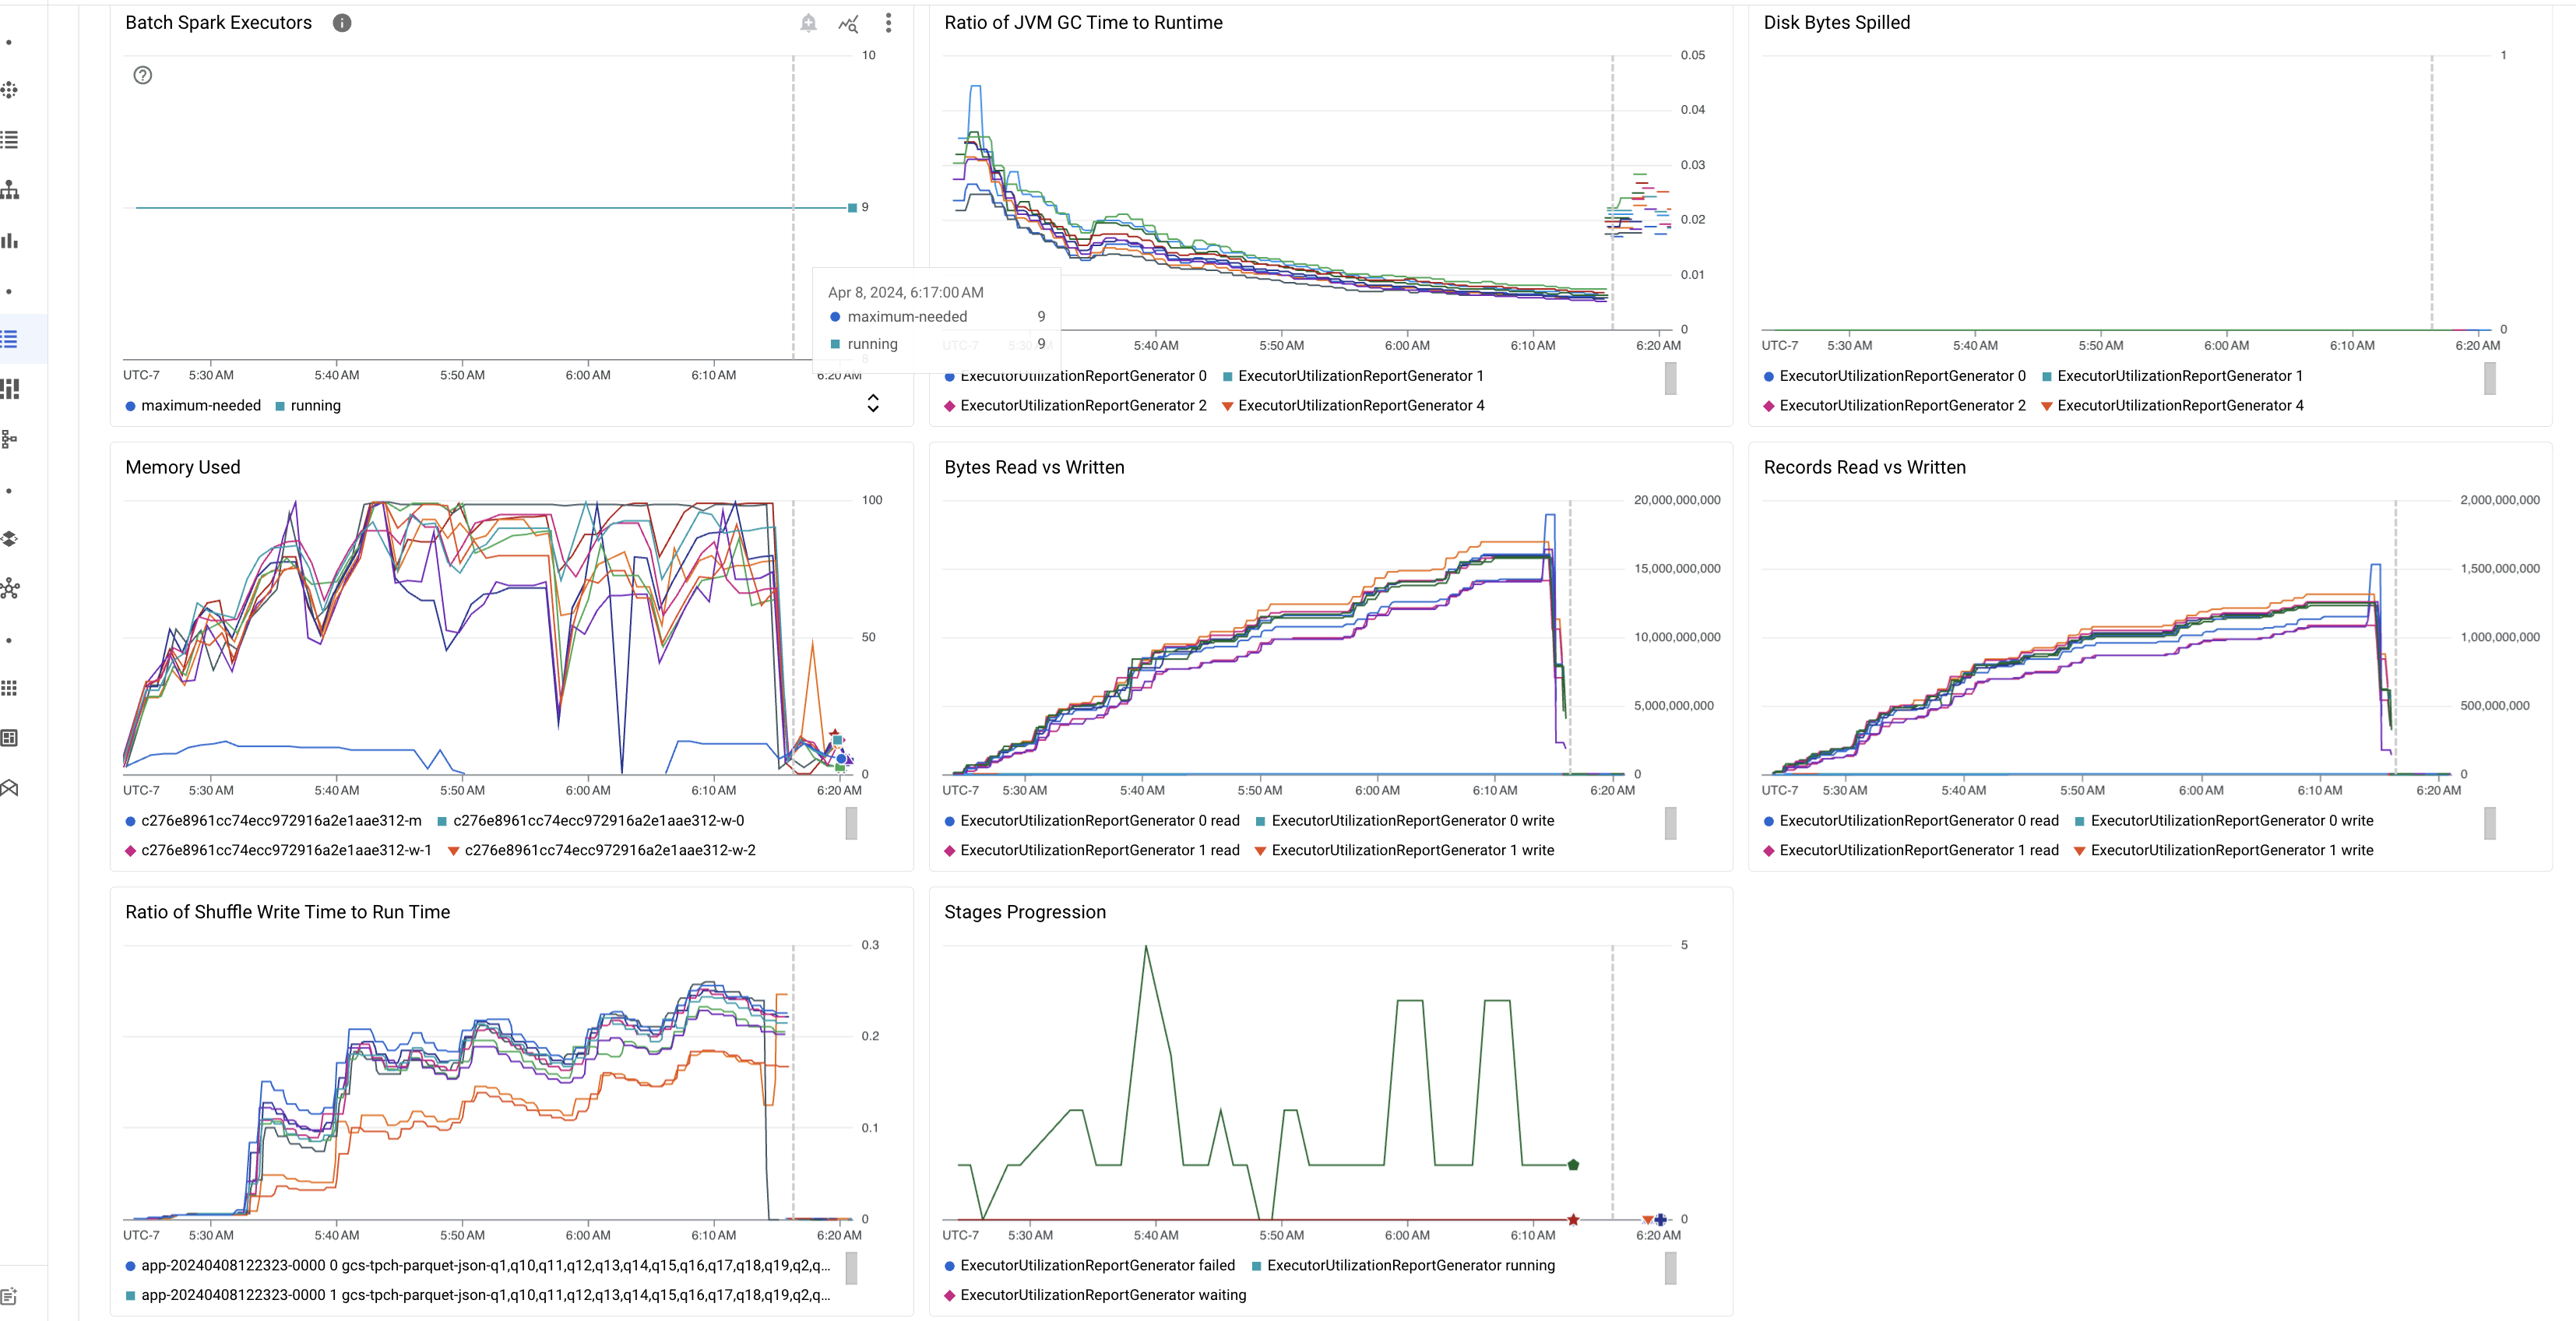
A tabela a seguir lista as métricas de carga de trabalho do Spark exibidas na página Detalhes do job em lote no console do Google Cloud e descreve como os valores das métricas podem fornecer insights sobre o status e o desempenho da carga de trabalho.
| Métrica | O que ele mostra? |
|---|---|
| Métricas no nível do executor | |
| Proporção entre o tempo de GC da JVM e o tempo de execução | Essa métrica mostra a proporção entre o tempo de GC (coleta de lixo) da JVM e o tempo de execução por executor. Proporções altas podem indicar vazamentos de memória em tarefas em execução em executores específicos ou estruturas de dados ineficientes, o que pode levar a uma alta rotatividade de objetos. |
| Bytes de disco vazados | Essa métrica mostra o número total de bytes de disco distribuídos entre diferentes executores. Se um executor mostrar um alto número de bytes de disco transferidos, isso pode indicar desvio de dados. Se a métrica aumentar ao longo do tempo, isso pode indicar que há estágios com pressão de memória ou vazamentos de memória. |
| Bytes lidos e gravados | Essa métrica mostra os bytes gravados em comparação com os bytes lidos por executor. Grandes discrepâncias em bytes lidos ou gravados podem indicar cenários em que as mesclagens replicadas levam à amplificação de dados em executores específicos. |
| Registros lidos e gravados | Essa métrica mostra os registros lidos e gravados por executor. Um grande número de registros lidos com um pequeno número de registros gravados pode indicar um gargalo na lógica de processamento em executores específicos, fazendo com que os registros sejam lidos enquanto aguardam. Executores que apresentam atrasos consistentes em leituras e gravações podem indicar contenção de recursos nesses nós ou ineficiências de código específicas do executor. |
| Proporção entre o tempo de gravação de embaralhamento e o tempo de execução | A métrica mostra o tempo que o executor passou no ambiente de execução de embaralhamento em comparação com o ambiente de execução geral. Se esse valor for alto para alguns executores, isso pode indicar desvio de dados ou serialização de dados ineficiente. É possível identificar estágios com tempos longos de gravação de embaralhamento na interface do Spark. Procure tarefas atípicas nessas etapas que levam mais tempo do que a média para serem concluídas. Verifique se os executores com tempos de gravação de embaralhamento altos também mostram alta atividade de E/S de disco. Uma serialização mais eficiente e etapas de particionamento adicionais podem ajudar. Gravações de registros muito grandes em comparação com leituras de registros podem indicar duplicação não intencional de dados devido a mesclagens ineficientes ou transformações incorretas. |
| Métricas no nível do aplicativo | |
| Progressão de fases | Essa métrica mostra o número de estágios com falha, em espera e em execução. Um grande número de estágios com falha ou em espera pode indicar desvio de dados. Verifique as partições de dados e depure o motivo da falha do estágio usando a guia Estágios na interface do Spark. |
| Executores do Spark em lote | Essa métrica mostra o número de executores que podem ser necessários em comparação com o número de executores em execução. Uma grande diferença entre os executores necessários e em execução pode indicar problemas de escalonamento automático. |
| Métricas no nível da VM | |
| Memória usada | Essa métrica mostra a porcentagem de memória da VM em uso. Se a porcentagem do mestre for alta, isso pode indicar que o driver está sob pressão de memória. Para outros nós de VM, uma porcentagem alta pode indicar que os executores estão ficando sem memória, o que pode levar a um alto vazamento de disco e a um ambiente de execução de carga de trabalho mais lento. Use a interface do Spark para analisar os executores e verificar se há um tempo de GC alto e muitas falhas de tarefas. Além disso, depure o código do Spark para armazenamento em cache de grandes conjuntos de dados e transmissão desnecessária de variáveis. |
Registros do job
A página Detalhes do job em lote inclui uma guia Registros do job (e destaques de registro) que lista avisos e erros filtrados dos registros do job (carga de trabalho em lote). Esse recurso permite identificar rapidamente problemas críticos sem precisar analisar manualmente arquivos de registro extensos. Selecione uma Gravidade do registro (por exemplo, Error) no menu suspenso e adicione um Filtro de texto para restringir os resultados. Para realizar uma análise mais detalhada, clique no ícone Ver na Análise de registros
para abrir os registros de lote selecionados na Análise de registros.
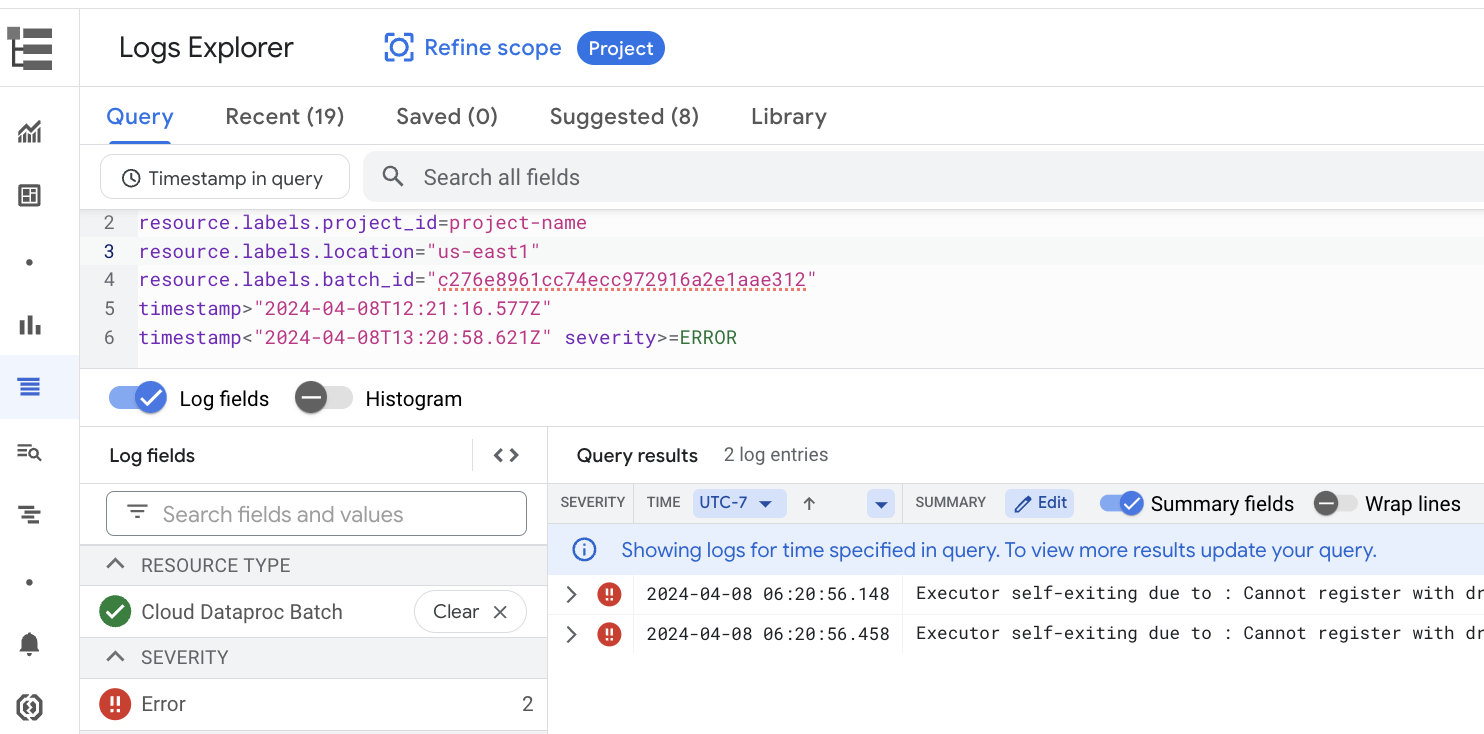
Exemplo: a Análise de registros é aberta depois de escolher Errors no seletor de gravidade
na página Detalhes do job em lote no console do Google Cloud .
Interface do Spark
A interface do Spark coleta detalhes de execução do Apache Spark das cargas de trabalho em lote do Serviço Gerenciado para Apache Spark. Não há cobrança pelo recurso da interface do Spark, que é ativado por padrão.
Os dados coletados pelo recurso de interface do Spark são retidos por 90 dias. É possível usar essa interface da Web para monitorar e depurar cargas de trabalho do Spark sem precisar criar um servidor de histórico persistente.
Permissões e papéis necessários do Identity and Access Management
As permissões a seguir são necessárias para usar o recurso de interface do Spark com cargas de trabalho em lote.
Permissão de coleta de dados:
dataproc.batches.sparkApplicationWrite. Essa permissão precisa ser concedida à conta de serviço que executa cargas de trabalho em lote. Essa permissão está incluída no papelManaged Service for Apache Spark Worker, que é concedido automaticamente à conta de serviço padrão do Compute Engine usada pelo Serviço Gerenciado para Apache Spark por padrão (consulte Conta de serviço do Serviço Gerenciado para Apache Spark). No entanto, se você especificar uma conta de serviço personalizada para sua carga de trabalho em lote, adicione a permissãodataproc.batches.sparkApplicationWritea essa conta de serviço (normalmente, concedendo à conta de serviço o papelWorkerdo Managed Service para Apache Spark).Permissão de acesso à interface do Spark:
dataproc.batches.sparkApplicationRead. Essa permissão precisa ser concedida a um usuário para acessar a interface do Spark no console doGoogle Cloud . Essa permissão está incluída nos papéisDataproc Viewer,Dataproc EditoreDataproc Administrator. Para abrir a interface do Spark no console do Google Cloud , é preciso ter um desses papéis ou um papel personalizado que inclua essa permissão.
Abrir a interface do Spark
A página da interface do Spark está disponível nas cargas de trabalho em lote do console do Google Cloud .
No console do Google Cloud , acesse a página Jobs do Serviço Gerenciado para Apache Spark.
Selecione a guia Spark sem servidor e clique em um código da tarefa em lote para abrir a página Detalhes do job.
Clique em Ver na interface do Spark (ao lado de ID do aplicativo Spark) ou em Ver interface do Spark.
O link Ver na interface do Spark fica desativado nos seguintes casos:
- Se uma permissão obrigatória não for concedida
- Se a interface do Spark não estiver ativada na página Detalhes do job em lote
- Se você definir a propriedade
spark.dataproc.appContext.enabledcomofalseao enviar uma carga de trabalho em lote,
Registros do Serviço Gerenciado para Apache Spark
A geração de registros é ativada por padrão no Serviço Gerenciado para Apache Spark, e os registros de carga de trabalho persistem após a conclusão de uma carga de trabalho. O Serviço Gerenciado para Apache Spark coleta registros de carga de trabalho no Cloud Logging.
É possível acessar os registros do Serviço Gerenciado para Apache Spark no recurso Cloud Dataproc Batch na Análise de Registros.
Consultar registros do Serviço Gerenciado para Apache Spark
A Análise de Registros no console do Google Cloud oferece um painel de consulta para ajudar você a criar uma consulta para examinar os registros de carga de trabalho em lote. Siga estas etapas para criar uma consulta que examine os registros de carga de trabalho em lote:
- O projeto atual está selecionado. Clique em Refinar projeto de escopo para selecionar um projeto diferente.
Defina uma consulta de registros em lote.
Use menus de filtro para filtrar uma carga de trabalho em lote.
Em Todos os recursos, selecione o recurso Serviço Gerenciado do Cloud para lote do Apache Spark.
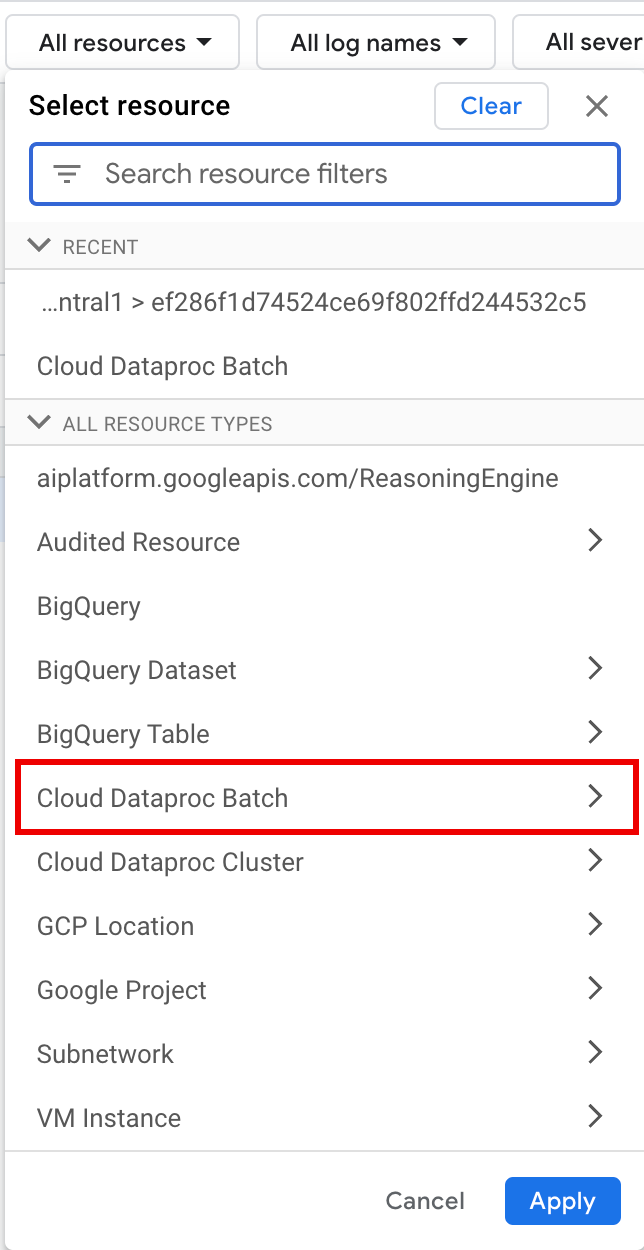
No painel Selecionar recurso, selecione o LOCAL do lote e o ID DO LOTE. Esses parâmetros de lote estão listados na guia Serverless Spark da página Jobs do Serviço Gerenciado para Apache Spark no console do Google Cloud .
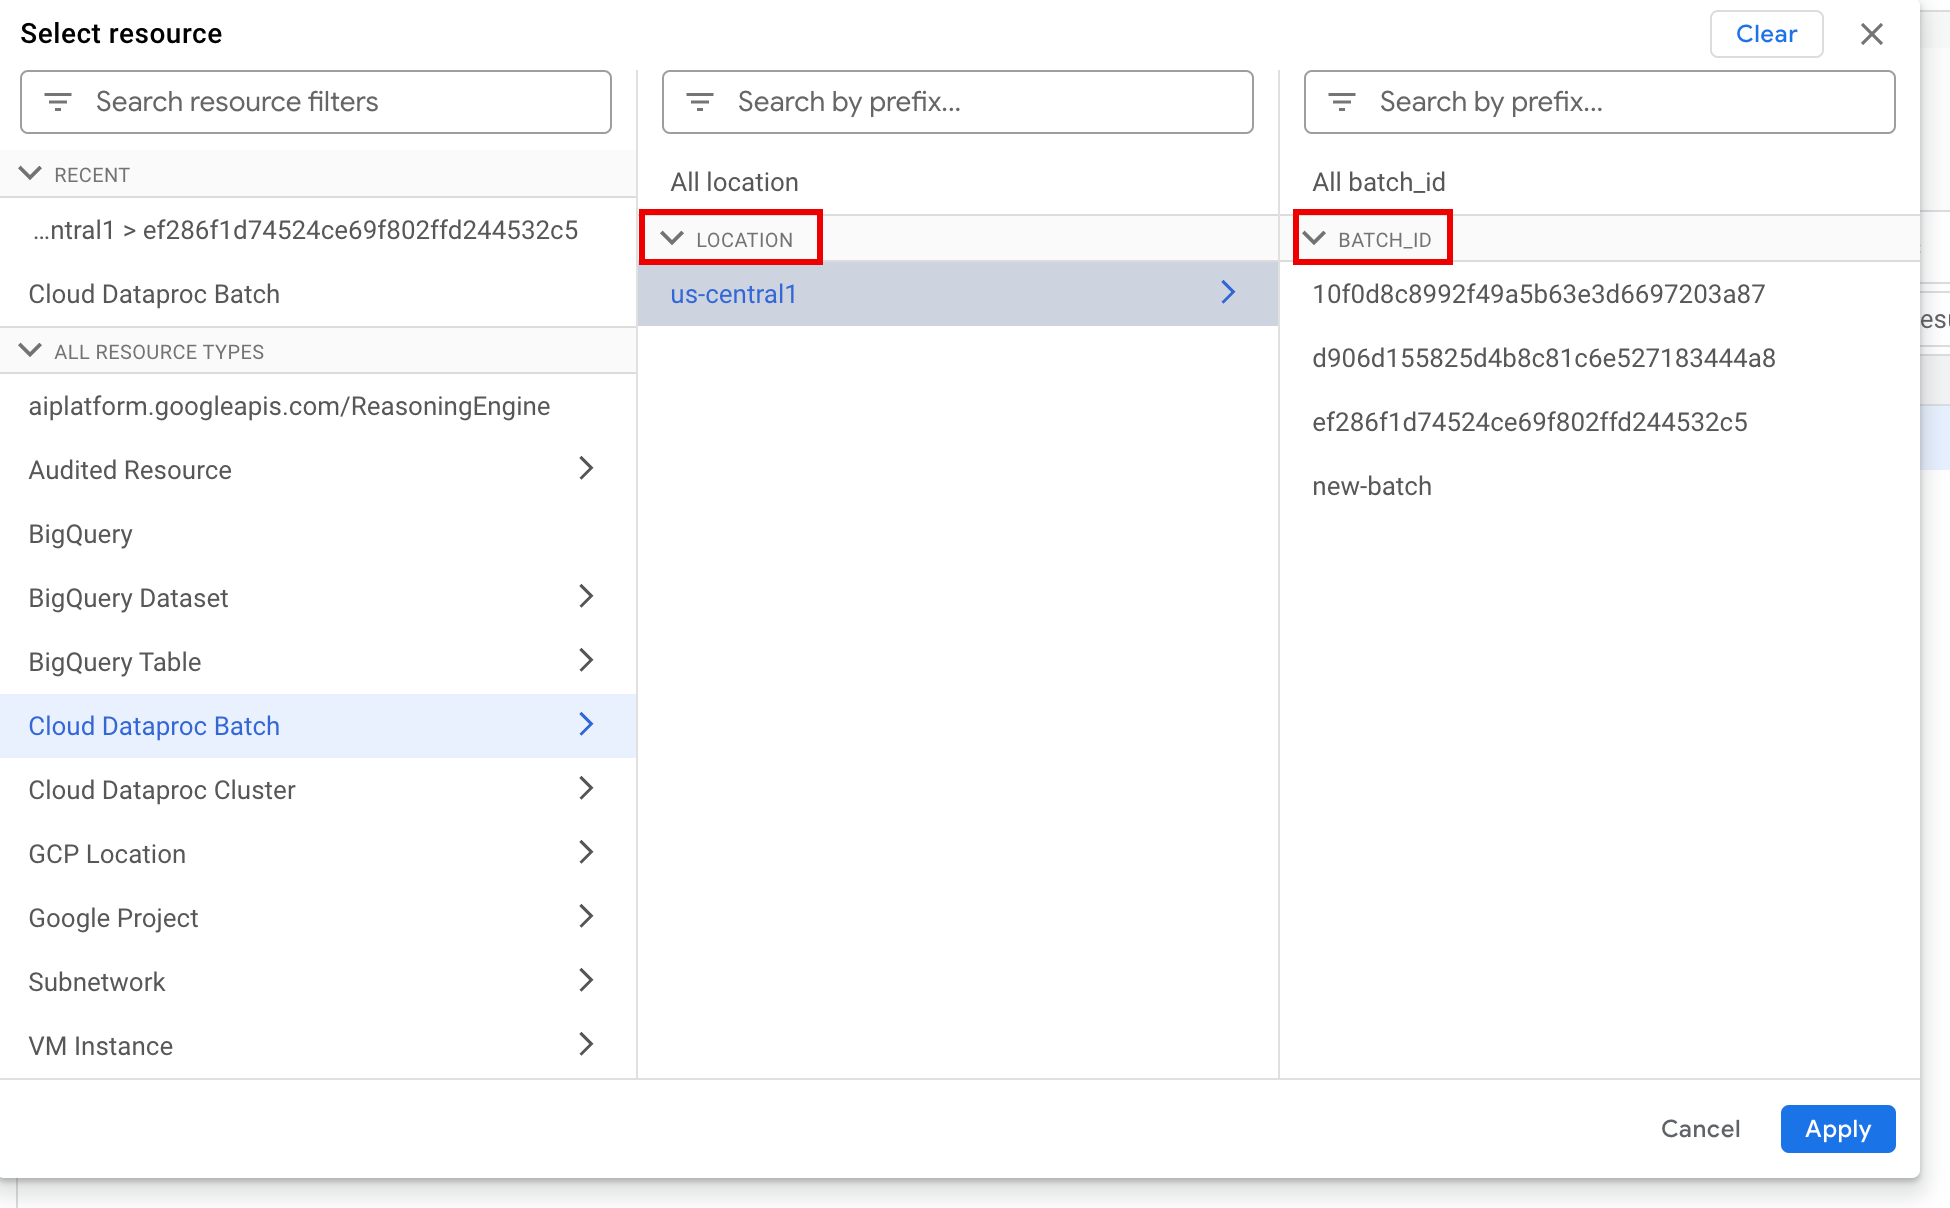
Clique em Aplicar.
Em Selecionar nomes de registros, digite
dataproc.googleapis.comna caixa Pesquisar nomes de registros para limitar os tipos de registro a serem consultados. Selecione um ou mais nomes de arquivos de registro listados.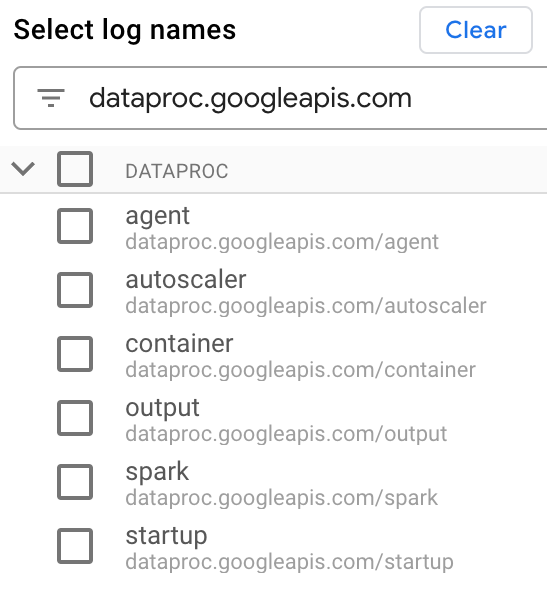
Use o editor de consultas para filtrar registros específicos de VM.
Especifique o tipo de recurso e o nome do recurso da VM, conforme mostrado no exemplo a seguir:
resource.type="cloud_dataproc_batch"
labels."dataproc.googleapis.com/resource_name"="VM_NAME_PREFIX-BATCH_UUID-VM_SUFFIX"
- VM_NAME_PREFIX:: use
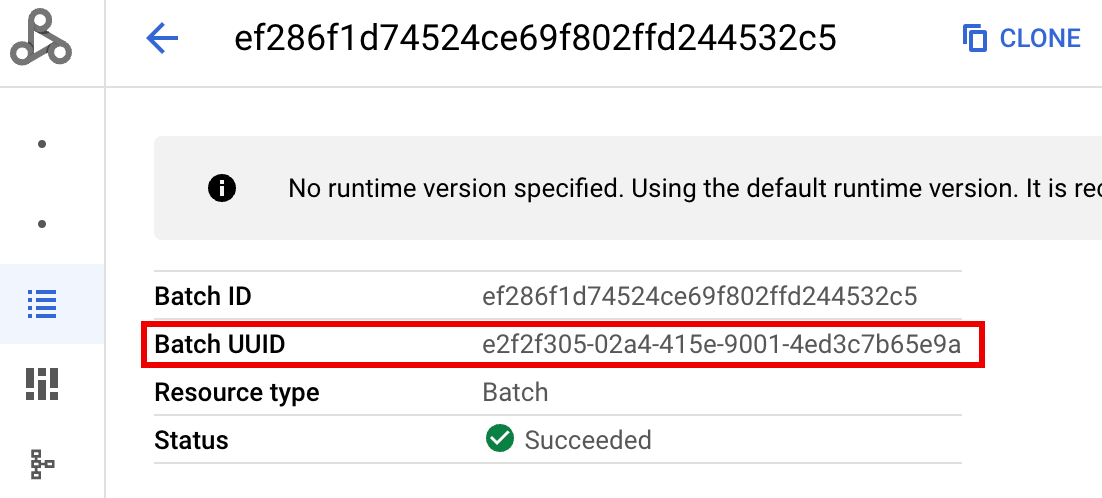
gdpic-rmpara cargas de trabalho em lote executadas no Serviço Gerenciado para Apache Spark3.0e versões mais recentes do ambiente de execução. Usegdpic-srvls-batchpara cargas de trabalho em lote executadas em versões anteriores do ambiente de execução. - BATCH_UUID: o UUID do job em lote está listado na página Detalhes do job (Detalhes do lote) no console do Google Cloud , que é aberta quando você clica no código da tarefa em lote na guia Spark sem servidor da página Jobs.
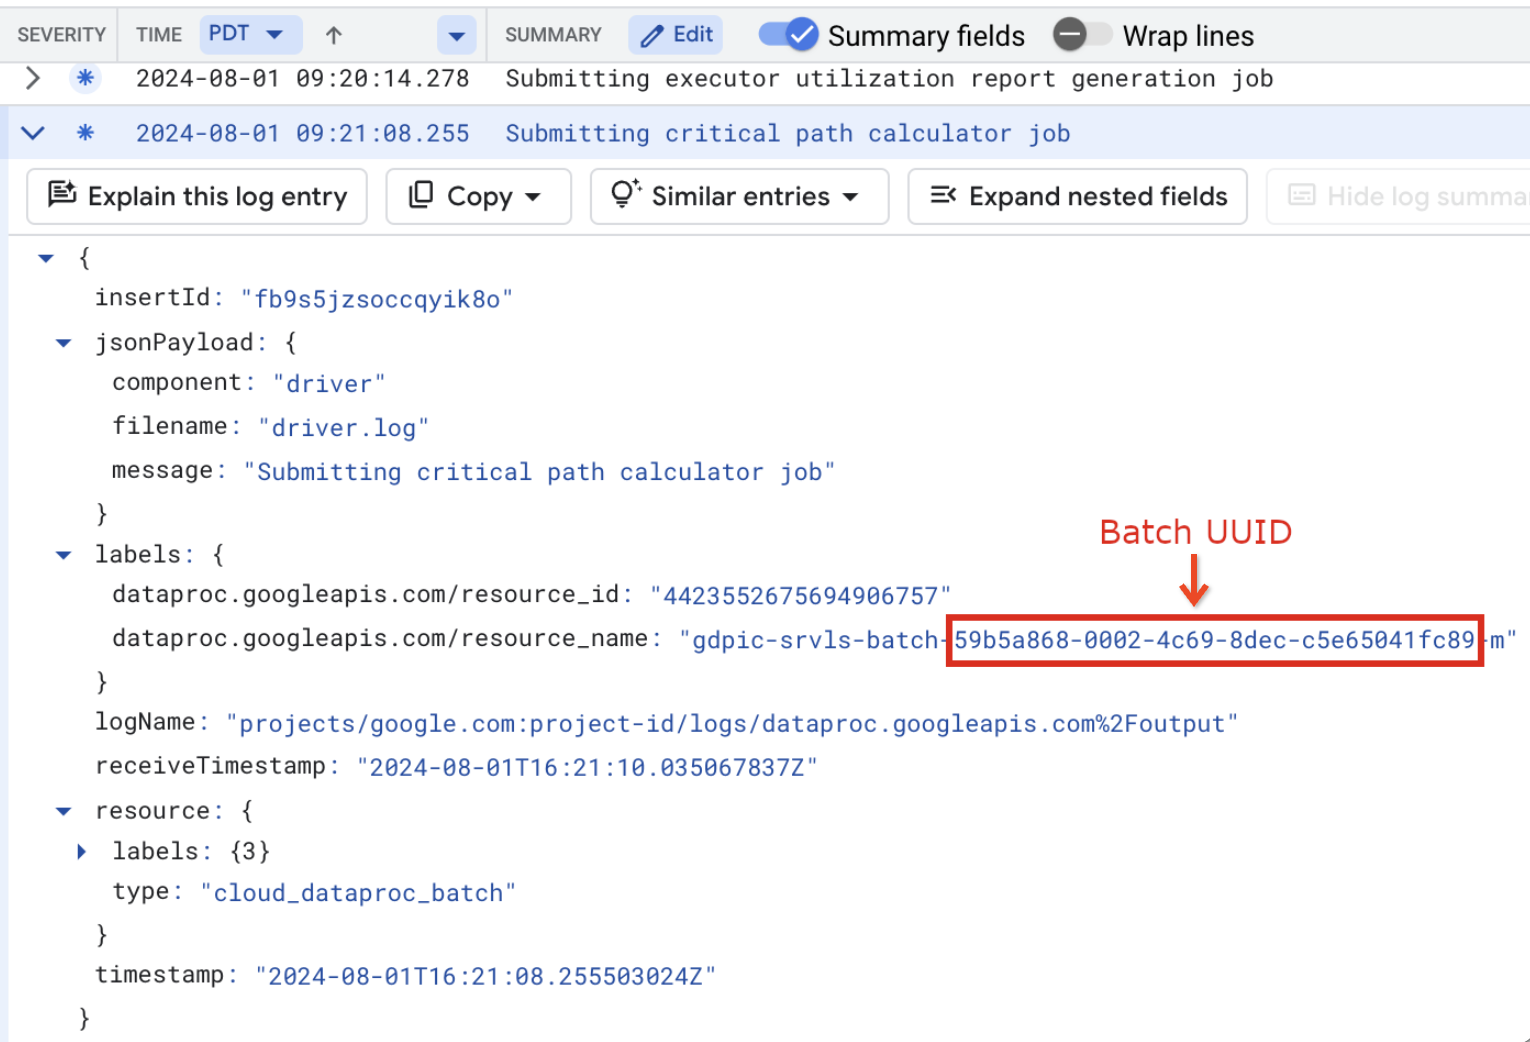
Os registros de lote também listam o UUID do lote no nome do recurso da VM. Veja um exemplo de um driver.log em lote:
- VM_NAME_PREFIX:: use
Clique em Executar consulta.
Tipos de registro e consultas de amostra do Serviço Gerenciado para Apache Spark
A lista a seguir descreve diferentes tipos de registro do Serviço Gerenciado para Apache Spark e fornece exemplos de consultas da Análise de Registros para cada tipo de registro.
dataproc.googleapis.com/output: esse arquivo de registro contém a saída da carga de trabalho em lote. O Serviço Gerenciado para Apache Spark transmite a saída em lote para o namespaceoutpute define o nome do arquivo comoJOB_ID.driver.log.Exemplo de consulta da Análise de registros para registros de saída:
resource.type="cloud_dataproc_batch"
resource.labels.location="REGION"
resource.labels.batch_id="BATCH_ID"
logName="projects/PROJECT_ID/logs/dataproc.googleapis.com%2Foutput"
dataproc.googleapis.com/spark: o namespacesparkagrega registros do Spark para daemons e executores em execução nas VMs mestre do cluster e VMs de worker do cluster do Serviço Gerenciado para Apache Spark. Cada entrada de registro inclui um rótulo de componentemaster,workerouexecutorpara identificar a origem do registro, da seguinte maneira:executor: registros de executores de código do usuário. Normalmente, esses são registros distribuídos.master: registros do mestre do gerenciador de recursos independente do Spark, que são semelhantes aos registros do YARN do Serviço Gerenciado para Apache SparkResourceManager.worker: registros do worker do gerenciador de recursos independente do Spark, que são semelhantes aos registros do YARN do Serviço Gerenciado para Apache SparkNodeManager.
Exemplo de consulta da Análise de registros para todos os registros no namespace
spark:resource.type="cloud_dataproc_batch" resource.labels.location="REGION" resource.labels.batch_id="BATCH_ID" logName="projects/PROJECT_ID/logs/dataproc.googleapis.com%2Fspark"
Exemplo de consulta da Análise de registros para registros de componentes independentes do Spark no namespace
spark:resource.type="cloud_dataproc_batch" resource.labels.location="REGION" resource.labels.batch_id="BATCH_ID" logName="projects/PROJECT_ID/logs/dataproc.googleapis.com%2Fspark" jsonPayload.component="COMPONENT"
dataproc.googleapis.com/startup: o namespacestartupinclui os registros de inicialização em lote (cluster). Todos os registros de script de inicialização são incluídos. Os componentes são identificados por rótulo, por exemplo:startup-script[855]: ... activate-component-spark[3050]: ... enable spark-worker
resource.type="cloud_dataproc_batch"
resource.labels.location="REGION"
resource.labels.batch_id="BATCH_ID"
logName="projects/PROJECT_ID/logs/dataproc.googleapis.com%2Fstartup"
labels."dataproc.googleapis.com/resource_name"="VM_NAME_PREFIX-BATCH_UUID-VM_SUFFIX"
dataproc.googleapis.com/agent: o namespaceagentagrega registros do agente do Managed Service para Apache Spark. Cada entrada de registro inclui um rótulo de nome de arquivo que identifica a origem do registro.Exemplo de consulta da Análise de registros para registros agênticos gerados por uma VM de worker especificada:
resource.type="cloud_dataproc_batch"
resource.labels.location="REGION"
resource.labels.batch_id="BATCH_ID"
logName="projects/PROJECT_ID/logs/dataproc.googleapis.com%2Fagent"
labels."dataproc.googleapis.com/resource_name"="VM_NAME_PREFIX-BATCHUUID-wWORKER#"
dataproc.googleapis.com/autoscaler: o namespaceautoscaleragrega os registros do escalonador automático do Managed Service para Apache Spark.Exemplo de consulta da Análise de registros para registros do escalonador automático gerados por uma VM de worker especificada:
resource.type="cloud_dataproc_batch"
resource.labels.location="REGION"
resource.labels.batch_id="BATCH_ID"
logName="projects/PROJECT_ID/logs/dataproc.googleapis.com%2Fautoscaler"
labels."dataproc.googleapis.com/resource_name"="VM_NAME_PREFIX-BATCHUUID-wWORKER#"
Para mais informações, consulte Registros do Serviço Gerenciado para Apache Spark.
Para informações sobre os registros de auditoria do Serviço Gerenciado para Apache Spark, consulte Registros de auditoria do Serviço Gerenciado para Apache Spark.
Métricas de carga de trabalho
O Serviço Gerenciado para Apache Spark fornece métricas de lote e do Spark que podem ser visualizadas no Metrics Explorer ou na página Detalhes do job em lote no console do Google Cloud .
Métricas de lote
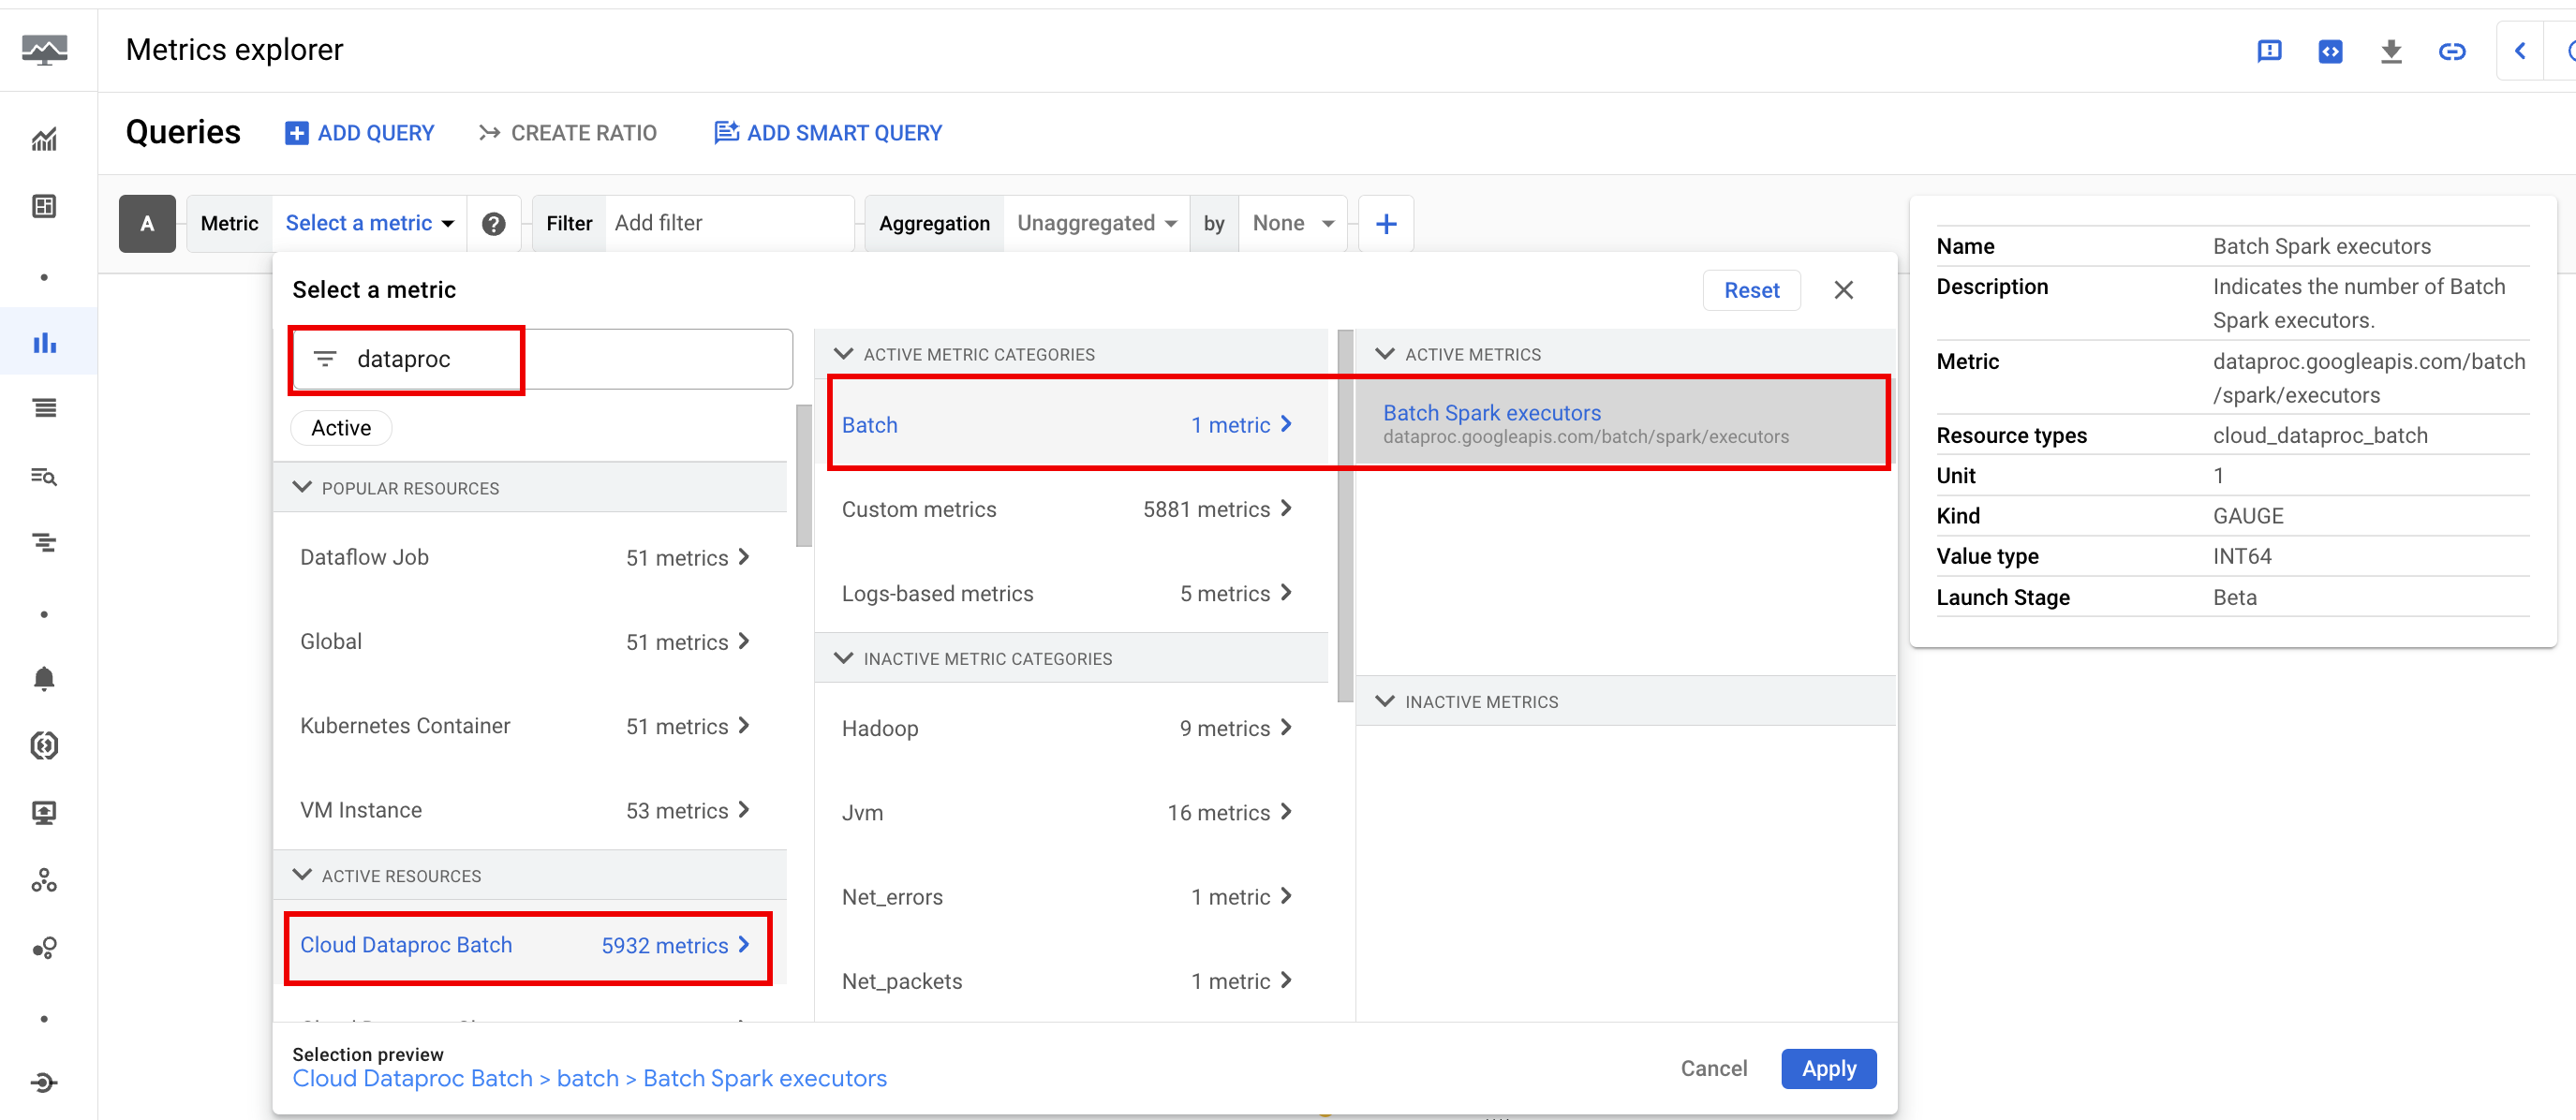
As métricas de recursos do batch do Serviço Gerenciado para Apache Spark fornecem insights sobre recursos em lote,
como o número de executores em lote. As métricas de lote são prefixadas com
dataproc.googleapis.com/batch.
Métricas do Spark
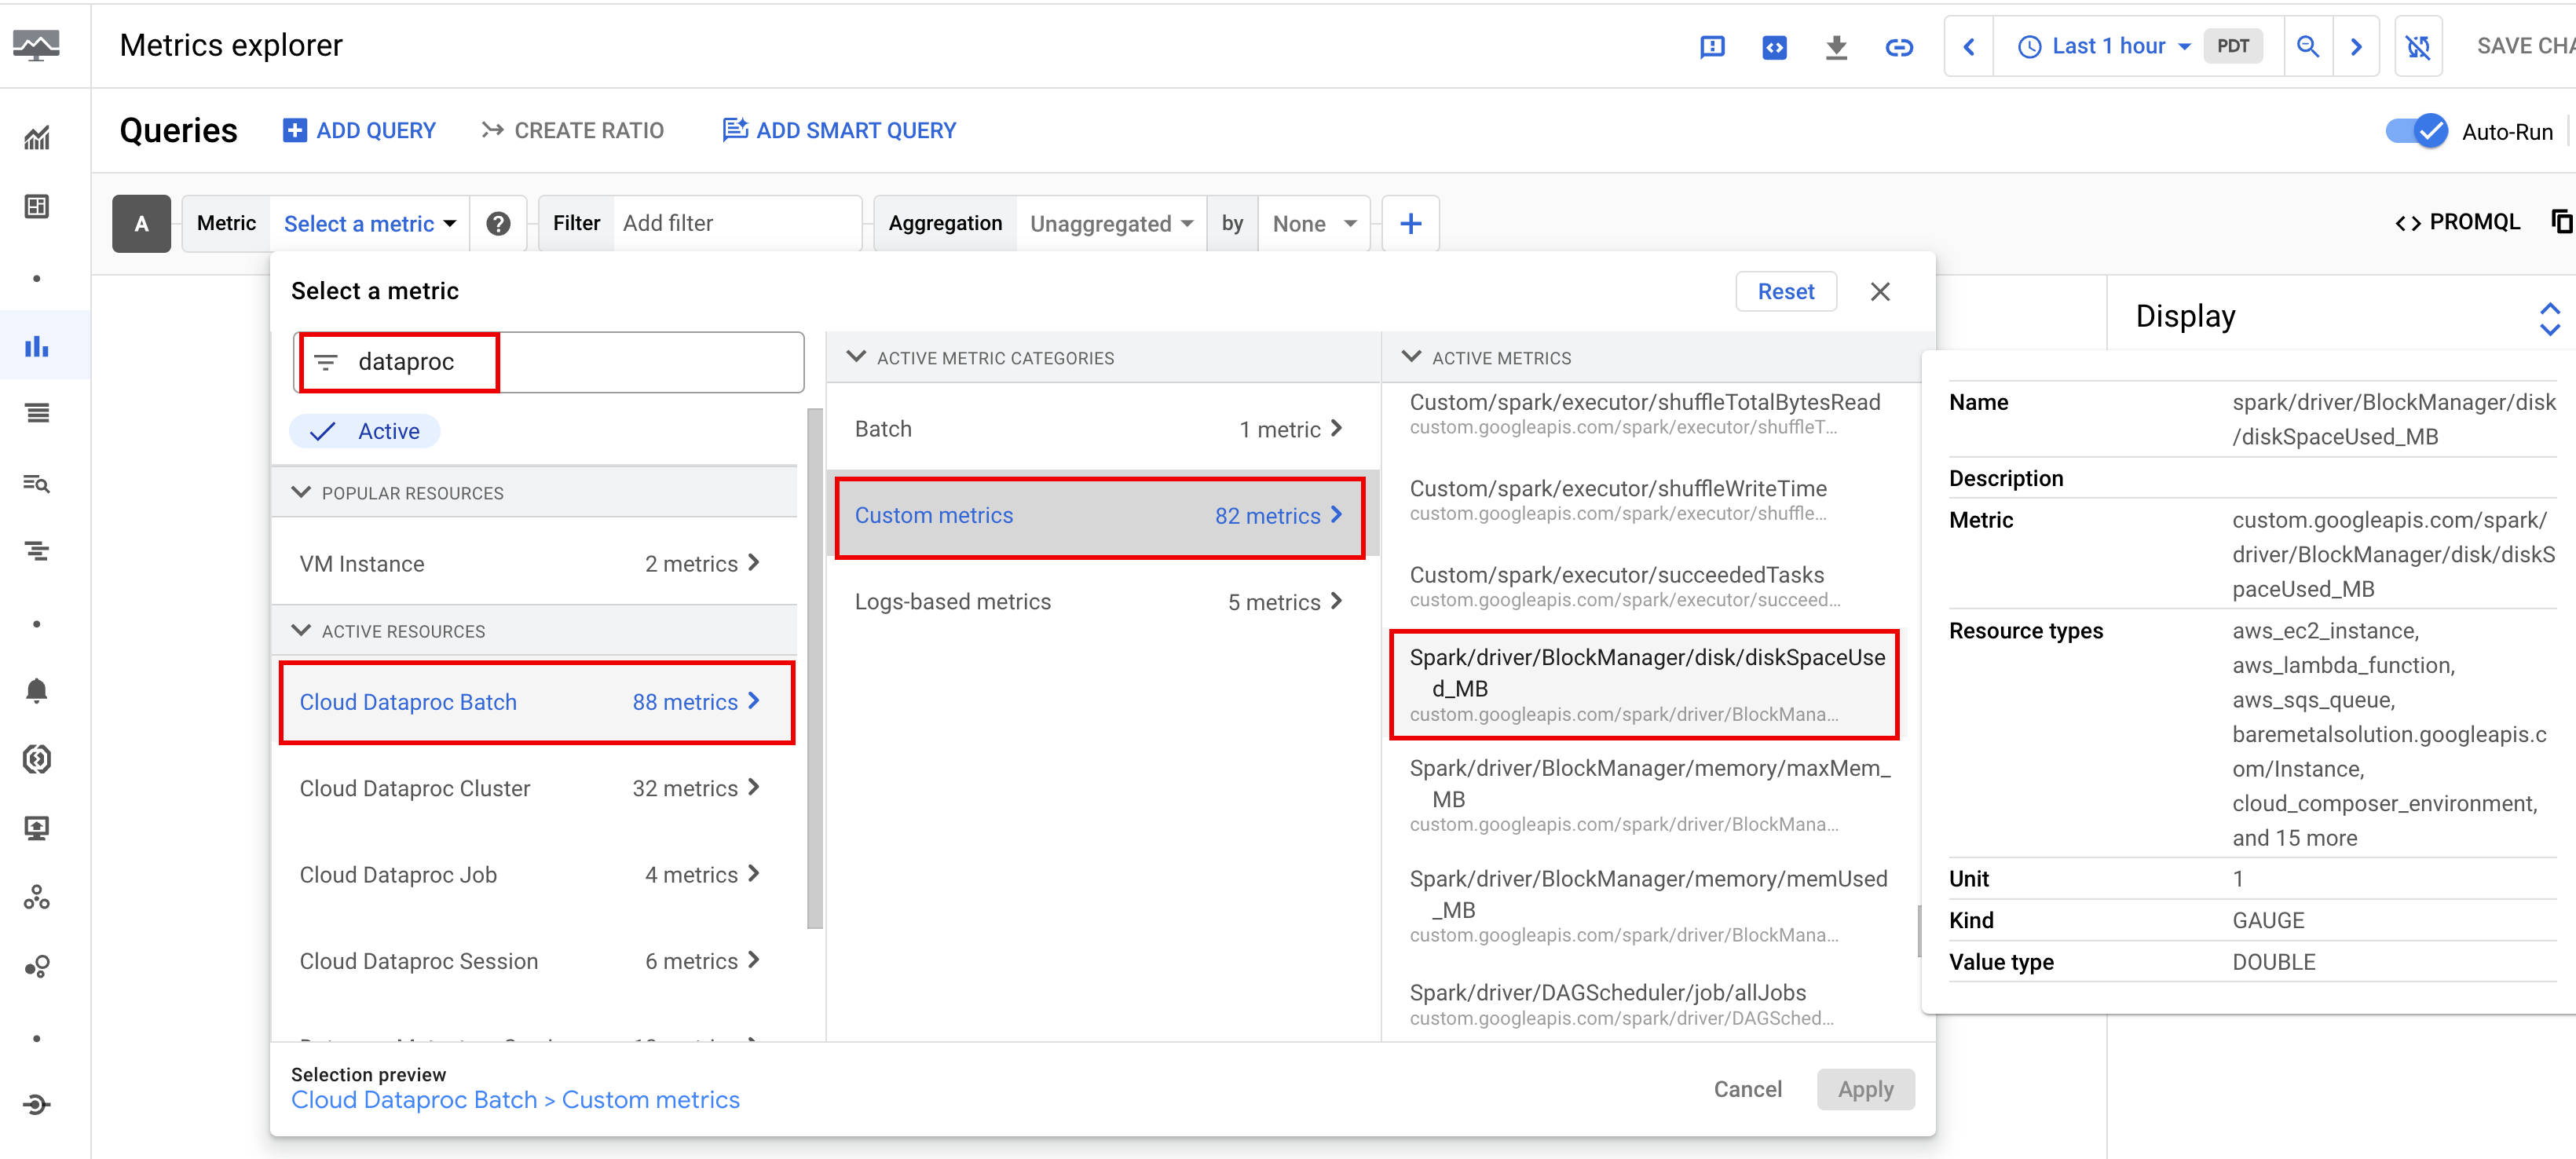
Por padrão, o Serviço Gerenciado para Apache Spark ativa a coleta de métricas do Spark disponíveis, a menos que você use propriedades de coleta de métricas do Spark para desativar ou substituir a coleta de uma ou mais métricas do Spark.
As métricas do Spark disponíveis
incluem métricas de driver e executor do Spark e métricas do sistema. As métricas do Spark disponíveis são prefixadas
com custom.googleapis.com/.
Configurar alertas de métricas
É possível criar alertas de métricas do Serviço Gerenciado para Apache Spark para receber notificações sobre problemas de carga de trabalho.
Criar tabelas
É possível criar gráficos que mostram as métricas de carga de trabalho usando o
Metrics Explorer no
console doGoogle Cloud . Por exemplo, é possível
criar um gráfico para exibir disk:bytes_used e, em seguida, filtrar por batch_id.
Cloud Monitoring
O Monitoring usa metadados e métricas de carga de trabalho para fornecer insights sobre a integridade e o desempenho das cargas de trabalho do Serviço Gerenciado para Apache Spark. As métricas de carga de trabalho incluem métricas do Spark, de lote e de operação.
Use o Cloud Monitoring no console do Google Cloud para analisar métricas, adicionar gráficos, criar painéis e gerar alertas.
Criar painéis
É possível criar um painel para monitorar cargas de trabalho usando métricas de vários projetos e diferentes produtos do Google Cloud . Para mais informações, consulte Criar e gerenciar painéis personalizados.
Servidor de histórico persistente
O Serviço Gerenciado para Apache Spark cria os recursos computacionais necessários para executar uma carga de trabalho, executa a carga de trabalho nesses recursos e os exclui quando a carga de trabalho é concluída. As métricas e os eventos de carga de trabalho não persistem após a conclusão de uma carga de trabalho. No entanto, é possível usar um servidor de histórico permanente (PHS, na sigla em inglês) para reter o histórico de aplicativos de carga de trabalho (logs de eventos) no Cloud Storage.
Para usar um PHS com uma carga de trabalho em lote, faça o seguinte:
Crie um servidor de histórico persistente (PHS) do Serviço Gerenciado para Apache Spark.
Especifique o PHS ao enviar uma carga de trabalho.
Use o gateway de componentes para se conectar ao PHS e ver detalhes do aplicativo, estágios do programador, detalhes do nível da tarefa e informações do ambiente e do executor.
Ajuste automático
- Ativar o ajuste automático para o Serviço Gerenciado para Apache Spark: é possível ativar o ajuste automático para o Serviço Gerenciado para Apache Spark ao enviar cada carga de trabalho em lote recorrente do Spark usando o Google Cloud console, a CLI gcloud ou a API Serviço Gerenciado para Apache Spark.
Console
Siga estas etapas para ativar o ajuste automático em cada carga de trabalho recorrente do Spark em lote:
No console do Google Cloud , acesse a página Jobs do Serviço Gerenciado para Apache Spark.
Para criar uma carga de trabalho em lote, clique em Enviar job para abrir a página Enviar um job.
Em Selecionar o tipo de computação para o job, confirme se a opção Spark sem servidor está selecionada.
Na seção Detalhes do job sem servidor:
- Especifique um código da tarefa ou aceite o ID padrão.
- Selecione um Perfil de ambiente de execução (ou mantenha a Configuração de serviço padrão para sua região) e clique em Configurar no card Resumo (ou clique em Criar novo perfil no menu Perfil de ambiente de execução) para abrir o painel de configuração do perfil de ambiente de execução.
- No painel de configuração do perfil de ambiente de execução, expanda Configuração adicional e clique em Editar ao lado de Outras personalizações.
- No painel Outras personalizações, em Ajuste automático, clique no botão
Ativar e preencha o ID da coorte, que identifica o
lote como uma de uma série de cargas de trabalho recorrentes. A análise assistida pelo Gemini é aplicada à segunda carga de trabalho e às seguintes que são enviadas com esse ID de coorte. Por exemplo, especifique
tpch-query1como o ID de coorte para uma carga de trabalho programada que executa uma consulta TPC-H diária. - Clique em Salvar no painel Outras personalizações e em Usar configuração (ou Salvar novo perfil) no painel de configuração do perfil de ambiente de execução.
Preencha as seções Arquivos e artefatos e Execução e propriedades do job na página Enviar um job conforme necessário e clique em Enviar. Para mais informações, consulte Enviar uma carga de trabalho em lote.
gcloud
Execute o seguinte comando da CLI gcloud
gcloud dataproc batches submit
localmente em uma janela do terminal ou no Cloud Shell
para ativar o ajuste automático em cada carga de trabalho em lote recorrente do Spark:
gcloud dataproc batches submit COMMAND \
    --region=REGION \
    --cohort=COHORT \
    other arguments ...
Substitua:
- COMMAND: o tipo de carga de trabalho do Spark, como
Spark,PySpark,Spark-SqlouSpark-R. - REGION: a região em que a carga de trabalho será executada.
- COHORT: o nome da coorte, que
identifica o lote como uma de uma série de cargas de trabalho recorrentes.
A análise assistida pelo Gemini é aplicada à segunda carga de trabalho e às seguintes que são enviadas
com esse nome de coorte. Por exemplo, especifique
TPCH Query 1como o nome da coorte para uma carga de trabalho programada que executa uma consulta TPC-H diária.
API
Inclua o nome RuntimeConfig.cohort
em uma solicitação batches.create
para ativar o ajuste automático em cada carga de trabalho recorrente
do Spark em lote. O ajuste automático é aplicado à segunda carga de trabalho e às seguintes enviadas com esse nome de coorte. Por exemplo, especifique TPCH-Query1 como o nome da coorte para uma carga de trabalho programada que executa uma consulta TPC-H diária.
Exemplo:
...
runtimeConfig:
  cohort: TPCH-Query1
...