


Questa pagina fornisce una panoramica del ciclo di vita della pipeline, dal codice della pipeline a un job Dataflow.
Questa pagina spiega i seguenti concetti:
- Che cos'è un grafico di esecuzione e come una pipeline Apache Beam diventa un job Dataflow
- Come Dataflow gestisce gli errori
- In che modo Dataflow parallelizza e distribuisce automaticamente la logica di elaborazione nella pipeline ai worker che eseguono il job
- Ottimizzazioni dei job che Dataflow potrebbe apportare
Grafico di esecuzione
Quando esegui la pipeline Dataflow, Dataflow
crea un grafico di esecuzione dal codice che crea l'oggetto Pipeline,
incluse tutte le trasformazioni e le relative funzioni di elaborazione, ad esempio
gli oggetti DoFn. Questo è il grafico di esecuzione della pipeline e la fase è chiamata
tempo di costruzione del grafico.
Durante la costruzione del grafico, Apache Beam esegue localmente il codice dal punto di ingresso principale del codice della pipeline, arrestandosi alle chiamate a un passaggio di origine, sink o trasformazione e trasformando queste chiamate in nodi del grafico.
Di conseguenza, un frammento di codice nel punto di ingresso di una pipeline (metodo Java e Go main
o livello superiore di uno script Python) viene eseguito localmente sulla macchina che
esegue la pipeline. Lo stesso codice dichiarato in un metodo di un oggetto DoFn
viene eseguito nei worker Dataflow.
Ad esempio, l'esempio WordCount incluso negli SDK Apache Beam contiene una serie di trasformazioni per leggere, estrarre, contare, formattare e scrivere le singole parole in una raccolta di testo, insieme a un conteggio delle occorrenze per ogni parola. Il seguente diagramma mostra come le trasformazioni nella pipeline WordCount vengono espanse in un grafico di esecuzione:
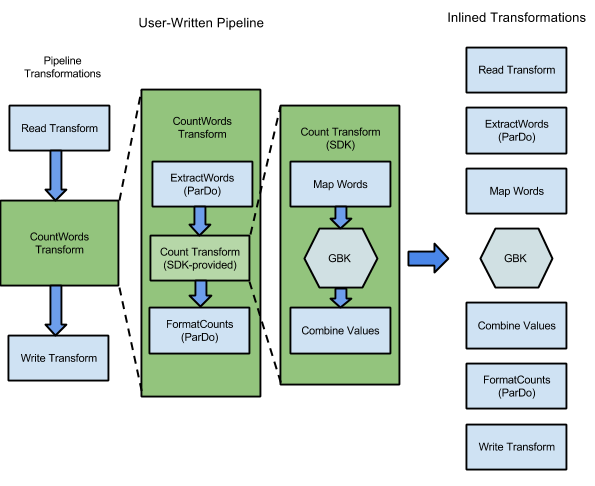
Figura 1: grafico di esecuzione dell'esempio WordCount
Il grafico di esecuzione spesso differisce dall'ordine in cui hai specificato le trasformazioni durante la creazione della pipeline. Questa differenza esiste perché il servizio Dataflow esegue varie ottimizzazioni e fusioni sul grafico di esecuzione prima di essere eseguito su risorse cloud gestite. Il servizio Dataflow rispetta le dipendenze dei dati durante l'esecuzione della pipeline. Tuttavia, i passaggi senza dipendenze di dati tra loro potrebbero essere eseguiti in qualsiasi ordine.
Per visualizzare il grafico di esecuzione non ottimizzato che Dataflow ha generato per la tua pipeline, seleziona il job nell'interfaccia di monitoraggio di Dataflow. Per saperne di più sulla visualizzazione dei job, consulta Utilizzare l'interfaccia di monitoraggio di Dataflow.
Durante la costruzione del grafico, Apache Beam verifica che tutte le risorse a cui fa riferimento la pipeline, come bucket Cloud Storage, tabelle BigQuery e argomenti o sottoscrizioni Pub/Sub, esistano effettivamente e siano accessibili. La convalida viene eseguita tramite chiamate API standard ai rispettivi servizi, pertanto è fondamentale che l'account utente utilizzato per eseguire una pipeline disponga della connettività corretta ai servizi necessari e sia autorizzato a chiamare le API dei servizi. Prima di inviare la pipeline al servizio Dataflow, Apache Beam verifica anche la presenza di altri errori e si assicura che il grafico della pipeline non contenga operazioni illegali.
Il grafico di esecuzione viene quindi tradotto in formato JSON e il grafico di esecuzione JSON viene trasmesso all'endpoint del servizio Dataflow.
Il servizio Dataflow convalida quindi il grafico di esecuzione JSON. Quando il grafico viene convalidato, diventa un job nel servizio Dataflow. Puoi visualizzare il job, il relativo grafico di esecuzione, lo stato e le informazioni dei log utilizzando l'interfaccia di monitoraggio di Dataflow.
Java
Il servizio Dataflow invia una risposta alla macchina in cui esegui
il programma Dataflow. Questa risposta è incapsulata nell'oggetto
DataflowPipelineJob, che contiene il jobId del tuo job Dataflow.
Utilizza jobId per monitorare, monitorare e risolvere i problemi del job utilizzando l'interfaccia di monitoraggio di Dataflow e l'interfaccia a riga di comando di Dataflow.
Per saperne di più, consulta il
riferimento API per DataflowPipelineJob.
Python
Il servizio Dataflow invia una risposta alla macchina in cui esegui
il programma Dataflow. Questa risposta è incapsulata nell'oggetto
DataflowPipelineResult, che contiene il job_id del tuo job Dataflow.
Utilizza job_id per monitorare, tenere traccia e risolvere i problemi relativi al job
utilizzando
l'interfaccia di monitoraggio di Dataflow
e l'interfaccia a riga di comando di Dataflow.
Vai
Il servizio Dataflow invia una risposta alla macchina in cui esegui
il programma Dataflow. Questa risposta è incapsulata nell'oggetto
dataflowPipelineResult, che contiene il jobID del tuo job Dataflow.
Utilizza jobID per monitorare, tenere traccia e risolvere i problemi relativi al job
utilizzando
l'interfaccia di monitoraggio di Dataflow
e l'interfaccia a riga di comando di Dataflow.
La costruzione del grafico avviene anche quando esegui la pipeline localmente, ma il grafico non viene convertito in JSON o trasmesso al servizio. Il grafico viene invece eseguito localmente sulla stessa macchina in cui hai avviato il programma Dataflow. Per saperne di più, consulta Configurazione di PipelineOptions per l'esecuzione locale.
Gestione di errori ed eccezioni
La pipeline potrebbe generare eccezioni durante l'elaborazione dei dati. Alcuni di questi errori sono temporanei, ad esempio la difficoltà temporanea di accedere a un servizio esterno. Altri errori sono permanenti, ad esempio quelli causati da dati di input danneggiati o non analizzabili o da puntatori nulli durante il calcolo.
Dataflow elabora gli elementi in bundle arbitrari e riprova a elaborare l'intero bundle quando viene generato un errore per qualsiasi elemento del bundle. Quando l'esecuzione avviene in modalità batch, i bundle che includono un elemento non riuscito vengono ritentati quattro volte. La pipeline non viene eseguita completamente quando un singolo bundle non è stato eseguito quattro volte. Quando viene eseguito in modalità di streaming, un bundle che include un elemento non riuscito viene ritentato indefinitamente, il che potrebbe causare l'arresto permanente della pipeline.
Quando l'elaborazione avviene in modalità batch, potresti notare un numero elevato di errori individuali prima che un job della pipeline non riesca completamente, il che si verifica quando un bundle specifico non riesce dopo quattro tentativi. Ad esempio, se la pipeline tenta di elaborare 100 bundle, Dataflow potrebbe generare diverse centinaia di errori individuali finché un singolo bundle non raggiunge la condizione di quattro errori per l'uscita.
Gli errori del worker di avvio, come l'impossibilità di installare pacchetti sui worker, sono temporanei. Questo scenario comporta tentativi di ripetizione indefiniti e potrebbe causare l'arresto permanente della pipeline.
Parallelizzazione e distribuzione
Il servizio Dataflow parallelizza e distribuisce automaticamente
la logica di elaborazione nella pipeline tra worker e thread.
Dataflow utilizza le astrazioni nel
modello di programmazione per rappresentare
le funzioni di elaborazione parallela. Ad esempio, le trasformazioni ParDo fanno sì che Dataflow distribuisca il codice di elaborazione, rappresentato dagli oggetti DoFn, a più worker da eseguire contemporaneamente.
Dataflow supporta due dimensioni complementari di parallelismo:
- Parallelismo orizzontale:i dati della pipeline vengono suddivisi ed elaborati in più istanze worker contemporaneamente, gestite dinamicamente utilizzando la scalabilità automatica orizzontale.
- Parallelismo verticale:i dati della pipeline vengono elaborati su più core e thread della CPU su ogni VM worker, gestiti utilizzando la scalabilità dinamica dei thread e la scalabilità automatica verticale.
Dataflow gestisce automaticamente il parallelismo dei job, gestisce il ribilanciamento dinamico del lavoro e ottimizza il grafico di esecuzione tramite le ottimizzazioni di fusione e combinazione. Fattori come origini dati non divisibili, passaggi con un elevato fan-out, distorsione delle chiavi e limiti del sink downstream possono limitare il parallelismo della pipeline.
Per una guida dettagliata su come Dataflow partiziona i dati, esegue lo scale dei worker e risolve i colli di bottiglia del parallelismo, consulta Informazioni sul parallelismo in Dataflow.
Ottimizzazione della fusione
Dopo la convalida del modulo JSON del grafico di esecuzione della pipeline, il
servizio Dataflow potrebbe modificare il grafico per eseguire ottimizzazioni.
Le ottimizzazioni possono includere la fusione di più passaggi o trasformazioni nel grafico di esecuzione della pipeline in singoli passaggi. I passaggi di fusione impediscono al
servizio Dataflow di dover materializzare ogni PCollection intermedio
nella pipeline, il che può essere costoso in termini di memoria e
overhead di elaborazione.
Sebbene tutte le trasformazioni specificate nella creazione della pipeline vengano eseguite sul servizio, per garantire l'esecuzione più efficiente della pipeline, le trasformazioni potrebbero essere eseguite in un ordine diverso o come parte di una trasformazione combinata più grande. Il servizio Dataflow rispetta le dipendenze dei dati tra i passaggi nel grafico di esecuzione, ma altrimenti i passaggi potrebbero essere eseguiti in qualsiasi ordine.
Esempio di fusione
Il seguente diagramma mostra come il grafico di esecuzione dell'esempio WordCount incluso nell'SDK Apache Beam per Java potrebbe essere ottimizzato e unito dal servizio Dataflow per un'esecuzione efficiente:
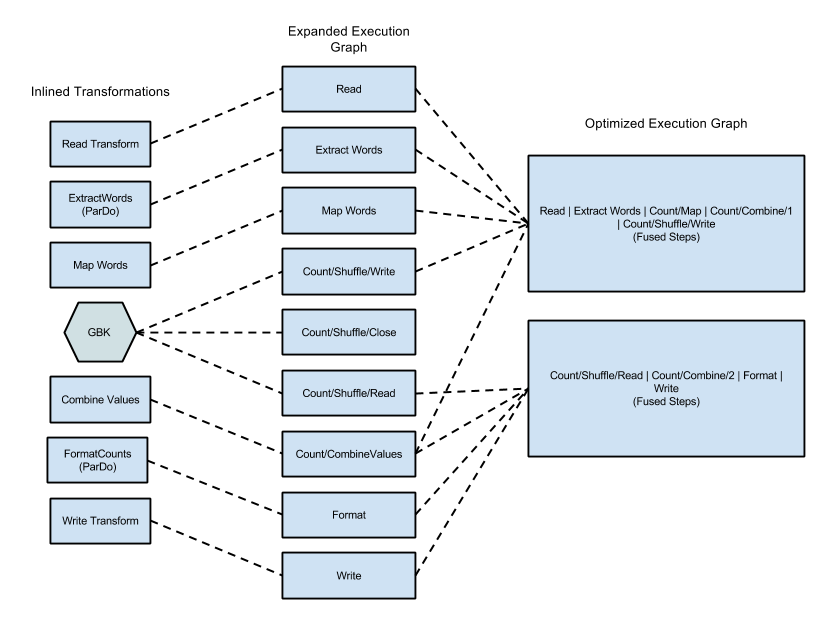
Figura 2: Esempio di grafico di esecuzione ottimizzato di WordCount
Impedire la fusione
In alcuni casi, Dataflow potrebbe indovinare in modo errato il modo ottimale per unire le operazioni nella pipeline, il che può limitare la capacità di Dataflow di utilizzare tutti i worker disponibili. In questi casi,
puoi dare un suggerimento a Dataflow per ridistribuire i dati utilizzando
una trasformazione Redistribute.
Per aggiungere una trasformazione Redistribute, chiama uno dei seguenti metodi:
Redistribute.arbitrarily: indica che è probabile che i dati siano sbilanciati. Dataflow sceglie l'algoritmo migliore per ridistribuire i dati.Redistribute.byKey: indica che unPCollectiondi coppie chiave-valore è probabilmente sbilanciato e deve essere ridistribuito in base alle chiavi. In genere, Dataflow colloca tutti gli elementi di una singola chiave nello stesso thread di lavoro. Tuttavia, la co-localizzazione delle chiavi non è garantita e gli elementi vengono elaborati in modo indipendente.
Se la pipeline contiene una trasformazione Redistribute, Dataflow
di solito impedisce la fusione dei passaggi prima e dopo la trasformazione Redistribute
e rimescola i dati in modo che i passaggi a valle della
trasformazione Redistribute abbiano un parallelismo più ottimale.
Monitoraggio della fusione
Puoi accedere al grafico ottimizzato e alle fasi unite nella console Google Cloud , utilizzando gcloud CLI o l'API.
Console
Per visualizzare le fasi e i passaggi uniti del grafico nella console, nella scheda Dettagli di esecuzione del job Dataflow, apri la visualizzazione del grafico Workflow delle fasi.
Per visualizzare i passaggi dei componenti uniti per una fase, fai clic sulla fase unita nel grafico. Nel riquadro Informazioni sullo stage, la riga Passaggi del componente mostra gli stage uniti. A volte, parti di una singola trasformazione composita vengono unite in più fasi.
gcloud
Per accedere al grafico ottimizzato e alle fasi unite utilizzando gcloud CLI, esegui questo comando gcloud:
gcloud dataflow jobs describe --full JOB_ID --format json
Sostituisci JOB_ID con l'ID del tuo job Dataflow.
Per estrarre i bit pertinenti, reindirizza l'output del comando gcloud a jq:
gcloud dataflow jobs describe --full JOB_ID --format json | jq '.pipelineDescription.executionPipelineStage\[\] | {"stage_id": .id, "stage_name": .name, "fused_steps": .componentTransform }'
Per visualizzare la descrizione delle fasi unite nel file di risposta di output, all'interno dell'array
ComponentTransform, consulta l'oggetto
ExecutionStageSummary.
API
Per accedere al grafico ottimizzato e alle fasi unite utilizzando l'API, chiama
project.locations.jobs.get.
Per visualizzare la descrizione delle fasi unite nel file di risposta di output, all'interno dell'array
ComponentTransform, consulta l'oggetto
ExecutionStageSummary.
Ottimizzazione combinata
Le operazioni di aggregazione sono un concetto importante nell'elaborazione di dati su larga scala.
L'aggregazione riunisce dati concettualmente molto distanti, rendendoli
estremamente utili per la correlazione. Il modello di programmazione Dataflow rappresenta le operazioni di aggregazione come trasformazioni GroupByKey, CoGroupByKey e
Combine.
Le operazioni di aggregazione di Dataflow combinano i dati dell'intero
set di dati, inclusi quelli che potrebbero essere distribuiti tra più worker. Durante queste operazioni di aggregazione, spesso è più efficiente combinare il maggior numero possibile di dati localmente prima di combinarli tra le istanze. Quando applichi una
trasformazione GroupByKey o un'altra trasformazione di aggregazione, il servizio Dataflow
esegue automaticamente la combinazione parziale in locale prima dell'operazione
di raggruppamento principale.
Quando esegue la combinazione parziale o multilivello, il servizio Dataflow prende decisioni diverse a seconda che la pipeline funzioni con dati batch o di streaming. Per i dati delimitati, il servizio privilegia l'efficienza ed esegue il maggior numero possibile di combinazioni locali. Per i dati senza limiti, il servizio privilegia una latenza inferiore e potrebbe non eseguire la combinazione parziale, perché potrebbe aumentare la latenza.