


Questa pagina fornisce indicazioni sulle best practice da seguire durante la creazione e l'esecuzione di workflow Dataflow HPC altamente paralleli, tra cui come utilizzare codice esterno nelle pipeline, come eseguire la pipeline e come gestire la gestione degli errori.
Includere codice esterno nella pipeline
Un elemento chiave di differenziazione per le pipeline altamente parallele è che utilizzano
codice C++ all'interno di
DoFn
anziché uno dei linguaggi standard dell'SDK Apache Beam. Per le pipeline Java, per semplificare l'utilizzo delle librerie C++ nella pipeline, è consigliabile
utilizzare chiamate di procedure esterne. Questa sezione descrive l'approccio generale
utilizzato per l'esecuzione di codice esterno (C++) nelle pipeline Java.
Una definizione di pipeline Apache Beam ha diversi componenti chiave:
PCollectionssono raccolte immutabili di elementi omogenei.PTransformsvengono utilizzati per definire le trasformazioni di unPCollectionche genera un altroPCollection.- La pipeline è il costrutto che ti consente, tramite il codice, di dichiarare le
interazioni tra
PTransformsePCollections. La pipeline è rappresentata come un grafo diretto aciclico (DAG).
Quando utilizzi codice di un linguaggio diverso da quelli standard dell'SDK Apache Beam, inserisci il codice in PTransform, che si trova all'interno di DoFn, e
utilizza uno dei linguaggi SDK standard per definire la pipeline stessa.
Ti consigliamo di utilizzare l'SDK Apache Beam Python per definire la pipeline,
perché l'SDK Python ha una classe di utilità che semplifica l'utilizzo di altro codice. Puoi, tuttavia, utilizzare gli altri SDK Apache Beam.
Puoi utilizzare il codice per condurre esperimenti rapidi senza richiedere una build completa. Per un sistema di produzione, in genere crei i tuoi binari, il che ti dà la libertà di personalizzare la procedura in base alle tue esigenze.
Il seguente diagramma illustra i due utilizzi dei dati della pipeline:
- I dati vengono utilizzati per guidare la procedura.
- I dati vengono acquisiti durante l'elaborazione e uniti ai dati del conducente.
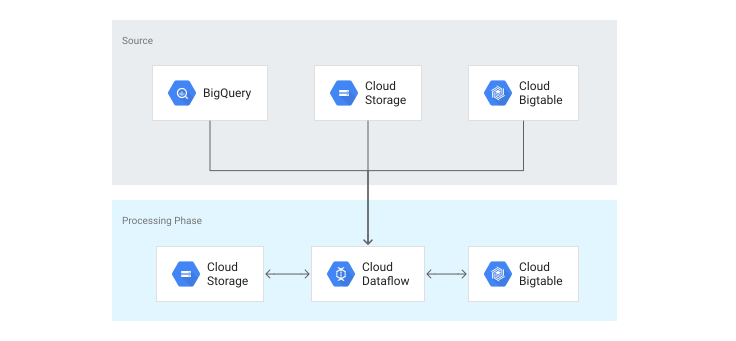
In questa pagina, i dati principali (dall'origine) sono chiamati dati di guida, mentre i dati secondari (dalla fase di elaborazione) sono chiamati dati di unione.
In un caso d'uso finanziario, i dati di guida potrebbero essere alcune centinaia di migliaia di scambi. Ogni operazione deve essere elaborata in combinazione con i dati di mercato. In questo caso, i dati di mercato sono i dati di unione. In un caso d'uso multimediale, i dati di guida potrebbero essere file immagine che richiedono l'elaborazione ma non necessitano di altre origini dati e pertanto non utilizzano i dati di unione.
Considerazioni sulle dimensioni per i dati di guida
Se le dimensioni dell'elemento di dati di guida rientrano nell'intervallo di pochi megabyte,
trattalo con il normale paradigma Apache Beam di creazione di un oggetto PCollection dalla
sorgente e invio dell'oggetto alle trasformazioni Apache Beam per l'elaborazione.
Se la dimensione dell'elemento di dati principale è di molti megabyte o gigabyte, come di solito accade per i contenuti multimediali, puoi inserire i dati principali in Cloud Storage. Poi, nell'oggetto PCollection iniziale, fai riferimento all'URI di archiviazione e viene utilizzato solo un riferimento URI a questi dati.
Considerazioni sulle dimensioni per l'unione dei dati
Se i dati di unione sono di poche centinaia di megabyte o meno, utilizza un input secondario per trasferire questi dati alle trasformazioni Apache Beam. L'input secondario invia il pacchetto di dati a ogni worker che ne ha bisogno.
Se i dati di unione sono nell'intervallo di gigabyte o terabyte, utilizza Bigtable o Cloud Storage per unire i dati di unione ai dati di guida, a seconda della natura dei dati. Bigtable è ideale per gli scenari finanziari in cui si accede spesso ai dati di mercato come ricerche coppia chiave-valore da Bigtable. Per saperne di più sulla progettazione dello schema Bigtable, inclusi i consigli per lavorare con i dati delle serie temporali, consulta la seguente documentazione di Bigtable:
Esegui il codice esterno
Puoi eseguire codice esterno in Apache Beam in molti modi.
Crea un processo chiamato da un oggetto
DoFnall'interno di una trasformazione Dataflow.Utilizza JNI con l'SDK Java.
Crea un sottoprocesso direttamente dall'oggetto
DoFn. Sebbene questo approccio non sia il più efficiente, è solido e semplice da implementare. A causa dei potenziali problemi con l'utilizzo di JNI, questa pagina mostra l'utilizzo di una chiamata di sottoprocesso.
Quando progetti il flusso di lavoro, considera la pipeline end-to-end completa. Eventuali inefficienze nel modo in cui viene eseguito il processo sono compensate dal fatto che lo spostamento dei dati dall'origine al sink viene eseguito con una singola pipeline. Se confronti questo approccio con altri, considera i tempi end-to-end della pipeline, nonché i costi end-to-end.
Trascina i file binari negli host
Quando utilizzi un linguaggio Apache Beam supportato, l'SDK Apache Beam sposta automaticamente tutto il codice richiesto nei worker. Tuttavia, quando effettui una chiamata a un codice esterno, devi spostare il codice manualmente.
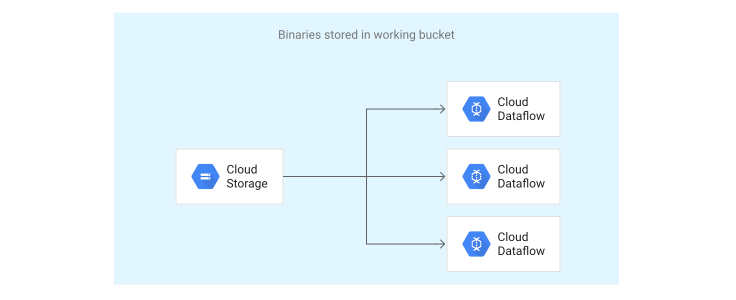
Per spostare il codice: L'esempio mostra i passaggi per l'SDK Java di Apache Beam.
- Archivia il codice esterno compilato, insieme alle informazioni sul controllo delle versioni, in Cloud Storage.
- Nel metodo
@Setup, crea un blocco sincronizzato per verificare se il file di codice è disponibile nella risorsa locale. Anziché implementare un controllo fisico, puoi confermare la disponibilità utilizzando una variabile statica al termine del primo thread. - Se il file non è disponibile, utilizza la libreria client Cloud Storage per
recuperarlo dal bucket Cloud Storage al worker locale. Un approccio consigliato è utilizzare la classe Apache Beam
FileSystemsper questa attività. - Dopo aver spostato il file, verifica che il bit di esecuzione sia impostato sul file di codice.
- In un sistema di produzione, controlla l'hash dei file binari per assicurarti che il file sia stato copiato correttamente.
Anche l'utilizzo della funzione Apache Beam
filesToStage
è un'opzione, ma rimuove alcuni dei vantaggi della capacità del runner di comprimere e spostare automaticamente il codice Java. Inoltre,
poiché la chiamata al sottoprocesso richiede un percorso di file assoluto, devi
utilizzare il codice per determinare il percorso di classe e quindi la posizione del file
spostato da filesToStage. Non consigliamo questo approccio.
Esegui i file binari esterni
Prima di poter eseguire codice esterno, devi creare un wrapper. Scrivi questo wrapper nello stesso linguaggio del codice esterno (ad esempio C++) o come uno script shell. Il wrapper consente di passare gli handle dei file e implementare le ottimizzazioni descritte nella sezione Progettare l'elaborazione per cicli di CPU ridotti di questa pagina. Il wrapper non deve essere sofisticato. Il seguente snippet mostra la struttura di un wrapper in C++.
int main(int argc, char* argv[])
{
    if(argc < 3){
        std::cerr << "Required return file and data to process" << '\n';
        return 1;
    }

    std::string returnFile = argv[1];
    std::string word = argv[2];

    std::ofstream myfile;
    myfile.open (returnFile);
    myfile << word;
    myfile.close();
    return 0;
}
Questo codice legge due parametri dall'elenco degli argomenti. Il primo parametro è la posizione del file di restituzione in cui vengono inseriti i dati. Il secondo parametro sono i dati che il codice restituisce all'utente. Nelle implementazioni reali, questo codice farebbe molto di più che ripetere "Hello, world".
Dopo aver scritto il codice wrapper, esegui il codice esterno nel seguente modo:
- Trasmetti i dati ai file binari del codice esterno.
- Esegui i file binari, rileva eventuali errori e registra errori e risultati.
- Gestisci le informazioni di logging.
- Acquisire i dati dall'elaborazione completata.
Trasmettere i dati ai file binari
Per avviare la procedura di esecuzione della libreria, trasmetti i dati al codice C++. In questo passaggio puoi sfruttare l'integrazione di Dataflow con altri Google Cloud strumenti. Uno strumento come Bigtable può gestire set di dati molto grandi e gestire l'accesso a bassa latenza e ad alta concorrenza, consentendo a migliaia di core di accedere contemporaneamente al set di dati. Inoltre, Bigtable può pre-elaborare i dati, consentendo la modellazione, l'arricchimento e il filtraggio dei dati. Tutto questo lavoro può essere svolto nelle trasformazioni di Apache Beam prima di eseguire il codice esterno.
Per un sistema di produzione, il percorso consigliato è utilizzare un buffer di protocollo per incapsulare i dati di input. Puoi convertire i dati di input in byte e codificarli in base64 prima di passarli alla libreria esterna. I due modi per passare questi dati alla libreria esterna sono i seguenti:
- Dati di input di piccole dimensioni. Per i dati di piccole dimensioni che non superano la lunghezza massima di un argomento di comando, passa l'argomento nella posizione 2 del processo in fase di creazione con
java.lang.ProcessBuilder. - Grandi quantità di dati di input. Per dimensioni dei dati più grandi, crea un file il cui nome includa un UUID per contenere i dati richiesti dal processo.
Esegui il codice C++, rileva gli errori e registra
L'acquisizione e la gestione delle informazioni sugli errori sono una parte fondamentale della pipeline. Le risorse utilizzate dal runner Dataflow sono effimere ed è spesso difficile ispezionare i file di log dei worker. Devi assicurarti di acquisire e inviare tutte le informazioni utili al logging del runner Dataflow e di archiviare i dati di logging in uno o più bucket Cloud Storage.
L'approccio consigliato è reindirizzare stdout e stderr ai file, il che
ti consente di evitare qualsiasi considerazione relativa all'esaurimento della memoria. Ad esempio, nel
runner Dataflow che chiama il codice C++, puoi includere righe
come le seguenti:
Java
  import java.lang.ProcessBuilder.Redirect;
  ...
      processbuilder.redirectError(Redirect.appendTo(errfile));
      processbuilder.redirectOutput(Redirect.appendTo(outFile));
Python
# Requires Apache Beam 2.34 or later.
stopping_times, bad_values = (
    integers
    | beam.Map(collatz.total_stopping_time).with_exception_handling(
        use_subprocess=True))

# Write the bad values to a side channel.
bad_values | 'WriteBadValues' >> beam.io.WriteToText(
    os.path.splitext(output_path)[0] + '-bad.txt')
Gestire le informazioni di logging
Molti casi d'uso prevedono l'elaborazione di milioni di elementi. L'elaborazione riuscita genera log di scarso o nessun valore, pertanto devi prendere una decisione aziendale in merito alla conservazione dei dati di log. Ad esempio, prendi in considerazione queste alternative alla conservazione di tutti i dati di log:
- Se le informazioni contenute nei log dell'elaborazione degli elementi riuscita non sono utili, non conservarle.
- Crea una logica che campioni i dati di log, ad esempio campionando solo ogni 10.000 voci di log. Se l'elaborazione è omogenea, ad esempio quando molte iterazioni del codice generano dati di log essenzialmente identici, questo approccio fornisce un equilibrio efficace tra la conservazione dei dati di log e l'ottimizzazione dell'elaborazione.
Per le condizioni di errore, la quantità di dati scaricati nei log potrebbe essere elevata. Una strategia efficace per gestire grandi quantità di dati dei log di errori consiste nel leggere le prime righe della voce di log e inviarle a Cloud Logging. Puoi caricare il resto del file di log nei bucket Cloud Storage. Questo approccio ti consente di esaminare in un secondo momento le prime righe dei log degli errori e, se necessario, fare riferimento a Cloud Storage per l'intero file.
È utile anche controllare le dimensioni del file di log. Se la dimensione del file è zero, puoi ignorarlo tranquillamente o registrare un messaggio di log che indica che il file non conteneva dati.
Acquisire i dati dal trattamento completato
Non è consigliabile utilizzare stdout per passare il risultato del calcolo
alla funzione DoFn. Anche altro codice chiamato dal tuo codice C++, e persino il tuo
codice, potrebbe inviare messaggi a stdout, contaminando lo stream stdoutput
che altrimenti contiene dati di logging. Invece, è una best practice
apportare una modifica al codice wrapper C++ per consentire al codice di accettare un parametro
che indica dove creare il file che memorizza il valore. Idealmente, questo file deve essere archiviato in modo indipendente dalla lingua utilizzando i protocol buffer, che consentono al codice C++ di passare un oggetto al codice Java o Python. L'oggetto DoFn
può leggere il risultato direttamente dal file e passare le informazioni
sul risultato alla propria chiamata output.
L'esperienza ha dimostrato l'importanza di eseguire test delle unità che riguardano il processo stesso. È importante implementare un test delle unità che esegua il processo indipendentemente dalla pipeline Dataflow. Il debug della libreria può essere eseguito in modo molto più efficiente se è autonoma e non deve eseguire l'intera pipeline.
Elaborazione del design per cicli della CPU ridotti
La chiamata di un sottoprocesso comporta un overhead. A seconda del workload, potresti dover svolgere un lavoro extra per ridurre il rapporto tra il lavoro svolto e l'overhead amministrativo di avvio e arresto del processo.
Nel caso d'uso dei media, le dimensioni dell'elemento di dati principale potrebbero essere nell'ordine di centinaia di megabyte o di gigabyte. Di conseguenza, l'elaborazione di ogni elemento di dati può richiedere molti minuti. In questo caso, il costo della chiamata al sottoprocesso è insignificante rispetto al tempo di elaborazione complessivo. L'approccio migliore in questa situazione è far sì che un singolo elemento avvii la propria procedura.
Tuttavia, in altri casi d'uso, come la finanza, l'elaborazione richiede unità di tempo CPU molto piccole (decine di millisecondi). In questo caso, l'overhead di
chiamata del sottoprocesso è sproporzionatamente grande. Una soluzione a questo problema
è utilizzare la trasformazione
GroupByKey
di Apache Beam per creare batch di 50-100 elementi da inserire nel
processo. Ad esempio, puoi seguire questi passaggi:
- In una
funzione
DoFn, crea una coppia chiave-valore. Se elabori operazioni finanziarie, puoi utilizzare il numero dell'operazione come chiave. Se non hai un numero univoco da utilizzare come chiave, puoi generare un checksum dai dati e utilizzare una funzione modulo per creare partizioni di 50 elementi. - Invia la chiave a una funzione
GroupByKey.create, che restituisce una raccoltaKV<key,Iterable<data>>contenente i 50 elementi che puoi quindi inviare al processo.
Limita il parallelismo dei worker
Quando lavori con una lingua supportata in modo nativo nel runner Dataflow, non devi mai pensare a cosa succede al worker. Dataflow ha molti processi che supervisionano il controllo del flusso e i thread in modalità batch o flusso.
Tuttavia, se utilizzi un linguaggio esterno come C++, tieni presente che l'avvio di subprocessi è un'operazione un po' insolita. In modalità batch, il runner Dataflow utilizza un piccolo rapporto tra thread di lavoro e CPU rispetto alla modalità di streaming. È consigliabile, soprattutto in modalità streaming, creare un semaforo all'interno della classe per controllare più direttamente il parallelismo di un singolo worker.
Ad esempio, con l'elaborazione multimediale, potresti non voler che centinaia di elementi di transcodifica
vengano elaborati in parallelo da un singolo worker. In casi come questi,
puoi creare una classe di utilità che fornisca le autorizzazioni alla funzione DoFn per
il lavoro in corso. L'utilizzo di questa classe ti consente di controllare direttamente
i thread di lavoro all'interno della pipeline.
Utilizza sink di dati ad alta capacità in Google Cloud
Una volta elaborati, i dati vengono inviati a un data sink. Il sink deve essere in grado di gestire il volume di risultati creati dalla soluzione di elaborazione della griglia.
Il seguente diagramma mostra alcuni dei sink disponibili in Google Cloud quando Dataflow esegue un workload a griglia.
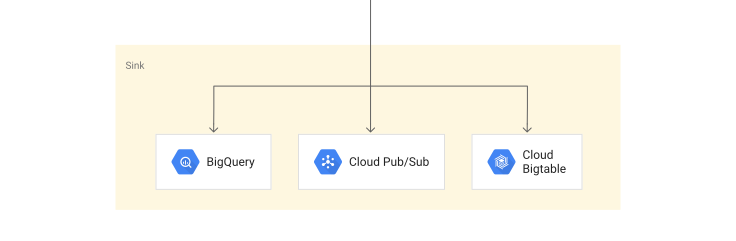
Bigtable, BigQuery e Pub/Sub possono gestire flussi di dati molto grandi. Ad esempio, ogni nodo Bigtable può gestire 10.000 inserimenti al secondo di dimensioni fino a 1 KB con scalabilità orizzontale. Di conseguenza, un cluster Bigtable di 100 nodi può assorbire 1.000.000 di messaggi al secondo generati dalla griglia Dataflow.
Gestisci errori di segmentazione
Quando utilizzi il codice C++ all'interno di una pipeline, devi decidere come gestire i segfault, perché hanno ramificazioni non locali se non vengono gestiti correttamente. Dataflow Runner crea i processi necessari in Java, Python o Go, quindi assegna il lavoro ai processi sotto forma di bundle.
Se la chiamata al codice C++ viene eseguita utilizzando strumenti strettamente accoppiati, come JNI o Cython, e il processo C++ genera un errore di segmentazione, si arrestano in modo anomalo anche il processo chiamante e la Java Virtual Machine (JVM). In questo scenario, i punti dati errati non sono rilevabili. Per rendere rilevabili i punti dati errati, utilizza un accoppiamento più libero, che separa i dati errati e consente alla pipeline di continuare. Tuttavia, con codice C++ maturo che è completamente testato rispetto a tutte le varianti di dati, puoi utilizzare meccanismi come Cython.
Passaggi successivi
Segui il tutorial per creare una pipeline che utilizza container personalizzati con librerie C++.
Visualizza il codice di esempio per questa pagina nel repository GitHub di Apache Beam.
Scopri di più sulla creazione di pipeline con Apache Beam.