


I workload altamente paralleli, noti anche come workload estremamente paralleli, sono comuni nelle aziende di finanza, media e scienze biologiche. Per carichi di lavoro paralleli come questi, le aziende in genere implementano un cluster di nodi di calcolo. Ogni nodo può eseguire attività di elaborazione indipendenti, in una configurazione denominata grid computing. Per elaborare i dati per i workload paralleli, puoi utilizzare Apache Beam con Dataflow. Per saperne di più su Apache Beam, consulta la guida alla programmazione di Apache Beam.
L'utilizzo di Dataflow per carichi di lavoro altamente paralleli offre molti vantaggi.
- Crea un flusso di lavoro completamente gestito, con l'elaborazione e l'orchestrazione dei dati nella stessa pipeline.
- L'interfaccia utente e l'API Dataflow includono funzionalità di osservabilità.
- Dataflow dispone di registrazione centralizzata per tutte le fasi della pipeline.
- Dataflow offre la scalabilità automatica per massimizzare le prestazioni e ottimizzare l'utilizzo delle risorse.
- Dataflow è tollerante agli errori e fornisce il bilanciamento del carico dinamico.
- Dataflow offre il rilevamento e la correzione degli straggler.
- Utilizza un unico sistema per tutti gli aspetti della pipeline, sia per la pre-elaborazione che per la post-elaborazione e per l'elaborazione delle attività. Puoi persino utilizzare il codice C++ esistente nella pipeline.
- Utilizza l'elaborazione exactly-once integrata fornita da Dataflow.
Inoltre, Dataflow include varie funzionalità di sicurezza:
- Utilizza la chiave di crittografia gestita dal cliente (CMEK) con la pipeline.
- Definisci le regole firewall per la rete associata al tuo job Dataflow.
- Utilizza una rete VPC.
Questi carichi di lavoro richiedono la distribuzione dei dati a funzioni eseguite su molti core. Questa distribuzione spesso richiede letture con concorrenza molto elevata seguite da un'ampia distribuzione dei dati, assorbiti dai sistemi downstream. Le competenze principali di Dataflow sono la distribuzione dei carichi di lavoro batch e di flusso tra le risorse e la gestione della scalabilità automatica e del ribilanciamento dinamico del lavoro tra queste risorse. Pertanto, quando utilizzi Dataflow per i tuoi carichi di lavoro altamente paralleli, le esigenze di prestazioni, scalabilità, disponibilità e sicurezza vengono gestite automaticamente.
Incorporare codice esterno nella pipeline
Apache Beam dispone di SDK integrati per Java, Python e Go. Tuttavia, molti carichi di lavoro altamente paralleli utilizzano codice scritto in C++. Puoi utilizzare Dataflow e altri servizi Google Cloud per eseguire file binari (librerie) C++ come codice esterno utilizzando Apache Beam. L'inclusione di binari C++ ti consente di sbloccare questi tipi di workload utilizzando servizi completamente gestiti. Inoltre, ti consente di creare pipeline complete utilizzando un sofisticato grafo diretto aciclico (DAG).
Lo stesso approccio per l'esecuzione di file binari C++ è valido anche per il codice scritto in altri linguaggi in cui è possibile compilare un file binario autonomo.
Pipeline end-to-end altamente parallele
Con Dataflow, puoi eseguire l'elaborazione di lettura e scrittura di I/O, l'analisi e l'output delle attività nella stessa pipeline. In questo modo puoi eseguire pipeline complete altamente parallele.
Ad esempio, un carico di lavoro HPC altamente parallelo potrebbe incorporare i seguenti passaggi:
Importa dati non elaborati da origini interne ed esterne. I dati potrebbero provenire da origini senza limiti o con limiti. Le origini illimitate vengono per lo più convertite in origini limitate per adattarsi alle tecnologie utilizzate per la suddivisione delle attività.
Preelabora i dati non elaborati in una forma e una codifica dei dati che il componente di task farming può utilizzare.
Utilizza un sistema per distribuire i calcoli agli host e recuperare i dati da un'origine, quindi materializza i risultati per l'analisi successiva.
Esegui l'analisi post-elaborazione per convertire i risultati in output.
Puoi utilizzare Dataflow per gestire tutti questi passaggi in un'unica pipeline sfruttando le funzionalità di Dataflow:
Poiché un unico sistema è responsabile di tutte le fasi, non hai bisogno di un sistema di orchestrazione esterno per coordinare l'esecuzione di più pipeline.
Con la località dei dati, non è necessario materializzare e dematerializzare esplicitamente tra i limiti dello stage, aumentando l'efficienza.
Grazie a una migliore telemetria nel sistema, sono disponibili informazioni sul numero totale di byte nella fase che aiutano a progettare le fasi successive.
Con la scalabilità automatica, quando i dati si trovano nel sistema, le risorse vengono scalate in base ai volumi di dati man mano che i dati si spostano nelle fasi della pipeline.
La pipeline Dataflow HPC altamente parallela principale utilizza motori di esecuzione DAG moderni. Tutti i processi tipici della pipeline possono essere completati in un unico DAG e, pertanto, in un'unica pipeline Dataflow. Puoi utilizzare un DAG generato da Apache Beam per definire la forma della pipeline.
Se esegui la migrazione da un sistema di task farm a un flusso di lavoro altamente parallelo, devi passare dalle attività ai dati. Un PTransform contiene un
DoFn,
che ha una funzione di elaborazione che accetta un elemento di dati. Il punto dati può essere
qualsiasi oggetto con una o più proprietà.
Utilizzando un DAG e una singola pipeline, puoi caricare tutti i dati all'interno del sistema durante l'intero flusso di lavoro. Non è necessario inviare i dati a database o spazi di archiviazione.
Google Cloud componenti utilizzati con workflow altamente paralleli
Le applicazioni di grid computing richiedono che i dati vengano distribuiti alle funzioni in esecuzione su molti core. Questo pattern spesso richiede letture ad alta concorrenza ed è spesso seguito da un ampio fan-out dei dati assorbiti dai sistemi downstream.
Dataflow è integrato con altri Google Cloud servizi gestiti che possono assorbire I/O di dati parallelizzati su larga scala:
- Pub/Sub: servizio di importazione di flussi di eventi globali
- Bigtable: datastore a colonne per la memorizzazione nella cache e l'erogazione
- Cloud Storage: archivio di oggetti unificato
- BigQuery: servizio di data warehouse su scala petabyte
Se utilizzati insieme, questi servizi forniscono una soluzione interessante per i carichi di lavoro altamente paralleli.
L'architettura comune per i workload altamente paralleli in esecuzione su Google Cloud include quanto segue:
Dataflow Runner per Apache Beam. Questo runner distribuisce il lavoro ai nodi della griglia con un flusso di elaborazione derivato da un DAG. Un singolo DAG Apache Beam consente di definire pipeline complesse multifase in cui le fasi della pipeline parallele possono essere riunite utilizzando input secondari o join.
Cloud Storage. Questo servizio fornisce una posizione in cui preparare i file binari C++. Quando è necessario archiviare file di grandi dimensioni, come in molti casi d'uso multimediali, questi file risiedono anche in Cloud Storage.
Bigtable, BigQuery e Pub/Sub. Questi servizi vengono utilizzati sia come origini che come destinazioni.
Il seguente diagramma mostra l'architettura di alto livello per un flusso di lavoro di esempio.
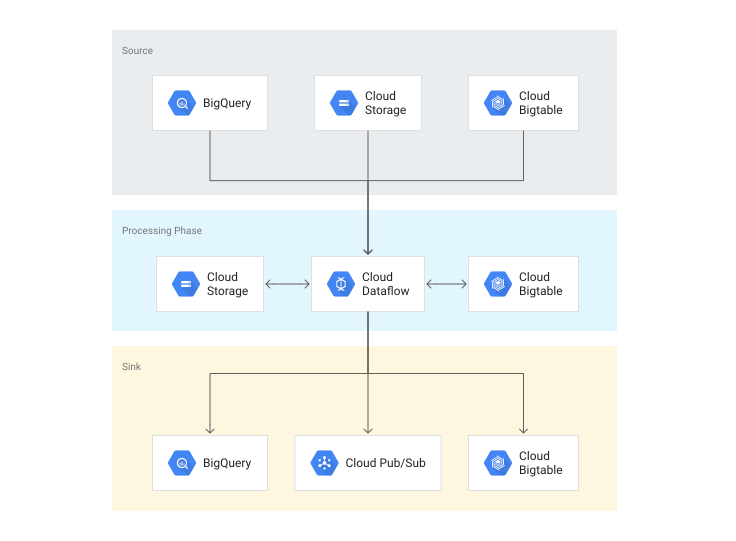
Puoi anche utilizzare altri sistemi di archiviazione. Per maggiori dettagli, consulta l'elenco dei sistemi di archiviazione e delle origini di streaming nella pagina I/O della pipeline nella documentazione di Apache Beam.
Dataflow Runner per Apache Beam
Utilizza Dataflow per trasformare e arricchire i dati in modalità streaming e batch. Dataflow si basa su Apache Beam.
Cloud Storage
Cloud Storage è un'archiviazione di oggetti unificata che comprende la pubblicazione di dati in tempo reale, l'analisi dei dati, il machine learning (ML) e l'archiviazione dei dati. Per i carichi di lavoro altamente paralleli con Dataflow, Cloud Storage fornisce l'accesso ai file binari C++. In alcuni casi d'uso, Cloud Storage fornisce anche la posizione dei dati necessari per la fase di elaborazione.
Per i carichi di lavoro ad alta intensità richiesti dal grid computing, devi comprendere le caratteristiche delle prestazioni di Cloud Storage. Per saperne di più sulle prestazioni di pubblicazione dei dati di Cloud Storage, consulta Linee guida per tasso di richieste e distribuzione degli accessi nella documentazione di Cloud Storage.
Bigtable
Bigtable è un servizio di database NoSQL ad alte prestazioni ottimizzato per carichi di lavoro analitici e operativi di grandi dimensioni.
Bigtable è complementare a Dataflow. Le caratteristiche principali di Bigtable, ovvero letture e scritture a bassa latenza (6 ms al 90° percentile), consentono di gestire molte migliaia di client simultanei e carichi di lavoro con picchi elevati. Queste funzionalità rendono Bigtable
ideale come sink e come origine dati all'interno della funzione DoFn nella
fase di elaborazione di Dataflow.
BigQuery
BigQuery è un data warehouse aziendale veloce, economico e completamente gestito per l'analisi di dati su larga scala. I risultati della griglia vengono spesso utilizzati per l'analisi e consentono di eseguire aggregazioni su larga scala sull'output dei dati della griglia.
Pub/Sub
Pub/Sub è un servizio di messaggistica asincrono e scalabile che disaccoppia i servizi che producono messaggi da quelli che li elaborano. Puoi utilizzare Pub/Sub per pipeline di analisi dei flussi di dati e integrazione dei dati al fine di importare e distribuire i dati. È altrettanto efficace come middleware orientato alla messaggistica per l'integrazione di servizi o come coda per parallelizzare le attività.
Il DAG Dataflow
Puoi utilizzare l'SDK Apache Beam per creare DAG espressivi, che a loro volta ti consentono di creare pipeline multi-stadio in modalità batch o flusso. Lo spostamento dei dati viene gestito
dal runner, con i dati espressi come
oggetti PCollection, che sono raccolte di elementi paralleli immutabili.
Il seguente diagramma illustra questo flusso.
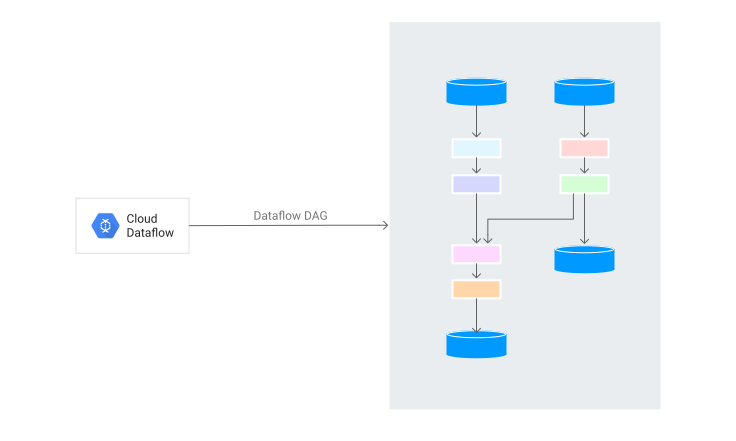
L'SDK Apache Beam consente di definire un DAG. Nel DAG puoi includere codice definito dall'utente come funzioni. In genere, per la dichiarazione del DAG e per il codice definito dall'utente viene utilizzato lo stesso linguaggio di programmazione (Java, Python o Go). Puoi anche utilizzare codice non integrato, ad esempio C++, per il codice definito dall'utente.
Passaggi successivi
- Scopri le best practice per lavorare con le pipeline altamente parallele di Dataflow HPC.
- Segui il tutorial per creare una pipeline che utilizza container personalizzati con librerie C++.