


Hochgradig parallele Arbeitslasten, auch als Embarrassingly-Parallel-Arbeitslasten bezeichnet, sind in den Finanz-, Medien- und Life-Science-Unternehmen üblich. Bei parallelen Arbeitslasten wie diesen stellen Unternehmen in der Regel einen Cluster aus Rechenknoten bereit. Jeder Knoten kann unabhängige Verarbeitungsaufgaben in einer Konfiguration ausführen, die als Grid-Computing bezeichnet wird. Zur Verarbeitung von Daten für parallele Arbeitslasten können Sie Apache Beam mit Dataflow verwenden. Weitere Informationen zu Apache Beam finden Sie im Apache Beam-Programmierhandbuch.
Die Verwendung von Dataflow für hochparallele Arbeitslasten bietet viele Vorteile.
- Erstellen Sie einen vollständig verwalteten Workflow mit Datenverarbeitung und Orchestrierung in derselben Pipeline.
- Die Dataflow-Benutzeroberfläche und ‑API enthalten Funktionen zur Beobachtbarkeit.
- Dataflow bietet eine zentrale Protokollierung für alle Pipelinephasen.
- Dataflow bietet Autoscaling, um die Leistung zu maximieren und die Ressourcennutzung zu optimieren.
- Dataflow ist fehlertolerant und bietet dynamisches Load-Balancing.
- Dataflow bietet Erkennung und Korrektur von Stragglern.
- Verwenden Sie ein einziges System für alle Aspekte der Pipeline, sowohl für die Vor- als auch für die Nachbearbeitung und für die Aufgabenverarbeitung. Sie können sogar den vorhandenen C++-Code in der Pipeline verwenden.
- Verwenden Sie die integrierte genau einmalige Verarbeitung von Dataflow.
Dataflow bietet außerdem verschiedene Sicherheitsfunktionen:
- Verwenden Sie mit Ihrer Pipeline den kundenverwalteten Verschlüsselungsschlüssel (CMEK).
- Definieren Sie Firewallregeln für das Netzwerk, das Ihrem Dataflow-Job zugeordnet ist.
- Verwenden Sie ein VPC-Netzwerk.
Bei diesen Arbeitslasten ist die Verteilung von Daten an Funktionen erforderlich, die über viele Kerne ausgeführt werden. Diese Verteilung erfordert oft hochparallele Lesevorgänge, gefolgt von einem großen Daten-Fan-Out, das von nachgelagerten Systemen aufgefangen wird. Die Kernkompetenzen von Dataflow sind die Verteilung von Batch- und Stream-Arbeitslasten auf Ressourcen sowie die Verwaltung von Autoscaling und dynamischem Arbeitsausgleich auf diesen Ressourcen. Daher werden Leistung, Skalierbarkeit, Verfügbarkeit und Sicherheitsanforderungen automatisch verarbeitet, wenn Sie Dataflow für Ihre hochparallelen Arbeitslasten verwenden.
Externen Code in Ihre Pipeline einbinden
Apache Beam hat integrierte SDKs für Java, Python und Go. Viele hoch parallele Arbeitslasten verwenden jedoch Code, der in C++ geschrieben ist. Sie können Dataflow und andere Google Cloud -Dienste verwenden, um C++-Binärdateien (Bibliotheken) als externen Code mit Apache Beam auszuführen. Wenn Sie C++-Binärdateien einbinden, können Sie diese Arten von Arbeitslasten mit vollständig verwalteten Diensten nutzen. Außerdem haben Sie so die Möglichkeit, vollständige Pipelines mit einem ausgefeilten gerichteten azyklischen Graphen (Directed Acyclic Graph, DAG) zu erstellen.
Derselbe Ansatz zum Ausführen von C++-Binärdateien ist auch für Code relevant, der in anderen Sprachen geschrieben wurde, wenn Sie eine eigenständige Binärdatei kompilieren.
Hochparallele End-to-End-Pipelines
Mit Dataflow können Sie die Verarbeitung von E/A-Lese-/Schreibvorgängen, Analysen und Aufgabenausgabe in derselben Pipeline ausführen. So können Sie hochparallele Pipelines ausführen.
Eine hochparallele HPC-Arbeitslast kann beispielsweise die folgenden Schritte enthalten:
Rohdaten aus internen und externen Quellen aufnehmen Daten können aus unbegrenzten oder begrenzten Quellen stammen. Unbegrenzte Quellen werden meist in begrenzte Quellen umgewandelt, um den für das Task Farming verwendeten Technologien gerecht zu werden.
Verarbeiten Sie die Rohdaten vorab in ein Datenformat und eine Codierung, die von der Task-Farming-Komponente verwendet werden können.
Verwenden Sie ein System, um die Berechnungen auf Hosts zu verteilen und Daten aus einer Quelle abzurufen. Die Ergebnisse werden dann für die Nachanalyse materialisiert.
Führen Sie eine Nachanalyse durch, um die Ergebnisse in die Ausgabe umzuwandeln.
Mit Dataflow können Sie alle diese Schritte in einer einzigen Pipeline verwalten und gleichzeitig die Dataflow-Funktionen nutzen:
Da ein einzelnes System für alle Phasen verantwortlich ist, benötigen Sie kein externes Orchestrierungssystem, um das Ausführen mehrerer Pipelines zu koordinieren.
Bei der Datenlokalisierung müssen Sie die Phasengrenzen nicht explizit materialisieren und dematerialisieren, was die Effizienz erhöht.
Durch eine bessere Telemetrie innerhalb des Systems stehen Informationen zur Gesamtzahl der Byte in der Phase zur Verfügung, was zum Entwerfen späterer Phasen hilfreich ist.
Wenn sich die Daten im System befinden, werden die Ressourcen beim Autoscaling basierend auf den Datenvolumen skaliert, während sich die Daten durch die Pipelinephasen bewegen.
Die hochparallele Dataflow-HPC-Pipeline verwendet moderne DAG-Ausführungsengines. Alle typischen Pipelineprozesse können in einem einzigen DAG und damit in einer einzigen Dataflow-Pipeline ausgeführt werden. Sie können einen von Apache Beam generierten DAG verwenden, um die Form der Pipeline zu definieren.
Wenn Sie von einem Task-Farm-System zu einem hochparallelen Workflow migrieren, müssen Sie von Aufgaben zu Daten wechseln. Ein PTransform enthält ein DoFn mit einer Prozessfunktion, die ein Datenelement entgegennimmt. Der Datenpunkt kann ein beliebiges Objekt mit einem oder mehreren Attributen sein.
Mit einem DAG und einer einzelnen Pipeline können Sie alle Daten im System während des gesamten Workflows laden. Sie müssen keine Daten in Datenbanken oder Speicher ausgeben.
Mit hochparallelen Workflows verwendeteGoogle Cloud -Komponenten
In Grid-Computing-Anwendungen werden Daten an Funktionen verteilt, die auf vielen Kernen ausgeführt werden. Dieser Ansatz erfordert oft hochgradig parallele Lesevorgänge und ist häufig von einem großen Daten-Fan-Out gefolgt, der von nachgeordneten Systemen aufgefangen wird.
Dataflow ist in andere Google Cloud verwaltete Dienste integriert, die massive parallele Daten-E/A verarbeiten können:
- Pub/Sub: Globaler Dienst zum Erfassen von Ereignisstreams
- Bigtable: Spaltenorientierter Speicher für das Caching und die Bereitstellung
- Cloud Storage: Einheitlicher Objektspeicher
- BigQuery: Data-Warehouse-Dienst im Petabyte-Bereich
Zusammen bieten diese Dienste eine überzeugende Lösung für hochparallele Arbeitslasten.
Die gängige Architektur für hochparallele Arbeitslasten, die aufGoogle Cloud ausgeführt werden, umfasst Folgendes:
Den Dataflow-Runner für Apache Beam. Dieser Runner verteilt die Arbeit auf die Grid-Knoten mit einem Verarbeitungsablauf, der aus einem DAG abgeleitet wird. Mit einem einzelnen Apache Beam-DAG können Sie komplexe mehrstufige Pipelines definieren, in denen parallele Pipelinephasen mithilfe von side-inputs oder joins zusammengeführt werden können.
Cloud Storage. Dieser Dienst stellt einen Speicherort für die C++-Binärdateien bereit. Wenn große Dateien gespeichert werden müssen, wie es zum Beispiel in Medienunternehmen der Fall ist, befinden sich diese Dateien ebenfalls in Cloud Storage.
Bigtable, BigQuery und Pub/Sub. Diese Dienste werden als Quellen und als Senken verwendet.
Das folgende Diagramm zeigt die allgemeine Architektur für einen Beispielworkflow.
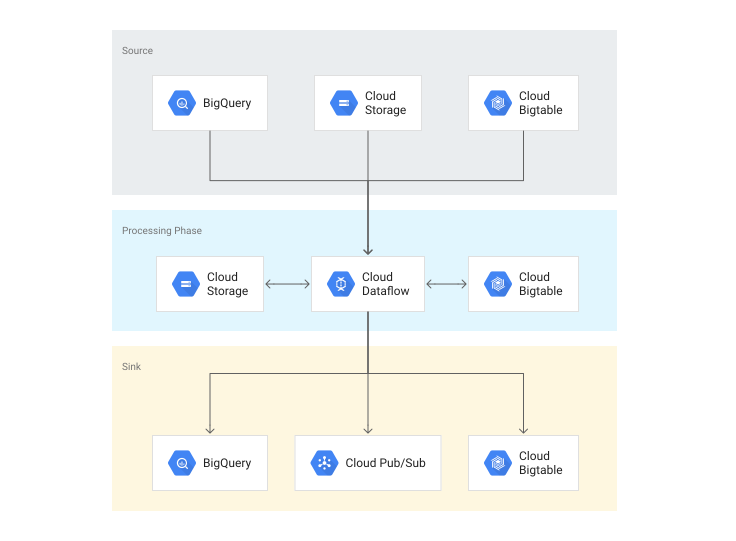
Sie können auch andere Speichersysteme verwenden. Einzelheiten entnehmen Sie der Liste der Speichersysteme und Streaming-Quellen auf der Pipeline-I/O-Seite der Apache Beam-Dokumentation.
Dataflow-Runner für Apache Beam
Mit Dataflow können Sie Ihre Daten sowohl im Streaming- als auch im Batchmodus transformieren und anreichern. Dataflow basiert auf Apache Beam.
Cloud Storage
Cloud Storage ist ein einheitlicher Objektspeicher, der die Bereitstellung von Livedaten, Datenanalyse, maschinelles Lernen (ML) und Datenarchivierung umfasst. Für hochgradig parallele Arbeitslasten mit Dataflow bietet Cloud Storage Zugriff auf C++-Binärdateien. In einigen Anwendungsfällen ist Cloud Storage auch der Speicherort für Daten, die in der Verarbeitungsphase benötigt werden.
Sie müssen die Leistungsmerkmale von Cloud Storage kennen, um mit den für das Grid-Computing typischen High-Burst-Lasten umgehen zu können. Weitere Informationen zur Leistung von Cloud Storage beim Bereitstellen von Daten finden Sie in der Cloud Storage-Dokumentation unter Richtlinien für Anforderungsrate und Zugriffsverteilung.
Bigtable
Bigtable ist ein leistungsstarker NoSQL-Datenbankdienst, der für umfangreiche analytische und operative Arbeitslasten optimiert ist.
Bigtable ergänzt Dataflow. Die Hauptmerkmale von Bigtable, Lese- und Schreibvorgänge mit niedriger Latenz (6 ms beim 90. Perzentil), ermöglichen die Verarbeitung vieler Tausender gleichzeitiger Clients und Heavy-Burst-Arbeitslasten. Diese Funktionen machen Bigtable zum idealen Ziel und zur idealen Datenquelle innerhalb der DoFn-Funktion in der Verarbeitungsphase von Dataflow.
BigQuery
BigQuery ist ein schnelles, kostengünstiges und vollständig verwaltetes Data Warehouse, mit dem Unternehmen umfangreiche Datenanalysen realisieren können. Grid-Ergebnisse werden häufig für Analysen verwendet und ermöglichen die Ausführung umfangreicher Zusammenfassungen auf Basis der Grid-Datenausgabe.
Pub/Sub
Pub/Sub ist ein asynchroner, skalierbarer Messaging-Dienst, der Dienste, die Nachrichten erzeugen, von Diensten entkoppelt, die diese Nachrichten verarbeiten. Sie können Pub/Sub für Streaminganalysen und Datenintegrationspipelines verwenden, um Daten aufzunehmen und zu verteilen. Sie ist gleichermaßen effektiv als Messaging-orientierte Middleware für die Dienstintegration oder als Warteschlange zum Parallelisieren von Aufgaben.
Dataflow-DAG
Mit dem Apache Beam SDK können Sie komplexe DAGs entwerfen, um damit problemlos mehrstufige Stream- oder Batch-Pipelines zu erstellen. Für die Datenverschiebung ist der Runner zuständig, wobei die Daten als PCollection-Objekte ausgedrückt werden. Diese sind unveränderbare Sammlungen von parallelen Elementen.
Das folgende Diagramm veranschaulicht diesen Ablauf.
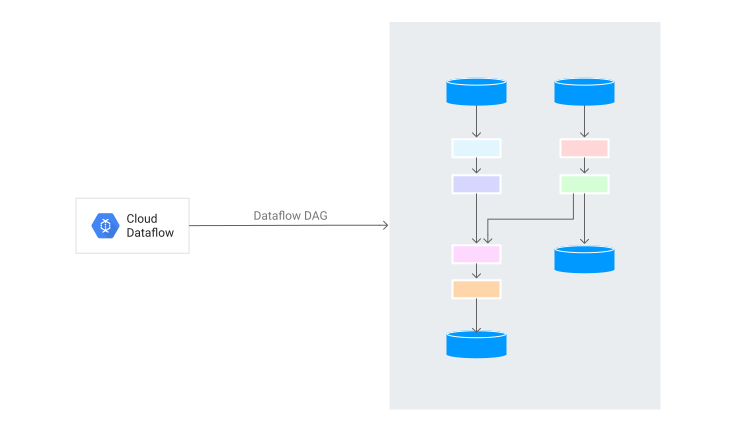
Mit dem Apache Beam SDK können Sie einen DAG definieren. Im DAG wiederum können Sie benutzerdefinierten Code als Funktionen hinzufügen. Normalerweise wird dieselbe Programmiersprache (Java, Python oder Go) sowohl für die Deklaration des DAG als auch für den benutzerdefinierten Code verwendet. Sie können auch Code verwenden, der nicht integriert ist, z. B. C++, für den benutzerdefinierten Code.
Nächste Schritte
- Best Practices für die Arbeit mit hochparallelen Dataflow-HPC-Pipelines
- Folgen Sie der Anleitung, um eine Pipeline zu erstellen, die benutzerdefinierte Container mit C++-Bibliotheken verwendet.