


O recurso de ajuste direito usa dicas de recursos do Apache Beam para personalizar recursos de worker para um pipeline. A capacidade de segmentar vários recursos diferentes para etapas específicas do pipeline oferece mais flexibilidade e capacidade, além de possível economia de custos. É possível aplicar recursos mais caros às etapas do pipeline que os exigem e recursos menos caros a outras etapas do pipeline. Use o ajuste direito para especificar os requisitos de recursos para um pipeline inteiro ou para etapas específicas de pipeline.
Suporte e limitações
- As dicas de recursos são compatíveis com os SDKs do Apache Beam para Java e Python, versões 2.31.0 e posteriores.
- O ajuste direito só é compatível com pipelines em lote.
O ajuste correto é compatível com pipelines de streaming com o escalonamento automático horizontal ativado.
- Para ativar, defina a opção de pipeline
--experiments=enable_streaming_rightfitting.
- Para ativar, defina a opção de pipeline
O ajuste direito é compatível com o Dataflow Prime.
O ajuste direito não é compatível com o FlexRS.
Quando você usar o ajuste direito, não use a opção de serviço
worker_accelerator.Quando você usa o escalonamento automático vertical, a seleção automática de VM não é compatível.
Ativar ajuste direito
Para ativar o ajuste direito, use uma ou mais dicas de recursos disponíveis no pipeline. Quando você usa uma dica de recurso no pipeline, o ajuste correto é ativado automaticamente. Para mais informações, consulte a seção Usar dicas de recursos deste documento.
Dicas de recursos disponíveis
As seguintes dicas de recurso estão disponíveis:
| Dica de recurso | Descrição |
|---|---|
min_ram |
A quantidade mínima de RAM em gigabytes para alocar aos workers. O Dataflow usa esse valor como um limite inferior ao alocar memória para novos workers (escalonamento horizontal) ou para workers existentes (escalonamento vertical). Por exemplo: min_ram=NUMBERGB
|
cpu_count |
O número de vCPUs a serem alocadas por worker. Quando você usa essa dica de recurso, o Dataflow seleciona tipos de máquinas que têm o número especificado de vCPUs e atendem aos requisitos de memória. Exemplo: cpu_count=NUMBER
|
accelerator |
Uma alocação de GPUs fornecida pelo usuário que permite controlar o uso e o custo de GPUs no pipeline e nas etapas dele. Especifique o tipo e o número de GPUs a serem anexadas aos workers do Dataflow como parâmetros à sinalização. Por exemplo: accelerator="type:GPU_TYPE;count:GPU_COUNT;machine_type:MACHINE_TYPE;CONFIGURATION_OPTIONS"
Para mais informações sobre o uso de GPUs, consulte GPUs com Dataflow. |
Seleção automática de VM para tipos de máquinas de worker
Quando você usa dicas de recursos min_ram ou cpu_count para etapas de pipeline que
não exigem aceleradores,
a flexibilidade de instância (seleção automática de VM)
é ativada automaticamente. Com a seleção automática de VMs, os workers são provisionados
de uma seleção de tipos de máquinas que atendem aos seus requisitos de RAM e CPU.
A seleção automática de VMs otimiza a escolha principalmente para confiabilidade, e não para performance. Isso significa que você pode ter uma redução no desempenho ao usar a seleção automática de VM para melhorar a confiabilidade de alguns dos seus jobs altamente ajustados. Recomendamos testar a seleção automática de VM em um subconjunto dos seus jobs atuais antes de implantá-los gradualmente em uma escala maior.
Se você usa reservas do Compute Engine com a seleção automática de VM, observe o seguinte:
- Se você tiver reservas que são consumidas automaticamente, elas poderão ser usadas se o Compute Engine provisionar VMs de um tipo de máquina correspondente.
- A seleção automática de VM não oferece suporte a consumir instâncias de uma reserva específica.
- A seleção automática de VM não é compatível com o escalonamento automático vertical.
Para mais informações, consulte Flexibilidade de instâncias e reservas.
Aninhamento de dica de recurso
As dicas de recurso são aplicadas à hierarquia de transformação do pipeline da seguinte maneira:
min_ram: o valor em uma transformação é avaliado como o maior valor de dicamin_ramentre os valores definidos na própria transformação e todos os pais na hierarquia da transformação.- Exemplo: se uma dica de transformação interna definir
min_ramcomo 16 GB, e a dica de transformação externa nos conjuntos de hierarquiamin_ramcomo 32 GB, uma dica de 32 GB será usada em todas as etapas da transformação. - Exemplo: se uma dica de transformação interna definir
min_ramcomo 16 GB, e a dica de transformação externa nos conjuntos de hierarquiamin_ramcomo 8 GB, uma dica de 8 GB é usada para todas as etapas na transformação externa que não estão na transformação interna, e uma dica de 16 GB será usada em todas as etapas da transformação interna.
- Exemplo: se uma dica de transformação interna definir
accelerator: o valor mais interno na hierarquia da transformação tem precedência.- Exemplo: se uma dica
acceleratorde transformação interna for diferente de uma dicaacceleratorde transformação externa em uma hierarquia, a dicaacceleratorde transformação interna será usada para a transformação interna.
- Exemplo: se uma dica
As dicas definidas para todo o pipeline são tratadas como se fossem definidas em uma transformação externa separada.
Use dicas de recursos
É possível definir dicas de recursos em todo o pipeline ou nas etapas de pipeline.
Dicas de recursos do pipeline
É possível definir dicas de recursos em todo o pipeline quando você o executar na linha de comando.
gcloud
Para definir dicas de recursos ao executar um pipeline com um modelo Flex, use a
flag --additional-pipeline-options com o
comando gcloud dataflow flex-template run.
O nome da opção de pipeline depende da linguagem do SDK. Por exemplo, para dicas de recursos:
- Para pipelines em Java, use
resourceHints. - Para pipelines do Python, use
resource_hints.
O exemplo a seguir demonstra como definir dicas de recursos ao executar um pipeline de modelo flexível do Java:
gcloud dataflow flex-template run JOB_NAME \
    --template-file-gcs-location="gs://TEMPLATE_LOCATION" \
    --region="REGION" \
    --additional-pipeline-options=resourceHints=min_ram=numberGB \
    --additional-pipeline-options=resourceHints=cpu_count=number \
    --additional-pipeline-options=resourceHints=accelerator="type:type;count:number;install-nvidia-driver" \
    --parameters ...
O exemplo a seguir demonstra como definir dicas de recursos ao executar um pipeline de modelo flexível do Python:
gcloud dataflow flex-template run JOB_NAME \
    --template-file-gcs-location="gs://TEMPLATE_LOCATION" \
    --region="REGION" \
    --additional-pipeline-options=resource_hints=min_ram=numberGB \
    --additional-pipeline-options=resource_hints=cpu_count=number \
    --additional-pipeline-options=resource_hints=accelerator="type:type;count:number;install-nvidia-driver" \
    --parameters ...
Python
Para configurar o ambiente do Python, consulte o tutorial do Python.
O exemplo a seguir demonstra como definir dicas de recursos ao executar um pipeline do Python:
python my_pipeline.py \
    --runner=DataflowRunner \
    --resource_hints=min_ram=numberGB \
    --resource_hints=cpu_count=number \
    --resource_hints=accelerator="type:type;count:number;install-nvidia-driver" \
    ...
Dicas de recursos da etapa do pipeline
É possível definir dicas de recursos em etapas (transformações) do pipeline de forma programática.
Java
Para instalar o SDK do Apache Beam para Java, consulte Instalar o SDK do Apache Beam.
É possível definir dicas de recursos de maneira programática em transformações de pipeline usando a
classe ResourceHints.
Veja no exemplo a seguir como definir dicas de recursos de maneira programática nas transformações de pipeline.
pcoll.apply(MyCompositeTransform.of(...)
    .setResourceHints(
        ResourceHints.create()
            .withMinRam("15GB")
            .withCpuCount(8)
            .withAccelerator(
    "type:nvidia-l4;count:1;install-nvidia-driver")))

pcoll.apply(ParDo.of(new BigMemFn())
    .setResourceHints(
        ResourceHints.create()
          .withMinRam("30GB")
          .withCpuCount(16)))
Para definir dicas de recursos de maneira programática em todo o pipeline, use a
interface ResourceHintsOptions.
Python
Para instalar o SDK do Apache Beam para Python, consulte Instalar o SDK do Apache Beam.
É possível definir dicas de recursos de maneira programática em transformações de pipeline usando a
classe PTransforms.with_resource_hints.
Para saber mais, consulte a
classe ResourceHint.
Veja no exemplo a seguir como definir dicas de recursos de maneira programática nas transformações de pipeline.
pcoll | MyPTransform().with_resource_hints(
    min_ram="4GB",
    cpu_count=8,
    accelerator="type:nvidia-tesla-l4;count:1;install-nvidia-driver")

pcoll | beam.ParDo(BigMemFn()).with_resource_hints(
    min_ram="30GB",
    cpu_count=16)
Para definir dicas de recursos em todo o pipeline, use a opção de pipeline --resource_hints
ao executar o pipeline. Para ver um exemplo, consulte
Dicas de recurso de pipeline.
Go
As dicas de recursos não são compatíveis com o Go.
Suporte a vários aceleradores
Em um pipeline, diferentes transformações podem ter configurações de acelerador diferentes. Isso inclui configurações que exigem diferentes tipos de máquinas. Essas configurações de acelerador no nível da transformação têm precedência sobre a configuração no nível do pipeline, se uma tiver sido fornecida.
Ajuste direito e fusão
Em alguns casos, transformações definidas com diferentes dicas de recursos podem ser executadas em workers no mesmo pool de workers, como parte do processo de otimização de fusão. Quando as transformações são unidas, o Dataflow as executa em um ambiente que atende à união de dicas de recursos definidas nas transformações. Em alguns casos, isso inclui todo o pipeline.
Quando as dicas de recursos não podem ser mescladas, a fusão não ocorre. Por exemplo, as dicas de recursos para GPUs diferentes não podem ser mescladas. Portanto, essas transformações não são fundidas.
Para evitar a fusão, adicione uma operação ao pipeline que force
o Dataflow a materializar um PCollection intermediário. Isso é
especialmente útil ao tentar isolar recursos caros, como GPUs ou máquinas de alta
memória, de etapas lentas ou computacionalmente caras que não precisam
desses recursos especiais. Nesses casos, pode ser útil forçar uma interrupção de fusão entre as etapas lentas vinculadas à CPU e as etapas que precisam de GPUs caras ou máquinas com muita memória e pagar o custo de materialização associado à interrupção da fusão. Para saber mais, consulte
Evitar a fusão.
Ajuste direito de streaming
Para jobs de streaming, é possível ativar o ajuste à direita definindo a opção de pipeline --experiments=enable_streaming_rightfitting.
O ajuste adequado pode melhorar a performance do seu pipeline se ele envolver etapas com diferentes requisitos de recursos.
Exemplo: pipeline com uma etapa que exige muito da CPU e outra que exige GPU
Um exemplo de pipeline que pode se beneficiar do ajuste correto é aquele que executa um estágio com uso intenso da CPU, seguido por um estágio que exige GPU. Sem o ajuste correto, um único pool de workers de GPU precisará ser configurado para executar todas as etapas do pipeline, incluindo a etapa com uso intensivo de CPU. Isso pode levar à subutilização dos recursos da GPU quando o pool de workers está executando a etapa com uso intensivo da CPU.
Se o ajuste correto estiver ativado e uma dica de recurso for aplicada à etapa que exige GPU, o pipeline vai criar dois pools separados. Assim, o estágio com uso intensivo de CPU será executado pelo pool de workers de CPU, e o estágio que exige GPU será executado pelo pool de workers de GPU.
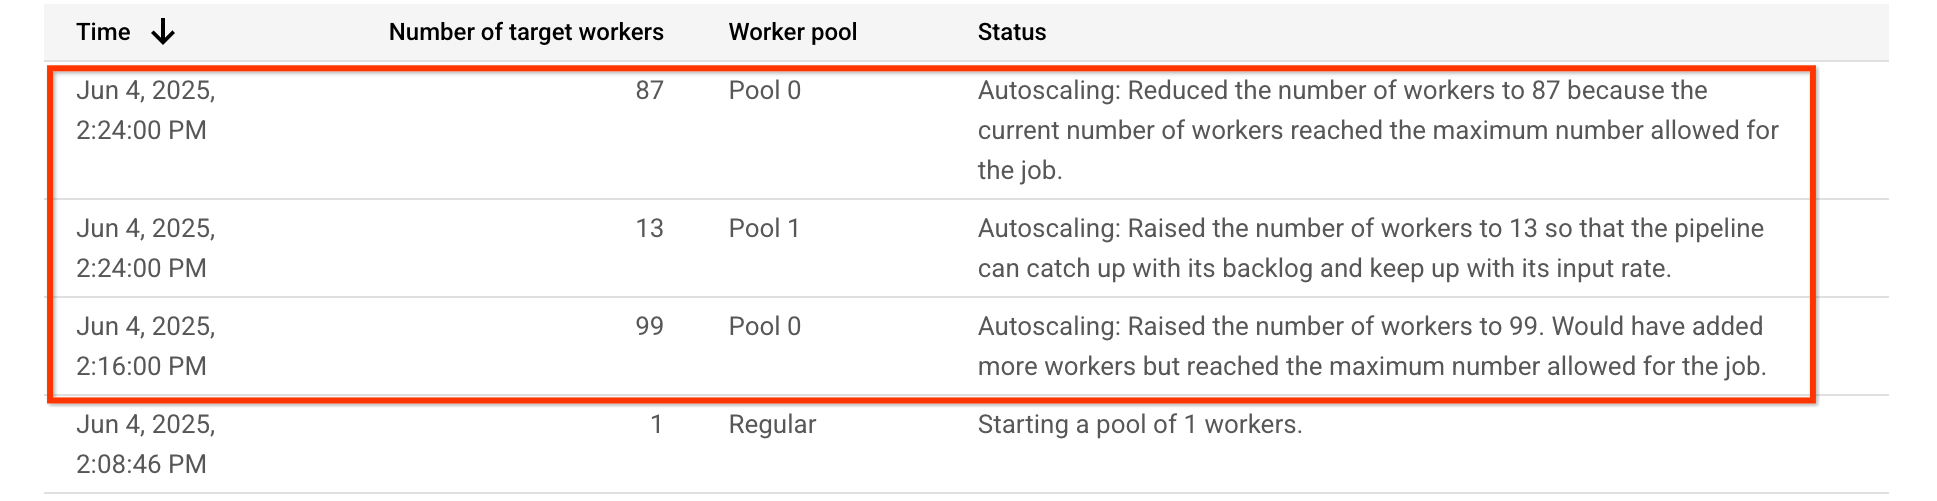
Para este pipeline de exemplo, a tabela de escalonamento automático mostra que o pool de workers que executa a etapa com uso intensivo de CPU, Pool 0, é inicialmente ampliado para 99 workers e depois reduzido para 87. O pool de workers que executa a etapa que exige GPU, Pool 1, é escalonado para 13 workers:
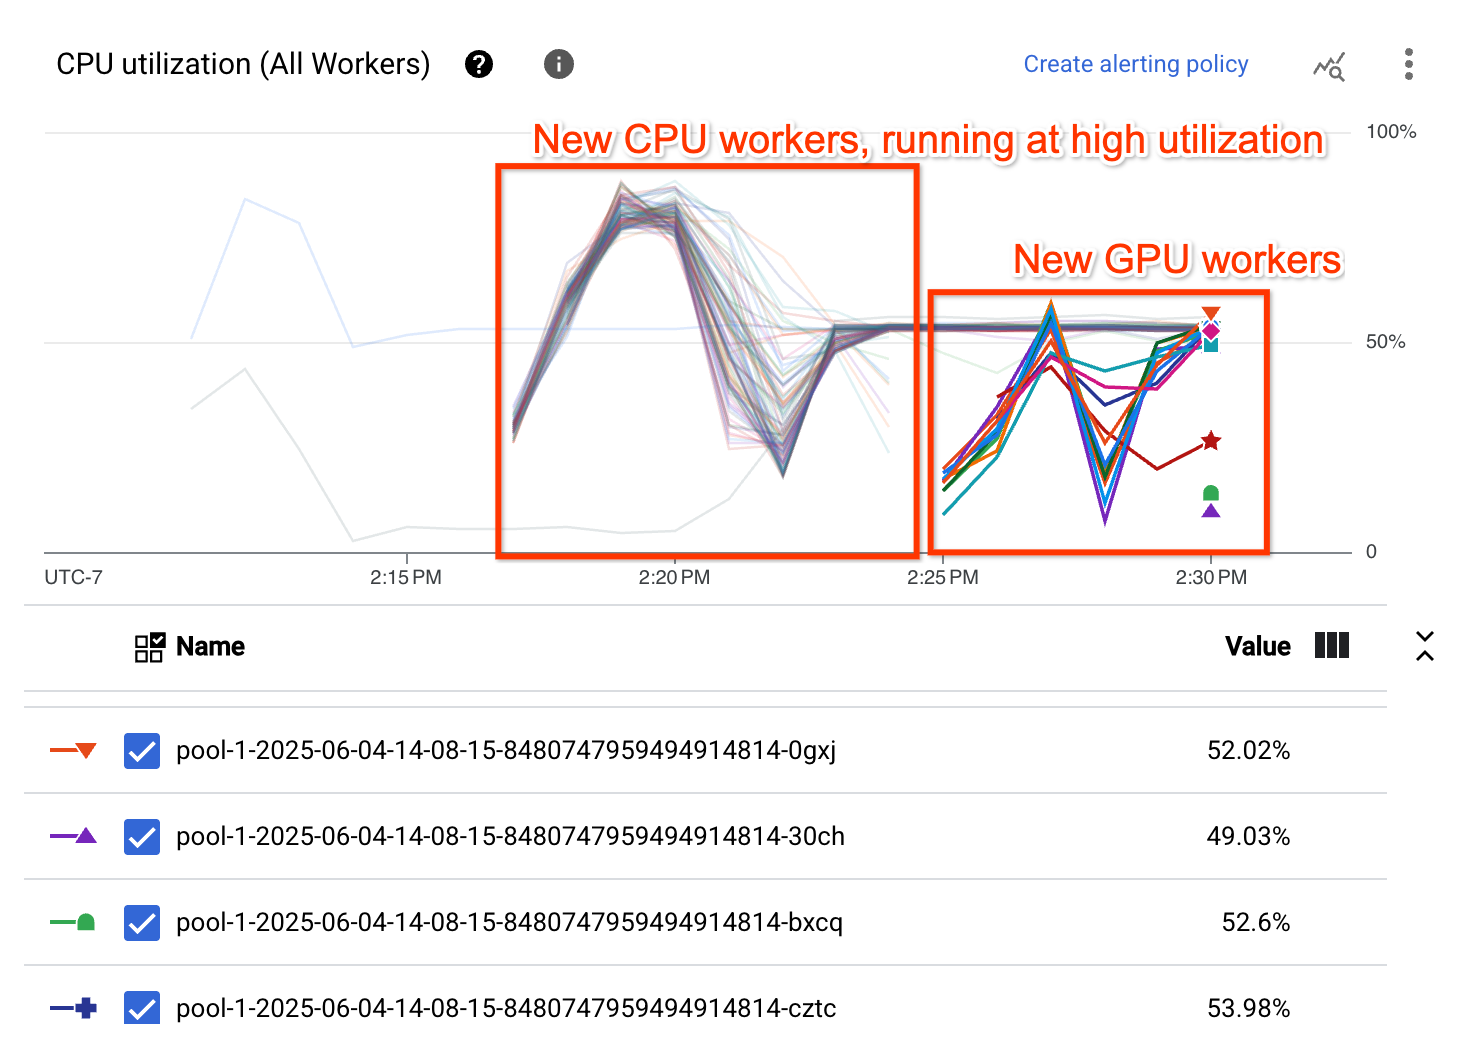
O gráfico de utilização da CPU mostra que os workers nos dois pools estão demonstrando uma alta utilização geral da CPU:
Resolver problemas de ajuste direito
Esta seção fornece instruções para solucionar problemas comuns relacionados ao ajuste direito.
Configuração inválida
Quando você tenta usar o ajuste direito, ocorre o seguinte erro:
Workflow failed. Causes: One or more operations had an error: 'operation-OPERATION_ID':
[UNSUPPORTED_OPERATION] 'NUMBER vCpus with NUMBER MiB memory is
an invalid configuration for NUMBER count of 'GPU_TYPE' in family 'MACHINE_TYPE'.'.
Esse erro ocorre quando o tipo de GPU selecionado não é compatível com o tipo de máquina selecionado. Para resolver esse erro, selecione um tipo de GPU e de máquina compatíveis. Para detalhes de compatibilidade, consulte Plataformas de GPU.
Paralelismo inesperado com a seleção automática de VM
Se você observar baixa utilização da CPU ou paralelismo inesperado em VMs de worker ao usar a seleção automática de VMs com ajuste adequado, isso pode indicar um problema em que o número de linhas de execução por worker não é definido automaticamente para corresponder à contagem de vCPUs do tipo de máquina selecionado.
Para contornar esse problema, defina explicitamente a opção de pipeline numberOfWorkerHarnessThreads e a dica de recurso de pipeline cpu_count com o mesmo valor. Por exemplo, se você precisar de 2 vCPUs, defina --numberOfWorkerHarnessThreads=2 e --resourceHints=cpu_count=2. A opção numberOfWorkerHarnessThreads se aplica globalmente a todos os pools de workers no pipeline.
Verificar o ajuste direito
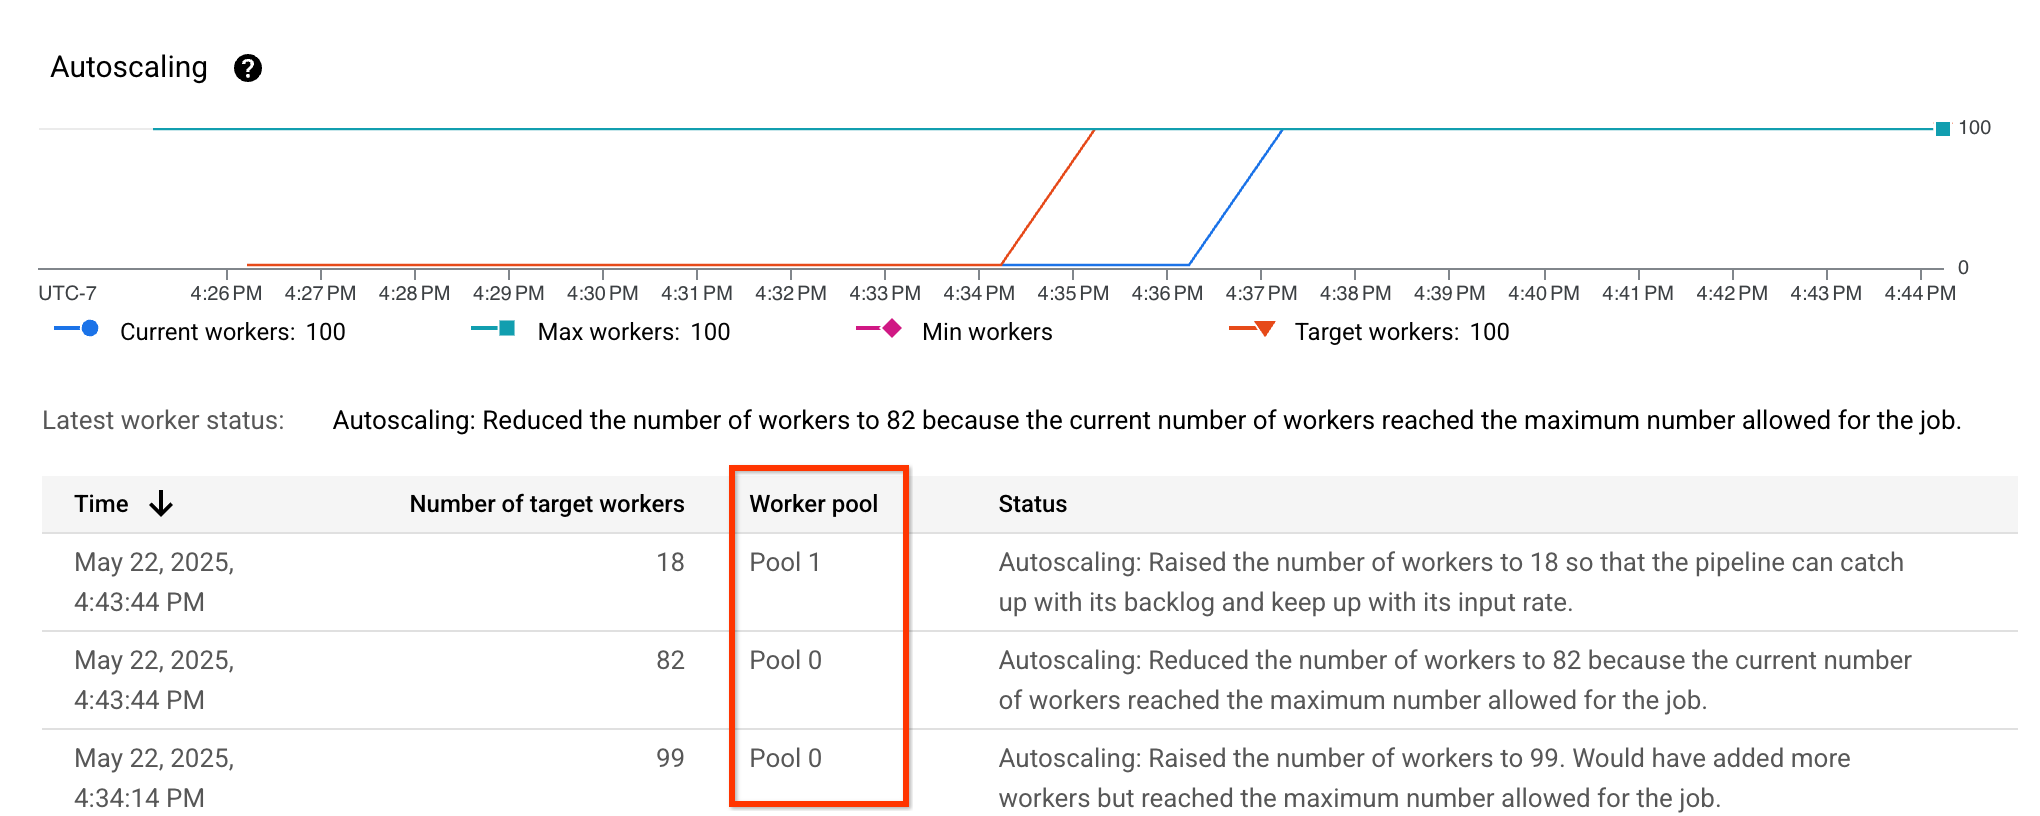
Para verificar se o ajuste correto está ativado, confira as métricas de escalonamento automático e verifique se a coluna Worker pool está visível e lista diferentes pools:
Performance de ajuste direito de streaming
Os pipelines de streaming com ajuste correto ativado nem sempre têm uma performance melhor do que aqueles sem esse recurso. Exemplo:
- O pipeline está usando mais workers
- A latência do sistema é maior ou a capacidade de processamento é menor
- Os tamanhos dos pools de workers estão mudando com mais frequência ou não estão se estabilizando.
Se você observar isso no seu pipeline, desative o ajuste direito removendo a opção de pipeline --experiments=enable_streaming_rightfitting. Além disso, os pipelines de streaming com ajuste direito ativado usando dicas de recursos de acelerador podem usar mais aceleradores do que o desejado. Se você observar isso no seu pipeline, configure um número máximo de aceleradores usados por ele definindo a opção de pipeline --experiments=max_num_accelerators=NUM.