


La funzionalità Adattabilità utilizza suggerimenti per le risorse Apache Beam per personalizzare le risorse worker per una pipeline. La possibilità di scegliere come target più risorse diverse per passaggi della pipeline specifici offre maggiore flessibilità e capacità alla pipeline, oltre a potenziali risparmi sui costi. Puoi applicare risorse più costose ai passaggi della pipeline che le richiedono e risorse meno costose ad altri passaggi della pipeline. Utilizza il dimensionamento corretto per specificare i requisiti delle risorse per un'intera pipeline o per passaggi specifici della pipeline.
Supporto e limitazioni
- I suggerimenti per le risorse sono supportati dagli SDK Apache Beam Java e Python, versioni 2.31.0 e successive.
- L'adattabilità è supportata con le pipeline batch.
L'adattamento giusto è supportato con le pipeline di streaming con la scalabilità automatica orizzontale abilitata.
- Puoi attivarlo impostando l'opzione della pipeline
--experiments=enable_streaming_rightfitting.
- Puoi attivarlo impostando l'opzione della pipeline
L'adattabilità supporta Dataflow Prime.
L'adattamento corretto non supporta FlexRS.
Quando utilizzi l'adattamento corretto, non utilizzare l'
worker_acceleratoropzione di servizio.Quando utilizzi la scalabilità automatica verticale, la selezione automatica delle VM non è supportata.
Attivare l'adattabilità
Per attivare l'adattamento giusto, utilizza uno o più suggerimenti per le risorse disponibili nella pipeline. Quando utilizzi un suggerimento per le risorse nella pipeline, il dimensionamento corretto viene attivato automaticamente. Per maggiori informazioni, consulta la sezione Utilizzare i suggerimenti per le risorse di questo documento.
Suggerimenti sulle risorse disponibili
Sono disponibili i seguenti suggerimenti per le risorse.
| Suggerimento per la risorsa | Descrizione |
|---|---|
min_ram |
La quantità minima di RAM in gigabyte da allocare ai worker. Dataflow utilizza questo valore come limite inferiore quando alloca memoria ai nuovi worker (scalabilità orizzontale) o ai worker esistenti (scalabilità verticale). Ad esempio: min_ram=NUMBERGB
|
cpu_count |
Il numero di vCPU da allocare per worker. Quando utilizzi questo suggerimento per le risorse, Dataflow seleziona i tipi di macchine che hanno il numero specificato di vCPU e soddisfano i requisiti di memoria. Ad esempio: cpu_count=NUMBER
|
accelerator |
Un'allocazione di GPU fornita dall'utente che ti consente di controllare l'utilizzo e il costo delle GPU nella pipeline e nei relativi passaggi. Specifica il tipo e il numero di GPU da collegare ai worker Dataflow come parametri del flag. Ad esempio: accelerator="type:GPU_TYPE;count:GPU_COUNT;machine_type:MACHINE_TYPE;CONFIGURATION_OPTIONS"
Per saperne di più sull'utilizzo delle GPU, consulta GPU con Dataflow. |
Selezione automatica delle VM per i tipi di macchine worker
Quando utilizzi i suggerimenti per le risorse min_ram o cpu_count per i passaggi della pipeline che non richiedono acceleratori, l'opzione Flessibilità delle istanze (selezione automatica delle VM) viene abilitata automaticamente. Con la selezione automatica delle VM, i worker vengono sottoposti al provisioning
da una selezione di tipi di macchine che soddisfano i requisiti di RAM e CPU.
La selezione automatica delle VM ottimizza la selezione delle VM principalmente per l'affidabilità e non per le prestazioni. Ciò significa che potresti riscontrare un calo delle prestazioni durante l'utilizzo della selezione automatica delle VM per migliorare l'affidabilità di alcuni dei tuoi job altamente ottimizzati. Ti consigliamo di testare la selezione automatica delle VM su un sottoinsieme dei tuoi job esistenti prima di eseguirne il deployment in modo più ampio.
Se utilizzi le prenotazioni di Compute Engine con la selezione automatica delle VM, tieni presente quanto segue:
- Se hai prenotazioni che vengono utilizzate automaticamente, potrebbero essere utilizzate se Compute Engine esegue il provisioning di VM di un tipo di macchina corrispondente.
- La selezione automatica delle VM non supporta l'utilizzo di istanze da una prenotazione specifica.
- La selezione automatica delle VM non è supportata con la scalabilità automatica verticale.
Per saperne di più, consulta Flessibilità delle istanze e prenotazioni.
Nidificazione dei suggerimenti per le risorse
I suggerimenti per le risorse vengono applicati alla gerarchia di trasformazione della pipeline nel seguente modo:
min_ram: Il valore di una trasformazione viene valutato come il valore di suggerimentomin_rampiù grande tra i valori impostati nella trasformazione stessa e in tutti i relativi elementi principali nella gerarchia della trasformazione.- Esempio: se un suggerimento di trasformazione interno imposta
min_ramsu 16 GB e il suggerimento di trasformazione esterno nella gerarchia impostamin_ramsu 32 GB, viene utilizzato un suggerimento di 32 GB per tutti i passaggi dell'intera trasformazione. - Esempio: se un suggerimento di trasformazione interno imposta
min_ramsu 16 GB e il suggerimento di trasformazione esterno nella gerarchia impostamin_ramsu 8 GB, viene utilizzato un suggerimento di 8 GB per tutti i passaggi della trasformazione esterna che non si trovano nella trasformazione interna e un suggerimento di 16 GB viene utilizzato per tutti i passaggi della trasformazione interna.
- Esempio: se un suggerimento di trasformazione interno imposta
accelerator: il valore più interno nella gerarchia della trasformazione ha la precedenza.- Esempio: se un suggerimento di trasformazione interno
acceleratorè diverso da un suggerimento di trasformazione esternoacceleratorin una gerarchia, il suggerimento di trasformazione internoacceleratorviene utilizzato per la trasformazione interna.
- Esempio: se un suggerimento di trasformazione interno
I suggerimenti impostati per l'intera pipeline vengono trattati come se fossero impostati su una trasformazione esterna separata.
Utilizzare i suggerimenti per le risorse
Puoi impostare suggerimenti per le risorse sull'intera pipeline o sui passaggi della pipeline.
Suggerimenti per le risorse della pipeline
Puoi impostare suggerimenti sulle risorse per l'intera pipeline quando la esegui dalla riga di comando.
gcloud
Per impostare i suggerimenti per le risorse quando esegui una pipeline con un modello flessibile, utilizza il flag --additional-pipeline-options con il comando gcloud dataflow flex-template run.
Il nome dell'opzione della pipeline dipende dalla lingua dell'SDK. Ad esempio, per i suggerimenti per le risorse:
- Per le pipeline Java, utilizza
resourceHints. - Per le pipeline Python, utilizza
resource_hints.
Il seguente esempio mostra come impostare i suggerimenti per le risorse quando esegui una pipeline Java Flex Template:
gcloud dataflow flex-template run JOB_NAME \
    --template-file-gcs-location="gs://TEMPLATE_LOCATION" \
    --region="REGION" \
    --additional-pipeline-options=resourceHints=min_ram=numberGB \
    --additional-pipeline-options=resourceHints=cpu_count=number \
    --additional-pipeline-options=resourceHints=accelerator="type:type;count:number;install-nvidia-driver" \
    --parameters ...
Il seguente esempio mostra come impostare i suggerimenti per le risorse quando esegui una pipeline di modelli flessibili Python:
gcloud dataflow flex-template run JOB_NAME \
    --template-file-gcs-location="gs://TEMPLATE_LOCATION" \
    --region="REGION" \
    --additional-pipeline-options=resource_hints=min_ram=numberGB \
    --additional-pipeline-options=resource_hints=cpu_count=number \
    --additional-pipeline-options=resource_hints=accelerator="type:type;count:number;install-nvidia-driver" \
    --parameters ...
Python
Per configurare l'ambiente Python, consulta il tutorial Python.
Il seguente esempio mostra come impostare i suggerimenti per le risorse durante l'esecuzione di una pipeline Python:
python my_pipeline.py \
    --runner=DataflowRunner \
    --resource_hints=min_ram=numberGB \
    --resource_hints=cpu_count=number \
    --resource_hints=accelerator="type:type;count:number;install-nvidia-driver" \
    ...
Suggerimenti sulle risorse del passaggio della pipeline
Puoi impostare suggerimenti sulle risorse nei passaggi della pipeline (trasformazioni) in modo programmatico.
Java
Per installare l'SDK Apache Beam per Java, consulta Installa l'SDK Apache Beam.
Puoi impostare suggerimenti sulle risorse a livello di programmazione nelle trasformazioni della pipeline utilizzando la
classe ResourceHints.
L'esempio seguente mostra come impostare gli hint per le risorse in modo programmatico nelle trasformazioni della pipeline.
pcoll.apply(MyCompositeTransform.of(...)
    .setResourceHints(
        ResourceHints.create()
            .withMinRam("15GB")
            .withCpuCount(8)
            .withAccelerator(
    "type:nvidia-l4;count:1;install-nvidia-driver")))

pcoll.apply(ParDo.of(new BigMemFn())
    .setResourceHints(
        ResourceHints.create()
          .withMinRam("30GB")
          .withCpuCount(16)))
Per impostare in modo programmatico i suggerimenti per le risorse sull'intera pipeline, utilizza l'interfaccia ResourceHintsOptions.
Python
Per installare l'SDK Apache Beam per Python, consulta Installa l'SDK Apache Beam.
Puoi impostare suggerimenti sulle risorse a livello di programmazione nelle trasformazioni della pipeline utilizzando la
classe PTransforms.with_resource_hints.
Per saperne di più, consulta la
classe ResourceHint.
L'esempio seguente mostra come impostare gli hint per le risorse in modo programmatico nelle trasformazioni della pipeline.
pcoll | MyPTransform().with_resource_hints(
    min_ram="4GB",
    cpu_count=8,
    accelerator="type:nvidia-tesla-l4;count:1;install-nvidia-driver")

pcoll | beam.ParDo(BigMemFn()).with_resource_hints(
    min_ram="30GB",
    cpu_count=16)
Per impostare i suggerimenti sulle risorse sull'intera pipeline, utilizza l'opzione --resource_hints
della pipeline quando esegui la pipeline. Per un esempio, consulta
Suggerimenti per le risorse della pipeline.
Vai
I suggerimenti per le risorse non sono supportati in Go.
Supporto di più acceleratori
All'interno di una pipeline, trasformazioni diverse possono avere configurazioni di acceleratore diverse. Queste includono configurazioni che richiedono tipi di macchine diversi. Queste configurazioni dell'acceleratore a livello di trasformazione hanno la precedenza sulla configurazione a livello di pipeline, se ne è stata fornita una.
Adattabilità e fusione
In alcuni casi, le trasformazioni impostate con suggerimenti sulle risorse diversi possono essere eseguite sui worker dello stesso pool di worker nell'ambito del processo di ottimizzazione della fusione. Quando le trasformazioni vengono unite, Dataflow le esegue in un ambiente che soddisfa l'unione dei suggerimenti sulle risorse impostati nelle trasformazioni. In alcuni casi, ciò include l'intera pipeline.
Quando i suggerimenti per le risorse non possono essere uniti, la fusione non viene eseguita. Ad esempio, i suggerimenti sulle risorse per GPU diverse non sono unibili, quindi queste trasformazioni non vengono unite.
Puoi anche impedire la fusione aggiungendo una operazione alla pipeline che forza
Dataflow a materializzare un PCollection intermedio. Ciò è
particolarmente utile quando si tenta di isolare risorse costose come GPU o macchine con memoria
elevata da passaggi lenti o costosi dal punto di vista computazionale che non richiedono
queste risorse speciali. In questi casi, potrebbe essere utile forzare un'interruzione
della fusione tra i passaggi lenti vincolati alla CPU e i passaggi che richiedono GPU costose
o macchine con memoria elevata e pagare il costo della materializzazione associata
all'interruzione della fusione. Per scoprire di più, vedi
Evitare la fusione.
Adattabilità dello streaming
Per i job di streaming, puoi attivare l'adattamento a destra impostando l'opzione della pipeline --experiments=enable_streaming_rightfitting.
Il dimensionamento corretto può migliorare il rendimento della pipeline se include fasi con requisiti di risorse diversi.
Esempio: pipeline con fase che richiede un utilizzo elevato della CPU e fase che richiede la GPU
Un esempio di pipeline che può trarre vantaggio dal dimensionamento corretto è una pipeline che esegue una fase che richiede un uso intensivo della CPU, seguita da una fase che richiede una GPU. Senza il dimensionamento corretto, un singolo pool di worker GPU dovrà essere configurato per eseguire tutte le fasi della pipeline, inclusa la fase che richiede un uso intensivo della CPU. Ciò potrebbe comportare un sottoutilizzo delle risorse GPU quando il pool di worker esegue la fase che richiede un utilizzo elevato della CPU.
Se l'adattamento giusto è abilitato e un suggerimento per le risorse viene applicato al passaggio che richiede la GPU, la pipeline creerà due pool separati, in modo che la fase che richiede un utilizzo elevato della CPU venga eseguita dal pool di worker CPU e la fase che richiede la GPU venga eseguita dal pool di worker GPU.
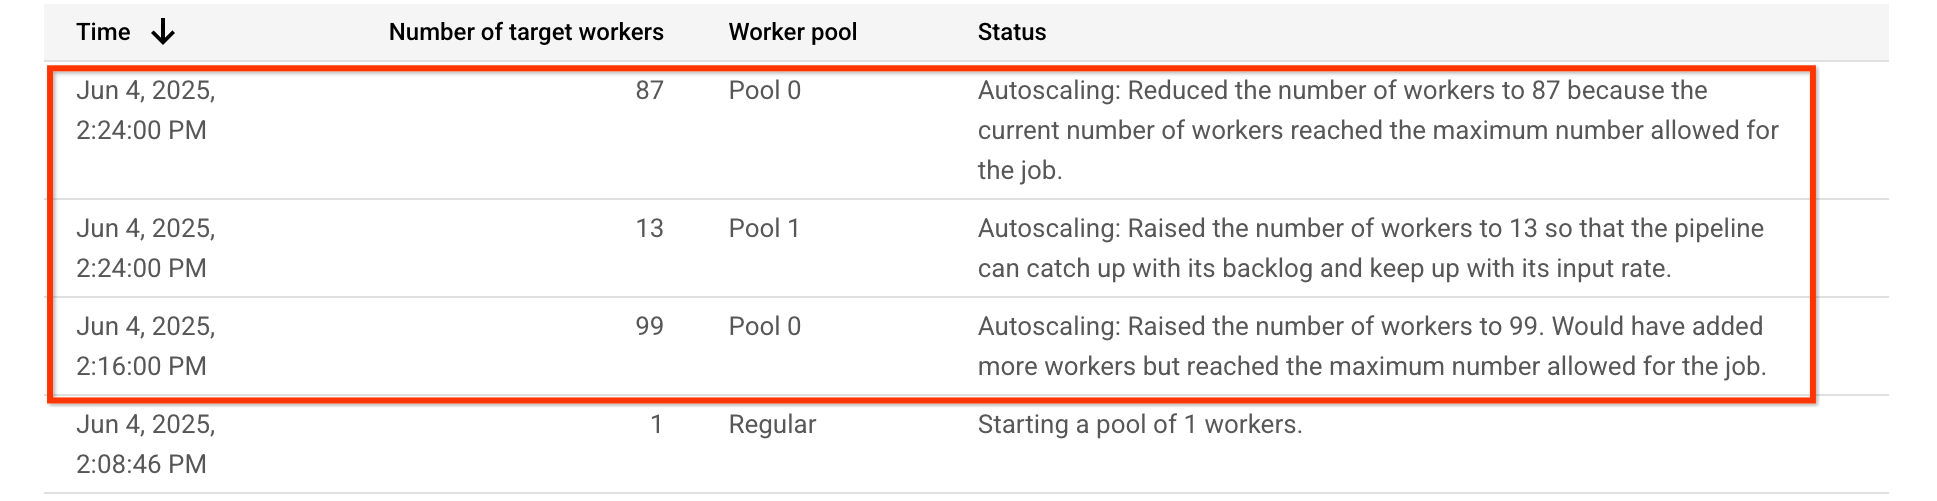
Per questa pipeline di esempio, la tabella di scalabilità automatica mostra che il pool di worker che esegue la fase a uso intensivo di CPU, Pool 0, viene inizialmente aumentato a 99 worker e successivamente ridotto a 87 worker. Il pool di worker che esegue la fase che richiede la GPU, Pool 1, viene scalato a 13 worker:
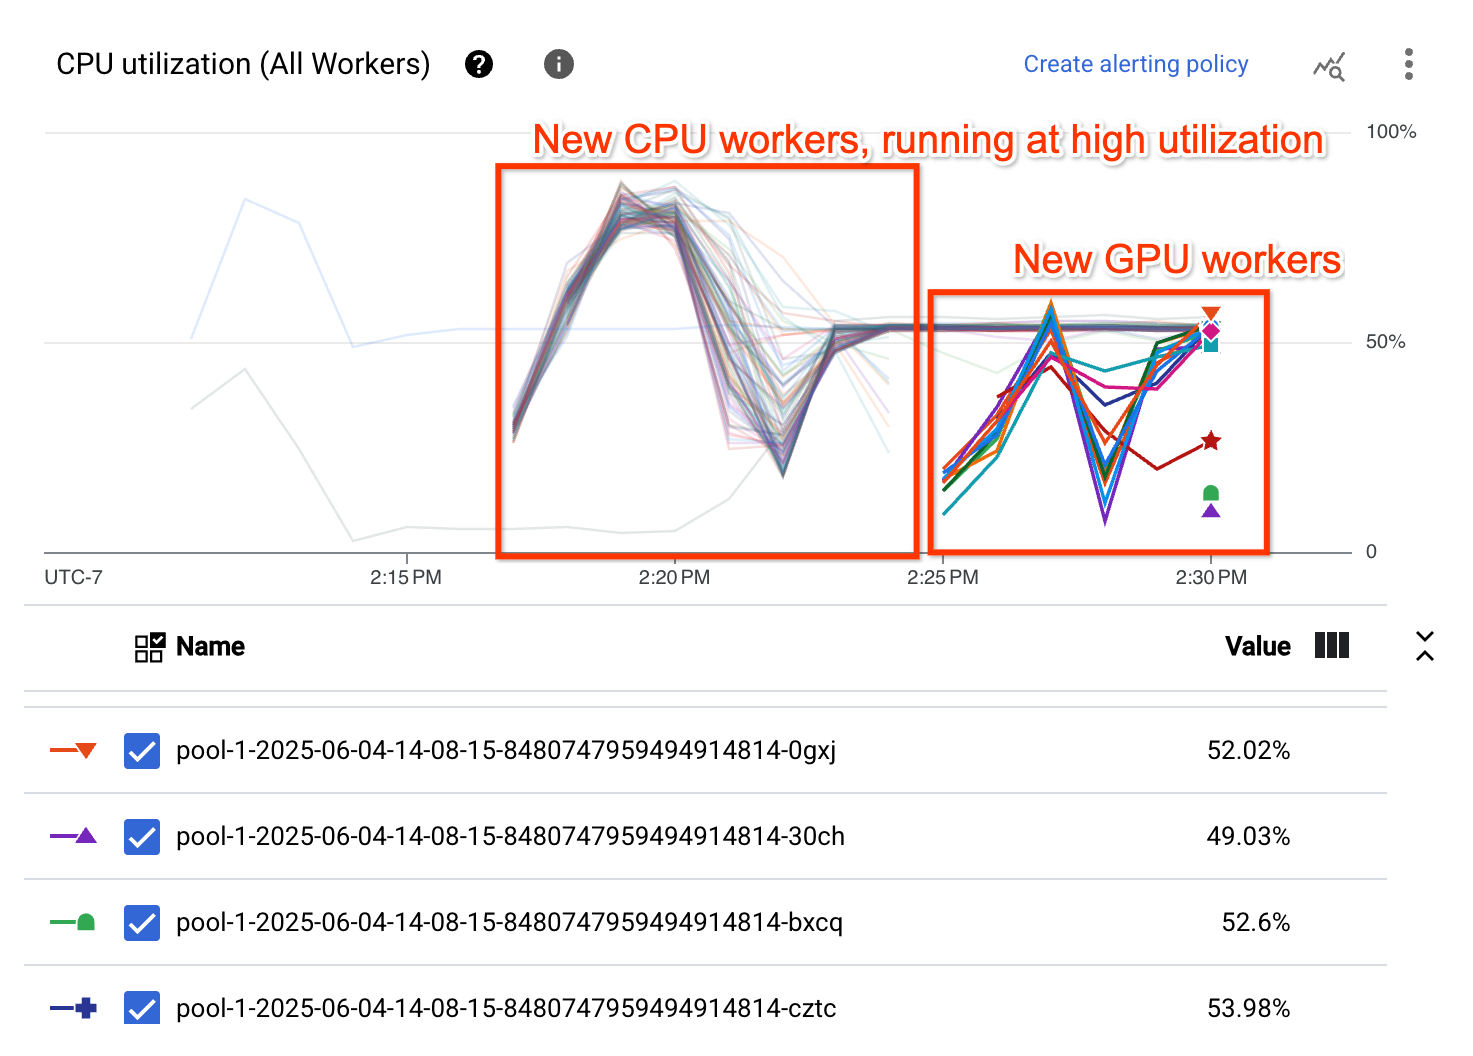
Il grafico Utilizzo CPU mostra che i worker in entrambi i worker pool mostrano un utilizzo della CPU complessivamente elevato:
Risolvere i problemi di adattabilità
Questa sezione fornisce istruzioni per la risoluzione dei problemi comuni relativi alla corretta vestibilità.
Configurazione non valida
Quando provi a utilizzare la taglia giusta, si verifica il seguente errore:
Workflow failed. Causes: One or more operations had an error: 'operation-OPERATION_ID':
[UNSUPPORTED_OPERATION] 'NUMBER vCpus with NUMBER MiB memory is
an invalid configuration for NUMBER count of 'GPU_TYPE' in family 'MACHINE_TYPE'.'.
Questo errore si verifica quando il tipo di GPU selezionato non è compatibile con il tipo di macchina selezionato. Per risolvere questo errore, seleziona un tipo di GPU e un tipo di macchina compatibili. Per i dettagli sulla compatibilità, consulta Piattaforme GPU.
Parallelismo imprevisto con la selezione automatica delle VM
Se osservi un basso utilizzo della CPU o un parallelismo imprevisto sulle VM worker quando utilizzi la selezione automatica delle VM con dimensionamento corretto, potrebbe indicare un problema per cui il numero di thread per worker non è impostato automaticamente in modo che corrisponda al numero di vCPU del tipo di macchina selezionato.
Per risolvere il problema, imposta in modo esplicito l'numberOfWorkerHarnessThreads opzione della pipeline e il suggerimento per la risorsa della pipeline cpu_count sullo stesso valore. Ad esempio, se hai bisogno di 2 vCPU, imposta --numberOfWorkerHarnessThreads=2 e --resourceHints=cpu_count=2. Tieni presente che l'opzione numberOfWorkerHarnessThreads si applica a livello globale a tutti i pool di worker nella pipeline.
Verifica la corretta vestibilità
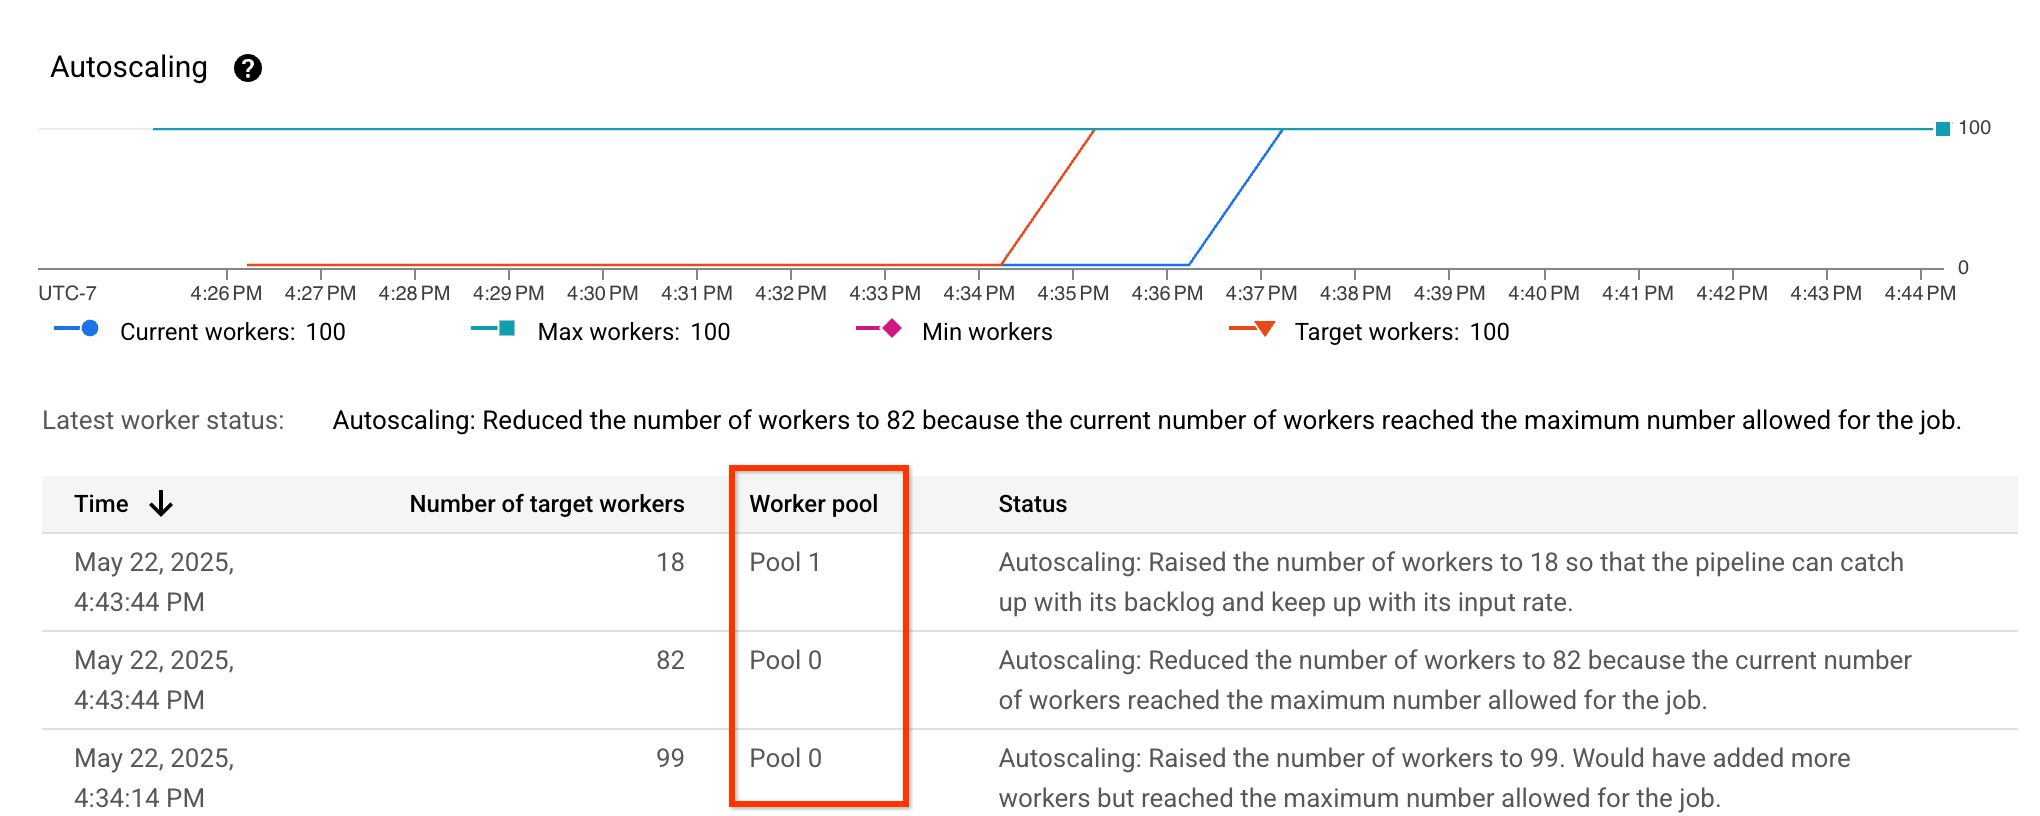
Puoi verificare che il dimensionamento corretto sia abilitato visualizzando le metriche di scalabilità automatica e verificando che la colonna Worker pool sia visibile e elenchi diversi pool:
Prestazioni di adattamento dello streaming
Le pipeline di streaming con l'adattamento dei diritti abilitato potrebbero non sempre avere un rendimento migliore rispetto a quelle senza. Ad esempio:
- La pipeline utilizza più worker
- La latenza del sistema è più elevata o la velocità effettiva è inferiore
- Le dimensioni del pool di worker cambiano più spesso o non si stabilizzano
Se noti questo problema per la tua pipeline, puoi disattivare l'adattamento alla destra rimuovendo l'opzione della pipeline --experiments=enable_streaming_rightfitting. Inoltre, le pipeline di streaming con l'adattamento corretto abilitato utilizzando i suggerimenti sulle risorse dell'acceleratore potrebbero utilizzare più acceleratori del necessario. Se osservi questo comportamento per la tua pipeline, puoi configurare un numero massimo di acceleratori utilizzati dalla pipeline impostando l'opzione della pipeline --experiments=max_num_accelerators=NUM.