


Se riscontri problemi con la pipeline o il job Dataflow, questa pagina elenca i messaggi di errore che potresti visualizzare e fornisce suggerimenti su come correggerli.
Gli errori nei tipi di log dataflow.googleapis.com/worker-startup,
dataflow.googleapis.com/harness-startup e dataflow.googleapis.com/kubelet
indicano problemi di configurazione di un job. Possono anche indicare condizioni che impediscono il normale funzionamento del percorso di logging.
La pipeline potrebbe generare eccezioni durante l'elaborazione dei dati. Alcuni di questi errori sono temporanei, ad esempio quando si verifica una difficoltà temporanea di accesso a un servizio esterno. Alcuni di questi errori sono permanenti, ad esempio quelli causati da dati di input danneggiati o non analizzabili o da puntatori nulli durante il calcolo.
Dataflow elabora gli elementi in bundle arbitrari e riprova l'intero bundle quando viene generato un errore per un elemento del bundle. Quando viene eseguito in modalità batch, i bundle che includono un elemento con errori vengono riprovati quattro volte. La pipeline non va a buon fine se un singolo bundle non va a buon fine quattro volte. Quando viene eseguito in modalità flusso, un bundle che include un elemento con errori viene ritentato all'infinito, il che potrebbe causare il blocco permanente della pipeline.
Le eccezioni nel codice utente, ad esempio le istanze DoFn, vengono segnalate nell'interfaccia di monitoraggio di Dataflow. Se esegui la pipeline con BlockingDataflowPipelineRunner, vedrai anche i messaggi di errore stampati nella finestra della console o del terminale.
Valuta la possibilità di proteggerti dagli errori nel codice aggiungendo gestori di eccezioni. Ad esempio, se vuoi eliminare gli elementi che non superano una convalida dell'input personalizzata eseguita in un ParDo, utilizza un blocco try/catch all'interno del ParDo per gestire l'eccezione, registrare ed eliminare l'elemento. Per i workload di produzione, implementa un pattern di messaggi non elaborati. Per monitorare il conteggio degli errori, utilizza le trasformazioni di aggregazione.
File di log mancanti
Se non vedi log per i tuoi job, rimuovi eventuali filtri di esclusione contenenti resource.type="dataflow_step" da tutti i sink del router dei log di Cloud Logging.
Per maggiori dettagli sulla rimozione delle esclusioni dei log, consulta la guida Rimozione delle esclusioni.
Duplicati nell'output
Quando esegui un job Dataflow, l'output contiene record duplicati.
Questo problema può verificarsi quando il job Dataflow utilizza la modalità di flussi di dati della pipeline at-least-once. Questa modalità garantisce che i record vengano elaborati almeno una volta. Tuttavia, in questa modalità sono possibili record duplicati.
Se il tuo workflow non può tollerare record duplicati, utilizza la modalità di flussi di dati exactly-once. Questa modalità contribuisce a garantire che i record non vengano eliminati o duplicati durante il passaggio dei dati nella pipeline.
Per verificare la modalità flusso di dati utilizzata dal job, consulta Visualizza la modalità flusso di dati di un job.
Per saperne di più sulle modalità di flusso, consulta Imposta la modalità di flusso della pipeline.
Errori della pipeline
Le sezioni seguenti contengono gli errori comuni della pipeline che potresti riscontrare e i passaggi per risolverli o per la risoluzione dei problemi.
Alcune API Cloud devono essere abilitate
Quando provi a eseguire un job Dataflow, si verifica il seguente errore:
Some Cloud APIs need to be enabled for your project in order for Cloud Dataflow to run this job.
Questo problema si verifica perché alcune API richieste non sono abilitate nel tuo progetto.
Per risolvere il problema ed eseguire un job Dataflow, abilita le seguenti APIGoogle Cloud nel tuo progetto:
- API Compute Engine (Compute Engine)
- API Cloud Logging
- Cloud Storage
- API JSON di Cloud Storage
- API BigQuery
- Pub/Sub
- API Datastore
Per istruzioni dettagliate, consulta la sezione Guida introduttiva sull'abilitazione delle APIGoogle Cloud .
"@*" e "@N" sono specifiche di sharding riservate
Quando provi a eseguire un job, nei file di log viene visualizzato il seguente errore e il job non va a buon fine:
Workflow failed. Causes: "@*" and "@N" are reserved sharding specs. Filepattern must not contain any of them.
Questo errore si verifica se il nome file del percorso di Cloud Storage per i file temporanei (tempLocation o temp_location) contiene un simbolo di chiocciola (@) seguito da un numero o da un asterisco (*).
Per risolvere il problema, modifica il nome file in modo che il simbolo @ sia seguito da un carattere supportato.
Richiesta errata
Quando esegui un job Dataflow, i log di Cloud Monitoring mostrano una serie di avvisi simili ai seguenti:
Unable to update setup work item STEP_ID error: generic::invalid_argument: Http(400) Bad Request
Update range task returned 'invalid argument'. Assuming lost lease for work with id LEASE_ID
with expiration time: TIMESTAMP, now: TIMESTAMP. Full status: generic::invalid_argument: Http(400) Bad Request
Gli avvisi di richiesta non valida si verificano se le informazioni sullo stato del worker sono obsolete o non sincronizzate a causa di ritardi nell'elaborazione. Spesso, il job Dataflow ha esito positivo nonostante gli avvisi di richiesta non valida. In questo caso, ignora gli avvisi.
Impossibile leggere e scrivere in località diverse
Quando esegui un job Dataflow, potresti visualizzare il seguente errore nei file di log:
message:Cannot read and write in different locations: source: SOURCE_REGION, destination: DESTINATION_REGION,reason:invalid
Questo errore si verifica quando l'origine e la destinazione si trovano in regioni diverse. Può
verificarsi anche quando la località di gestione temporanea e la destinazione si trovano in regioni
diverse. Ad esempio, se il job legge da Pub/Sub e poi scrive in un bucket Cloud Storage temp prima di scrivere in una tabella BigQuery, il bucket Cloud Storage temp e la tabella BigQuery devono trovarsi nella stessa regione.
Le località multiregionali sono considerate diverse da quelle a regione singola, anche se la singola regione rientra nell'ambito della località multiregionale.
Ad esempio, us (multiple regions in the United States) e us-central1 sono regioni diverse.
Per risolvere il problema, assicurati che le località di destinazione, di origine e di gestione temporanea si trovino nella stessa regione. Le località dei bucket Cloud Storage non possono essere modificate, quindi potresti dover creare un nuovo bucket Cloud Storage nella regione corretta.
Timeout della connessione
Quando esegui un job Dataflow, potresti visualizzare il seguente errore nei file di log:
org.springframework.web.client.ResourceAccessException: I/O error on GET request for CONNECTION_PATH: Connection timed out (Connection timed out); nested exception is java.net.ConnectException: Connection timed out (Connection timed out)
Questo problema si verifica quando i worker Dataflow non riescono a stabilire o mantenere una connessione con l'origine o la destinazione dei dati.
Per risolvere il problema, segui questi passaggi per la risoluzione dei problemi:
- Verifica che l'origine dati sia in esecuzione.
- Verifica che la destinazione sia in esecuzione.
- Esamina i parametri di connessione utilizzati nella configurazione della pipeline di Dataflow.
- Verifica che i problemi di prestazioni non influiscano sull'origine o sulla destinazione.
- Assicurati che le regole firewall non blocchino la connessione.
Nessun oggetto di questo tipo
Quando esegui i job Dataflow, potresti visualizzare il seguente errore nei file di log:
..., 'server': 'UploadServer', 'status': '404'}>, <content <No such object:...
Questi errori si verificano in genere quando alcuni dei job Dataflow in esecuzione utilizzano lo stesso temp_location per l'area di gestione temporanea dei file dei job temporanei creati durante l'esecuzione della pipeline. Quando più job simultanei condividono lo stesso temp_location,
questi job potrebbero sovrascrivere i dati temporanei l'uno dell'altro e potrebbe verificarsi una race condition. Per evitare questo problema, ti consigliamo di utilizzare un temp_location univoco per ogni job.
Dataflow non è in grado di determinare il backlog
Quando esegui una pipeline di streaming da Pub/Sub, viene visualizzato il seguente avviso:
Dataflow is unable to determine the backlog for Pub/Sub subscription
Quando una pipeline Dataflow estrae dati da Pub/Sub, Dataflow deve richiedere ripetutamente informazioni a Pub/Sub. Queste informazioni includono la quantità di backlog nella sottoscrizione e l'età del messaggio non confermato più vecchio. A volte, Dataflow non è in grado di recuperare queste informazioni da Pub/Sub a causa di problemi di sistema interni, che potrebbero causare un accumulo temporaneo di backlog.
Per saperne di più, consulta Streaming con Cloud Pub/Sub.
DEADLINE_EXCEEDED o Server Unresponsive
Quando esegui i job, potresti riscontrare eccezioni di timeout RPC o uno dei seguenti errori:
DEADLINE_EXCEEDED
Oppure:
Server Unresponsive
In genere, questi errori si verificano per uno dei seguenti motivi:
Nella rete Virtual Private Cloud (VPC) utilizzata per il job potrebbe mancare una regola firewall. La regola firewall deve abilitare tutto il traffico TCP tra le VM nella rete VPC specificata nelle opzioni della pipeline. Per saperne di più, consulta Regole firewall per Dataflow.
In alcuni casi, i worker non sono in grado di comunicare tra loro. Quando esegui un job Dataflow che non utilizza Dataflow Shuffle o Streaming Engine, i worker devono comunicare tra loro utilizzando le porte TCP
12345e12346all'interno della rete VPC. In questo scenario, l'errore include il nome dell'harness del worker e la porta TCP bloccata. L'errore è simile a uno dei seguenti esempi:DEADLINE_EXCEEDED: (g)RPC timed out when SOURCE_WORKER_HARNESS talking to DESTINATION_WORKER_HARNESS:12346.Rpc to WORKER_HARNESS:12345 completed with error UNAVAILABLE: failed to connect to all addresses Server unresponsive (ping error: Deadline Exceeded, UNKNOWN: Deadline Exceeded...)Per risolvere il problema, utilizza il flag
gcloud compute firewall-rules createrules per consentire il traffico di rete verso le porte12345e12346. L'esempio seguente mostra il comando Google Cloud CLI:gcloud compute firewall-rules create FIREWALL_RULE_NAME \ --network NETWORK \ --action allow \ --direction IN \ --target-tags dataflow \ --source-tags dataflow \ --priority 0 \ --rules tcp:12345-12346Sostituisci quanto segue:
FIREWALL_RULE_NAME: il nome della regola firewallNETWORK: il nome della tua rete
Il job è limitato dallo shuffle.
Per risolvere il problema, apporta una o più delle seguenti modifiche.
Java
- Se il job non utilizza lo shuffling basato sul servizio, passa all'utilizzo di Dataflow Shuffle basato sul servizio impostando
--experiments=shuffle_mode=service. Per i dettagli e la disponibilità, consulta Dataflow Shuffle. - Aggiungi altri worker. Prova a impostare
--numWorkerssu un valore più alto quando esegui la pipeline. - Aumenta le dimensioni del disco collegato per i worker. Prova a impostare
--diskSizeGbsu un valore più alto quando esegui la pipeline. - Utilizza un Persistent Disk supportato da SSD. Prova a impostare
--workerDiskType="compute.googleapis.com/projects/PROJECT_ID/zones/ZONE/diskTypes/pd-ssd"quando esegui la pipeline.
Python
- Se il job non utilizza lo shuffling basato sul servizio, passa all'utilizzo di Dataflow Shuffle basato sul servizio impostando
--experiments=shuffle_mode=service. Per i dettagli e la disponibilità, consulta Dataflow Shuffle. - Aggiungi altri worker. Prova a impostare
--num_workerssu un valore più alto quando esegui la pipeline. - Aumenta le dimensioni del disco collegato per i worker. Prova a impostare
--disk_size_gbsu un valore più alto quando esegui la pipeline. - Utilizza un Persistent Disk supportato da SSD. Prova a impostare
--worker_disk_type="compute.googleapis.com/projects/PROJECT_ID/zones/ZONE/diskTypes/pd-ssd"quando esegui la pipeline.
Vai
- Se il job non utilizza lo shuffling basato sul servizio, passa all'utilizzo di Dataflow Shuffle basato sul servizio impostando
--experiments=shuffle_mode=service. Per i dettagli e la disponibilità, consulta Dataflow Shuffle. - Aggiungi altri worker. Prova a impostare
--num_workerssu un valore più alto quando esegui la pipeline. - Aumenta le dimensioni del disco collegato per i worker. Prova a impostare
--disk_size_gbsu un valore più alto quando esegui la pipeline. - Utilizza un Persistent Disk supportato da SSD. Prova a impostare
--disk_type="compute.googleapis.com/projects/PROJECT_ID/zones/ZONE/diskTypes/pd-ssd"quando esegui la pipeline.
- Se il job non utilizza lo shuffling basato sul servizio, passa all'utilizzo di Dataflow Shuffle basato sul servizio impostando
Suddivisione vuota restituita
Quando esegui un job Dataflow, nei log dei worker potrebbe essere visualizzato il seguente messaggio:
Continuing to process work-id WORK_ID without splitting. Reader split status was: INTERNAL: Empty split returned and SDK split status was: ...
Se il job viene eseguito correttamente, questo messaggio è innocuo e puoi ignorarlo. Questo messaggio può essere visualizzato a causa di una race condition in cui il servizio tenta di suddividere il lavoro già completato.
Errori di codifica, IOException o comportamenti imprevisti nel codice utente
Gli SDK Apache Beam e i worker Dataflow dipendono da componenti di terze parti comuni. Questi componenti importano dipendenze aggiuntive. Le collisioni di versioni possono causare un comportamento imprevisto nel servizio. Inoltre, alcune librerie non sono compatibili con le versioni successive. Potresti dover bloccare le versioni elencate che rientrano nell'ambito durante l'esecuzione. Dipendenze dell'SDK e dei worker contiene un elenco di dipendenze e delle relative versioni richieste.
Il tipo di macchina richiede il tipo di disco Hyperdisk bilanciato
Quando provi a eseguire un job Dataflow, si verifica il seguente errore:
MACHINE_TYPE machine types require the Hyperdisk Balanced disk type.
Questo problema si verifica quando utilizzi un tipo di macchina che richiede
dischi Hyperdisk bilanciato,
come C4A o N4, ma specifichi un tipo di disco incompatibile, come pd-standard.
Per risolvere il problema, se utilizzi un tipo di macchina che richiede dischi Hyperdisk bilanciato, non specificare l'opzione della pipeline workerDiskType (worker_disk_type per Python, disk_type per Go) o impostala su hyperdisk-balanced.
Errore durante l'esecuzione di LookupEffectiveGuestPolicies
Quando esegui un job Dataflow, potresti visualizzare il seguente errore nei file di log:
OSConfigAgent Error policies.go:49: Error running LookupEffectiveGuestPolicies:
error calling LookupEffectiveGuestPolicies: code: "Unauthenticated",
message: "Request is missing required authentication credential.
Expected OAuth 2 access token, login cookie or other valid authentication credential.
Questo errore si verifica se la gestione della configurazione del sistema operativo è abilitata per l'intero progetto.
Per risolvere il problema, disattiva le policy di VM Manager che si applicano all'intero progetto. Se non è possibile disattivare le policy di VM Manager per l'intero progetto, puoi ignorare questo errore e filtrarlo dagli strumenti di monitoraggio dei log.
Violazione del vincolo di accesso IP esterno
Quando esegui o cloni un job Dataflow, si verifica il seguente errore:
Constraint constraints/compute.vmExternalIpAccess violated for project PROJECT_ID.
Questo errore si verifica quando un vincolo delle policy dell'organizzazione vieta alle istanze VM di utilizzare indirizzi IP esterni, ma il job Dataflow è configurato per utilizzare indirizzi IP esterni.
Per risolvere il problema, configura esplicitamente il job in modo che utilizzi solo indirizzi IP interni:
- Nella console Google Cloud : nell'elenco Configurazione indirizzo IP worker, seleziona Privato.
- Utilizzando l'SDK: imposta l'opzione della pipeline
--usePublicIps=false.
Per saperne di più, consulta Disattiva gli indirizzi IP esterni.
A fatal error has been detected by the Java Runtime Environment
Durante l'avvio del worker si verifica il seguente errore:
A fatal error has been detected by the Java Runtime Environment
Questo errore si verifica se la pipeline utilizza Java Native Interface (JNI) per eseguire codice non Java e il codice o le associazioni JNI contengono un errore.
Errore della chiave dell'attributo googclient_deliveryattempt
Il job Dataflow non riesce e viene visualizzato uno dei seguenti errori:
The request contains an attribute key that is not valid (key=googclient_deliveryattempt). Attribute keys must be non-empty and must not begin with 'goog' (case-insensitive).
Oppure:
Invalid extensions name: googclient_deliveryattempt
Questo errore si verifica quando il job Dataflow presenta le seguenti caratteristiche:
- Il job Dataflow utilizza Streaming Engine.
- La pipeline ha un sink Pub/Sub.
- La pipeline utilizza una sottoscrizione pull.
- La pipeline utilizza una delle API di servizio Pub/Sub per pubblicare i messaggi anziché utilizzare il sink di I/O Pub/Sub integrato.
- Pub/Sub utilizza la libreria client Java o C#.
- La sottoscrizione Pub/Sub ha un argomento di messaggi non recapitabili.
Questo errore si verifica perché, quando utilizzi la libreria client Pub/Sub Java o C# e un argomento messaggi non recapitabili per una sottoscrizione è abilitato, i tentativi di invio si trovano nell'attributo del messaggio googclient_deliveryattempt anziché nel campo delivery_attempt. Per saperne di più, consulta Monitora i tentativi di consegna nella pagina "Gestisci gli errori dei messaggi".
Per risolvere il problema, apporta una o più delle seguenti modifiche.
- Disabilita Streaming Engine.
- Utilizza il connettore Apache Beam
PubSubIOintegrato anziché l'API di servizio Pub/Sub. - Utilizza un tipo di sottoscrizione Pub/Sub diverso.
- Rimuovi l'argomento di messaggi non recapitabili.
- Non utilizzare la libreria client Java o C# con la sottoscrizione pull Pub/Sub. Per altre opzioni, consulta Esempi di codice della libreria client.
- Nel codice della pipeline, quando le chiavi degli attributi iniziano con
goog, cancella gli attributi dei messaggi prima di pubblicarli.
È stata rilevata una hot key…
Si verifica il seguente errore:
A hot key HOT_KEY_NAME was detected in...
Questi errori si verificano se i dati contengono una hot key. Una hot key è una chiave con un numero di elementi sufficiente a influire negativamente sulle prestazioni della pipeline. Queste chiavi limitano la capacità di Dataflow di elaborare gli elementi in parallelo, il che aumenta il tempo di esecuzione.
Per stampare la chiave leggibile nei log quando viene rilevata una hot key nella pipeline, utilizza l'opzione della pipeline per le hot key.
Per risolvere il problema, verifica che i dati siano distribuiti in modo uniforme. Se una chiave ha un numero sproporzionato di valori, valuta le seguenti linee d'azione:
- Esegui la nuova codifica dei dati. Applica una trasformazione
ParDoper generare nuove coppie chiave-valore. - Per i job Java, utilizza la trasformazione
Combine.PerKey.withHotKeyFanout. - Per i job Python, utilizza la trasformazione
CombinePerKey.with_hot_key_fanout. - Attiva Dataflow Shuffle.
Per visualizzare le hot key nell'interfaccia di monitoraggio di Dataflow, consulta Risolvi i problemi relativi agli elementi lenti nei job batch.
Il grafico del job è troppo grande
Il job potrebbe non riuscire con il seguente errore:
The job graph is too large. Please try again with a smaller job graph,
or split your job into two or more smaller jobs.
Questo errore si verifica se le dimensioni del grafico del job superano i 10 MB. Alcune condizioni nella pipeline possono far sì che il grafico del job superi il limite. Le condizioni più comuni includono:
- Una trasformazione
Createche include una grande quantità di dati in memoria. - Un'istanza
DoFndi grandi dimensioni serializzata per la trasmissione ai worker remoti. - Un
DoFncome istanza di classe interna anonima che (forse inavvertitamente) inserisce una grande quantità di dati da serializzare. - Un grafo diretto aciclico (DAG) viene utilizzato come parte di un ciclo programmatico che enumera un elenco di grandi dimensioni.
Per evitare queste condizioni, valuta la possibilità di ristrutturare la pipeline.
Commit della chiave troppo grande
Quando esegui un job di flussi di dati, nei file di log dei worker viene visualizzato il seguente errore:
KeyCommitTooLargeException
Questo errore si verifica negli scenari di flussi di dati ogni volta che un commit di un singolo elemento di lavoro supera il limite massimo di dimensioni del commit. Per saperne di più sui limiti delle dimensioni dei commit, consulta Quote e limiti.
Quando un commit supera il limite, Dataflow lo rifiuta, genera KeyCommitTooLargeException nei log dei worker e tenta di rielaborare l'elemento di lavoro utilizzando una dimensione del bundle iniziale più piccola (troncamento del bundle):
- Eccezioni temporanee (troncamento del bundle riuscito): se il bundle può essere suddiviso in commit più piccoli i cui output rientrano nel limite, potresti visualizzare un singolo errore
KeyCommitTooLargeExceptiono un errore non frequente prima che la pipeline continui a progredire. Tuttavia, la velocità di elaborazione viene temporaneamente ridotta a causa dei nuovi tentativi con bundle più piccoli. - Eccezioni continue (blocchi dell'elaborazione delle chiavi): se la dimensione del bundle iniziale viene ridotta fino a un singolo messaggio di input o timer e l'output generato o la modifica dello stato supera ancora il limite di commit, l'elemento di lavoro non può essere ulteriormente suddiviso. Poiché Dataflow riprova continuamente a eseguire il commit, ma l'operazione non va a buon fine, l'elaborazione per quella chiave si blocca completamente e i log dei worker mostrano occorrenze ripetute e continue di
KeyCommitTooLargeExceptionche non si risolvono automaticamente.
Strategie di mitigazione
Per ridurre la possibilità di riscontrare questo errore, utilizza le seguenti strategie:
- Assicurati che l'elaborazione di un singolo elemento o di una singola finestra non possa comportare output o modifiche dello stato che superano il limite di dimensioni del commit. Ad esempio, se una trasformazione accetta elementi di input relativamente piccoli e restituisce output molto più grandi, ad esempio leggendo un nome file ed emettendo l'intero contenuto di un file di grandi dimensioni, l'output risultante può superare il limite di dimensioni del commit anche quando viene elaborato un solo elemento di input.
- Se più elementi sono raggruppati per chiave senza utilizzare una trasformazione
Combine, valuta la possibilità di aumentare lo spazio delle chiavi (ad esempio aggiungendo bucket di tempo o identificatori secondari) per ridurre il numero di elementi raggruppati per chiave. - Se gli elementi di una chiave vengono emessi ad alta frequenza in un breve periodo di tempo, ciò potrebbe comportare molti GB di eventi per quella chiave in una finestra. Riscrivi la pipeline per rilevare le chiavi ad alta frequenza ed emettere solo un output che indica che la chiave era presente di frequente in quella finestra.
- Utilizza trasformazioni
Combinecon spazio sublineare per operazioni commutative e associative. Non utilizzare un combiner se non riduce le dimensioni dei dati. Ad esempio, un combinatore per stringhe che aggiunge stringhe è peggiore rispetto a non utilizzare un combinatore.
Rifiuto del messaggio di dimensioni superiori a 7168K
Quando esegui un job Dataflow creato da un template, il job potrebbe non riuscire con il seguente errore:
Error: CommitWork failed: status: APPLICATION_ERROR(3): Pubsub publish requests are limited to 10MB, rejecting message over 7168K (size MESSAGE_SIZE) to avoid exceeding limit with byte64 request encoding.
Questo errore si verifica quando i messaggi scritti in una coda di messaggi non recapitabili superano il limite di dimensioni di 7168 K. Come soluzione alternativa, attiva Streaming Engine, che ha un limite di dimensioni più elevato. Per attivare Streaming Engine, utilizza la seguente opzione della pipeline.
Java
--enableStreamingEngine=true
Python
--enable_streaming_engine=true
Request Entity Too Large (Dimensioni dell'entità richiesta eccessive)
Quando invii il job, nella console o nella finestra del terminale viene visualizzato uno dei seguenti errori:
413 Request Entity Too Large
The size of serialized JSON representation of the pipeline exceeds the allowable limit
Failed to create a workflow job: Invalid JSON payload received
Failed to create a workflow job: Request payload exceeds the allowable limit
Se durante l'invio del job viene visualizzato un errore relativo al payload JSON, la rappresentazione JSON della pipeline supera la dimensione massima della richiesta di 20 MB.
Le dimensioni del job sono legate alla rappresentazione JSON della pipeline. Una pipeline più grande significa una richiesta più grande. Dataflow ha una limitazione che limita le richieste a 20 MB.
Per stimare le dimensioni della richiesta JSON della pipeline, esegui la pipeline con la seguente opzione:
Java
--dataflowJobFile=PATH_TO_OUTPUT_FILE
Python
--dataflow_job_file=PATH_TO_OUTPUT_FILE
Vai
L'output del job in formato JSON non è supportato in Go.
Questo comando scrive una rappresentazione JSON del job in un file. Le dimensioni del file serializzato sono una buona stima delle dimensioni della richiesta. Le dimensioni effettive sono leggermente superiori a causa di alcune informazioni aggiuntive incluse nella richiesta.
Alcune condizioni nella pipeline possono far sì che la rappresentazione JSON superi il limite. Le condizioni più comuni includono:
- Una trasformazione
Createche include una grande quantità di dati in memoria. - Un'istanza
DoFndi grandi dimensioni serializzata per la trasmissione ai worker remoti. - Un
DoFncome istanza di classe interna anonima che (forse inavvertitamente) inserisce una grande quantità di dati da serializzare.
Per evitare queste condizioni, valuta la possibilità di ristrutturare la pipeline.
Le opzioni della pipeline dell'SDK o l'elenco dei file di gestione temporanea superano il limite di dimensioni
Quando esegui una pipeline, si verifica uno dei seguenti errori:
SDK pipeline options or staging file list exceeds size limit.
Please keep their length under 256K Bytes each and 512K Bytes in total.
Oppure:
Value for field 'resource.properties.metadata' is too large: maximum size
Questi errori si verificano se non è stato possibile avviare la pipeline perché sono stati superati i limiti dei metadati di Compute Engine. Questi limiti non possono essere modificati. Dataflow utilizza i metadati di Compute Engine per le opzioni della pipeline. Il limite è documentato nelle limitazioni dei metadati personalizzati di Compute Engine.
I seguenti scenari possono far sì che la rappresentazione JSON superi il limite:
- Ci sono troppi file JAR da preparare.
- Il campo della richiesta
sdkPipelineOptionsè troppo grande.
Per stimare le dimensioni della richiesta JSON della pipeline, esegui la pipeline con la seguente opzione:
Java
--dataflowJobFile=PATH_TO_OUTPUT_FILE
Python
--dataflow_job_file=PATH_TO_OUTPUT_FILE
Vai
L'output del job in formato JSON non è supportato in Go.
Le dimensioni del file di output di questo comando devono essere inferiori a 256 kB. I 512 KB nel messaggio di errore si riferiscono alla dimensione totale del file di output e alle opzioni dei metadati personalizzati per l'istanza VM di Compute Engine.
Puoi ottenere una stima approssimativa dell'opzione dei metadati personalizzati per l'istanza VM dai job Dataflow in esecuzione nel progetto. Scegli un job Dataflow in esecuzione. Seleziona un'istanza VM, quindi vai alla pagina dei dettagli dell'istanza VM di Compute Engine per verificare la presenza della sezione dei metadati personalizzati. La lunghezza totale dei metadati personalizzati e del file deve essere inferiore a 512 KB. Non è possibile fornire una stima accurata per il job non riuscito, perché le VM non vengono avviate per i job non riusciti.
Se l'elenco di JAR sta raggiungendo il limite di 256 kB, esaminalo e riduci i file JAR non necessari. Se è ancora troppo grande, prova a eseguire il job Dataflow utilizzando un uber JAR. Per un esempio che mostra come creare e utilizzare un uber JAR, consulta Crea ed esegui il deployment di un uber JAR.
Se il campo della richiesta sdkPipelineOptions è troppo grande, includi la seguente opzione quando esegui la pipeline. L'opzione della pipeline è la stessa per Java, Python e Go.
--experiments=no_display_data_on_gce_metadata
Chiave di shuffle troppo grande
Nei file di log del worker viene visualizzato il seguente errore:
Shuffle key too large
Questo errore si verifica se la chiave serializzata emessa per un determinato (Co-)GroupByKey è troppo grande dopo l'applicazione del coder corrispondente. Dataflow ha un limite per le chiavi di shuffling serializzate.
Per risolvere il problema, riduci le dimensioni delle chiavi o utilizza codificatori più efficienti in termini di spazio.
Per saperne di più, consulta i limiti di produzione per Dataflow.
Side input stale caching in global window
Quando esegui una pipeline di streaming utilizzando l'SDK Apache Beam per Python, gli input secondari nella finestra globale potrebbero subire ritardi imprevedibili negli aggiornamenti. I worker potrebbero conservare i vecchi valori degli input secondari per periodi prolungati, soprattutto durante l'elaborazione di dati di input principali continui. Questo problema in genere interessa le pipeline che utilizzano Pub/Sub sia come input principale che come input secondario.
Per risolvere il problema, se utilizzi l'SDK Apache Beam versione 2.56.0 o successive, attiva il flag dell'esperimento disable_global_windowed_args_caching:
--experiments=disable_global_windowed_args_caching
Total number of BoundedSource objects … is larger than the allowable limit
Quando esegui job con Java, potrebbe verificarsi uno dei seguenti errori:
Total number of BoundedSource objects generated by splitIntoBundles() operation is larger than the allowable limit
Oppure:
Total size of the BoundedSource objects generated by splitIntoBundles() operation is larger than the allowable limit
Java
Questo errore potrebbe verificarsi se stai leggendo un numero molto elevato di file utilizzando TextIO, AvroIO, BigQueryIO tramite EXPORT o un'altra origine basata su file. Il limite specifico dipende dai dettagli della tua origine, ma è nell'ordine di decine di migliaia di file in una pipeline. Ad esempio, l'incorporamento dello schema in AvroIO.Read consente un numero inferiore di file.
Questo errore potrebbe verificarsi anche se hai creato un'origine dati personalizzata per la tua pipeline e il metodo splitIntoBundles dell'origine ha restituito un elenco di oggetti BoundedSource che occupa più di 20 MB quando viene serializzato.
Il limite consentito per la dimensione totale degli oggetti BoundedSource generati dall'operazione splitIntoBundles() dell'origine personalizzata è 20 MB.
Per ovviare a questo limite, apporta una delle seguenti modifiche:
Attiva il runner portatile. Il Portable Runner converte le origini in DoFn suddivisibili che non hanno questo limite di suddivisione delle origini.
Modifica la sottoclasse
BoundedSourcepersonalizzata in modo che la dimensione totale degli oggettiBoundedSourcegenerati sia inferiore al limite di 20 MB. Ad esempio, l'origine potrebbe generare inizialmente un numero inferiore di suddivisioni e fare affidamento sul ribilanciamento dinamico del lavoro per suddividere ulteriormente gli input on demand.
Le dimensioni del payload della richiesta superano il limite: 20.971.520 byte
Quando esegui una pipeline, il job potrebbe non riuscire con il seguente errore:
com.google.api.client.googleapis.json.GoogleJsonResponseException: 400 Bad Request
POST https://dataflow.googleapis.com/v1b3/projects/PROJECT_ID/locations/REGION/jobs/JOB_ID/workItems:reportStatus
{
  "code": 400,
  "errors": [
    {
      "domain": "global",
      "message": "Request payload size exceeds the limit: 20971520 bytes.",
      "reason": "badRequest"
    }
  ],
  "message": "Request payload size exceeds the limit: 20971520 bytes.",
  "status": "INVALID_ARGUMENT"
}
Questo errore può verificarsi quando un job che utilizza il runner Dataflow ha un grafico del job molto grande. Un grafico dei job di grandi dimensioni può generare un numero elevato di metriche che devono essere segnalate al servizio Dataflow. Se le dimensioni di queste metriche superano il limite di 20 MB per le richieste API, il job non va a buon fine.
Per risolvere il problema, esegui la migrazione della pipeline in modo da utilizzare il runner portatile di Dataflow. Il runner portatile utilizza un metodo più efficiente per la generazione di report sulle metriche e non ha questa limitazione di 20 MB.
ModuleNotFoundError: No module named 'pkg_resources'
Quando esegui un job Dataflow, si verifica il seguente errore durante l'avvio del worker o l'installazione delle dipendenze:
ModuleNotFoundError: No module named 'pkg_resources'
Questo problema si verifica perché a partire dalla versione 82.0.0 di setuptools (rilasciata l'8 febbraio 2026), il modulo pkg_resources è stato rimosso. Questo modulo è stato ritirato in precedenza ed è stato sostituito da importlib.resources e importlib.metadata.
Per risolvere il problema, utilizza uno dei seguenti metodi:
Blocca
setuptools: se le tue dipendenze richiedono una versione disetuptoolscompatibile con le versioni precedenti per la corretta compilazione, forza un requisito di versione specifico utilizzando l'argomentosetup_requiresnel filesetup.py. Ad esempio:import setuptools setuptools.setup( name='PACKAGE-NAME', version='PACKAGE-VERSION', # Pin to a version prior to 82.0.0 setup_requires=['setuptools<82.0.0'], install_requires=['incompatible-package', ...], packages=setuptools.find_packages() )Aggiorna le dipendenze: esamina i requisiti della libreria e delle dipendenze per eseguire l'aggiornamento alle versioni più recenti compatibili con l'ultima versione di
setuptoolse che non si basano supkg_resources.Rimuovi le librerie non necessarie: rimuovi dal file dei requisiti o di configurazione tutte le librerie non richieste dal job. Ad esempio, alcune versioni precedenti di
cx_Oraclesono state identificate come causa di questo problema durante il processo di compilazione.
NameError
Quando esegui la pipeline utilizzando il servizio Dataflow, si verifica il seguente errore:
NameError
Questo errore non si verifica quando l'esecuzione avviene localmente, ad esempio quando utilizzi DirectRunner.
Questo errore si verifica se i tuoi DoFn utilizzano valori nello spazio dei nomi globale che non sono disponibili nel worker Dataflow.
Per impostazione predefinita, le importazioni, le funzioni e le variabili globali definite nella sessione principale non vengono salvate durante la serializzazione di un job Dataflow.
Per risolvere il problema, utilizza uno dei seguenti metodi. Se i tuoi DoFn sono definiti nel file principale e fanno riferimento a importazioni e funzioni nello spazio dei nomi globale, imposta l'opzione della pipeline --save_main_session su True. Questa modifica
salva lo stato dello spazio dei nomi globale e lo carica sul
worker Dataflow.
Se nel tuo spazio dei nomi globale sono presenti oggetti che non possono essere sottoposti a pickling, si verifica un errore di pickling. Se l'errore riguarda un modulo che dovrebbe essere disponibile nella distribuzione Python, importa il modulo localmente, dove viene utilizzato.
Ad esempio, invece di:
import re
…
def myfunc():
  # use re module
utilizza:
def myfunc():
  import re
  # use re module
In alternativa, se i tuoi DoFn si estendono su più file, utilizza un approccio diverso per pacchettizzare il workflow e gestire le dipendenze.
L'oggetto è soggetto alla policy di conservazione del bucket
Quando hai un job Dataflow che scrive in un bucket Cloud Storage, il job non riesce e viene visualizzato il seguente errore:
Object 'OBJECT_NAME' is subject to bucket's retention policy or object retention and cannot be deleted or overwritten
Potresti anche visualizzare il seguente errore:
Unable to rename "gs://BUCKET"
Il primo errore si verifica quando la conservazione degli oggetti è abilitata nel bucket Cloud Storage in cui il job Dataflow sta scrivendo. Per saperne di più, consulta Abilita e utilizza le configurazioni di conservazione degli oggetti.
Per risolvere il problema, utilizza una delle seguenti soluzioni:
Scrivere in un bucket Cloud Storage che non ha una policy di conservazione nella cartella
temp.Rimuovi la policy di conservazione dal bucket in cui scrive il job. Per saperne di più, consulta Imposta la configurazione di conservazione di un oggetto.
Il secondo errore può indicare che la conservazione degli oggetti è abilitata nel bucket Cloud Storage o che il account di servizio worker di Dataflow non dispone dell'autorizzazione per scrivere nel bucket Cloud Storage.
Se visualizzi il secondo errore e la conservazione degli oggetti è abilitata nel bucket Cloud Storage, prova le soluzioni alternative descritte in precedenza. Se la conservazione degli oggetti non è abilitata nel bucket Cloud Storage, verifica se l'account di servizio worker Dataflow dispone dell'autorizzazione di scrittura nel bucket Cloud Storage. Per saperne di più, consulta Accedi ai bucket Cloud Storage.
Elaborazione bloccata o operazione in corso
Se Dataflow impiega più tempo per l'esecuzione di un DoFn rispetto al tempo specificato in TIME_INTERVAL senza restituire un valore, viene visualizzato il seguente messaggio.
Java
Uno dei due seguenti messaggi di log, a seconda della versione:
Processing stuck in step STEP_NAME for at least TIME_INTERVAL
Operation ongoing in bundle BUNDLE_ID for at least TIME_INTERVAL without outputting or completing: at STACK_TRACE
Python
Operation ongoing for over TIME_INTERVAL in state STATE in step STEP_ID without returning. Current Traceback: TRACEBACK
Vai
Operation ongoing in transform TRANSFORM_ID for at least TIME_INTERVAL without outputting or completing in state STATE
Questo comportamento ha due possibili cause:
- Il codice
DoFnè lento o è in attesa del completamento di un'operazione esterna lenta. - Il codice
DoFnpotrebbe essere bloccato, in deadlock o anormalmente lento nel completare l'elaborazione.
Per determinare quale sia il caso, espandi la voce di log di Cloud Monitoring per visualizzare un'analisi dello stack. Cerca i messaggi che indicano che il codice DoFn è bloccato o che si stanno verificando altri problemi. Se non sono presenti messaggi, il problema potrebbe essere la velocità di esecuzione del codice DoFn. Valuta la possibilità di utilizzare Cloud Profiler o un altro strumento per esaminare le prestazioni del codice.
Se la pipeline è basata sulla VM Java (utilizzando Java o Scala), puoi esaminare la causa del blocco del codice. Esegui un dump completo dei thread dell'intera JVM (non solo del thread bloccato) seguendo questi passaggi:
- Prendi nota del nome del worker dalla voce di log.
- Nella sezione Compute Engine della console Google Cloud , individua l'istanza di Compute Engine con il nome del worker che hai annotato.
- Utilizza SSH per connetterti all'istanza con quel nome.
Esegui questo comando:
curl http://localhost:8081/threadz
Operazione in corso nel bundle
Quando esegui una pipeline che legge da JdbcIO, le letture partizionate da JdbcIO sono lente e nei file di log dei worker viene visualizzato il seguente messaggio:
Operation ongoing in bundle process_bundle-[0-9-]* for PTransform{id=Read from JDBC with Partitions\/JdbcIO.Read\/JdbcIO.ReadAll\/ParDo\(Read\)\/ParMultiDo\(Read\).*, state=process} for at least (0[1-9]h[0-5][0-9]m[0-5][0-9]s) without outputting or completing:
Per risolvere il problema, apporta una o più delle seguenti modifiche alla pipeline:
Utilizza le partizioni per aumentare il parallelismo dei job. Leggi con più partizioni di dimensioni inferiori per una scalabilità migliore.
Controlla se la colonna di partizionamento è una colonna di indice o una colonna di partizionamento effettiva nell'origine. Attiva l'indicizzazione e il partizionamento su questa colonna nel database di origine per ottenere le migliori prestazioni.
Utilizza i parametri
lowerBoundeupperBoundper evitare di trovare i limiti.
Errori relativi alla quota Pub/Sub
Quando esegui una pipeline di streaming da Pub/Sub, si verificano i seguenti errori:
429 (rateLimitExceeded)
Oppure:
Request was throttled due to user QPS limit being reached
Questi errori si verificano se il progetto non dispone di una quota Pub/Sub sufficiente.
Per scoprire se il tuo progetto non ha una quota sufficiente, segui questi passaggi per verificare la presenza di errori del client:
- Vai alla consoleGoogle Cloud .
- Nel menu a sinistra, seleziona API e servizi.
- Nella casella di ricerca, cerca Cloud Pub/Sub.
- Fai clic sulla scheda Utilizzo.
- Esamina i codici di risposta e cerca i codici di errore client
(4xx).
La richiesta è vietata dalla policy dell'organizzazione
Quando esegui una pipeline, si verifica il seguente errore:
Error trying to get gs://BUCKET_NAME/FOLDER/FILE:
{"code":403,"errors":[{"domain":"global","message":"Request is prohibited by organization's policy","reason":"forbidden"}],
"message":"Request is prohibited by organization's policy"}
Questo errore si verifica se il bucket Cloud Storage si trova al di fuori del perimetro di servizio.
Per risolvere il problema, crea una regola in uscita che consenta l'accesso al bucket al di fuori del perimetro di servizio.
Pacchetto in fase di gestione temporanea… non accessibile
I job che in precedenza venivano eseguiti correttamente potrebbero non riuscire con il seguente errore:
Staged package...is inaccessible
Per risolvere il problema:
- Verifica che il bucket Cloud Storage utilizzato per la gestione temporanea non abbia impostazioni TTL che causano l'eliminazione dei pacchetti temporanei.
Verifica che il account di servizio worker del tuo progetto Dataflow disponga dell'autorizzazione per accedere al bucket Cloud Storage utilizzato per la gestione temporanea. Le lacune nell'autorizzazione possono essere dovute a uno dei seguenti motivi:
- Il bucket Cloud Storage utilizzato per la gestione temporanea si trova in un progetto diverso.
- È stata eseguita la migrazione del bucket Cloud Storage utilizzato per la gestione temporanea dall'accesso granulare all'accesso uniforme a livello di bucket. A causa dell'incoerenza tra le policy IAM e ACL, la migrazione del bucket di gestione temporanea all'accesso uniforme a livello di bucket non consente gli ACL per le risorse Cloud Storage. Le ACL includono le autorizzazioni di cui dispone il account di servizio worker del tuo progetto Dataflow sul bucket di gestione temporanea.
Per saperne di più, consulta Accesso ai bucket Cloud Storage tra progettiGoogle Cloud.
Un elemento di lavoro ha generato un errore 4 volte
Il seguente errore si verifica quando un job batch non va a buon fine:
The job failed because a work item has failed 4 times.
Questo errore si verifica se una singola operazione in un job batch causa l'errore del codice del worker per quattro volte. Dataflow non riesce a eseguire il job e viene visualizzato questo messaggio.
In modalità flusso di dati, un bundle che include un elemento con errori viene ritentato all'infinito, il che potrebbe causare l'arresto definitivo della pipeline.
Non puoi configurare questa soglia di errore. Per maggiori dettagli, consulta la sezione sulla gestione di errori ed eccezioni della pipeline.
Per risolvere il problema, cerca nei log di Cloud Monitoring del job i quattro errori singoli. Nei log dei worker, cerca le voci di log di livello Errore o Errore irreversibile che mostrano eccezioni o errori. L'eccezione o l'errore deve essere visualizzato almeno quattro volte. Se i log contengono solo errori di timeout generici relativi all'accesso a risorse esterne, come MongoDB, verifica che il account di servizio worker disponga dell'autorizzazione per accedere alla subnet della risorsa.
Timeout nel file dei risultati del polling
Per informazioni complete sulla risoluzione di un errore "Timeout in polling result file", consulta Risolvi i problemi relativi ai template flessibili.
Scrittura del file corretto/Scrittura/WriteImpl/PreFinalize non riuscita
Durante l'esecuzione di un job, questo non va a buon fine in modo intermittente e si verifica il seguente errore:
Workflow failed. Causes: S27:Write Correct File/Write/WriteImpl/PreFinalize failed., Internal Issue (ID): ID:ID, Unable to expand file pattern gs://BUCKET_NAME/temp/FILE
Questo errore si verifica quando la stessa sottocartella viene utilizzata come posizione di archiviazione temporanea per più job eseguiti contemporaneamente.
Per risolvere il problema, non utilizzare la stessa sottocartella come località di archiviazione temporanea per più pipeline. Per ogni pipeline, fornisci una sottocartella univoca da utilizzare come posizione di archiviazione temporanea.
L'elemento supera le dimensioni massime del messaggio protobuf
Quando esegui job Dataflow e la pipeline contiene elementi di grandi dimensioni, potresti visualizzare errori simili ai seguenti esempi:
Exception serializing message!
ValueError: Message org.apache.beam.model.fn_execution.v1.Elements exceeds maximum protobuf size of 2GB
Oppure:
Buffer size ... exceeds GRPC limit 2147483548. This is likely due to a single element that is too large.
Oppure:
Output element size exceeds the allowed limit. (... > 83886080) See https://cloud.google.com/dataflow/quotas#limits for more details.
Potresti anche visualizzare un avviso simile al seguente esempio:
Data output stream buffer size ... exceeds 536870912 bytes. This is likely due to a large element in a PCollection.
Questi errori si verificano quando la pipeline contiene elementi di grandi dimensioni.
Per risolvere il problema, se utilizzi l'SDK Python, esegui l'upgrade ad Apache Beam versione 2.57.0 o successive. Le versioni 2.57.0 e successive dell'SDK Python migliorano l'elaborazione di elementi di grandi dimensioni e aggiungono il logging pertinente.
Se gli errori persistono dopo l'upgrade o se non utilizzi l'SDK Python, identifica il passaggio del job in cui si verifica l'errore e prova a ridurre le dimensioni degli elementi in quel passaggio.
Quando gli oggetti PCollection nella pipeline hanno elementi di grandi dimensioni, i requisiti di RAM per la pipeline aumentano. Gli elementi di grandi dimensioni possono anche causare errori di runtime, soprattutto quando superano i confini delle fasi fuse.
Gli elementi di grandi dimensioni possono verificarsi quando una pipeline materializza inavvertitamente un iterabile di grandi dimensioni. Ad esempio, una pipeline che passa l'output di un'operazione GroupByKey a un'operazione Reshuffle non necessaria materializza gli elenchi come singoli elementi. Questi elenchi contengono potenzialmente un numero elevato di valori per ogni chiave.
Se l'errore si verifica in un passaggio che utilizza un input laterale, tieni presente che l'utilizzo di input laterali può introdurre una barriera di fusione. Controlla se la trasformazione che produce un elemento di grandi dimensioni e quella che lo consuma appartengono alla stessa fase.
Quando crei la pipeline, segui queste best practice:
- In
PCollectionsutilizza più elementi di piccole dimensioni anziché un unico elemento di grandi dimensioni. - Archivia blob di grandi dimensioni in sistemi di archiviazione esterni. Utilizza
PCollectionsper passare i metadati o utilizza un programmatore personalizzato che riduca le dimensioni dell'elemento. - Se devi passare una PCollection che può superare i 2 GB come input secondario, utilizza
viste iterabili, come
AsIterableeAsMultiMap.
La dimensione massima di un singolo elemento in un job Dataflow è limitata a 2 GB (o 80 MB per Streaming Engine). Per saperne di più, consulta Quote e limiti.
Dataflow non è in grado di elaborare le trasformazioni gestite…
Le pipeline che utilizzano I/O gestito potrebbero non riuscire con questo errore se Dataflow non riesce a eseguire l'upgrade automatico delle trasformazioni di I/O alla versione supportata più recente. L'URN e i nomi dei passaggi forniti nell'errore devono specificare esattamente di quali trasformazioni Dataflow non è riuscito a eseguire l'upgrade.
Potresti trovare ulteriori dettagli su questo errore in Esplora log nei nomi dei log di Dataflow managed-transforms-worker e managed-transforms-worker-startup.
Se Esplora log non fornisce informazioni adeguate per risolvere l'errore, contatta l'assistenza clienti Google Cloud.
Errori dei job di archiviazione
Le sezioni seguenti contengono gli errori comuni che potresti riscontrare quando provi ad archiviare un job Dataflow utilizzando l'API.
Nessun valore fornito
Quando provi ad archiviare un job Dataflow utilizzando l'API, potrebbe verificarsi il seguente errore:
The field mask specifies an update for the field job_metadata.user_display_properties.archived in job JOB_ID, but no value is provided. To update a field, please provide a field for the respective value.
Questo errore si verifica per uno dei seguenti motivi:
Il percorso specificato per il campo
updateMasknon segue il formato corretto. Questo problema può verificarsi a causa di errori di battitura.Il valore
JobMetadatanon è specificato correttamente. Nel campoJobMetadata, peruserDisplayProperties, utilizza la coppia chiave-valore"archived":"true".
Per risolvere questo errore, verifica che il comando che passi all'API corrisponda al formato richiesto. Per maggiori dettagli, consulta Archivia un job.
L'API non riconosce il valore
Quando provi ad archiviare un job Dataflow utilizzando l'API, potrebbe verificarsi il seguente errore:
The API does not recognize the value VALUE for the field job_metadata.user_display_properties.archived for job JOB_ID. REASON: Archived display property can only be set to 'true' or 'false'
Questo errore si verifica quando il valore fornito nella coppia chiave-valore dei job di archiviazione non è un valore supportato. I valori supportati per la coppia chiave-valore dei job di archiviazione sono "archived":"true" e "archived":"false".
Per risolvere questo errore, verifica che il comando che passi all'API corrisponda al formato richiesto. Per maggiori dettagli, consulta Archivia un job.
Impossibile aggiornare sia lo stato che la maschera
Quando provi ad archiviare un job Dataflow utilizzando l'API, potrebbe verificarsi il seguente errore:
Cannot update both state and mask.
Questo errore si verifica quando provi ad aggiornare sia lo stato del job sia lo stato di archiviazione nella stessa chiamata API. Non puoi aggiornare sia lo stato del job sia il parametro di query updateMask nella stessa chiamata API.
Per risolvere questo errore, aggiorna lo stato del job in una chiamata API separata. Apporta aggiornamenti allo stato del job prima di aggiornare lo stato di archiviazione del job.
Modifica del workflow non riuscita
Quando provi ad archiviare un job Dataflow utilizzando l'API, potrebbe verificarsi il seguente errore:
Workflow modification failed.
Questo errore si verifica in genere quando provi ad archiviare un job in esecuzione.
Per risolvere questo errore, attendi il completamento del job prima di archiviarlo. I job completati hanno uno dei seguenti stati del job:
JOB_STATE_CANCELLEDJOB_STATE_DRAINEDJOB_STATE_DONEJOB_STATE_FAILEDJOB_STATE_UPDATED
Per saperne di più, consulta Rileva il completamento dei job Dataflow.
Errori delle immagini container
Le sezioni seguenti contengono gli errori comuni che potresti riscontrare durante l'utilizzo di container personalizzati e i passaggi per risolverli o eseguire il relativo troubleshooting. In genere, gli errori sono preceduti dal seguente messaggio:
Unable to pull container image due to error: DETAILED_ERROR_MESSAGE
Autorizzazione "containeranalysis.occurrences.list" negata
Nei file di log viene visualizzato il seguente errore:
Error getting old patchz discovery occurrences: generic::permission_denied: permission "containeranalysis.occurrences.list" denied for project "PROJECT_ID", entity ID "" [region="REGION" projectNum=PROJECT_NUMBER projectID="PROJECT_ID"]
L'API Container Analysis non è abilitata. In alcuni casi, l'API Container Analysis è necessaria per l'analisi delle vulnerabilità.
tramite Google Cloud CLI o tramite l'API Compute Engine.
Per saperne di più, consulta la panoramica dell'analisi del sistema operativo e Configurazione del controllo degli accessi nella documentazione di Artifact Analysis.
Errore di sincronizzazione del pod … "StartContainer" non riuscito
Durante l'avvio del worker si verifica il seguente errore:
Error syncing pod POD_ID, skipping: [failed to "StartContainer" for CONTAINER_NAME with CrashLoopBackOff: "back-off 5m0s restarting failed container=CONTAINER_NAME pod=POD_NAME].
Un pod è un gruppo di container Docker collocati nella stessa posizione ed eseguiti su un worker Dataflow. Questo errore si verifica quando uno dei container Docker nel pod non si avvia. Se l'errore non è recuperabile, il worker Dataflow non può avviarsi e i job batch Dataflow alla fine non vanno a buon fine con errori come i seguenti:
The Dataflow job appears to be stuck because no worker activity has been seen in the last 1h.
Questo errore si verifica in genere quando uno dei container si arresta in modo anomalo continuamente durante l'avvio.
Per comprendere la causa principale, cerca i log acquisiti immediatamente prima dell'errore. Per analizzare i log, utilizza Esplora log. In Esplora log, limita i file di log alle voci di log emesse dal worker con errori di avvio del container. Per limitare le voci di log, completa i seguenti passaggi:
- In Esplora log, individua la voce di log
Error syncing pod. - Per visualizzare le etichette associate alla voce di log, espandi la voce di log.
- Fai clic sull'etichetta associata a
resource_name, quindi su Mostra voci corrispondenti.
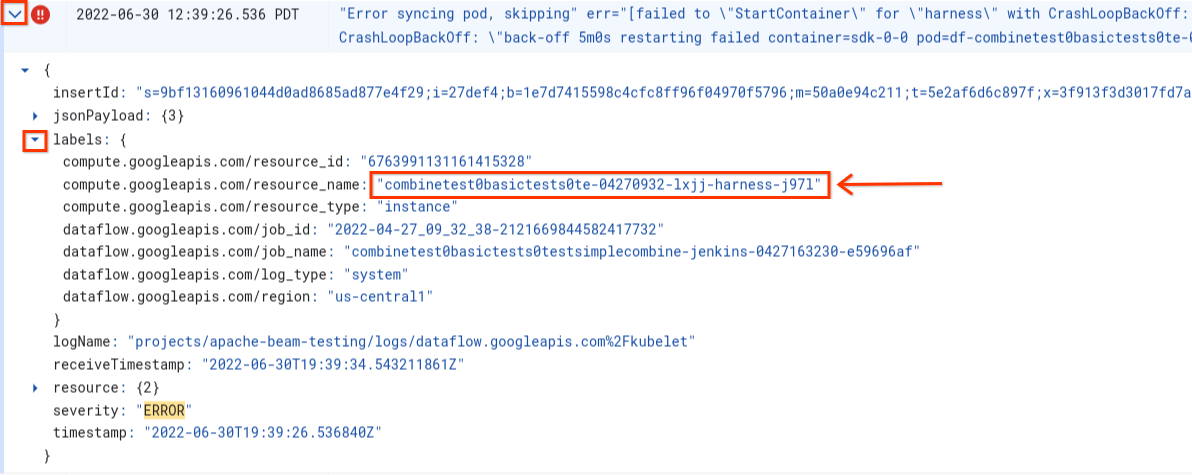
In Esplora log, i log di Dataflow sono organizzati in diversi flussi di log. Il messaggio Error syncing pod viene emesso nel log denominato kubelet. Tuttavia, i log del container con errori potrebbero trovarsi in un flusso di log diverso. Ogni container ha un nome. Utilizza la tabella seguente per determinare quale stream di log potrebbe contenere log pertinenti al container con errori.
| Nome container | Nomi log |
|---|---|
| sdk, sdk0, sdk1, sdk-0-0 e simili | docker |
| harness | harness, harness-startup |
| python, java-batch, java-streaming | worker-startup, worker |
| artefatto | artefatto |
Quando esegui una query su Esplora log, assicurati che la query includa i nomi dei log pertinenti nell'interfaccia di Query Builder o che non abbia limitazioni sul nome del log.
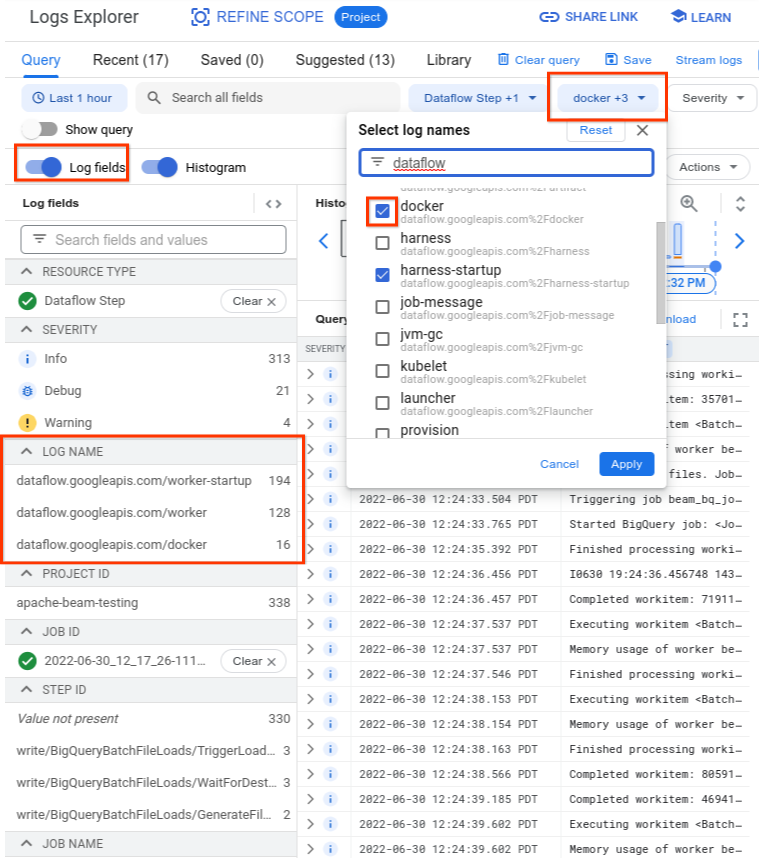
Dopo aver selezionato i log pertinenti, il risultato della query potrebbe essere simile al seguente esempio:
resource.type="dataflow_step"
resource.labels.job_id="2022-06-29_08_02_54-JOB_ID"
labels."compute.googleapis.com/resource_name"="testpipeline-jenkins-0629-DATE-cyhg-harness-8crw"
logName=("projects/apache-beam-testing/logs/dataflow.googleapis.com%2Fdocker"
OR
"projects/apache-beam-testing/logs/dataflow.googleapis.com%2Fworker-startup"
OR
"projects/apache-beam-testing/logs/dataflow.googleapis.com%2Fworker")
Poiché i log che segnalano il sintomo dell'errore del container a volte vengono segnalati come INFO, includi i log INFO nella tua analisi.
Le cause tipiche degli errori dei container includono:
- La pipeline Python ha dipendenze aggiuntive installate al runtime e l'installazione non è riuscita. Potresti visualizzare errori come
pip install failed with error. Questo problema potrebbe verificarsi a causa di requisiti in conflitto o di una configurazione di rete limitata che impedisce a un worker Dataflow di estrarre una dipendenza esterna da un repository pubblico su internet. Un worker non riesce a completare l'esecuzione della pipeline a causa di un errore di out of memory. Potresti visualizzare un errore simile a uno dei seguenti:
java.lang.OutOfMemoryError: Java heap spaceShutting down JVM after 8 consecutive periods of measured GC thrashing. Memory is used/total/max = 24453/42043/42043 MB, GC last/max = 58.97/99.89 %, #pushbacks=82, gc thrashing=true. Heap dump not written.
Per eseguire il debug di un problema di memoria esaurita, consulta Risolvi gli errori di memoria esaurita di Dataflow.
Dataflow non riesce a eseguire il pull dell'immagine container. Per saperne di più, consulta Richiesta di pull dell'immagine non riuscita con errore.
Il container utilizzato non è compatibile con l'architettura della CPU della VM worker. Nei log di avvio dell'harness, potresti visualizzare un errore simile al seguente:
exec
/opt/apache/beam/boot: exec format error
. Per controllare l'architettura dell'immagine container, eseguidocker image inspect $IMAGE:$TAGe cerca la parola chiaveArchitecture. Se viene visualizzatoError: No such image: $IMAGE:$TAG, potresti dover prima eseguire il pull dell'immagine eseguendodocker pull $IMAGE:$TAG. Per informazioni sulla creazione di immagini multi-architettura, consulta Crea un'immagine container multi-architettura.
Dopo aver identificato l'errore che causa l'errore del container, prova a risolverlo, quindi invia nuovamente la pipeline.
Lancio del template non riuscito con errore
Durante l'avvio del template flessibile, nei log dei job viene visualizzato il seguente errore:
Error: Template launch failed: exit status 13
Error occurred in the launcher container: Template launch failed. See console logs.
I log dei worker contengono un'analisi dello stack simile ai seguenti log di traccia:
TypeError: canonicalize_version() got an unexpected keyword argument 'strip_trailing_zero'
ERROR:absl:Internal Error Type : RuntimeError
ERROR:absl:Error Message : Full trace: Traceback (most recent call last):
File "/usr/local/lib/python3.9/site-packages/apache_beam/utils/processes.py", line 89, in check_output
out = subprocess.check_output(*args, **kwargs)
IFile "/usr/local/lib/python3.9/subprocess.py", line 424, in check_output
return run(*popenargs, stdout=PIPE, timeout=timeout, check=True,
File "/usr/local/lib/python3.9/subprocess.py", line 528, in run
raise CalledProcessError(retcode, process.args,
subprocess.CalledProcessError: Command '['/usr/local/bin/python', 'setup.py', 'sdist', '--dist-dir', '/tmp/tmp196n6g8d']' returned non-zero exit status 1.
Questi errori si verificano se un launcher di modelli trova dipendenze in conflitto durante la configurazione, in particolare quando il pacchetto setuptools viene aggiornato a una versione superiore o uguale a 71.0. Esamina le dipendenze della pipeline e assicurati che la dipendenza del pacchetto sia superiore o uguale a 25.0.
Richiesta di pull dell'immagine non riuscita con errore
Durante l'avvio del worker, nei log del worker o del job viene visualizzato uno dei seguenti errori:
Image pull request failed with error
pull access denied for IMAGE_NAME
manifest for IMAGE_NAME not found: manifest unknown: Failed to fetch
Get IMAGE_NAME: Service Unavailable
Questi errori si verificano se un worker non riesce ad avviarsi perché non può eseguire il pull di un'immagine container Docker. Questo problema si verifica nei seguenti scenari:
- L'URL dell'immagine container dell'SDK personalizzato non è corretto
- Il worker non dispone delle credenziali o dell'accesso di rete all'immagine remota
Per risolvere il problema:
- Se utilizzi un'immagine container personalizzata con il job, verifica che l'URL dell'immagine sia corretto e che abbia un tag o un digest valido. Anche i worker Dataflow devono avere accesso all'immagine.
- Verifica che le immagini pubbliche possano essere scaricate localmente eseguendo
docker pull
$image
da una macchina non autenticata.
Per immagini private o worker privati:
- Se utilizzi Container Registry per ospitare l'immagine container, ti consigliamo di utilizzare Artifact Registry. A partire dal 15 maggio 2023, Container Registry è deprecato. Se utilizzi Container Registry, puoi eseguire la transizione ad Artifact Registry. Se le tue immagini si trovano in un progetto diverso da quello utilizzato per eseguire il jobGoogle Cloud , configura il controllo degli accessi per il service accountGoogle Cloud predefinito.
- Se utilizzi un Virtual Private Cloud (VPC) condiviso, assicurati che i worker possano accedere all'host del repository di container personalizzati.
- Utilizza
sshper connetterti a una VM worker di un job in esecuzione ed eseguidocker pull $imageper verificare direttamente che il worker sia configurato correttamente.
Se i worker non riescono più volte di seguito a causa di questo errore e il lavoro su un job è iniziato, il job può non riuscire con un errore simile al seguente messaggio:
Job appears to be stuck.
Se rimuovi l'accesso all'immagine mentre il job è in esecuzione, rimuovendo l'immagine stessa o revocando le credenziali dell'account del service account del worker Dataflow o l'accesso a internet per accedere alle immagini, Dataflow registra solo gli errori. Dataflow non genera un errore del job. Dataflow evita inoltre di interrompere le pipeline di streaming a lunga esecuzione per evitare di perdere lo stato della pipeline.
Altri possibili errori possono derivare da problemi di quota del repository o da interruzioni del servizio. Se riscontri problemi di superamento della quota di Docker Hub per il pull di immagini pubbliche o interruzioni generali del repository di terze parti, valuta la possibilità di utilizzare Artifact Registry come repository di immagini.
SystemError: unknown opcode
La pipeline del container personalizzato Python potrebbe non riuscire con il seguente errore subito dopo l'invio del job:
SystemError: unknown opcode
Inoltre, l'analisi dello stack potrebbe includere
apache_beam/internal/pickler.py
Per risolvere il problema, verifica che la versione di Python che utilizzi localmente corrisponda alla versione nell'immagine container fino alla versione principale e secondaria. La differenza nella versione della patch, ad esempio 3.6.7 rispetto a 3.6.8, non crea problemi di compatibilità. La differenza nella versione secondaria, ad esempio 3.6.8 rispetto a 3.8.2, può causare errori della pipeline.
Errori di upgrade della pipeline di streaming
Per informazioni su come risolvere gli errori durante l'upgrade di una pipeline di streaming utilizzando funzionalità come l'esecuzione di un job di sostituzione parallelo, consulta Risolvi i problemi relativi agli upgrade della pipeline di streaming.
Aggiornamento dell'harness di Portable Runner
Il seguente messaggio informativo viene visualizzato nei log dei job di un job Portable Runner
The Dataflow Portable Runner container image of this job's workers will be ready for update in 7 days.
Ciò significa che la versione del processo runner harness verrà aggiornata automaticamente a un certo punto 7 giorni dopo l'invio iniziale del messaggio, con una breve pausa nell'elaborazione. Se vuoi controllare quando si verifica questa pausa, consulta Aggiorna una pipeline esistente per avviare un job di sostituzione che avrà la versione più recente del runner harness.
Errori dei worker
Le sezioni seguenti contengono gli errori comuni dei worker che potresti riscontrare e i passaggi per risolverli o eseguire la risoluzione dei problemi.
La chiamata dall'harness del worker Java a DoFn Python non riesce con un errore
Se una chiamata dall'agente worker Java a un DoFn Python non va a buon fine, viene visualizzato un messaggio di errore pertinente.
Per esaminare l'errore, espandi la voce di log degli errori di Cloud Monitoring e osserva il messaggio di errore e il traceback. Mostra quale codice non è riuscito, in modo da poterlo correggere, se necessario. Se ritieni che l'errore sia un bug in Apache Beam o Dataflow, segnala il bug.
EOFError: marshal data too short
Nei log del worker viene visualizzato il seguente errore:
EOFError: marshal data too short
Questo errore a volte si verifica quando i worker della pipeline Python esauriscono lo spazio su disco.
Per risolvere il problema, consulta Spazio esaurito sul dispositivo.
Impossibile collegare il disco
Quando provi ad avviare un job Dataflow che utilizza VM C3 con Persistent Disk, il job non riesce con uno o entrambi i seguenti errori:
Failed to attach disk(s), status: generic::invalid_argument: One or more operations had an error
Can not allocate sha384 (reason: -2), Spectre V2 : WARNING: Unprivileged eBPF is enabled with eIBRS on...
Questi errori si verificano quando utilizzi VM C3 con un tipo di Persistent Disk non supportato. Per maggiori informazioni, consulta Tipi di dischi supportati per C3.
Per utilizzare le VM C3 con il job Dataflow, scegli il tipo di disco worker pd-ssd. Per saperne di più, consulta Opzioni a livello di worker.
Java
--workerDiskType=pd-ssd
Python
--worker_disk_type=pd-ssd
Vai
disk_type=pd-ssd
No space left on device
Quando un job esaurisce lo spazio su disco, nei log dei worker potrebbe essere visualizzato il seguente errore:
No space left on device
Questo errore può verificarsi per uno dei seguenti motivi:
- Lo spazio di archiviazione permanente dei worker si esaurisce, il che può verificarsi per uno dei seguenti motivi:
- Un job scarica dipendenze di grandi dimensioni in fase di runtime
- Un job utilizza container personalizzati di grandi dimensioni
- Un job scrive molti dati temporanei sul disco locale
- Quando utilizzi Dataflow Shuffle, Dataflow imposta una dimensione del disco predefinita inferiore. Di conseguenza, questo errore potrebbe verificarsi con i job che passano dallo shuffling basato sui worker.
- Il disco di avvio del worker si riempie perché registra più di 50 voci al secondo.
Per risolvere il problema, segui questi passaggi per la risoluzione dei problemi:
Per visualizzare le risorse disco associate a un singolo worker, consulta i dettagli dell'istanza VM per le VM worker associate al tuo job. Parte dello spazio su disco è occupato dal sistema operativo, dai file binari, dai log e dai container.
Per aumentare lo spazio su disco permanente o su disco di avvio, regola l'opzione della pipeline per le dimensioni del disco.
Monitora l'utilizzo dello spazio su disco sulle istanze VM worker utilizzando Cloud Monitoring. Per istruzioni su come configurare questa opzione, consulta Ricevi le metriche delle VM worker dall'agente Monitoring.
Cerca problemi di spazio su disco di avvio visualizzando l'output della porta seriale sulle istanze VM worker e cercando messaggi come:
Failed to open system journal: No space left on device
Se hai molte istanze VM worker, puoi creare uno script per eseguire gcloud
compute instances get-serial-port-output su tutte contemporaneamente. In alternativa, puoi esaminare l'output.
La pipeline Python non va a buon fine dopo un'ora di inattività del worker
Quando utilizzi l'SDK Apache Beam per Python con Dataflow Portable Runner su macchine worker con molti core della CPU, utilizza l'SDK Apache Beam 2.35.0 o versioni successive. Se il job utilizza un container personalizzato, utilizza l'SDK Apache Beam 2.46.0 o versioni successive.
Valuta la possibilità di pre-creare il container Python. Questo passaggio può migliorare i tempi di avvio delle VM e le prestazioni della scalabilità automatica orizzontale. Per utilizzare questa funzionalità, abilita l'API Cloud Build nel tuo progetto e invia la pipeline con il seguente parametro:
‑‑prebuild_sdk_container_engine=cloud_build.
Per saperne di più, consulta Dataflow Portable Runner.
Puoi anche utilizzare un'immagine container personalizzata con tutte le dipendenze preinstallate.
RESOURCE_POOL_EXHAUSTED o IP_SPACE_EXHAUSTED_WITH_DETAILS
Quando crei una risorsa Google Cloud , potrebbe verificarsi uno dei seguenti errori di creazione del pool di worker.
Il nome della VM INSTANCE_NAME rappresenta il nome della VM worker. Le VM worker sono istanze Compute Engine completamente gestite che eseguono le attività della pipeline di trattamento dati.
ZONE_RESOURCE_POOL_EXHAUSTED_WITH_DETAILS
Startup of the worker pool in zone ZONE_NAME failed to bring up any of the desired NUMBER workers. ZONE_RESOURCE_POOL_EXHAUSTED_WITH_DETAILS: Instance 'INSTANCE_NAME' creation failed: The zone 'projects/PROJECT_ID/zones/ZONE_NAME' does not have enough resources available to fulfill the request. '(resource type:RESOURCE_TYPE)'.
Questo errore si verifica a causa di una temporanea mancanza di disponibilità del tipo di VM worker richiesto. Per impostazione predefinita, Dataflow seleziona il tipo di macchina per le VM worker che eseguono il job, insieme alle dimensioni e al tipo di Persistent Disk.
Per risolvere il problema, utilizza una delle seguenti strategie:
- Aggiorna la VM worker impostando un tipo di macchina diverso e riprova a eseguire il job.
- Avvia il job Dataflow da un'altra regione.
Attiva la selezione automatica delle VM utilizzando i suggerimenti per le risorse
min_ramocpu_count. Con la selezione automatica delle VM, viene eseguito il provisioning dei worker da un elenco selezionato di tipi di macchine che soddisfano i tuoi requisiti di RAM e CPU, il che può aiutare a prevenire problemi di esaurimento del pool di risorse.Nota: quando la selezione automatica delle VM è attivata, qualsiasi tipo di macchina specificato nelle opzioni della pipeline viene ignorato.
Per creare la gestione degli errori per questo tipo di scenario, puoi anche creare un loop di nuovi tentativi per i tuoi job. Se si verifica un errore di esaurimento delle risorse, il job riprova automaticamente finché le risorse non sono disponibili. Per creare un ciclo di nuovi tentativi, segui questo flusso di lavoro:
- Crea un job Dataflow e ottieni l'ID job.
- Esegui il polling dello stato del job finché non è
RUNNINGoFAILED.- Se lo stato del job è
RUNNING, esci dal ciclo di nuovi tentativi. - Se lo stato del job è
FAILED, utilizza l'API Cloud Logging per eseguire query sui log del job per la stringaZONE_RESOURCE_POOL_EXHAUSTED_WITH_DETAILS. Per saperne di più, consulta Utilizza i log della pipeline.- Se i log non contengono la stringa, esci dal ciclo di nuovi tentativi.
- Se i log contengono la stringa, crea un job Dataflow, recupera l'ID job e riavvia il ciclo di nuovi tentativi.
- Se lo stato del job è
Infine, valuta la possibilità di adottare la best practice di distribuire le risorse in più zone e regioni per tollerare le interruzioni.
IP_SPACE_EXHAUSTED_WITH_DETAILS
Startup of the worker pool in REGION_NAME failed to bring up any of the desired NUMBER workers. ... IP_SPACE_EXHAUSTED_WITH_DETAILS: Instance 'INSTANCE_NAME' creation failed: IP space of 'projects/PROJECT_ID/regions/REGION_NAME/subnetworks/SUBNETWORK_NAME' is exhausted. Insufficient free IP addresses in the IP range 'IP_RANGE'. Consider expanding the current IP range or selecting an alternative IP range. If this is a secondary range, consider adding an additional secondary range.
Questo errore si verifica quando la subnet assegnata al job Dataflow non dispone di indirizzi IP liberi sufficienti per eseguire il provisioning del numero richiesto di VM worker.
Per risolvere il problema, utilizza una delle seguenti strategie:
- Espandi l'intervallo IP principale della subnet.
- Se utilizzi un intervallo secondario, aggiungi un altro intervallo secondario.
- Seleziona una subnet o un intervallo IP alternativo con un numero sufficiente di indirizzi IP disponibili.
Errori di dipendenza di runtime
Quando esegui un job Dataflow che utilizza l'SDK Apache Beam per Python con trasformazioni multilingue, il job potrebbe non riuscire con un errore HTTP Error
403: Forbidden durante il download dei file JAR da Maven Central.
Questo problema è causato da una modifica nel provider CDN di Maven Central, che blocca le richieste dalla libreria Python urllib utilizzata dall'SDK Apache Beam.
Per risolvere il problema, esegui l'upgrade ad Apache Beam versione 2.69.0 o successive. Se non puoi eseguire l'upgrade, consulta le soluzioni alternative in questa sezione.
Correzioni in Apache Beam 2.69.0 e versioni successive
Apache Beam 2.69.0 e versioni successive includono le seguenti correzioni:
URL repository Maven personalizzato: puoi specificare un repository Maven personalizzato utilizzando l'opzione della pipeline
--maven_repository_url. Ad esempio:--maven_repository_url https://maven-central.storage-download.googleapis.com/maven2/Identificazione dello user agent: l'SDK Apache Beam invia un'intestazione
User-Agentspecifica per impedire il blocco delle richieste.
Soluzioni alternative per gli SDK meno recenti
Se non puoi eseguire l'upgrade ad Apache Beam 2.69.0 o versioni successive, utilizza una delle seguenti soluzioni alternative:
- Pre-pacchettizza i JAR in un container personalizzato (consigliato): pre-pacchettizza i file JAR richiesti nell'immagine container personalizzata. Inserisci i file JAR nella directory della cache di Apache Beam (
/root/.apache_beam/cache/jars/) per impedire all'SDK di scaricarli in fase di runtime. Utilizza il mirror Maven di Google: utilizza l'opzione della pipeline
--expansion_serviceper indicare all'SDK Apache Beam di scaricare i JAR necessari dal mirror di Google di Maven Central. Ad esempio:--expansion_service https://maven-central.storage-download.googleapis.com/maven2/org/apache/beam/beam-sdks-java-extensions-schemaio-expansion-service/BEAM_VERSION/beam-sdks-java-extensions-schemaio-expansion-service-BEAM_VERSION.jarEsegui lo stage dei JAR in Cloud Storage: scarica i JAR richiesti, eseguine lo stage in un bucket Cloud Storage, quindi fornisci il percorso Cloud Storage del JAR all'opzione della pipeline
--expansion_service.
Le istanze con acceleratori guest non supportano la migrazione live
Una pipeline Dataflow non riesce durante l'invio del job con il seguente errore:
UNSUPPORTED_OPERATION: Instance <worker_instance_name> creation failed:
Instances with guest accelerators do not support live migration
Questo errore potrebbe verificarsi se hai richiesto un tipo di macchina worker con acceleratori hardware, ma non hai configurato Dataflow per l'utilizzo degli acceleratori.
Utilizza l'opzione di servizio --worker_accelerator Dataflow o il suggerimento per le risorse accelerator per richiedere acceleratori hardware.
Se utilizzi i template flessibili, puoi utilizzare l'opzione --additionalExperiments per fornire le opzioni del servizio Dataflow. Se l'operazione viene eseguita correttamente, l'opzione worker_accelerator si trova nel riquadro Informazioni job del job nella consoleGoogle Cloud .
Quota del progetto… o policy di controllo dell'accesso che impediscono l'operazione
Si verifica il seguente errore:
Startup of the worker pool in zone ZONE_NAME failed to bring up any of the desired NUMBER workers. The project quota may have been exceeded or access control policies may be preventing the operation; review the Cloud Logging 'VM Instance' log for diagnostics.
Questo errore si verifica per uno dei seguenti motivi:
- Hai superato una delle quote di Compute Engine su cui si basa la creazione dei worker Dataflow.
- La tua organizzazione ha dei vincoli che vietano alcuni aspetti del processo di creazione delle istanze VM, ad esempio l'account utilizzato o la zona di destinazione.
Per risolvere il problema, segui questi passaggi per la risoluzione dei problemi:
Esamina il log dell'istanza VM
- Vai al visualizzatore log di Cloud Logging
- Nell'elenco a discesa Risorsa controllata, seleziona Istanza VM.
- Nell'elenco a discesa Tutti i log, seleziona compute.googleapis.com/activity_log.
- Analizza il log per individuare eventuali voci relative all'errore di creazione dell'istanza VM.
Controlla l'utilizzo delle quote di Compute Engine
Per visualizzare l'utilizzo delle risorse di Compute Engine rispetto alle quote di Dataflow per la zona che hai scelto come target, esegui questo comando:
gcloud compute regions describe [REGION]Esamina i risultati per le seguenti risorse per verificare se qualcuna supera la quota:
- CPU
- DISKS_TOTAL_GB
- IN_USE_ADDRESSES
- INSTANCE_GROUPS
- ISTANZE
- REGIONAL_INSTANCE_GROUP_MANAGERS
Se necessario, richiedi una modifica della quota.
Esamina i vincoli delle policy dell'organizzazione
- Vai alla pagina Policy dell'organizzazione
- Esamina i vincoli per individuare quelli che potrebbero limitare la creazione di istanze VM per l'account che stai utilizzando (per impostazione predefinita, il service account Dataflow) o nella zona che hai scelto come target.
- Se hai una policy che limita l'utilizzo di indirizzi IP esterni, disattiva gli indirizzi IP esterni per questo job. Per saperne di più sulla disattivazione degli indirizzi IP esterni, consulta Configura l'accesso a internet e le regole firewall.
Timeout durante l'attesa di un aggiornamento dal worker
Quando un job Dataflow non va a buon fine, si verifica il seguente errore:
Root cause: Timed out waiting for an update from the worker. For more information, see https://cloud.google.com/dataflow/docs/guides/common-errors#worker-lost-contact.
Questo errore può essere causato da diversi fattori, tra cui:
- Sovraccarico dei worker
- Holding the Global Interpreter Lock
- Configurazione di DoFn a lunga esecuzione
Sovraccarico dei worker
A volte, si verifica un errore di timeout quando il worker esaurisce la memoria o lo spazio di swap. Per risolvere il problema, come primo passaggio, prova a eseguire nuovamente il job. Se il job continua a non riuscire e si verifica lo stesso errore, prova a utilizzare un worker con più memoria e spazio su disco. Ad esempio, aggiungi la seguente opzione di avvio della pipeline:
--worker_machine_type=m1-ultramem-40 --disk_size_gb=500
La modifica del tipo di worker potrebbe influire sul costo fatturato. Per saperne di più, consulta Risolvi gli errori di memoria esaurita di Dataflow.
Questo errore può verificarsi anche quando i dati contengono una hot key. In questo scenario, l'utilizzo della CPU è elevato su alcuni worker per la maggior parte della durata del job. Tuttavia, il numero di worker non raggiunge il numero massimo consentito. Per ulteriori informazioni sulle hot key e sulle possibili soluzioni, consulta Scrittura di pipeline Dataflow con scalabilità in mente.
Per ulteriori soluzioni a questo problema, consulta È stata rilevata una hot key….
Python: Global Interpreter Lock (GIL)
Se il tuo codice Python chiama il codice C/C++ utilizzando il meccanismo di estensione Python, controlla se il codice dell'estensione rilascia il Global Interpreter Lock (GIL) di Python nelle parti di codice ad alta intensità di calcolo che non accedono allo stato di Python. Se il GIL non viene rilasciato per un periodo di tempo prolungato, potresti visualizzare messaggi di errore come: Unable to retrieve status info from SDK harness <...> within allowed time e SDK worker appears to be permanently unresponsive. Aborting the SDK.
Le librerie che facilitano le interazioni con estensioni come
Cython
e
PyBind
dispongono di primitive per controllare lo stato del GIL. Puoi anche rilasciare manualmente il GIL e
riacquisirlo prima di restituire il controllo all'interprete Python utilizzando le
macro Py_BEGIN_ALLOW_THREADS e Py_END_ALLOW_THREADS. Per saperne di più, consulta Thread State and the Global Interpreter Lock nella documentazione di Python.
Potrebbe essere possibile recuperare le analisi dello stack di un thread che contiene il GIL su un worker Dataflow in esecuzione come segue:
# SSH into a running Dataflow worker VM that is currently a straggler, for example:
gcloud compute ssh --zone "us-central1-a" "worker-that-emits-unable-to-retrieve-status-messages" --project "project-id"

# Install nerdctl to inspect a running container with ptrace privileges.
wget https://github.com/containerd/nerdctl/releases/download/v2.0.2/nerdctl-2.0.2-linux-amd64.tar.gz
sudo tar Cxzvvf /var/lib/toolbox  nerdctl-2.0.2-linux-amd64.tar.gz
alias nerdctl="sudo /var/lib/toolbox/nerdctl -n k8s.io"

# Find a container running the Python SDK harness.
CONTAINER_ID=`nerdctl ps | grep sdk-0-0 | awk '{print $1}'`

# Start a shell in the running container.
nerdctl exec --privileged -it $CONTAINER_ID /bin/bash

# Inspect python processes in the running container.
ps -A | grep python
PYTHON_PID=$(ps -A | grep python | head -1 | awk '{print $1}')

# Use pystack to retrieve stacktraces from the python process.
pip install pystack

pystack remote --native $PYTHON_PID

# Find which thread holds the GIL and inspect the stacktrace.
pystack remote --native $PYTHON_PID | grep -iF "Has the GIL" -A 100

# Alternately, use inspect with gdb.
apt update && apt install -y gdb
gdb --quiet \
  --eval-command="set pagination off" \
  --eval-command="thread apply all bt" \
  --eval-command "set confirm off" \
  --eval-command="quit"  -p $PYTHON_PID
Nelle pipeline Python, nella configurazione predefinita, Dataflow presuppone che ogni processo Python in esecuzione sui worker utilizzi in modo efficiente un core vCPU. Se il codice della pipeline bypassa le limitazioni del GIL, ad esempio utilizzando librerie implementate in C++, gli elementi di elaborazione potrebbero utilizzare risorse di più core vCPU e i worker potrebbero non ricevere risorse CPU sufficienti. Per risolvere il problema, riduci il numero di thread sui worker.
Configurazione di DoFn a lunga esecuzione
Se non utilizzi il runner portatile, una chiamata a lunga esecuzione a DoFn.Setup può
generare il seguente errore:
Timed out waiting for an update from the worker
In generale, evita operazioni che richiedono molto tempo all'interno di DoFn.Setup.
Errori temporanei durante la pubblicazione nell'argomento
Quando il job di flussi di dati utilizza la modalità di flussi di dati at-least-once e pubblica in un sink Pub/Sub, nei log del job viene visualizzato il seguente errore:
There were transient errors publishing to topic
Se il job viene eseguito correttamente, questo errore è innocuo e puoi ignorarlo. Dataflow riprova automaticamente a inviare i messaggi Pub/Sub con un ritardo di backoff.
Impossibile recuperare i dati a causa di una mancata corrispondenza del token per la chiave
Il seguente errore indica che l'elemento di lavoro in fase di elaborazione è stato riassegnato a un altro worker:
Unable to fetch data due to token mismatch for key
Questo accade più comunemente durante la scalabilità automatica, ma può verificarsi in qualsiasi momento. Qualsiasi lavoro interessato verrà ripetuto. Puoi ignorare questo errore.
Problemi di dipendenza Java
Classi e librerie incompatibili possono causare problemi di dipendenza Java. Quando la pipeline presenta problemi di dipendenza Java, potrebbe verificarsi uno dei seguenti errori:
NoClassDefFoundError: questo errore si verifica quando un'intera classe non è disponibile durante il runtime. Può essere causato da problemi di configurazione generale o da incompatibilità tra la versione protobuf di Beam e i proto generati da un client (ad esempio, questo problema).NoSuchMethodError: questo errore si verifica quando la classe nel percorso di classe utilizza una versione che non contiene il metodo corretto o quando la firma del metodo è cambiata.
NoSuchFieldError: questo errore si verifica quando la classe nel classpath utilizza una versione che non ha un campo obbligatorio durante il runtime.FATAL ERROR in native method: questo errore si verifica quando una dipendenza integrata non può essere caricata correttamente. Quando utilizzi un uber JAR (shaded), non includere nello stesso JAR librerie che utilizzano firme (come Conscrypt).
Se la pipeline contiene codice e impostazioni specifici per l'utente, il codice non può contenere versioni miste di librerie. Se utilizzi una libreria di gestione delle dipendenze, ti consigliamo di utilizzare la BOM delle librerieGoogle Cloud .
Se utilizzi l'SDK Apache Beam, per importare la distinta base (BOM) delle librerie corretta, utilizza beam-sdks-java-io-google-cloud-platform-bom:
Maven
<dependencyManagement>
  <dependencies>
    <dependency>
      <groupId>org.apache.beam</groupId>
      <artifactId>beam-sdks-java-google-cloud-platform-bom</artifactId>
      <version>BEAM_VERSION</version>
      <type>pom</type>
      <scope>import</scope>
    </dependency>
  </dependencies>
</dependencyManagement>
Gradle
dependencies {
    implementation(platform("org.apache.beam:beam-sdks-java-google-cloud-platform-bom:BEAM_VERSION"))
}
Per saperne di più, consulta Gestisci le dipendenze della pipeline in Dataflow.
InaccessibleObjectException in JDK 17 e versioni successive
Quando esegui pipeline con Java Platform, Standard Edition Development Kit (JDK) versioni 17 e successive, nei file di log dei worker potrebbe essere visualizzato il seguente errore:
Unable to make protected METHOD accessible:
    module java.MODULE does not "opens java.MODULE" to ...
Questo problema si verifica perché, a partire dalla versione 9 di Java, sono necessarie opzioni JVM (Java Virtual Machine) del modulo aperto per accedere agli elementi interni del JDK. In Java 16 e versioni successive, le opzioni JVM del modulo aperto sono sempre necessarie per accedere agli elementi interni del JDK.
Per risolvere il problema, quando passi i moduli alla pipeline Dataflow per aprirli, utilizza il formato MODULE/PACKAGE=TARGET_MODULE(,TARGET_MODULE)* con l'opzione della pipeline jdkAddOpenModules. Questo formato consente l'accesso alla libreria necessaria.
Ad esempio, se l'errore è module java.base does not "opens java.lang" to
unnamed module @..., includi la seguente opzione della pipeline quando esegui la pipeline:
--jdkAddOpenModules=java.base/java.lang=ALL-UNNAMED
Per saperne di più, consulta la documentazione della classe DataflowPipelineOptions.
Avanzamento del workitem di Error Reporting
Per le pipeline Java, se non utilizzi il runner portatile, potresti visualizzare il seguente errore:
Error reporting workitem progress update to Dataflow service: ...
Questo errore è causato da un'eccezione non gestita durante l'aggiornamento dello stato di avanzamento di un work item, ad esempio durante la suddivisione di un'origine. Nella maggior parte dei casi, se il codice utente di Apache Beam genera un'eccezione non gestita, l'elemento di lavoro non va a buon fine, causando l'errore della pipeline.Tuttavia, le eccezioni in Source.split vengono soppresse, perché quella parte del codice si trova al di fuori di un elemento di lavoro. Di conseguenza, viene registrato solo un log degli errori.
Questo errore di solito è innocuo se si verifica solo a intermittenza. Tuttavia, ti consigliamo di gestire correttamente le eccezioni all'interno del codice Source.split.
Errori del connettore BigQuery
Le sezioni seguenti contengono gli errori comuni del connettore BigQuery che potresti riscontrare e i passaggi per risolverli o eseguire il relativo troubleshooting.
quotaExceeded
Quando utilizzi il connettore BigQuery per scrivere in BigQuery utilizzando gli inserimenti di flussi di dati, la velocità effettiva di scrittura è inferiore al previsto e potrebbe verificarsi il seguente errore:
quotaExceeded
La lentezza del throughput potrebbe essere dovuta al fatto che la pipeline supera la quota di inserimento di flussi di dati BigQuery disponibile. In questo caso, i messaggi di errore relativi alla quota di BigQuery vengono visualizzati nei log dei worker Dataflow (cerca gli errori quotaExceeded).
Se visualizzi errori quotaExceeded, per risolvere il problema:
- Quando utilizzi l'SDK Apache Beam per Java, imposta l'opzione sink BigQuery
ignoreInsertIds(). - Quando utilizzi l'SDK Apache Beam per Python, utilizza l'opzione
ignore_insert_ids.
Queste impostazioni ti consentono di usufruire di una velocità effettiva di inserimento di flussi di dati BigQuery di 1 GB al secondo per progetto. Per saperne di più sulle limitazioni relative alla deduplicazione automatica dei messaggi, consulta la documentazione di BigQuery. Per aumentare la quota di inserimento di flussi di dati di BigQuery oltre 1 GBps, invia una richiesta tramite la consoleGoogle Cloud .
Se non vedi errori relativi alla quota nei log dei worker, il problema potrebbe essere che i parametri predefiniti relativi al raggruppamento o al batching non forniscono un parallelismo adeguato per la scalabilità della pipeline. Puoi modificare diverse configurazioni relative al connettore BigQuery di Dataflow per ottenere le prestazioni previste durante la scrittura in BigQuery utilizzando gli inserimenti di flussi di dati. Ad esempio, per l'SDK Apache Beam per Java, regola numStreamingKeys in modo che corrisponda al numero massimo di worker e valuta la possibilità di aumentare insertBundleParallelism per configurare il connettore BigQuery in modo che scriva in BigQuery utilizzando più thread paralleli.
Per le configurazioni disponibili nell'SDK Apache Beam per Java, consulta BigQueryPipelineOptions, mentre per le configurazioni disponibili nell'SDK Apache Beam per Python, consulta la trasformazione WriteToBigQuery.
rateLimitExceeded
Quando utilizzi il connettore BigQuery, si verifica il seguente errore:
rateLimitExceeded
Questo errore si verifica se vengono inviate troppe richieste API BigQuery in un breve periodo di tempo. BigQuery ha limiti di quota a breve termine. È possibile che la pipeline Dataflow superi temporaneamente questa quota. In questo scenario, le richieste API dalla pipeline Dataflow a BigQuery potrebbero non riuscire, il che potrebbe causare errori rateLimitExceeded nei log dei worker.
Dataflow riprova a eseguire queste operazioni, quindi puoi ignorare questi errori. Se ritieni che la tua pipeline sia interessata da errori rateLimitExceeded, contatta l'assistenza clienti Google Cloud.
Errori vari
Le sezioni seguenti contengono vari errori che potresti riscontrare e i passaggi per risolverli o individuarne la causa.
Impossibile allocare sha384
Il job viene eseguito correttamente, ma nei log del job viene visualizzato il seguente errore:
ima: Can not allocate sha384 (reason: -2)
Se il job viene eseguito correttamente, questo errore è innocuo e puoi ignorarlo. Le immagini di base delle VM worker a volte generano questo messaggio. Dataflow risponde e risolve automaticamente il problema sottostante.
Esiste una richiesta di funzionalità per modificare il livello di questo messaggio da WARN a INFO. Per saperne di più, consulta Riduzione del livello di log degli errori di avvio del sistema Dataflow a WARN o INFO.
Errore durante l'inizializzazione del probe del plug-in dinamico
Il job viene eseguito correttamente, ma nei log del job viene visualizzato il seguente errore:
Error initializing dynamic plugin prober" err="error (re-)creating driver directory: mkdir /usr/libexec/kubernetes: read-only file system
Se il job viene eseguito correttamente, questo errore è innocuo e puoi ignorarlo. Questo errore si verifica quando il job Dataflow tenta di creare una directory senza le autorizzazioni in scrittura necessarie e l'attività non riesce. Se il job ha esito positivo, la directory non era necessaria o Dataflow ha risolto il problema sottostante.
Esiste una richiesta di funzionalità per modificare il livello di questo messaggio da WARN a INFO. Per saperne di più, consulta Riduzione del livello di log degli errori di avvio del sistema Dataflow a WARN o INFO.
Nessun oggetto: pipeline.pb
Quando elenchi i job utilizzando l'opzione JOB_VIEW_ALL, si verifica il seguente errore:
No such object: BUCKET_NAME/PATH/pipeline.pb
Questo errore può verificarsi se elimini il file pipeline.pb dai file di gestione temporanea per il job.
Sincronizzazione dei pod ignorata
Il job viene eseguito correttamente, ma nei log del job viene visualizzato uno dei seguenti errori:
Skipping pod synchronization" err="container runtime status check may not have completed yet"
Oppure:
Skipping pod synchronization" err="[container runtime status check may not have completed yet, PLEG is not healthy: pleg has yet to be successful]"
Se il job viene eseguito correttamente, questi errori sono innocui e puoi ignorarli.
Il messaggio container runtime status check may not have completed yet viene visualizzato quando il kubelet di Kubernetes salta la sincronizzazione dei pod perché è in attesa dell'inizializzazione del runtime del container. Questo scenario si verifica per una serie di motivi, ad esempio quando il runtime del container è stato avviato di recente o è in fase di riavvio.
Quando il messaggio include PLEG is not healthy: pleg has yet to be
successful, il kubelet è in attesa che il generatore di eventi del ciclo di vita del pod (PLEG) diventi integro prima di sincronizzare i pod. Il PLEG è responsabile della generazione di eventi utilizzati da kubelet per monitorare lo stato dei pod.
Esiste una richiesta di funzionalità per modificare il livello di questo messaggio da WARN a INFO. Per saperne di più, consulta Riduzione del livello di log degli errori di avvio del sistema Dataflow a WARN o INFO.
Consigli
Per indicazioni sui suggerimenti generati da Dataflow Insights, consulta Insight.