


בדף הזה נסביר איך לנהל את בקרת הגישה כשפורסים ומריצים צינור נתונים שמשתמש באשכולות של Managed Service for Apache Spark בפרויקט אחר של Google Cloud .
תרחיש
כברירת מחדל, כשמפעילים מופע של Cloud Data Fusion בפרויקט ב-Google Cloud , המערכת פורסת ומריצה צינורות עיבוד נתונים באמצעות אשכולות של Managed Service for Apache Spark באותו פרויקט. עם זאת, יכול להיות שהארגון שלכם ידרוש מכם להשתמש באשכולות בפרויקט אחר. בתרחיש השימוש הזה, צריך לנהל את הגישה בין הפרויקטים. בדף הבא מוסבר איך לשנות את הגדרות הבסיס (ברירת המחדל) ולהחיל את אמצעי בקרת הגישה המתאימים.
לפני שמתחילים
כדי להבין את הפתרונות במקרה השימוש הזה, צריך להכיר את ההקשר הבא:
- היכרות עם מושגים בסיסיים ב-Cloud Data Fusion
- הכרת ניהול הזהויות והרשאות הגישה (IAM) ב-Cloud Data Fusion
- היכרות עם הגדרת הרשת ב-Cloud Data Fusion
הנחות והיקף
הדרישות של התרחיש לדוגמה הזה הן:
- מכונת Cloud Data Fusion פרטית. מטעמי אבטחה, יכול להיות שארגון ידרוש שימוש בסוג כזה של מופע.
- מקור ויעד ב-BigQuery.
- בקרת גישה באמצעות IAM, ולא בקרת גישה מבוססת-תפקידים (RBAC).
פתרון
הפתרון הזה משווה בין ארכיטקטורה ותצורה בסיסיות לבין ארכיטקטורה ותצורה ספציפיות לתרחיש לדוגמה.
ארכיטקטורה
בתרשימים הבאים מוצגת השוואה בין ארכיטקטורת הפרויקט ליצירת מופע של Cloud Data Fusion ולהרצת צינורות עיבוד נתונים כשמשתמשים באשכולות באותו פרויקט (בסיס) ובפרויקט אחר באמצעות ה-VPC של פרויקט הדייר.
ארכיטקטורת בסיס
בתרשים הזה מוצגת ארכיטקטורת הבסיס של הפרויקטים:
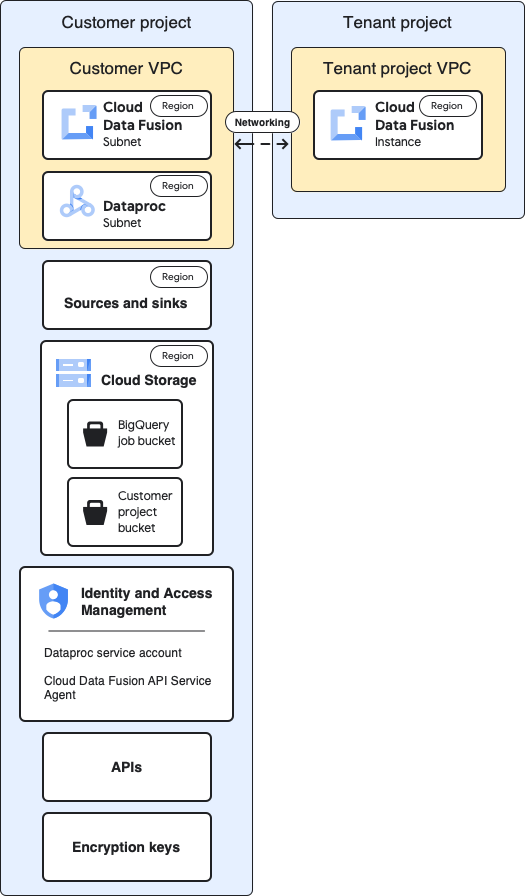
בהגדרת הבסיס, יוצרים מכונת Cloud Data Fusion פרטית ומריצים צינור ללא התאמה אישית נוספת:
- אתם משתמשים באחד מפרופילי החישוב המובנים
- מקור הנתונים ויעד הנתונים נמצאים באותו פרויקט כמו המופע
- לא הוקצו תפקידים נוספים לאף אחד מחשבונות השירות
מידע נוסף על פרויקטים של דיירים ולקוחות זמין במאמר בנושא רשתות.
ארכיטקטורה של תרחיש לדוגמה
בתרשים הזה מוצגת ארכיטקטורת הפרויקט כשמשתמשים באשכולות בפרויקט אחר:
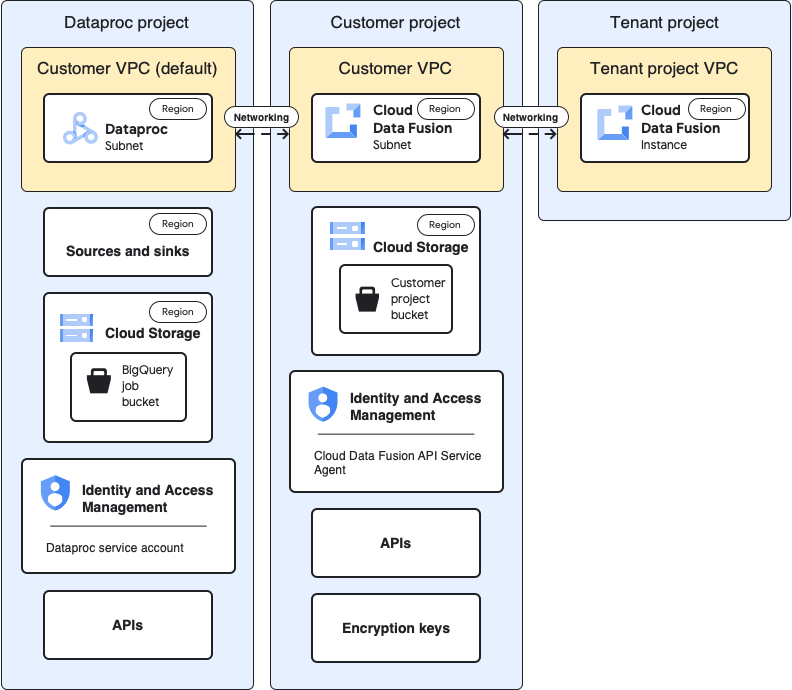
הגדרות אישיות
בקטעים הבאים מוצגות השוואות בין הגדרות הבסיס לבין הגדרות ספציפיות לתרחיש השימוש, להפעלת אשכולות של Managed Service for Apache Spark בפרויקט אחר באמצעות ה-VPC של פרויקט ברירת המחדל של הדייר.
בתיאורי תרחישי השימוש הבאים, פרויקט הלקוח הוא המקום שבו מופעל מופע Cloud Data Fusion, ופרויקט Managed Service for Apache Spark הוא המקום שבו מופעל אשכול Managed Service for Apache Spark.
מכונה ו-VPC של פרויקט דייר (tenant)
| בסיס להשוואה | תרחיש שימוש |
|---|---|
בתרשים הארכיטקטורה הבסיסית שלמעלה, פרויקט הדייר כולל את הרכיבים הבאים:
|
לא נדרשת הגדרה נוספת לתרחיש השימוש הזה. |
פרויקט של לקוח
| בסיס להשוואה | תרחיש שימוש |
|---|---|
| בפרויקט Google Cloud מגדירים ומריצים צינורות. כברירת מחדל, אשכולות של Managed Service for Apache Spark מופעלים בפרויקט הזה כשמריצים את צינורות הנתונים. | בתרחיש לדוגמה הזה, אתם מנהלים שני פרויקטים. בדף הזה, פרויקט הלקוח הוא המקום שבו פועלת מכונת Cloud Data Fusion. הפרויקט של Managed Service for Apache Spark מתייחס למיקום שבו מופעלים אשכולות של Managed Service for Apache Spark. |
VPC של הלקוח
| בסיס להשוואה | תרחיש שימוש |
|---|---|
מנקודת המבט שלכם (הלקוח), ה-VPC של הלקוח הוא המקום שבו Cloud Data Fusion ממוקם באופן לוגי. נקודה חשובה: פרטי ה-VPC של הלקוח מופיעים בדף 'רשתות VPC' בפרויקט. |
לא נדרשת הגדרה נוספת לתרחיש השימוש הזה. |
רשת משנה של Cloud Data Fusion
| בסיס להשוואה | תרחיש שימוש |
|---|---|
מנקודת המבט שלכם (הלקוח), רשת המשנה הזו היא המקום שבו Cloud Data Fusion ממוקם באופן לוגי. נקודה חשובה: האזור של רשת המשנה הזו זהה למיקום של מכונת Cloud Data Fusion בפרויקט הדייר. |
לא נדרשת הגדרה נוספת לתרחיש השימוש הזה. |
רשת משנה של Managed Service for Apache Spark
| בסיס להשוואה | תרחיש שימוש |
|---|---|
רשת המשנה שבה מופעלים אשכולות של Managed Service for Apache Spark כשמריצים צינור נתונים. נקודות עיקריות:
|
זוהי רשת משנה חדשה שבה מופעלים אשכולות של Managed Service for Apache Spark כשמריצים צינור נתונים. נקודות עיקריות:
|
מקורות ו-sinks
| בסיס להשוואה | תרחיש שימוש |
|---|---|
המקורות שמהם הנתונים מחולצים והיעדים שאליהם הנתונים נטענים, כמו מקורות ויעדים של BigQuery. נקודה מרכזית:
|
ההגדרות הספציפיות של בקרת הגישה בדף הזה מיועדות למקורות וליעדים של BigQuery. |
Cloud Storage
| בסיס להשוואה | תרחיש שימוש |
|---|---|
קטגוריית האחסון בפרויקט של הלקוח, שעוזרת להעביר קבצים בין Cloud Data Fusion לבין Managed Service for Apache Spark. נקודות עיקריות:
|
לא נדרשת הגדרה נוספת לתרחיש השימוש הזה. |
קטגוריות זמניות שמשמשות כמקורות וכ-sinks
| בסיס להשוואה | תרחיש שימוש |
|---|---|
מאגרי זמניים שנוצרים על ידי תוספים למקורות וליעדים שלכם, כמו משימות טעינה שהופעלו על ידי התוסף BigQuery Sink. נקודות עיקריות:
|
במקרה השימוש הזה, אפשר ליצור את הקטגוריה בכל פרויקט. |
קטגוריות שהן מקורות או יעדים של נתונים לתוספים
| בסיס להשוואה | תרחיש שימוש |
|---|---|
| קטגוריות של לקוחות, שאתם מציינים בהגדרות של תוספים, כמו התוסף Cloud Storage והתוסף FTP to Cloud Storage. | לא נדרשת הגדרה נוספת לתרחיש השימוש הזה. |
IAM: סוכן שירות של Cloud Data Fusion API
| בסיס להשוואה | תרחיש שימוש |
|---|---|
כשמפעילים את Cloud Data Fusion API, התפקיד Cloud Data Fusion API Service Agent ( נקודות עיקריות:
|
בתרחיש השימוש הזה, מעניקים את התפקיד Cloud Data Fusion API Service Agent (סוכן שירות של Cloud Data Fusion API) לחשבון השירות בפרויקט Managed Service for Apache Spark. לאחר מכן, מעניקים את התפקידים הבאים בפרויקט הזה:
|
IAM: חשבון שירות של Managed Service for Apache Spark
| בסיס להשוואה | תרחיש שימוש |
|---|---|
חשבון השירות שמשמש להרצת צינור עיבוד הנתונים כמשימה באשכול Managed Service for Apache Spark. כברירת מחדל, זהו חשבון השירות של Compute Engine. אופציונלי: בהגדרת הבסיס, אפשר לשנות את חשבון השירות שמוגדר כברירת מחדל לחשבון שירות אחר מאותו פרויקט. מקצים לחשבון השירות החדש את התפקידים הבאים ב-IAM:
|
בדוגמה הזו לתרחיש שימוש מניחים שאתם משתמשים בחשבון השירות שמוגדר כברירת מחדל ב-Compute Engine ( מקצים לחשבון השירות שמוגדר כברירת מחדל ב-Compute Engine בפרויקט Managed Service for Apache Spark את התפקידים הבאים.
מקצים את התפקיד 'משתמש בחשבון שירות' לחשבון השירות של Cloud Data Fusion בחשבון השירות שמשמש כברירת המחדל של Compute Engine בפרויקט Managed Service for Apache Spark. צריך לבצע את הפעולה הזו בפרויקט Managed Service for Apache Spark. מוסיפים את חשבון השירות שמוגדר כברירת מחדל ב-Compute Engine של פרויקט Managed Service for Apache Spark לפרויקט Cloud Data Fusion. מקצים גם את התפקידים הבאים:
|
ממשקי API
| בסיס להשוואה | תרחיש שימוש |
|---|---|
כשמפעילים את Cloud Data Fusion API, מופעלים גם ממשקי ה-API הבאים: מידע נוסף על ממשקי ה-API האלה זמין בדף APIs & services בפרויקט.
כשמפעילים את Cloud Data Fusion API, חשבונות השירות הבאים מתווספים אוטומטית לפרויקט:
|
בתרחיש השימוש הזה, צריך להפעיל את ממשקי ה-API הבאים בפרויקט שמכיל את פרויקט Managed Service for Apache Spark, אם הם עדיין לא הופעלו:
|
מפתחות הצפנה
| בסיס להשוואה | תרחיש שימוש |
|---|---|
בהגדרת הבסיס, מפתחות ההצפנה יכולים להיות בניהול Google או CMEK . נקודות עיקריות: אם אתם משתמשים ב-CMEK, הגדרת הבסיס שלכם צריכה לכלול את הדברים הבאים:
בהתאם לשירותים שבהם נעשה שימוש בצינור עיבוד הנתונים, כמו BigQuery או Cloud Storage, צריך גם להעניק לחשבונות השירות את התפקיד Cloud KMS CryptoKey Encrypter/Decrypter:
|
אם אתם לא משתמשים ב-CMEK, לא צריך לבצע שינויים נוספים לתרחיש השימוש הזה. אם משתמשים ב-CMEK, צריך להקצות את התפקיד Cloud KMS CryptoKey Encrypter/Decrypter לחשבון השירות הבא ברמת המפתח בפרויקט שבו הוא נוצר:
בהתאם לשירותים שבהם נעשה שימוש בצינור עיבוד הנתונים, כמו BigQuery או Cloud Storage, צריך להעניק לחשבונות שירות אחרים את התפקיד Cloud KMS CryptoKey Encrypter/Decrypter ברמת המפתח. לדוגמה:
|
אחרי שתבצעו את ההגדרות הספציפיות לתרחיש השימוש, צינור הנתונים יוכל להתחיל לפעול באשכולות בפרויקט אחר.
המאמרים הבאים
- מידע נוסף על רשתות ב-Cloud Data Fusion
- במאמר מסמך עזר בנושא תפקידים בסיסיים ומוגדרים מראש ב-IAM אפשר לקרוא פרטים נוספים.