


Halaman ini menjelaskan cara menjalankan pipeline di Cloud Data Fusion terhadap cluster Managed Service for Apache Spark yang sudah ada.
Secara default, Cloud Data Fusion membuat cluster sementara untuk setiap pipeline: cluster dibuat di awal eksekusi pipeline, lalu dihapus setelah eksekusi pipeline selesai. Meskipun perilaku ini menghemat biaya dengan memastikan bahwa resource hanya dibuat saat diperlukan, perilaku default ini mungkin tidak diinginkan dalam skenario berikut:
Jika waktu yang diperlukan untuk membuat kluster baru untuk setiap pipeline tidak memungkinkan untuk kasus penggunaan Anda.
Jika organisasi Anda mewajibkan pembuatan cluster dikelola secara terpusat; misalnya, saat Anda ingin menerapkan kebijakan tertentu untuk semua cluster Managed Service for Apache Spark.
Untuk skenario ini, Anda menjalankan pipeline terhadap cluster yang ada dengan langkah-langkah berikut.
Sebelum memulai
Anda memerlukan hal berikut:
Instance Cloud Data Fusion.
Cluster Managed Service for Apache Spark yang ada.
Jika Anda menjalankan pipeline di Cloud Data Fusion versi 6.2, gunakan image Managed Service for Apache Spark yang lebih lama yang berjalan dengan Hadoop 2.x (misalnya, 1.5-debian10), atau upgrade ke Cloud Data Fusion versi terbaru.
Hubungkan ke cluster yang ada
Di Cloud Data Fusion versi 6.2.1 dan yang lebih baru, Anda dapat terhubung ke cluster Managed Service for Apache Spark yang ada saat membuat profil Compute Engine baru.
Buka instance Anda:
Di konsol Google Cloud , buka halaman Cloud Data Fusion.
Untuk membuka instance di Cloud Data Fusion Studio, klik Instance, lalu klik View instance.
Klik Admin sistem.
Klik tab Configuration.
Klik Profil komputasi sistem.
Klik Buat profil baru. Halaman penyedia akan terbuka.
Klik Managed Service for Apache Spark yang Ada.
Masukkan informasi profil, cluster, dan pemantauan.
Klik Create.
Mengonfigurasi pipeline Anda untuk menggunakan profil kustom
Buka instance Anda:
Di konsol Google Cloud , buka halaman Cloud Data Fusion.
Untuk membuka instance di Cloud Data Fusion Studio, klik Instance, lalu klik View instance.
Buka pipeline Anda di halaman Studio.
Klik Configure.
Klik Compute config.
Klik profil yang Anda buat.
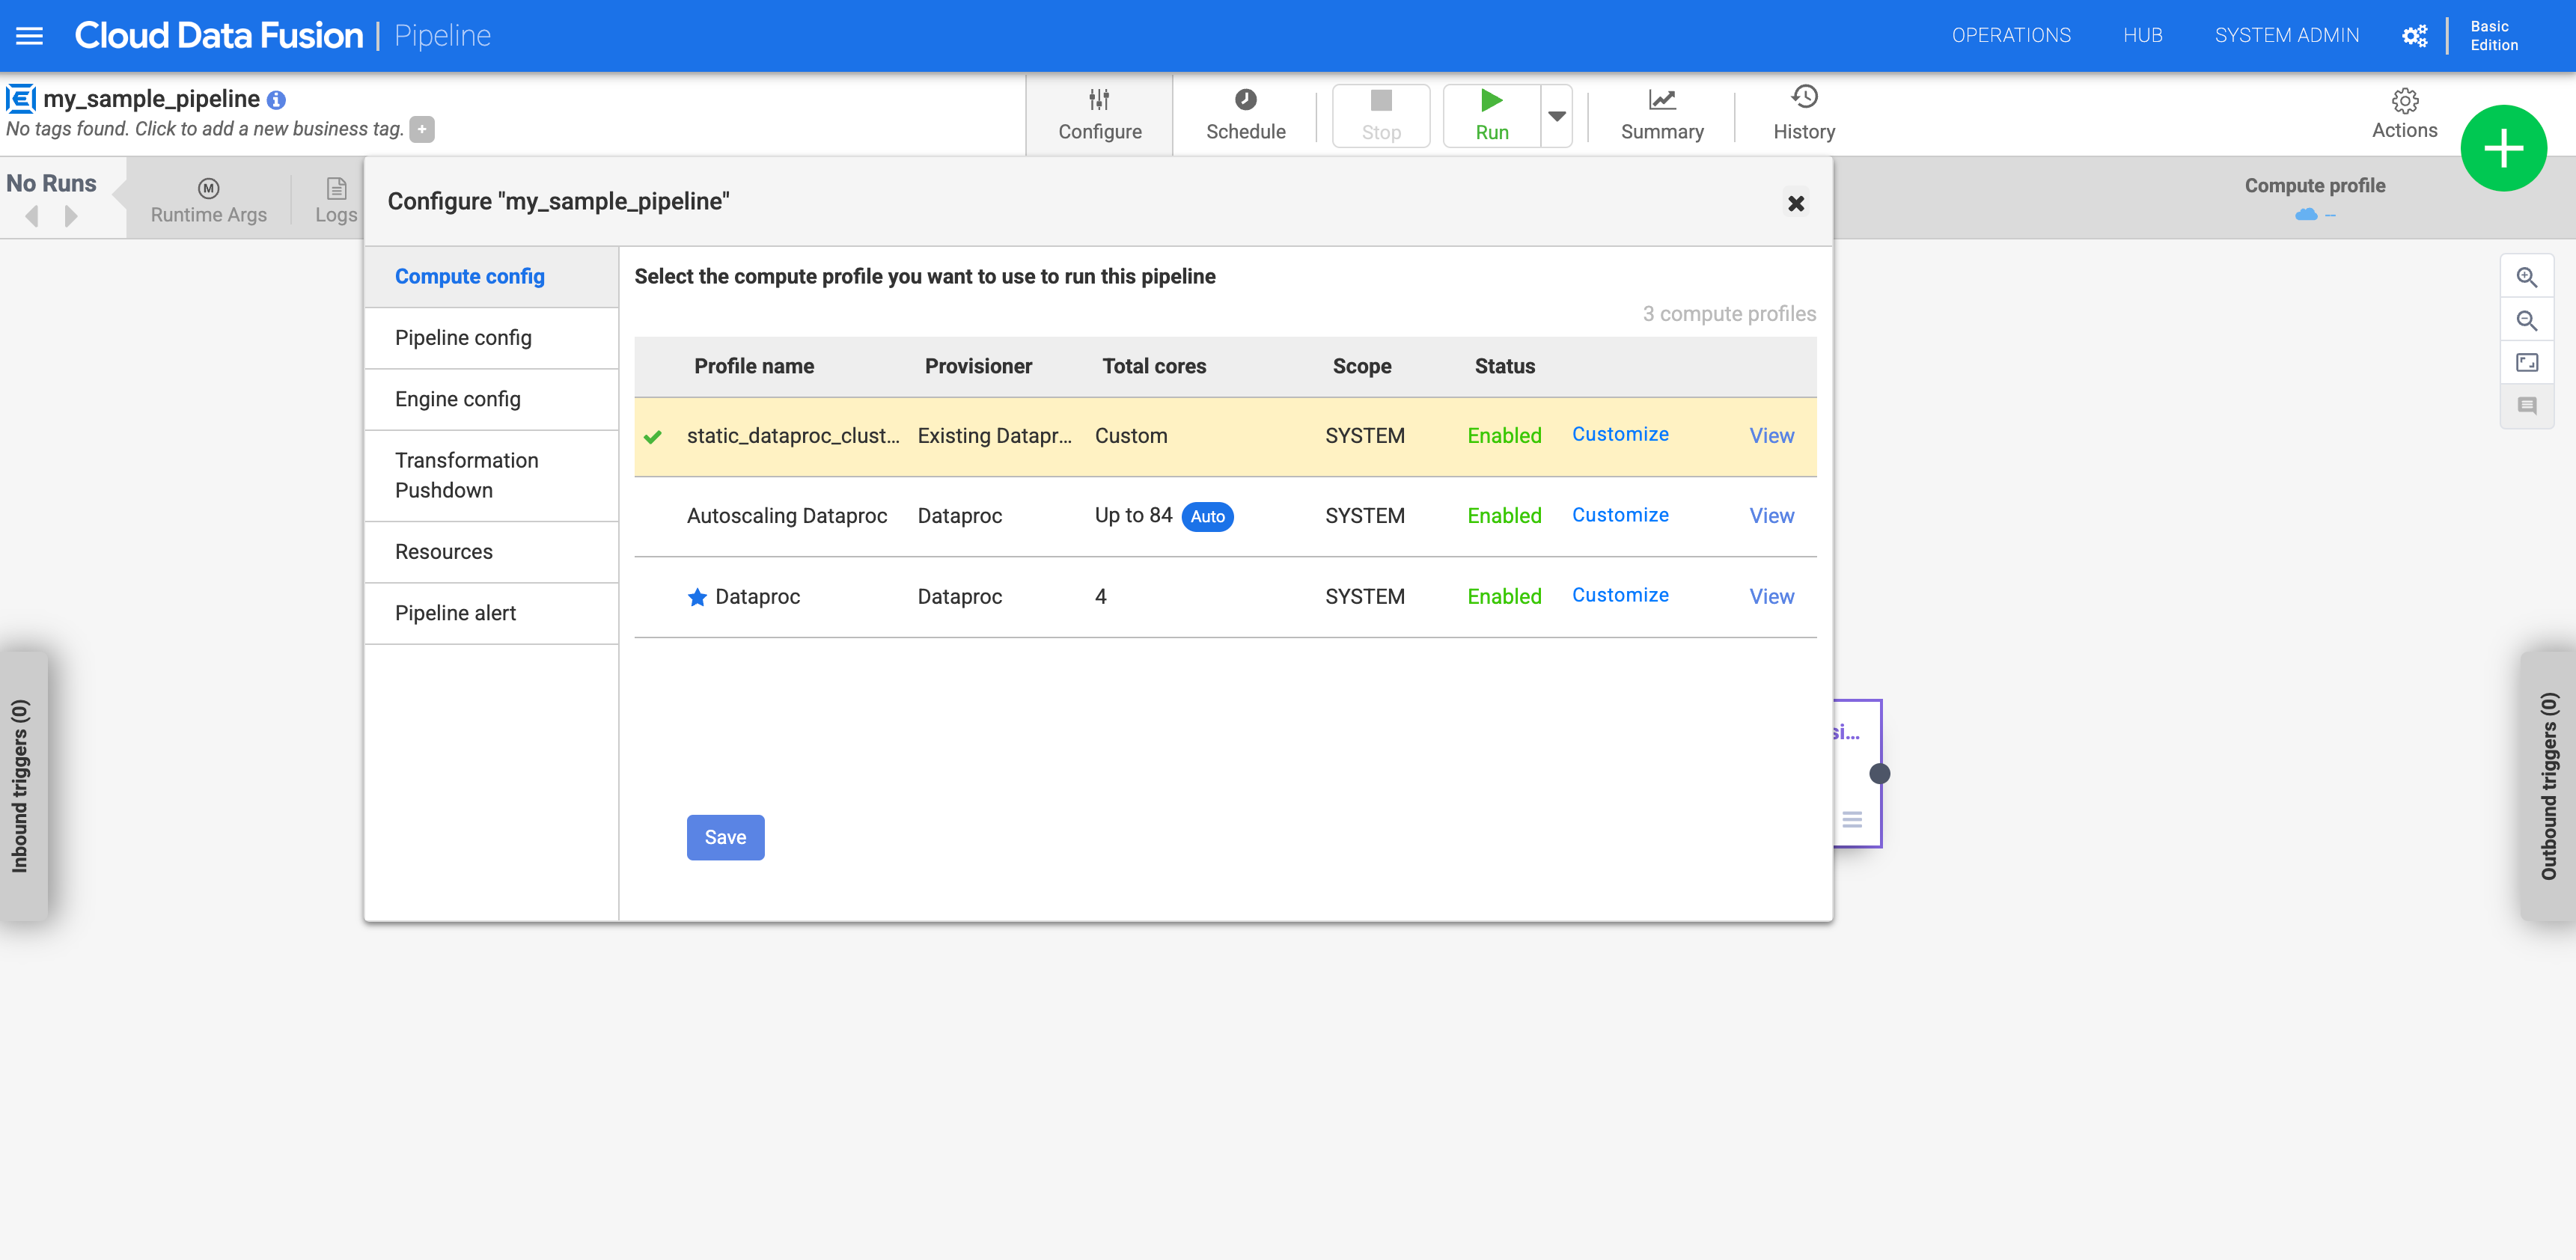
Gambar 1: Klik profil kustom Menjalankan pipeline. Tindakan ini berjalan terhadap cluster Managed Service for Apache Spark yang ada.
Langkah berikutnya
- Pelajari lebih lanjut cara mengonfigurasi cluster.
- Memecahkan masalah penghapusan cluster.