


בדף הזה מוסבר איך להריץ צינור ב-Cloud Data Fusion מול אשכול קיים של Managed Service for Apache Spark.
כברירת מחדל, Cloud Data Fusion יוצר אשכולות זמניים לכל צינור: הוא יוצר אשכול בתחילת ההרצה של הצינור, ואז מוחק אותו אחרי שההרצה של הצינור מסתיימת. ההתנהגות הזו חוסכת בעלויות כי היא מבטיחה שהמשאבים ייווצרו רק כשצריך אותם, אבל יכול להיות שהתנהגות ברירת המחדל הזו לא תתאים לתרחישים הבאים:
אם הזמן שנדרש ליצירת אשכול חדש לכל צינור ארוך מדי לתרחיש השימוש שלכם.
אם הארגון שלכם דורש ניהול מרכזי של יצירת אשכולות, למשל כשרוצים לאכוף מדיניות מסוימת על כל האשכולות של Managed Service for Apache Spark.
במקרים כאלה, במקום זאת מריצים צינורות נתונים מול אשכול קיים באמצעות השלבים הבאים.
לפני שמתחילים
תצטרכו את הדברים הבאים:
מופע של Cloud Data Fusion.
אשכול קיים של Managed Service for Apache Spark.
אם אתם מריצים את צינורות העיבוד ב-Cloud Data Fusion בגרסה 6.2, אתם יכולים להשתמש בתמונה ישנה יותר של Managed Service for Apache Spark שפועלת עם Hadoop 2.x (לדוגמה, 1.5-debian10), או לשדרג לגרסה האחרונה של Cloud Data Fusion.
התחברות לאשכול קיים
בגרסאות 6.2.1 ואילך של Cloud Data Fusion, אפשר להתחבר לאשכול קיים של Managed Service for Apache Spark כשיוצרים פרופיל חדש של Compute Engine.
עוברים למופע:
במסוף Google Cloud , נכנסים לדף Cloud Data Fusion.
כדי לפתוח את המכונה ב-Cloud Data Fusion Studio, לוחצים על Instances (מכונות) ואז על View instance (הצגת מכונה).
לוחצים על מנהל מערכת.
לוחצים על הכרטיסייה Configuration.
לוחצים על System compute profiles.
לוחצים על יצירת פרופיל חדש. ייפתח דף עם רשימה של כלי הקצאת הרשאות.
לוחצים על Existing Managed Service for Apache Spark (שירות מנוהל קיים ל-Apache Spark).
מזינים את פרטי הפרופיל, האשכול והמעקב.
לוחצים על יצירה.
הגדרת צינור עיבוד הנתונים לשימוש בפרופיל המותאם אישית
עוברים למופע:
במסוף Google Cloud , נכנסים לדף Cloud Data Fusion.
כדי לפתוח את המכונה ב-Cloud Data Fusion Studio, לוחצים על Instances (מכונות) ואז על View instance (הצגת מכונה).
עוברים אל צינור העיבוד בדף Studio.
לוחצים על Configure (הגדרה).
לוחצים על Compute config (הגדרת מחשוב).
לוחצים על הפרופיל שיצרתם.
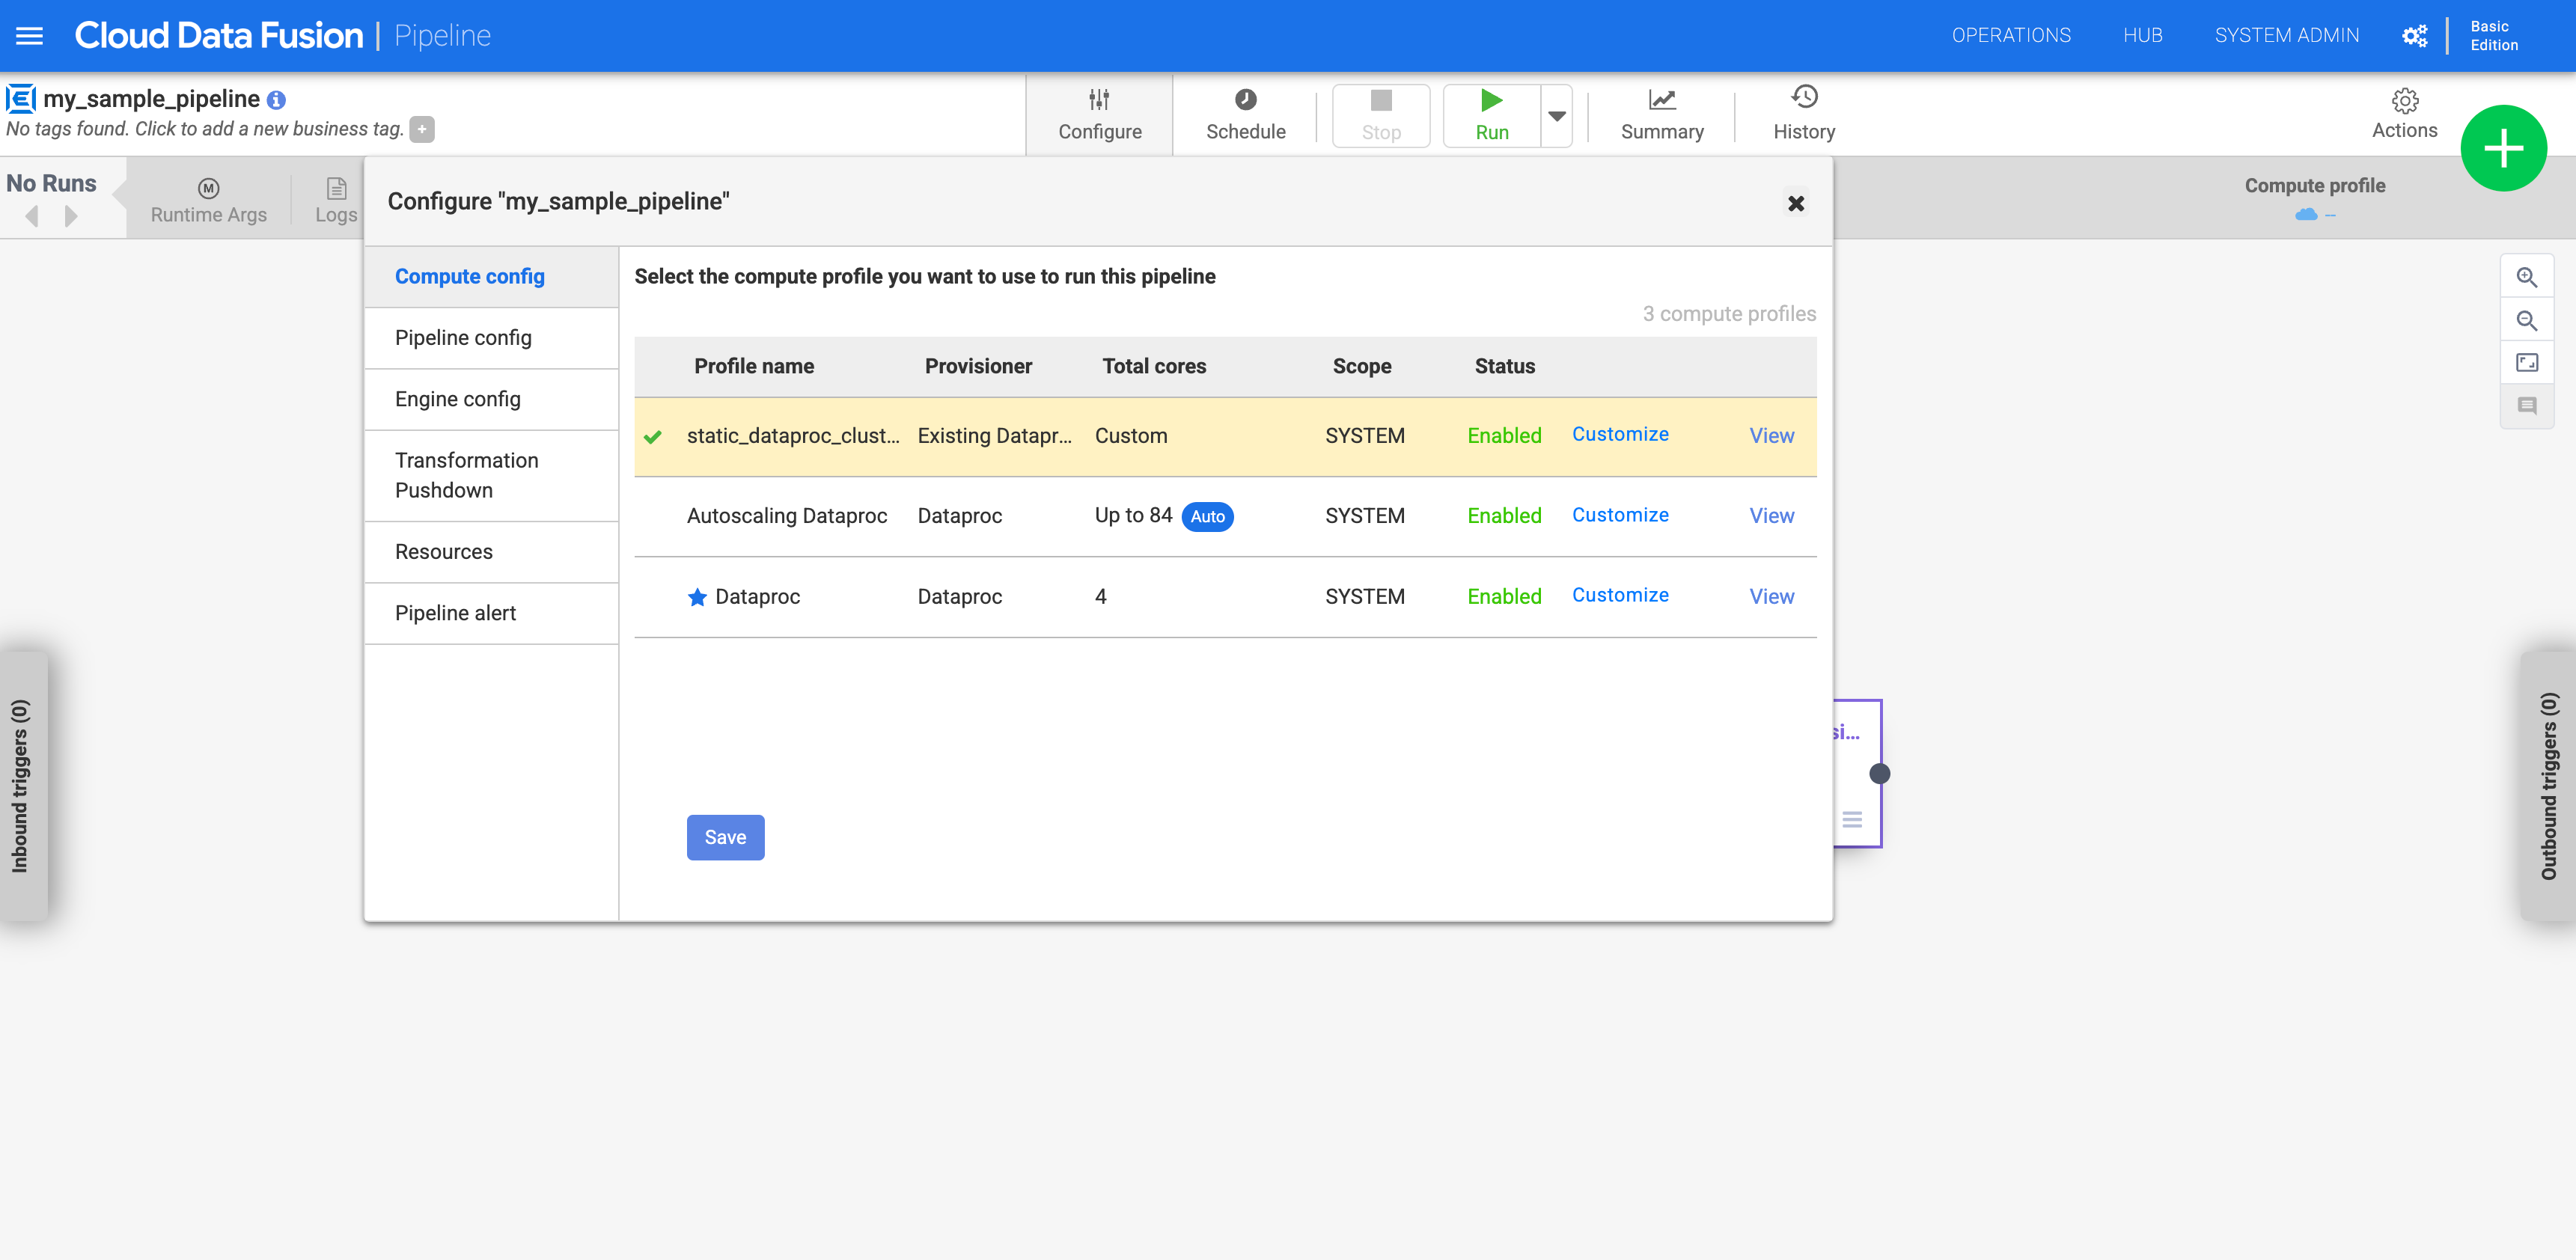
איור 1: לחיצה על פרופיל בהתאמה אישית מריצים את הפייפליין. הוא פועל מול אשכול קיים של Managed Service for Apache Spark.
המאמרים הבאים
- מידע נוסף על הגדרת אשכולות
- פתרון בעיות שקשורות למחיקת אשכולות.