


כוונון של עיבוד צינורות עיבוד הנתונים ב-Cloud Data Fusion מאפשר לכם לשפר את מהירות הביצוע ולמנוע צווארי בקבוק בזמן הריצה. הבנת המושגים האלה עוזרת לכם להעריך את גודל התשתית בצורה יעילה ולצמצם את עלויות המחשוב בתהליכי העבודה של הנתונים.
הביצועים של צינור עיבוד הנתונים תלויים בהיבטים הבאים:
- הגודל והמאפיינים של הנתונים
- המבנה של צינור עיבוד הנתונים
- גודל האשכול
- פלאגינים שמשמשים את צינור עיבוד הנתונים ב-Cloud Data Fusion
מונחים שקשורים לעיבוד צינורות נתונים ב-Cloud Data Fusion
המונחים הבאים רלוונטיים לעיבוד צינורות נתונים ב-Cloud Data Fusion.
- סוג המכונה
- סוג המכונות הווירטואליות (VM) שבהן משתמשים (מעבד, זיכרון).
- אשכול
- קבוצה של מכונות וירטואליות שפועלות יחד כדי לטפל במשימות עיבוד נתונים בהיקף גדול.
- צומתי מאסטר וצומתי עובדים
- מכונות פיזיות או וירטואליות שיכולות לבצע עיבוד. צומתי מאסטר בדרך כלל מתאמים את העבודה. צמתי עובד מריצים רכיבי Executor שמעבדים נתונים. יש להם מאפייני מכונה (נפח הזיכרון ומספר הליבות הווירטואליות שזמינות לתהליכים).
- ליבות וירטואליות, ליבות או מעבדים
- משאב שמבצע חישובים. בדרך כלל הצמתים מספקים כמות מסוימת של ליבות, וה-Executors מבקשים מעבד אחד או כמה מעבדים. חשוב לאזן את זה עם הזיכרון, אחרת יכול להיות שלא תנצלו את האשכול כמו שצריך.
- נהג/ת
- מכונה וירטואלית אחת שמשמשת כמתאם מרכזי לכל האשכול. הוא מנהל את המשימות, מתזמן את העבודה בין צומתי העובדים ועוקב אחרי התקדמות המשימות.
- מבצעים
- כמה מכונות וירטואליות שמבצעות את משימות עיבוד הנתונים בפועל, לפי ההוראות של מנהל ההתקן. הנתונים מחולקים ומפוזרים בין המבצעים האלה לצורך עיבוד מקביל. כדי להשתמש בכל הרכיבים להרצת קוד, צריך שיהיו מספיק פיצולים.
- פיצולים או מחיצות
- קבוצת נתונים מפוצלת לפיצולים (חלוקות אחרות של שמות) כדי לעבד נתונים במקביל. אם אין לכם מספיק פיצולים, לא תוכלו להשתמש בכל האשכול.
סקירה כללית על שיפור הביצועים
הצינורות מופעלים באשכולות של מכונות. כשבוחרים להפעיל צינורות של Cloud Data Fusion באשכולות של Managed Service for Apache Spark (שהוא ספק השירות המומלץ), המערכת משתמשת ב-YARN (Yet Another Resource Negotiator) ברקע. ב-Managed Service for Apache Spark, ניהול המשאבים באשכול מתבצע באמצעות YARN. כששולחים צינור עיבוד נתונים של Cloud Data Fusion לאשכול Managed Service for Apache Spark, המשימה הבסיסית של Apache Spark משתמשת ב-YARN להקצאת משאבים ולתזמון משימות.
קלאסטר מורכב מצמתי מאסטר ומצמתי עובד. צומתי מאסטר אחראים בדרך כלל על תיאום העבודה, וצומתי עובד מבצעים את העבודה בפועל. בדרך כלל, באשכולות יש מספר קטן של צמתי מאסטר (אחד או שלושה) ומספר גדול של צמתי עובד. מערכת תיאום העבודה היא YARN. YARN מריץ שירות של מנהל משאבים בצומת הראשי ושירות של Node Manager בכל צומת עובד. מנהלי המשאבים מתאמים בין כל Node Managers כדי לקבוע איפה ליצור ולהריץ קונטיינרים באשכול.
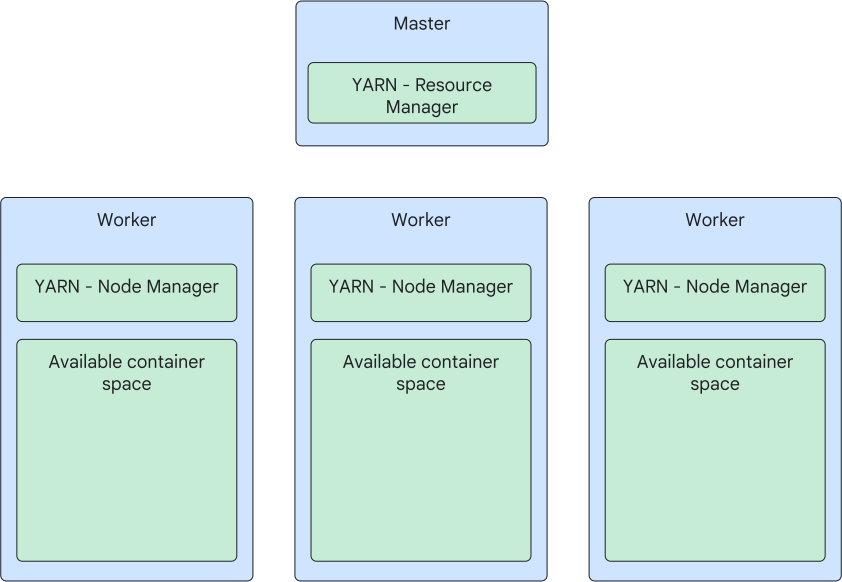
בכל צומת עובד, Node Manager שומר חלק מהזיכרון ומעבדי ה-CPU הזמינים במכונה להרצת קונטיינרים של YARN. לדוגמה, באשכול של Managed Service for Apache Spark, אם צומתי העובדים הם מכונות וירטואליות מסוג n1-standard-4 (4 מעבדים, זיכרון בנפח 15GB), כל Node Manager יקצה 4 מעבדים וזיכרון בנפח 12GB להרצת קונטיינרים של YARN. שאר הזיכרון בנפח 3 GB מיועד לשירותי Hadoop אחרים שפועלים בצומת.
כשמריצים צינור עיבוד נתונים ב-YARN, מופעלים מנהל התקן של תהליך העבודה של צינור עיבוד הנתונים, מנהל התקן של Spark ומבצעים רבים של Spark ב-Managed Service for Apache Spark.
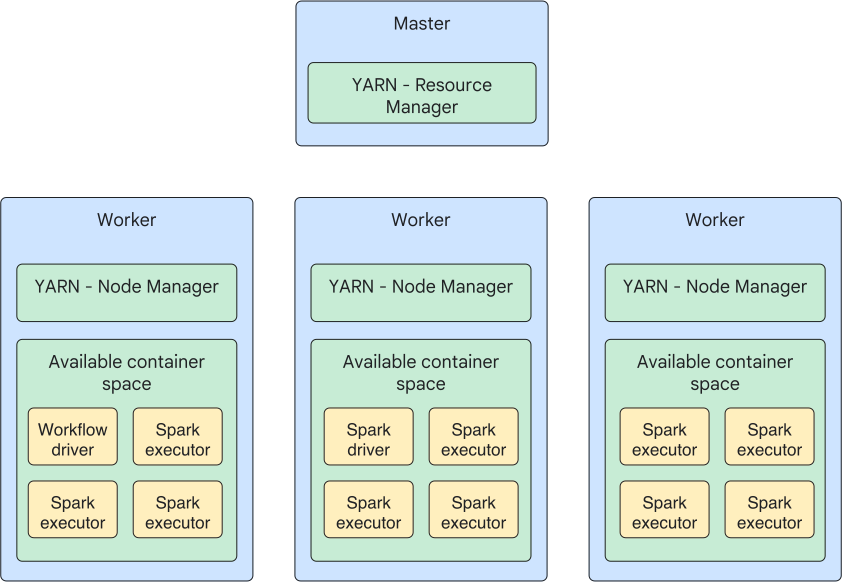
מנהל ההתקן של תהליך העבודה אחראי להפעלת תוכנית Spark אחת או יותר שמרכיבות את צינור עיבוד הנתונים. בדרך כלל, מנהל התהליך לא מבצע הרבה עבודה. כל תוכנית Spark מפעילה מנהל התקן Spark יחיד וכמה מפעילים של Spark. ה-driver מתאם את העבודה בין ה-executors, אבל בדרך כלל לא מבצע עבודה בפועל. רוב העבודה בפועל מתבצעת על ידי תהליכי Spark executor.
המאמרים הבאים
- מידע נוסף על עיבוד מקביל ב-Cloud Data Fusion