


שיטות מומלצות לתכנון סכימה
סכימה יעילה של Bigtable מאפשרת למקסם את קצב הקריאה והכתיבה, למנוע נקודות חמות ולהתאים את נפח האחסון ביעילות. לפני שמתחילים, כדאי לקרוא את הסקירה הכללית על Bigtable כדי להבין את הארכיטקטורה הבסיסית ואת מודל האחסון.
מושגים כלליים
עיצוב סכימה של Bigtable שונה מעיצוב סכימה של מסד נתונים רלציוני. סכימה של Bigtable מוגדרת על ידי לוגיקה של אפליקציה, ולא על ידי אובייקט או קובץ של הגדרת סכימה. אפשר להוסיף קבוצות עמודות לטבלה כשיוצרים או מעדכנים אותה, אבל העמודות והתבניות של מפתחות השורות מוגדרות לפי הנתונים שכותבים בטבלה.
ב-Bigtable, סכימה היא תוכנית או מודל של טבלה, כולל המבנה של רכיבי הטבלה הבאים:
- מפתחות שורות
- משפחות עמודות, כולל מדיניות איסוף האשפה שלהן
- Columns
ב-Bigtable, עיצוב הסכימה מבוסס בעיקר על השאילתות או על בקשות הקריאה שאתם מתכננים לשלוח לטבלה. מכיוון שקריאת טווח שורות היא הדרך המהירה ביותר לקרוא את הנתונים ב-Bigtable, ההמלצות בדף הזה נועדו לעזור לכם לבצע אופטימיזציה לקריאות של טווח שורות. ברוב המקרים, זה אומר לשלוח שאילתה שמבוססת על קידומות של מפתחות שורות.
שיקול משני הוא הימנעות מנקודות חמות – כדי למנוע נקודות חמות, צריך להביא בחשבון דפוסי כתיבה ואיך אפשר להימנע מגישה למרחב מפתחות קטן בפרק זמן קצר.
המושגים הכלליים הבאים רלוונטיים לתכנון סכימה ב-Bigtable:
- Bigtable הוא מאגר מפתחות/ערכים, ולא מאגר יחסי. הוא לא תומך בצירופים, והטרנזקציות נתמכות רק בשורה אחת.
- לכל טבלה יש אינדקס: מפתח השורה. כל מפתח שורה חייב להיות ייחודי. כדי ליצור אינדקס משני, צריך להשתמש בתצוגה מהותית רציפה. מידע נוסף זמין במאמר יצירת אינדקס משני אסינכרוני.
- מפתחות השורות ממיינים את השורות בסדר לקסיקוגרפי, ממחרוזת הבייטים הנמוכה ביותר לגבוהה ביותר. הסדר הזה הוא big-endian (לפעמים נקרא network byte order), המקבילה הבינארית לסדר אלפביתי.
- משפחות עמודות לא מאוחסנות בסדר מסוים.
- העמודות מקובצות לפי קבוצת עמודות וממוינות בסדר לקסיקוגרפי בתוך קבוצת העמודות. לדוגמה, בקבוצת עמודות שנקראת
SysMonitorעם מגדירי העמודותProcessName,User,%CPU,ID,Memory,DiskReadו-Priority, Bigtable מאחסן את העמודות בסדר הבא:
| SysMonitor | ||||||
|---|---|---|---|---|---|---|
| %CPU | DiskRead | מזהה | זיכרון | עדיפות | ProcessName | משתמש |
- ההצטלבות של שורה ועמודה יכולה להכיל כמה תאים עם חותמות זמן. כל תא מכיל גרסה ייחודית עם חותמת זמן של הנתונים בשורה ובעמודה הרלוונטיות.
- משפחות עמודות נתונים נצברים מכילות תאים של נתונים נצברים. אתם יכולים ליצור קבוצות עמודות שמכילות רק תאים מצטברים. צבירה מאפשרת למזג נתונים חדשים עם נתונים שכבר קיימים בתא.
- כל הפעולות הן אטומיות ברמת השורה. פעולה משפיעה על שורה שלמה או לא משפיעה על השורה בכלל.
- באופן אידיאלי, גם פעולות הקריאה וגם פעולות הכתיבה צריכות להיות מפוזרות באופן שווה במרחב השורות של הטבלה.
- הטבלאות של Bigtable הן חסכוניות (sparse). עמודה לא תופסת מקום בשורה שלא משתמשת בה.
שיטות מומלצות
סכימה טובה מובילה לביצועים מצוינים וליכולת התאמה לעומס, וסכימה שתוכננה בצורה לא טובה יכולה להוביל למערכת עם ביצועים נמוכים. כל תרחיש לדוגמה הוא שונה ודורש עיצוב משלו, אבל השיטות המומלצות הבאות רלוונטיות לרוב התרחישים לדוגמה. החריגים מצוינים.
בקטעים הבאים מתוארות השיטות המומלצות לתכנון סכימה, החל מרמת הטבלה ועד לרמת מפתח השורה:
כל רכיבי הטבלה, במיוחד מפתחות השורות, צריכים להיות מתוכננים בהתאם לבקשות הקריאה המתוכננות. כדאי לבדוק את המכסות והמגבלות כדי לראות את הגודל המומלץ והגודל המקסימלי של כל רכיבי הטבלה.
כל הטבלאות במכונה מאוחסנות באותם טאבלטים, ולכן עיצוב סכימה שגורם לנקודות חמות בטבלה אחת יכול להשפיע על זמן האחזור של טבלאות אחרות באותה מכונה. נקודות חמות נוצרות כשניגשים לעיתים קרובות לחלק אחד בטבלה בפרק זמן קצר.
Tables
אחסון מערכי נתונים עם סכימות דומות באותה טבלה, במקום בטבלאות נפרדות.
במערכות אחרות של מסדי נתונים, יכול להיות שתבחרו לאחסן נתונים בכמה טבלאות, בהתאם לנושא ולמספר העמודות. אבל ב-Bigtable בדרך כלל עדיף לאחסן את כל הנתונים בטבלה אחת. אתם יכולים להקצות לכל קבוצת נתונים קידומת ייחודית של מפתח שורה, כדי ש-Bigtable יאחסן את הנתונים הקשורים בטווח רציף של שורות, שאחר כך תוכלו לשלוח אליהן שאילתות לפי הקידומת של מפתח השורה.
ב-Bigtable יש מגבלה של 1,000 טבלאות לכל מכונה, אבל מומלץ להימנע מיצירת מספר גדול של טבלאות מהסיבות הבאות:
- שליחת בקשות להרבה טבלאות שונות יכולה להגדיל את התקורה של החיבור לקצה העורפי, וכתוצאה מכך להגדיל את זמן האחזור של הזנב.
- יצירת טבלאות נוספות לא משפרת את איזון העומסים ויכולה להגדיל את התקורה של הניהול.
יכול להיות שתרצו טבלה נפרדת לתרחיש לדוגמה אחר שדורש סכימה שונה, אבל אל תשתמשו בטבלאות נפרדות לנתונים דומים. לדוגמה, לא כדאי ליצור טבלה חדשה רק כי התחילה שנה חדשה או כי יש לכם לקוח חדש.
משפחות עמודות
הציבו עמודות קשורות באותה קבוצת עמודות. כששורה מכילה כמה ערכים שקשורים זה לזה, מומלץ לקבץ את העמודות שמכילות את הערכים האלה באותה קבוצת עמודות. כדאי לקבץ את הנתונים בצורה הכי קרובה שאפשר כדי שלא תצטרכו ליצור מסננים מורכבים, וכדי שתקבלו רק את המידע שאתם צריכים, ולא יותר, בבקשות הקריאה הנפוצות ביותר.
אפשר ליצור עד כ-100 קבוצות עמודות בכל טבלה. יצירה של יותר מ-100 קבוצות עמודות עלולה לגרום לפגיעה בביצועים.
בחרו שמות קצרים לקבוצות העמודות. השמות נכללים בנתונים שמועברים בכל בקשה.
הציבו עמודות עם צרכים שונים של שמירת נתונים בקבוצות עמודות שונות. השיטה הזו חשובה אם רוצים להגביל את עלויות האחסון. מדיניות איסוף האשפה מוגדרת ברמת קבוצת העמודות, ולא ברמת העמודה. לדוגמה, אם אתם צריכים לשמור רק את הגרסה האחרונה של נתון מסוים, אל תאחסנו אותו בקבוצת עמודות שמוגדרת לאחסן 1,000 גרסאות של משהו אחר. אחרת, אתם משלמים על אחסון של 999 תאי נתונים שאתם לא צריכים.
Columns
אפשר ליצור כמה עמודות שרוצים בטבלה. טבלאות Bigtable הן חסכוניות (sparse), ואין עונש על שימוש בשטח לעמודה שלא נעשה בה שימוש בשורה. בטבלה יכולות להיות מיליוני עמודות, כל עוד אף שורה לא חורגת מהמגבלה המקסימלית של 256MB לשורה.
אל תשתמשו ביותר מדי עמודות בשורה אחת. למרות שטבלה יכולה להכיל מיליוני עמודות, שורה לא צריכה להכיל מיליוני עמודות. יש כמה גורמים שמשפיעים על השיטה המומלצת הזו:
- ל-Bigtable לוקח זמן לעבד כל תא בשורה.
- כל תא מוסיף תקורה לכמות הנתונים שמאוחסנים בטבלה ונשלחים ברשת. לדוגמה, אם אתם מאחסנים נתונים בנפח של 1KB (1,024 בייטים), הרבה יותר יעיל לאחסן את הנתונים האלה בתא אחד, במקום לפזר אותם על פני 1,024 תאים שכל אחד מהם מכיל בייט אחד.
אם קבוצת הנתונים שלכם דורשת באופן לוגי יותר עמודות בכל שורה ממה ש-Bigtable יכול לעבד ביעילות, כדאי לשקול לאחסן את הנתונים כ-protobuf בעמודה אחת.
אפשר גם להתייחס למגדירי העמודות כנתונים. מכיוון שצריך לאחסן מגדיר עמודה לכל עמודה, אפשר לחסוך מקום על ידי מתן שם לעמודה עם ערך. לדוגמה, נניח שיש טבלה שבה מאוחסנים נתונים על חברויות בקבוצת עמודות Friends. כל שורה מייצגת אדם ואת כל החברויות שלו. כל מגדיר עמודה יכול להיות מזהה של חבר. אחר כך, הערך של כל עמודה בשורה הזו יכול להיות המעגל החברתי שהחבר נמצא בו. בדוגמה הזו, השורות יכולות להיראות כך:
| מפתח שורה | Fred | גבריאל | הירושי | Seo Yoon | יעקב |
|---|---|---|---|---|---|
| יוסי | מועדון הספר הטוב | עבודה | טניס | ||
| סופיה | עבודה | בית ספר | מועדון שחמט |
השוו את הסכימה הזו לסכימה של אותם נתונים שלא מתייחסת למגדירי העמודות כנתונים, ובמקום זאת יש בה את אותן עמודות בכל שורה:
| מפתח שורה | חבר | עיגול |
|---|---|---|
| Jose#1 | Fred | מועדון הספר הטוב |
| Jose#2 | גבריאל | עבודה |
| Jose#3 | הירושי | טניס |
| Sofia#1 | הירושי | עבודה |
| סופיה#2 | Seo Yoon | בית ספר |
| Sofia#3 | יעקב | מועדון שחמט |
העיצוב השני של הסכימה גורם לטבלה לגדול הרבה יותר מהר.
אם אתם משתמשים במגדירי עמודות כדי לאחסן נתונים, תנו למגדירי העמודות שמות קצרים אבל משמעותיים. הגישה הזו מאפשרת לכם לצמצם את כמות הנתונים שמועברים בכל בקשה. הגודל המקסימלי הוא 16KB.
Rows
הגודל של כל הערכים בשורה אחת צריך להיות קטן מ-100MB. חשוב לוודא שהנתונים בשורה אחת לא חורגים מ-256MB. שורות שחורגות מהמגבלה הזו עלולות לפגוע בביצועי הקריאה.
כל המידע על ישות מסוימת צריך להיות בשורה אחת. ברוב התרחישים לדוגמה, כדאי להימנע מאחסון נתונים שצריך לקרוא באופן אטומי, או בבת אחת, ביותר משורה אחת כדי למנוע חוסר עקביות. לדוגמה, אם מעדכנים שתי שורות בטבלה, יכול להיות ששורה אחת תתעדכן בהצלחה והעדכון של השורה השנייה ייכשל. כדי שהנתונים הקשורים יהיו מדויקים, ודאו שהסכימה לא דורשת עדכון של יותר משורה אחת בו-זמנית. כך, אם חלק מבקשת הכתיבה נכשל או שצריך לשלוח אותו שוב, הנתונים לא יהיו חלקיים באופן זמני.
חריג: אם שמירת ישות בשורה אחת גורמת לשורות בגודל של מאות מגה-בייט, צריך לפצל את הנתונים לכמה שורות.
אחסון ישויות קשורות בשורות סמוכות, כדי לייעל את הקריאות.
תאים
אל תאחסנו יותר מ-10MB של נתונים בתא אחד. חשוב לזכור שתא הוא הנתונים שמאוחסנים בשורה ובעמודה נתונות עם חותמת זמן ייחודית, ושאפשר לאחסן כמה תאים בנקודת החיתוך של השורה והעמודה האלה. מספר התאים שנשמרים בעמודה נקבע לפי מדיניות איסוף האשפה שהגדרתם לקבוצת העמודות שמכילה את העמודה הזו.
משתמשים בתאים נצברים כדי לאחסן ולעדכן נתונים נצברים. אם אתם מתעניינים רק בערך המצטבר של אירועים של ישות, כמו סכום המכירות החודשי לכל עובד בחנות קמעונאית, אתם יכולים להשתמש בצבירות. למידע נוסף, ראו צבירת ערכים בזמן הכתיבה.
מפתחות שורות
תכננו את מפתח השורה על סמך השאילתות שבהן תשתמשו כדי לאחזר את הנתונים. מפתחות שורות שתוכננו היטב מפיקים את הביצועים הטובים ביותר מ-Bigtable. השאילתות היעילות ביותר ב-Bigtable מאחזרות נתונים באמצעות אחת מהאפשרויות הבאות:
- מפתח שורה
- קידומת של מפתח שורה
- טווח של שורות שמוגדר על ידי מפתחות השורה הראשונה והאחרונה
סוגים אחרים של שאילתות מפעילים סריקה של טבלה מלאה, שהיא הרבה פחות יעילה. אם תבחרו עכשיו את מפתח השורה הנכון, תוכלו להימנע מתהליך כואב של העברת נתונים בהמשך.
מפתחות שורות קצרים. מפתח שורה חייב להיות בגודל של עד 4KB. מפתחות שורה ארוכים תופסים יותר זיכרון ונפח אחסון, ומאריכים את הזמן שנדרש כדי לקבל תשובות מהשרת של Bigtable.
אחסון של כמה ערכים מופרדים בכל מפתח שורה. הדרך הטובה ביותר לשלוח שאילתות ל-Bigtable ביעילות היא באמצעות מפתח שורה, ולכן כדאי לכלול כמה מזהים במפתח השורה. כשמפתח השורה כולל כמה ערכים, חשוב במיוחד להבין בבירור איך אתם משתמשים בנתונים.
בדרך כלל, מקטעים של מפתחות שורות מופרדים באמצעות תו מפריד, כמו נקודתיים, קו נטוי או סולמית. הפלח הראשון או קבוצת הפלחים הרציפים הם הקידומת של מפתח השורה, והפלח האחרון או קבוצת הפלחים הרציפים הם הסיומת של מפתח השורה.
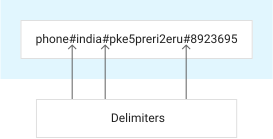
תחיליות מתוכננות היטב של מפתחות שורות מאפשרות לכם לנצל את סדר המיון המובנה של Bigtable כדי לאחסן נתונים קשורים בשורות סמוכות. אחסון נתונים קשורים בשורות סמוכות מאפשר לגשת לנתונים קשורים כטווח של שורות, במקום להריץ סריקות לא יעילות של טבלאות.
אם הנתונים כוללים מספרים שלמים שרוצים לאחסן או למיין באופן מספרי, צריך להוסיף למספרים השלמים אפסים בתחילת המספר. Bigtable מאחסן נתונים באופן לקסיקוגרפי. לדוגמה, מבחינה לקסיקוגרפית, 3 > 20 אבל 20 > 03. הוספת אפס לפני הספרה 3 מבטיחה שהמספרים ימוינו לפי הסדר המספרי. הטקטיקה הזו חשובה לחותמות זמן שבהן נעשה שימוש בשאילתות מבוססות-טווח.
חשוב ליצור מפתח שורה שמאפשר לאחזר טווח מוגדר היטב של שורות. אחרת, השאילתה תדרוש סריקת טבלה, שהיא איטית בהרבה מאחזור שורות ספציפיות.
לדוגמה, אם האפליקציה עוקבת אחרי נתונים של מכשירים ניידים, מפתח השורה יכול לכלול את סוג המכשיר, מזהה המכשיר והיום שבו הנתונים תועדו. מפתחות השורות של הנתונים האלה עשויים להיראות כך:
        phone#4c410523#20200501
        phone#4c410523#20200502
        tablet#a0b81f74#20200501
        tablet#a0b81f74#20200502
העיצוב הזה של מפתח השורה מאפשר לאחזר נתונים באמצעות בקשה אחת:
- סוג מכשיר
- שילוב של סוג המכשיר ומזהה המכשיר
העיצוב הזה של מפתח השורה לא יהיה אופטימלי אם תרצו לאחזר את כל הנתונים של יום מסוים. היום מאוחסן בקטע השלישי, או בסיומת של מפתח השורה, ולכן אי אפשר פשוט לבקש טווח של שורות על סמך הסיומת או קטע אמצעי של מפתח השורה. במקום זאת, צריך לשלוח בקשת קריאה עם מסנן שסורק את כל הטבלה ומחפש את ערך היום.
השתמשו בערכי מחרוזת קריאים לאנשים במפתחות השורות כשאפשר. כך קל יותר להשתמש בכלי Key Visualizer כדי לפתור בעיות ב-Bigtable.
בדרך כלל, כדאי לעצב מפתחות שורות שמתחילים בערך נפוץ ומסתיימים בערך פרטני. לדוגמה, אם מפתח השורה כולל יבשת, מדינה ועיר, אפשר ליצור מפתחות שורה שנראים כמו בדוגמה הבאה, כדי שהם ימוינו באופן אוטומטי קודם לפי ערכים עם עוצמה נמוכה יותר:
        asia#india#bangalore
        asia#india#mumbai
        asia#japan#osaka
        asia#japan#sapporo
        southamerica#bolivia#cochabamba
        southamerica#bolivia#lapaz
        southamerica#chile#santiago
        southamerica#chile#temuco
מפתחות שורה מובנים
אם אתם מתכננים לשלוח שאילתות לטבלה באמצעות SQL, אתם יכולים להגדיר מפתחות שורה מובְנים, שמאפשרים לגשת לנתונים ב-Bigtable באמצעות מפתחות עם כמה חלקים, בדומה למפתחות מורכבים במסדי נתונים רלציוניים. הגדרת מפתחות שורות מובְנים לטבלה מאפשרת לגשת לפלחים ספציפיים של מפתחות השורות באמצעות שאילתות GoogleSQL ל-Bigtable.
מפתחות שורות מובְנים נוצרים באופן אוטומטי כשיוצרים תצוגה מהותית רציפה. כדי להטמיע מפתחות שורה מובְנים בטבלה ב-Bigtable, אתם יכולים ליצור סכימה של מפתחות שורה שמגדירה את סוג הנתונים והקידוד של כל קטע במפתח השורה. מפתחות השורות מאוחסנים ב-Bigtable כבייטים שממוינים באופן לקסיקוגרפי, והסכימה של מפתחות השורות מציינת ל-GoogleSQL ל-Bigtable איך לפענח ולפרש את הבייטים האלה.
המערכת מתעלמת מסכימות של מפתחות שורות כששולחים שאילתה לטבלה באמצעות ה-method ReadRows של Bigtable Data API עם ספריית לקוח של Bigtable.
מידע נוסף זמין במאמרים ניהול סכימות של מפתחות שורות ושאילתות מובְנות של מפתחות שורות.
מפתחות שורות שכדאי להימנע מהם
סוגים מסוימים של מפתחות שורות יכולים להקשות על שליחת שאילתות לנתונים, וחלקם גורמים לביצועים נמוכים. בקטע הזה מתוארים כמה סוגים של מפתחות שורות שכדאי להימנע מלהשתמש בהם ב-Bigtable.
מפתחות שורות שמתחילים בחותמת זמן. התבנית הזו גורמת לכתיבה רציפה להידחף לצומת יחיד, מה שיוצר נקודה חמה. אם אתם מוסיפים חותמת זמן למפתח שורה, הוסיפו לפניה ערך בעל עוצמה גבוהה, כמו מזהה משתמש, כדי להימנע מנקודות חמות.
מפתחות שורות שגורמים לכך שנתונים קשורים לא מקובצים. הימנעו ממפתחות שורה שגורמים לאחסון של נתונים קשורים בטווחים של שורות לא רציפות, כי לא יעיל לקרוא אותם ביחד.
מזהים מספריים עוקבים. נניח שהמערכת שלכם מקצה מזהה מספרי לכל אחד מהמשתמשים באפליקציה. יכול להיות שתתפתו להשתמש במזהה המספרי של המשתמש כמפתח השורה בטבלה. עם זאת, מכיוון שמשתמשים חדשים נוטים יותר להיות משתמשים פעילים, הגישה הזו עשויה להעביר את רוב התנועה למספר קטן של צמתים.
גישה בטוחה יותר היא להשתמש בגרסה הפוכה של המזהה המספרי של המשתמש, שמפזרת את התנועה באופן שווה יותר בין כל הצמתים של טבלת Bigtable.
מזהים שמתעדכנים לעיתים קרובות. אל תשתמשו במפתח שורה אחד כדי לזהות ערך שצריך לעדכן לעיתים קרובות. לדוגמה, אם אתם מאחסנים נתוני שימוש בזיכרון של מספר מכשירים פעם בשנייה, אל תשתמשו במפתח שורה יחיד לכל מכשיר שמורכב ממזהה המכשיר ומהמדד שמאוחסן, כמו 4c410523#memusage, ותעדכנו את השורה שוב ושוב. פעולה מהסוג הזה מעמיסה על ה-tablet שבו מאוחסנת השורה שמשתמשים בה לעיתים קרובות. היא גם יכולה לגרום לשורה לחרוג ממגבלת הגודל שלה, כי הערכים הקודמים של העמודה תופסים מקום עד שהתאים מוסרים במהלך איסוף האשפה.
במקום זאת, שמרו כל קריאה חדשה בשורה חדשה. בדוגמה של השימוש בזיכרון, כל מפתח שורה יכול להכיל את מזהה המכשיר, סוג המדד וחותמת זמן, כך שמפתחות השורות דומים ל-4c410523#memusage#1423523569918. האסטרטגיה הזו יעילה כי ב-Bigtable, יצירת שורה חדשה לא אורכת יותר זמן מיצירת תא חדש. בנוסף, האסטרטגיה הזו מאפשרת לכם לקרוא במהירות נתונים מטווח תאריכים ספציפי, על ידי חישוב מפתחות ההתחלה והסיום המתאימים.
לערכים שמשתנים לעיתים קרובות, כמו מונה שמתעדכן מאות פעמים בכל דקה, מומלץ לשמור את הנתונים בזיכרון, בשכבת האפליקציה, ולכתוב שורות חדשות ב-Bigtable מדי פעם.
thought ערכים מגובבים (hashed). גיבוב של מפתח שורה מסיר את היכולת לנצל את סדר המיון הטבעי של Bigtable, ומונע אחסון של שורות באופן שמתאים לשאילתות. מאותה סיבה, גיבוב ערכים מקשה על השימוש בכלי Key Visualizer כדי לפתור בעיות ב-Bigtable. השתמשו בערכים קריאים לאנשים במקום בערכים מגובבים.
ערכים שמבוטאים כבייטים גולמיים ולא כמחרוזות קריאות לאנשים. אפשר להשתמש בבייטים גולמיים לערכי עמודות, אבל כדי לשפר את הקריאוּת ולפתור בעיות, כדאי להשתמש בערכי מחרוזות במפתחות שורה.
תרחישי שימוש מיוחדים
יכול להיות שיש לכם קבוצת נתונים ייחודית שדורשת התייחסות מיוחדת כשאתם מתכננים סכימה לאחסון שלה ב-Bigtable. בקטע הזה מתוארים חלק מסוגי הנתונים השונים של Bigtable, ומוצעות כמה שיטות לאחסון שלהם בצורה הכי אופטימלית.
נתונים מבוססי-זמן
אם אתם מאחזרים נתונים לעיתים קרובות על סמך הזמן שבו הם תועדו, אתם יכולים לכלול חותמת זמן כחלק ממפתח השורה.
לדוגמה, יכול להיות שהאפליקציה שלכם מתעדת נתונים שקשורים לביצועים, כמו שימוש ב-CPU ובזיכרון, פעם בשנייה במכונות רבות. מפתח השורה של הנתונים האלה יכול לשלב מזהה של המכונה עם חותמת זמן של הנתונים (לדוגמה, machine_4223421#1425330757685). חשוב לזכור שמפתחות השורות ממוינים באופן לקסיקוגרפי.
אם אתם כוללים חותמות זמן במפתח השורה, אל תשתמשו בחותמת זמן לבדה או בתחילת מפתח השורה. התבנית הזו גורמת לכך שכתיבות רציפות נדחפות לצומת יחיד, ויוצרות נקודה חמה.
אם בדרך כלל אתם מאחזרים את הרשומות האחרונות קודם בשאילתות, כדאי לשקול להשתמש בחותמות זמן הפוכות במפתח השורה. התבנית הזו גורמת לשורות להיות מסודרות מהחדשה ביותר לישנה ביותר, כך שהנתונים החדשים יותר מופיעים מוקדם יותר בטבלה. כמו בכל חותמת זמן, אל תתחילו מפתח שורה בחותמת זמן הפוכה כדי לא ליצור נקודות חמות.
כדי לקבל חותמת זמן הפוכה, מחסירים את חותמת הזמן מהערך המקסימלי של מספרים שלמים ארוכים בשפת התכנות (ב-Java, java.lang.Long.MAX_VALUE).
למידע ספציפי על עבודה עם נתונים של סדרות זמנים, ראו תכנון סכימה לנתונים של סדרות זמנים.
Multi-tenancy
תחיליות של מפתחות שורות מספקות פתרון שניתן להתאמה לתרחיש לדוגמה של "ריבוי דיירים", תרחיש שבו אתם מאחסנים נתונים דומים, באמצעות אותו מודל נתונים, בשם כמה לקוחות. שימוש בטבלה אחת לכל הדיירים היא הדרך היעילה ביותר לאחסן נתונים של כמה דיירים ולגשת אליהם.
לדוגמה, נניח שאתם שומרים היסטוריית רכישות ועוקבים אחריה בשביל הרבה חברות. אתם יכולים להשתמש במזהה הייחודי של כל חברה בתור תחילית של מפתח שורה. כל הנתונים של דייר מאוחסנים בשורות סמוכות באותה טבלה, ואפשר לשלוח שאילתות או לסנן באמצעות התחילית של מפתח השורה. אם חברה מסוימת מפסיקה להיות לקוחה שלכם ואתם צריכים למחוק את נתוני היסטוריית הרכישות ששמרתם בשבילה, אתם יכולים להסיר את טווח השורות שמשתמשות בתחילית של מפתח השורה של אותו לקוח.
לדוגמה, אם אתם מאחסנים נתונים של מכשירים ניידים של הלקוחות altostrat ו-examplepetstore, אתם יכולים ליצור מפתחות שורות כמו אלה: אם altostrat כבר לא לקוח שלכם, אתם יכולים למחוק את כל השורות עם הקידומת altostrat של מפתח השורה.
        altostrat#phone#4c410523#20190501
        altostrat#phone#4c410523#20190502
        altostrat#tablet#a0b41f74#20190501
        examplepetstore#phone#4c410523#20190502
        examplepetstore#tablet#a6b81f79#20190501
        examplepetstore#tablet#a0b81f79#20190502
לעומת זאת, אם אתם מאחסנים נתונים בשם כל חברה בטבלה משלה, אתם עלולים להיתקל בבעיות בביצועים ובמדרגיות. בנוסף, סביר יותר שתגיעו בטעות למגבלה של Bigtable, שהיא 1,000 טבלאות לכל מכונה. אחרי שמכונה מגיעה למגבלה הזו, Bigtable מונע מכם ליצור עוד טבלאות במכונה.
פרטיות
אלא אם תרחיש השימוש שלכם דורש זאת, אל תשתמשו בפרטים אישיים מזהים (PII) או בנתוני משתמשים במפתחות של שורות או במזהים של קבוצות עמודות. הערכים במפתחות השורות ובמשפחות העמודות הם גם נתוני לקוחות וגם נתוני שירות, ואפליקציות שמשתמשות בהם, כמו הצפנה או רישום ביומן, יכולות לחשוף אותם בטעות למשתמשים שלא אמורה להיות להם גישה לנתונים פרטיים.
בהודעת הפרטיות שלGoogle Cloud מוסבר איך אנחנו מטפלים בנתוני השירות.
שמות דומיין
אפשר לאחסן שמות של דומיינים כנתונים ב-Bigtable.
מגוון רחב של שמות דומיינים
אם אתם מאחסנים נתונים על ישויות שאפשר לייצג כשמות דומיינים, כדאי להשתמש בשם דומיין הפוך (לדוגמה, com.company.product) כמפתח השורה. שימוש בשם דומיין הפוך הוא רעיון טוב במיוחד אם הנתונים של כל שורה נוטים לחפוף לשורות סמוכות. במקרה כזה, Bigtable יכול לדחוס את הנתונים בצורה יעילה יותר.
לעומת זאת, שמות דומיינים רגילים שלא הפוכים יכולים לגרום למיון שורות באופן שבו נתונים קשורים לא מקובצים יחד במקום אחד, מה שיכול להוביל לדחיסה פחות יעילה ולקריאות פחות יעילות.
הגישה הזו יעילה במיוחד אם הנתונים שלכם מפוזרים על פני הרבה שמות דומיינים הפוכים.
כדי להמחיש את הנקודה הזו, נבחן את שמות הדומיינים הבאים, שממוינים אוטומטית בסדר לקסיקוגרפי על ידי Bigtable:
      drive.google.com
      en.wikipedia.org
      maps.google.com
זה לא רצוי בתרחיש לדוגמה שבו רוצים לשלוח שאילתה לכל השורות של google.com. לעומת זאת, נבחן את אותן שורות שבהן שמות הדומיינים הפוכים:
      com.google.drive
      com.google.maps
      org.wikipedia.en
בדוגמה השנייה, השורות הקשורות ממוינות באופן אוטומטי, כך שקל יותר לאחזר אותן כטווח של שורות.
מעט שמות דומיינים
אם אתם מתכננים לאחסן הרבה נתונים לשם דומיין אחד או למספר קטן של שמות דומיינים, כדאי לשקול ערכים אחרים למפתח השורה. אחרת, יכול להיות שתשלחו כתיבות לצומת יחיד באשכול, מה שיגרום לנקודות חמות, או שהשורות יהיו גדולות מדי.
אחסון נתונים בפורמט protobuf
כדי להפחית את עלויות האחסון ולשפר את יעילות הקריאה והכתיבה, אפשר לקבץ נתונים קשורים להודעת מאגר אחסון לפרוטוקולים (protobuf) ולאחסן אותה בעמודה אחת, במקום לאחסן כל שדה בעמודה משלו. אם אתם בדרך כלל קוראים קבוצה של שדות ביחד, כדאי לאחסן אותם בעמודה אחת כערך אחד, כי קריאה של עמודה אחת מהירה יותר מקריאה של הרבה עמודות נפרדות. אם אתם מאחסנים נתונים כהודעות protobuf, אתם יכולים להשתמש בתכונות הבאות של Bigtable:
- שימוש במאגרי אחסון לפרוטוקולים כדי לאחסן מבני נתונים גמישים מפחית את עלויות האחסון, כי הנתונים נשארים במקום ולא משוכפלים.
- העלאת הסכימה של ה-protobuf ל-Bigtable בחבילות סכימה מאפשרת שליחת שאילתות בצד השרת. חבילת הסכימה מאפשרת ל-Bigtable להבין ולנתח את המבנה של הנתונים שעברו סריאליזציה במהלך הרצת השאילתה.
- השימוש ב-GoogleSQL כדי לשלוח שאילתות ולסנן שדות ספציפיים בהודעות protobuf ישירות ב-Bigtable הוא מהיר ויעיל. כשמבטלים את ההמשכה של הנתונים בצד השרת, אפשר לבצע שאילתות והשלכות מפורטות בלי להעביר את כל אובייקט ה-protobuf ללקוח.
- שימוש בטבלאות חיצוניות של BigQuery כדי לנתח נתוני protobuf שמאוחסנים ב-Bigtable מאפשר לפשט את הניתוח.
מידע נוסף זמין במאמרים יצירה וניהול של סכימות protobuf ויצירה וניהול של סכימות Avro (גרסת טרום-השקה (Preview)).
המאמרים הבאים
- תכנון סכימה לנתוני סדרת זמנים
- סקירת השלבים לתכנון סכימה
- סוגי בקשות הכתיבה שאפשר לשלוח ל-Bigtable
- הטמעת מונים באמצעות תאים מצטברים
- בדיקת המכסות והמגבלות הרלוונטיות
- שליחת שאילתות לנתוני protobuf
- שליחת שאילתות לנתוני Avro