


Best Practices für Schemadesign
Mit einem effektiven Bigtable-Schema können Sie den Lese- und Schreibdurchsatz maximieren, Hotspots vermeiden und Ihren Speicher effizient skalieren. Bevor Sie beginnen, sollten Sie sich die Bigtable-Übersicht ansehen, um die zugrunde liegende Architektur und das Speichermodell zu verstehen.
Allgemeine Konzepte
Das Entwerfen eines Bigtable-Schemas unterscheidet sich vom Entwerfen eines Schemas für eine relationale Datenbank. Ein Bigtable-Schema wird durch die Anwendungslogik und nicht durch ein Schemadefinitionsobjekt oder eine Schemadefinitionsdatei definiert. Sie können einer Tabelle Spaltenfamilien hinzufügen, wenn Sie die Tabelle erstellen oder aktualisieren. Spalten und Zeilenschlüsselmuster werden jedoch durch die Daten definiert, die Sie in die Tabelle schreiben.
In Bigtable ist ein Schema ein Blueprint oder Modell einer Tabelle, einschließlich der Struktur der folgenden Tabellenkomponenten:
- Zeilenschlüssel
- Spaltenfamilien, einschließlich ihrer Richtlinien für die automatische Speicherbereinigung
- Spalten
In Bigtable wird das Schemadesign in erster Linie durch die Abfragen oder Leseanfragen bestimmt, die Sie an die Tabelle senden möchten. Da das Lesen eines Zeilenbereichs die schnellste Methode zum Lesen Ihrer Bigtable-Daten ist, sollen die Empfehlungen auf dieser Seite Ihnen helfen, die Lesevorgänge von Zeilenbereichen zu optimieren. In den meisten Fällen bedeutet das, dass eine Abfrage auf Grundlage von Zeilenschlüsselpräfixen gesendet wird.
Ein weiterer wichtiger Aspekt ist die Vermeidung von Hotspots. Um Hotspots zu vermeiden, müssen Sie Schreibmuster berücksichtigen und überlegen, wie Sie vermeiden können, in kurzer Zeit auf einen kleinen Schlüsselbereich zuzugreifen.
Die folgenden allgemeinen Konzepte gelten für das Schemadesign von Bigtable:
- Bigtable ist ein Schlüssel/Wert-Speicher, kein relationaler Speicher. Es unterstützt keine Joins und Transaktionen werden nur in einer einzelnen Zeile unterstützt.
- Jede Tabelle hat einen Index: den Zeilenschlüssel. Zeilenschlüssel dürfen jeweils nur einmal vorkommen. Verwenden Sie eine kontinuierliche materialisierte Ansicht, um einen sekundären Index zu erstellen. Weitere Informationen finden Sie unter Asynchronen sekundären Index erstellen.
- Zeilenschlüssel sortieren Zeilen lexikografisch vom niedrigsten zum höchsten Byte-String. Diese Reihenfolge ist Big-Endian (manchmal auch als Netzwerk-Bytereihenfolge bezeichnet), das binäre Äquivalent der alphabetischen Reihenfolge.
- Spaltenfamilien werden nicht in einer bestimmten Reihenfolge gespeichert.
- Spalten werden nach Spaltenfamilien gruppiert und in lexikografischer Reihenfolge innerhalb der Spaltenfamilie sortiert. Beispiel: In einer Spaltenfamilie mit dem Namen
SysMonitormit Spaltenqualifizierer vonProcessName,User,%CPU,ID,Memory,DiskReadundPriorityspeichert Bigtable die Spalten in folgender Reihenfolge:
| SysMonitor | ||||||
|---|---|---|---|---|---|---|
| %CPU | DiskRead | ID | Speicher | Priorität | ProcessName | Nutzer |
- Der Schnittpunkt einer Zeile und Spalte kann mehrere Zellen mit Zeitstempel enthalten. Jede Zelle enthält eine eindeutige Zeitstempelversion der Daten für diese Zeile und Spalte.
- Aggregat-Spaltenfamilien enthalten aggregierte Zellen. Sie können Spaltenfamilien erstellen, die nur aggregierte Zellen enthalten. Mit einem Aggregat können Sie neue Daten mit Daten zusammenführen, die sich bereits in der Zelle befinden.
- Alle Vorgänge sind auf Zeilenebene atomar. Ein Vorgang wirkt sich entweder auf die gesamte Zeile oder auf keinen Teil der Zeile aus.
- Über die Zeilen der Tabelle hinweg sollten Lese- und Schreibvorgänge idealerweise gleichmäßig verteilt sein.
- Bigtable-Tabellen sind "Sparse Tables". Eine Spalte belegt keinen Platz in einer Zeile, in der die Spalte nicht verwendet wird.
Best Practices
Ein gutes Schema führt zu exzellenter Leistung sowie Skalierbarkeit und ein schlechtes Schema kann zu einem System mit schwacher Leistung führen. Jeder Anwendungsfall ist anders und erfordert ein eigenes Design, für die meisten Anwendungsfälle gelten die folgenden Best Practices. Ausnahmen sind vermerkt.
In den folgenden Abschnitten werden, beginnend mit der Tabellenebene bis hinunter zur Ebene der Zeilenschlüssel, die Best Practices für den Schemaentwurf beschrieben:
Alle Tabellenelemente, insbesondere Zeilenschlüssel, sollten auf geplante Leseanfragen ausgelegt werden. Empfohlene und feste Größenlimits für alle Tabellenelemente finden Sie unter Kontingente und Limits.
Da alle Tabellen in einer Instanz auf denselben Tabellenreihen gespeichert sind, kann ein Schemadesign, das zu Heißlaufen in einer Tabelle führt, die Latenz anderer Tabellen in derselben Instanz beeinflussen. Hotspots werden durch häufigen Zugriff auf einen Teil der Tabelle in kurzer Zeit verursacht.
Tabellen
Datasets mit ähnlichen Schemas in derselben Tabelle speichern, nicht in separaten Tabellen.
In anderen Datenbanksystemen entscheiden Sie sich möglicherweise, Daten basierend auf dem Thema und der Anzahl der Spalten in mehreren Tabellen zu speichern. In Bigtable ist es jedoch in der Regel besser, alle Daten in einer Tabelle zu speichern. Sie können jedem Dataset ein eindeutiges Zeilenschlüsselpräfix zuweisen, sodass Bigtable die zugehörigen Daten in einem zusammenhängenden Bereich von Zeilen speichert, die Sie dann nach dem Präfix des Zeilenschlüssels abfragen können.
Bigtable hat ein Limit von 1.000 Tabellen pro Instanz. Wir empfehlen jedoch,nicht viele Tabellen zu erstellen, aus folgenden Gründen:
- Das Senden von Anfragen an viele verschiedene Tabellen kann den Aufwand der Backend-Verbindung erhöhen, was zu einem Anstieg der Extremwert-Latenz führt.
- Das Erstellen weiterer Tabellen verbessert das Load Balancing nicht und kann den Verwaltungsaufwand erhöhen.
Es kann natürlich vorkommen, dass Sie eine separate Tabelle für einen anderen Anwendungsfall brauchen, der ein anderes Schema erfordert, aber Sie sollten keine separaten Tabellen für ähnliche Daten verwenden. Sie sollten beispielsweise keine neue Tabelle erstellen, weil ein neues Jahr begonnen hat oder Sie einen neuen Kunden haben.
Spaltenfamilien
Legen Sie für verwandte Spalten dieselbe Spaltenfamilie fest. Wenn eine Zeile mehrere Werte enthält, die einen Bezug zueinander haben, empfiehlt es sich, die Spalten mit diesen Werten in derselben Spaltenfamilie zu gruppieren. Gruppieren Sie Daten so nah wie möglich beieinander, damit Sie keine komplexen Filter entwerfen müssen und in Ihren häufigsten Leseanfragen genau die Informationen erhalten, die Sie benötigen, aber nicht mehr.
Sie können bis zu 100 Spaltenfamilien pro Tabelle erstellen. Wenn Sie mehr als 100 Spaltenfamilien erstellen, kann das die Leistung beeinträchtigen.
Wählen Sie kurze Namen für Ihre Spaltenfamilien aus. Die Namen sind in den Daten enthalten, die bei jeder Anfrage übertragen werden.
Legen Sie für Spalten mit unterschiedlichen Datenaufbewahrungsanforderungen verschiedene Spaltenfamilien fest. Diese Vorgehensweise ist wichtig, wenn Sie die Speicherkosten in Grenzen halten möchten. Richtlinien für die automatische Speicherbereinigung werden auf der Ebene der Spaltenfamilie und nicht auf Spaltenebene festgelegt. Wenn Sie beispielsweise nur die neueste Version eines bestimmten Datenelements behalten möchten, speichern Sie diese nicht in einer Spaltenfamilie, in der 1.000 Versionen eines anderes Element gespeichert werden sollen. Andernfalls bezahlen Sie für das Speichern von 999 Zellen, die Sie nicht benötigen.
Spalten
Erstellen Sie in der Tabelle so viele Spalten wie nötig. Bigtable-Tabellen sind dünnbesetzt und es gibt keinen Speicherplatznachteil für eine Spalte, die nicht in einer Zeile verwendet wird. Sie können in einer Tabelle Millionen von Spalten angeben, solange keine Zeile das Limit von 256 MB pro Zeile überschreitet.
Vermeiden Sie zu viele Spalten in einer einzelnen Zeile. Eine Tabelle kann Millionen von Spalten haben, eine Zeile jedoch nicht. Diese Best Practice hat mehrere Gründe:
- Bigtable benötigt Zeit für die Verarbeitung der einzelnen Zellen in einer Zeile.
- Jede Zelle erhöht die Menge der Daten, die in Ihrer Tabelle gespeichert und über das Netzwerk gesendet werden. Wenn Sie beispielsweise 1 KB (1.024 Byte) an Daten speichern, ist es viel speichereffizienter, diese Daten in einer einzelnen Zelle zu speichern, anstatt sie auf 1.024 Zellen zu verteilen, die jeweils 1 Byte enthalten.
Wenn Ihr Dataset logisch mehrere Spalten pro Zeile benötigt, als Bigtable effizient verarbeiten kann, sollten Sie die Daten als protobuf in einer einzelnen Spalte speichern.
Optional können Sie Spaltenqualifizierer als Daten behandeln. Da Sie für jede Spalte einen Spaltenqualifizierer speichern müssen, können Sie Platz sparen, indem Sie die Spalte mit einem Wert benennen. Nehmen wir als Beispiel eine Tabelle, die Daten über Freundschaften in einer Spaltenfamilie Friends speichert. Jede Zeile steht für eine Person und alle ihre Freundschaften. Jeder Spaltenqualifizierer kann die ID eines Freundes sein. Der Wert für jede Spalte in dieser Zeile kann dann der soziale Kreis sein, dem der Freund angehört. In diesem Beispiel könnten die Zeilen so aussehen:
| Zeilenschlüssel | Fred | Gabriel | Hiroshi | Seo Yoon | Jakob |
|---|---|---|---|---|---|
| Jose | book-club | einfach mehr erreichen | Tennis | ||
| Sofia | einfach mehr erreichen | school | chess-club |
Vergleichen Sie dieses Schema mit einem Schema für dieselben Daten, in dem Spaltenqualifizierer nicht als Daten behandelt werden und stattdessen in jeder Zeile dieselben Spalten vorhanden sind:
| Zeilenschlüssel | Freund | Kreis |
|---|---|---|
| Jose#1 | Fred | book-club |
| Jose#2 | Gabriel | einfach mehr erreichen |
| Jose#3 | Hiroshi | Tennis |
| Sofia#1 | Hiroshi | einfach mehr erreichen |
| Sofia#2 | Seo Yoon | school |
| Sofia#3 | Jakob | chess-club |
Das zweite Schemadesign führt dazu, dass die Tabelle schneller wächst.
Wenn Sie zum Speichern von Daten Spaltenqualifizierer verwenden, erteilen Sie den Spaltenqualifizierern kurze, aber aussagekräftige Namen. So können Sie die Datenmenge reduzieren, die bei jeder Anfrage übertragen wird. Die maximale Größe beträgt 16 KB.
Zeilen
Die Größe aller Werte in einer einzelnen Zeile darf maximal 100 MB betragen. Die Daten in einer einzelnen Zeile dürfen 256 MB nicht überschreiten. Zeilen, die dieses Limit überschreiten, können zu einer geringeren Leseleistung führen.
Bewahren Sie alle Informationen für eine Entität in einer einzelnen Zeile auf. In den meisten Anwendungsfällen sollten Sie Daten, die Sie atomisch lesen müssen, oder alle gleichzeitig, in mehreren Zeilen speichern, um Inkonsistenzen zu vermeiden. Wenn Sie zum Beispiel zwei Zeilen in einer Tabelle aktualisieren, ist es möglich, dass eine Zeile erfolgreich aktualisiert wird und die andere nicht. Ihr Schema darf nicht mehr als eine Zeile gleichzeitig aktualisieren, damit ähnliche Daten korrekt sind. Diese Vorgehensweise stellt sicher, dass die Daten nicht vorübergehend unvollständig sind, wenn ein Teil einer Schreibanfrage fehlschlägt oder noch einmal gesendet werden muss.
Ausnahme: Wenn das Speichern einer Entität in einer einzelnen Zeile zu Zeilen mit mehreren MB führt, sollten Sie die Daten auf mehrere Zeilen aufteilen.
Speichern Sie verwandte Entitäten in benachbarten Zeilen, damit Lesevorgänge effizienter werden.
Zellen
Speichern Sie nicht mehr als 10 MB Daten in einer einzelnen Zelle. Denken Sie daran, dass eine Zelle die Daten umfasst, die für eine bestimmte Zeile und Spalte mit einem eindeutigen Zeitstempel gespeichert sind, und dass mehrere Zellen am Schnittpunkt dieser Zeile und Spalte gespeichert werden können. Die Anzahl der Zellen, die in einer Spalte beibehalten werden, unterliegt der Richtlinie für die automatische Speicherbereinigung, die Sie für die Spaltenfamilie festlegen, die diese Spalte enthält.
Aggregatzellen zum Speichern und Aktualisieren von aggregierten Daten verwenden Wenn Sie sich nur für den aggregierten Wert von Ereignissen für eine Entität interessieren, z. B. die monatliche Summe der Verkäufe pro Mitarbeiter in einem Einzelhandelsgeschäft, können Sie Aggregate verwenden. Weitere Informationen finden Sie unter Werte beim Schreiben aggregieren.
Zeilenschlüssel
Entwerfen Sie den Zeilenschlüssel basierend auf den Abfragen, mit denen Sie die Daten abrufen. Speziell konzipierte Zeilenschlüssel ermöglichen die optimale Leistung von Bigtable. Die effizientesten Bigtable-Abfragen rufen Daten mit einer der folgenden Optionen ab:
- Zeilenschlüssel
- Zeilenschlüsselpräfix
- Zeilenbereich, der durch den Start und das Ende der Zeilenschlüssel definiert wird
Andere Arten von Abfragen lösen einen Scan der gesamten Tabelle aus, was deutlich weniger effizient ist. Wenn Sie von vornherein den richtigen Zeilenschlüssel wählen, verhindern Sie, dass Sie später mühsam Daten migrieren müssen.
Begrenzen Sie die Größe des Zeilenschlüssels. Ein Zeilenschlüssel darf maximal 4 KB groß sein. Lange Zeilenschlüssel benötigen zusätzlichen Arbeitsspeicher und Speicherplatz und verlängern die Zeit, die benötigt wird, um Antworten vom Bigtable-Server zu erhalten.
Speichern Sie mehrere durch Trennzeichen getrennte Werte in den einzelnen Zeilenschlüsseln. Die effizienteste Methode zum effizienten Abfragen von Bigtable ist der Zeilenschlüssel. Daher ist es oft nützlich, mehrere Kennungen in Ihren Zeilenschlüssel aufzunehmen. Wenn Ihr Zeilenschlüssel mehrere Werte enthält, ist es besonders wichtig, ein klares Verständnis von der Verwendung der Daten zu haben.
Zeilenschlüsselsegmente werden normalerweise durch ein Trennzeichen getrennt, z. B. einen Doppelpunkt, einen Schrägstrich oder ein Rautezeichen. Das erste Segment oder die erste Gruppe zusammenhängender Segmente ist das Präfix des Zeilenschlüssels und das letzte Segment oder die letzte Gruppe zusammenhängender Segmente ist das Suffix des Zeilenschlüssels.
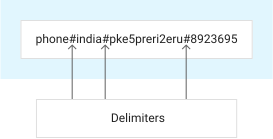
Mit gut geplanten Zeilenschlüsselpräfixen können Sie die integrierte Sortierreihenfolge von Bigtable nutzen, um zusammengehörige Daten in zusammenhängenden Zeilen zu speichern. Das Speichern zusammengehöriger Daten in angrenzenden Zeilen bietet Ihnen die Möglichkeit, auf verwandte Daten als Zeilenbereich zuzugreifen und keine ineffiziente Tabellensuche ausführen zu müssen.
Wenn Ihre Daten Ganzzahlen enthalten, die Sie numerisch speichern oder sortieren möchten, versehen Sie die Ganzzahlen mit vorangestellten Nullen auf. Bigtable speichert Daten lexikografisch. Beispiel: lexikografisch, 3 > 20, aber 20 > 03. Wenn Sie die Drei mit einer vorangestellten Null versehen, werden die Zahlen numerisch sortiert. Diese Taktik ist für Zeitstempel wichtig, in denen bereichsbasierte Abfragen genutzt werden.
Es ist wichtig, einen Zeilenschlüssel zu erstellen, mit dem ein klar definierter Zeilenbereich abgerufen werden kann. Andernfalls erfordert Ihre Abfrage einen Tabellenscan, der viel langsamer ist als das Abrufen bestimmter Zeilen.
Wenn Ihre Anwendung beispielsweise Mobilgerätedaten erfasst, können Sie einen Zeilenschlüssel haben, der aus dem Gerätetyp, der Geräte-ID und dem Tag besteht, an dem die Daten aufgezeichnet werden. Zeilenschlüssel für diese Daten können so aussehen:
        phone#4c410523#20200501
        phone#4c410523#20200502
        tablet#a0b81f74#20200501
        tablet#a0b81f74#20200502
Mit diesem Zeilenschlüssel-Design können Sie Daten mit einer einzigen Anfrage für Folgendes abrufen:
- Einen Gerätetyp
- Eine Kombination aus Gerätetyp und Geräte-ID
Dieses Zeilenschlüsseldesign ist nicht ideal, wenn Sie alle Daten für einen bestimmten Tag abrufen möchten. Da der Tag im dritten Segment oder im Suffix des Zeilenschlüssels gespeichert wird, können Sie nicht einfach einen Zeilenbereich anhand des Suffixes oder des mittleren Abschnitts des Zeilenschlüssels anfordern. Stattdessen müssen Sie eine Leseanfrage mit einem Filter senden, der die gesamte Tabelle auf den Tageswert hin scannt.
Verwenden Sie nach Möglichkeit menschenlesbare Stringwerte in Ihren Zeilenschlüsseln. Diese Vorgehensweise erleichtert die Verwendung des Key Visualizer-Tools zum Beheben von Problemen mit Bigtable.
Oft sollten Sie Zeilenschlüssel entwerfen, die mit einem häufig verwendeten Wert beginnen und mit einem detaillierten Wert enden. Wenn Ihr Zeilenschlüssel beispielsweise einen Kontinent, ein Land und eine Stadt enthält, können Sie Zeilenschlüssel erstellen, die folgendermaßen aussehen, sodass sie zuerst automatisch nach Werten mit einer niedrigen Kardinalität sortiert werden:
        asia#india#bangalore
        asia#india#mumbai
        asia#japan#osaka
        asia#japan#sapporo
        southamerica#bolivia#cochabamba
        southamerica#bolivia#lapaz
        southamerica#chile#santiago
        southamerica#chile#temuco
Strukturierte Zeilenschlüssel
Wenn Sie Ihre Tabelle mit SQL abfragen möchten, können Sie strukturierte Zeilenschlüssel definieren, mit denen Sie über mehrteilige Schlüssel auf Ihre Bigtable-Daten zugreifen können. Das ist ähnlich wie bei zusammengesetzten Schlüsseln in relationalen Datenbanken. Wenn Sie strukturierte Zeilenschlüssel für eine Tabelle definieren, können Sie mit GoogleSQL für Bigtable-Abfragen auf bestimmte Segmente der Zeilenschlüssel zugreifen.
Strukturierte Zeilenschlüssel werden automatisch erstellt, wenn Sie eine kontinuierliche materialisierte Ansicht erstellen. Wenn Sie strukturierte Zeilenschlüssel für eine Bigtable-Tabelle implementieren möchten, können Sie ein Zeilenschlüsselschema erstellen, das den Datentyp und die Codierung jedes Segments des Zeilenschlüssels definiert. In Bigtable werden die Zeilenschlüssel als lexikografisch sortierte Bytes gespeichert. Das Zeilenschlüssel-Schema gibt GoogleSQL for Bigtable an, wie diese Bytes decodiert und interpretiert werden.
Zeilenschlüssel-Schemas werden ignoriert, wenn Sie die Tabelle mit der Bigtable Data API-Methode ReadRows und einer Bigtable-Clientbibliothek abfragen.
Weitere Informationen finden Sie unter Schemas für Zeilenschlüssel verwalten und Strukturierte Abfragen für Zeilenschlüssel.
Zu vermeidende Zeilenschlüssel
Einige Arten von Zeilenschlüsseln können das Abfragen Ihrer Daten erschweren und andere die Leistung beeinträchtigen. In diesem Teil werden einige Arten von Zeilenschlüsseln beschrieben, deren Verwendung Sie in Bigtable vermeiden sollten.
Zeilenschlüssel, die mit einem Zeitstempel beginnen: Dieses Muster bewirkt, dass sequenzielle Schreibvorgänge auf einen einzelnen Knoten übertragen werden, wodurch ein Heißlaufen verursacht wird. Wenn Sie einen Zeitstempel in einen Zeilenschlüssel einfügen, stellen Sie ihm einen Wert mit hoher Kardinalität wie eine Nutzer-ID voran, um ein Heißlaufen zu vermeiden.
Zeilenschlüssel, die dazu führen, dass ähnliche Daten nicht gruppiert werden: Vermeiden Sie Zeilenschlüssel, bei denen verwandte Daten in nicht zusammenhängenden Zeilenbereichen gespeichert werden, da diese nicht effizient gelesen werden können.
Sequenzielle numerische IDs. Angenommen, Ihr System vergibt eine numerische ID an jeden Nutzer Ihrer Anwendung. Es mag in diesem Fall bequem erscheinen, die numerische ID der Nutzer als Zeilenschlüssel für Ihre Tabelle zu verwenden. Da neue Nutzer jedoch wahrscheinlich aktiver sind, verschiebt diese Herangehensweise den Großteil Ihres Traffics auf wenige Knoten.
Eine sicherere Herangehensweise wäre es, eine umgekehrte Version der numerischen ID der Nutzer zu verwenden. Dadurch verteilt sich der Traffic gleichmäßiger auf die Knoten Ihrer Bigtable-Tabelle.
Häufig aktualisierte IDs. Vermeiden Sie die Verwendung eines einzelnen Zeilenschlüssels zur Identifizierung eines Wertes, der oft aktualisiert werden muss. Wenn Sie z. B. Daten zur Speichernutzung für eine Reihe von Geräten einmal pro Sekunde speichern, verwenden Sie nicht für jedes Gerät einen einzelnen Zeilenschlüssel, der sich aus der Geräte-ID und dem zu speichernden Messwert zusammensetzt, wie z. B. 4c410523#memusage, und aktualisieren Sie die Zeile wiederholt. Diese Art von Vorgang überlastet das Tablet, in dem die häufig verwendete Zeile gespeichert ist. Außerdem kann es dazu führen, dass eine Zeile ihr Größenlimit überschreitet, da die vorherigen Werte einer Spalte Speicherplatz belegen, bis die Zellen bei der Garbage Collection entfernt werden.
Speichern Sie stattdessen jeden neuen Lesevorgang in einer neuen Zeile. Im Beispiel zur Arbeitsspeichernutzung kann jeder Zeilenschlüssel die Geräte-ID, den Messwerttyp und einen Zeitstempel enthalten. Die Zeilenschlüssel ähneln also 4c410523#memusage#1423523569918. Diese Strategie ist effizient, da das Erstellen einer neuen Zeile in Bigtable nicht länger dauert als das Erstellen einer neuen Zelle. Außerdem können Sie durch diese Strategie schnell Daten aus einem bestimmten Zeitraum lesen, indem Sie die passenden Start- und Endschlüssel berechnen.
Für Werte, die sich häufig ändern, wie zum Beispiel ein Zähler, der sich hunderte Male pro Minute aktualisiert, ist es am besten, die Daten im Speicher zu lassen, auf der Anwendungsebene, und periodisch neue Zeilen in Bigtable zu schreiben.
Hashwerte Durch das Hashing eines Zeilenschlüssels können Sie nicht mehr von den Vorteilen der natürlichen Sortierreihenfolge von Bigtable profitieren, sodass Zeilen nicht so gespeichert werden können, wie es für Abfragen optimal wäre. Aus demselben Grund ist es schwierig, das Key Visualizer-Tool zum Beheben von Problemen mit Bigtable zu verwenden, wenn Werte gehasht werden. Verwenden Sie lesbare Werte anstelle von gehashten Werten.
Werte werden als Rohbyte und nicht als menschenlesbare Strings ausgedrückt. Rohbyte eignen sich gut für Spaltenwerte. Verwenden Sie zur Verbesserung der Lesbarkeit und Fehlerbehebung jedoch Stringwerte in Zeilenschlüsseln.
Besondere Anwendungsfälle
Möglicherweise haben Sie ein einzigartiges Dataset, auf das beim Entwerfen eines Schemas für die Speicherung in Bigtable besonderes Augenmerk gelegt werden muss. In diesem Abschnitt werden einige, aber nicht alle unterschiedlichen Arten von Bigtable-Daten sowie einige empfohlene Speicherpraktiken beschrieben.
Zeitbasierte Daten
Wenn Sie häufig Daten nach dem Zeitpunkt der Aufzeichnung abrufen, können Sie einen Zeitstempel als Teil Ihres Zeilenschlüssels einfügen.
Ihre Anwendung erfasst beispielsweise einmal pro Sekunde leistungsbezogene Daten wie CPU- und Arbeitsspeichernutzung für viele Maschinen. Ihr Zeilenschlüssel für diese Daten könnte eine Kennzeichnung für die Maschine mit einem Zeitstempel für die Daten kombinieren (z. B. machine_4223421#1425330757685). Denken Sie daran, dass die Zeilenschlüssel lexikografisch sortiert sind.
Wenn Sie Zeitstempel in den Zeilenschlüssel einfügen, verwenden Sie keinen Zeitstempel allein oder am Anfang eines Zeilenschlüssels. Dieses Muster bewirkt, dass sequenzielle Schreibvorgänge auf einen einzelnen Knoten übertragen werden, wodurch ein Hotspot entsteht.
Wenn Sie in Ihren Abfragen in der Regel die am kürzesten zurückliegenden Aufzeichnungen zuerst abrufen, können Sie umgekehrte Zeitstempel im Zeilenschlüssel verwenden. Durch dieses Muster werden die Zeilen vom neuesten zum ältesten sortiert, sodass neuere Daten weiter oben in der Tabelle stehen. Wie bei jedem Zeitstempel sollten Sie vermeiden, einen Zeilenschlüssel mit einem umgekehrten Zeitstempel zu beginnen, um Hotspots zu vermeiden.
Sie können einen umgekehrten Zeitstempel abrufen, indem Sie den Zeitstempel vom Maximalwert Ihrer Programmiersprache für lange Ganzzahlen abziehen (in Java: java.lang.Long.MAX_VALUE).
Informationen zum Arbeiten mit Zeitreihendaten finden Sie unter Schemadesign für Zeitreihendaten.
Mehrinstanzenfähigkeit
Zeilenschlüsselpräfixe bieten eine skalierbare Lösung für einen Anwendungsfall mit erforderlicher Mehrinstanzenfähigkeit. In einem solchen Szenario werden ähnliche Daten mit dem gleichen Datenmodell für mehrere Clients gespeichert. Die Verwendung einer Tabelle für alle Mandanten ist die leistungsstärkste Methode für das Speichern und Zugreifen auf Daten mehrerer Mandanten.
Angenommen, Sie speichern und verfolgen den Bestellverlauf für viele Unternehmen. Dabei können Sie Ihre eindeutige ID für jedes Unternehmen als Zeilenschlüsselpräfix nutzen. Alle Daten für einen Mandanten werden in zusammenhängenden Zeilen in derselben Tabelle gespeichert, und Sie können anhand des Zeilenschlüsselpräfixes abfragen oder filtern. Wenn dann ein Unternehmen nicht mehr zu Ihren Kunden gehört und Sie die Bestellverlaufsdaten löschen müssen, die Sie für das Unternehmen gespeichert haben, können Sie dafür den Zeilenbereich löschen, für den der Zeilenschlüsselpräfix dieses Kunden verwendet wird.
Wenn Sie beispielsweise die Daten von Mobilgeräten der Kunden altostrat und examplepetstore speichern, können Sie folgende Zeilenschlüssel erstellen. Wenn dann altostrat nicht mehr Ihr Kunde ist, werden alle Zeilen mit dem Zeilenschlüsselpräfix altostrat gelöscht.
        altostrat#phone#4c410523#20190501
        altostrat#phone#4c410523#20190502
        altostrat#tablet#a0b41f74#20190501
        examplepetstore#phone#4c410523#20190502
        examplepetstore#tablet#a6b81f79#20190501
        examplepetstore#tablet#a0b81f79#20190502
Wenn Sie Daten für jedes Unternehmen in einer eigenen Tabelle speichern, kann es dagegen zu Leistungs- und Skalierbarkeitsproblemen kommen. Außerdem wird dann oft ungewollt die Grenze von Bigtable von 1.000 Tabellen pro Instanz überschritten. Nachdem eine Instanz dieses Limit erreicht hat, können Sie in Bigtable keine weiteren Tabellen in der Instanz erstellen.
Datenschutz
Sofern Ihr Anwendungsfall dies nicht erfordert, sollten Sie keine personenidentifizierbaren Informationen oder Nutzerdaten in Zeilenschlüsseln oder Spaltenfamilien-IDs verwenden. Die Werte in Zeilenschlüsseln und Spaltenfamilien sind sowohl Kundendaten als auch Dienstdaten. Anwendungen, die sie verwenden, z. B. Verschlüsselung oder Protokollierung, können sie versehentlich Nutzern zugänglich machen, die keinen Zugriff auf private Daten haben sollten.
Weitere Informationen zum Umgang mit Dienstdaten finden Sie in der Google Cloud-Datenschutzerklärung.
Domainnamen
Sie können Domainnamen als Bigtable-Daten speichern.
Große Bereich von Domainnamen
Sollten Sie Daten über Entitäten speichern, die als Domainnamen dargestellt werden können, ist es sinnvoll, als Zeilenschlüssel einen umgekehrten Domainnamen zu verwenden (z. B. com.company.product). Dies ist besonders dann zu empfehlen, wenn die Daten in den einzelnen Zeilen sich häufiger mit denen in benachbarten Zeilen überschneiden. In diesem Fall kann Bigtable Ihre Daten besser komprimieren.
Im Gegensatz dazu können Standarddomainnamen, die nicht umgekehrt werden, so sortiert werden, dass zusammengehörige Daten an einem Ort gruppiert werden. Dies kann zu einer weniger effizienten Komprimierung und zu weniger effizienten Lesevorgängen führen.
Diese Vorgehensweise funktioniert außerdem am besten, wenn Ihre Daten über viele verschiedene umgekehrte Domainnamen verteilt sind.
Betrachten Sie zur Veranschaulichung dieses Punkts die folgenden Domainnamen, die automatisch in lexikografischer Reihenfolge von Bigtable sortiert werden:
      drive.google.com
      en.wikipedia.org
      maps.google.com
Das ist nicht sinnvoll für den Anwendungsfall, in dem Sie alle Zeilen für google.com abfragen möchten. Betrachten Sie im Gegensatz dazu dieselben Zeilen, in denen die Domainnamen umgekehrt wurden:
      com.google.drive
      com.google.maps
      org.wikipedia.en
Im zweiten Beispiel werden die zugehörigen Zeilen automatisch so sortiert, dass sie leichter als Zeilenbereich abgerufen werden können.
Wenige Domainnamen
Wenn Sie davon ausgehen, dass nur eine oder eine kleine Anzahl von Domainnamen gespeichert werden sollen, sollten Sie andere Werte für Ihren Zeilenschlüssel verwenden. Andernfalls werden Schreibvorgänge unter Umständen auf einen einzelnen Knoten im Cluster übertragen. Dies kann einerseits zu Heißlaufen führen und andererseits dazu, dass Ihre Zeilen zu groß werden.
Daten im Protobuf-Format speichern
Um die Speicherkosten zu senken und die Lese- und Schreibeffizienz zu verbessern, können Sie zusammengehörige Daten in einer Protobuf-Nachricht gruppieren und in einer einzelnen Spalte speichern, anstatt jedes Feld in einer eigenen Spalte zu speichern. Wenn Sie in der Regel eine Reihe von Feldern zusammen lesen, ist es effizienter, sie als einen Wert in einer einzelnen Spalte zu speichern, da das Lesen einer einzelnen Spalte schneller ist als das Lesen vieler einzelner Spalten. Wenn Sie Daten als Protobuf-Nachrichten speichern, können Sie die folgenden Bigtable-Funktionen nutzen:
- Durch die Verwendung von Protocol Buffers zum Speichern flexibler Datenstrukturen werden die Speicherkosten gesenkt, da Ihre Daten an ihrem ursprünglichen Speicherort verbleiben und Duplikate vermieden werden.
- Wenn Sie Ihr Protobuf-Schema in Schemabundles in Bigtable hochladen, können Sie serverseitige Abfragen ausführen. Mit dem Schemabundle kann Bigtable die Struktur Ihrer serialisierten Daten während der Ausführung von Abfragen verstehen und parsen.
- Mit GoogleSQL können Sie einzelne Felder in Ihren Protobuf-Nachrichten direkt in Bigtable abfragen und filtern. Das ist schnell und effizient. Durch die Deserialisierung der Daten auf der Serverseite können Sie detaillierte Abfragen und Projektionen durchführen, ohne das gesamte Protobuf-Objekt an Ihren Client übertragen zu müssen.
- Wenn Sie externe BigQuery-Tabellen verwenden, um in Bigtable gespeicherte Protobuf-Daten zu analysieren, können Sie Ihre Analysen vereinfachen.
Weitere Informationen finden Sie unter Protobuf-Schemas erstellen und verwalten.
Nächste Schritte
- Schema für Zeitreihendaten entwerfen
- Schritte zur Planung eines Schemas
- Informationen zu den Arten von Schreibanfragen, die Sie an Bigtable senden können.
- Zähler mit Sammelzellen implementieren
- Geltende Kontingente und Limits ansehen.
- Protobuf-Daten abfragen: