


結構定義設計最佳做法
有效的 Bigtable 結構定義可讓您盡量提高讀取和寫入輸送量、避免熱點,並有效率地擴充儲存空間。開始之前,請先參閱 Bigtable 總覽,瞭解基礎架構和儲存空間模型。
基本概念
設計 Bigtable 結構定義與設計關聯式資料庫的結構定義不同。Bigtable 結構定義是由應用程式邏輯定義,而非結構定義物件或檔案。建立或更新資料表時,您可以將資料欄系列新增至資料表,但資料欄和資料列索引鍵模式是由您寫入資料表的資料定義。
在 Bigtable 中,結構定義是資料表的藍圖或模型,包括下列資料表元件的結構:
- 資料列索引鍵
- 資料欄系列,包括垃圾收集政策
- 資料欄
在 Bigtable 中,結構定義設計主要取決於您打算傳送至資料表的查詢或讀取要求。因為讀取資料列範圍是讀取 Bigtable 資料最快的方式,所以本頁的建議旨在協助您針對資料列範圍讀取作業進行最佳化。在大多數情況下,這表示要根據資料列索引鍵前置字串傳送查詢。
其次是避免熱點,如要避免熱點,您必須考量寫入模式,以及如何避免在短時間內存取小鍵空間。
下列一般概念適用於 Bigtable 結構定義設計:
- Bigtable 是鍵/值儲存空間,而非關聯式儲存空間。不支援聯結,且僅支援單一資料列內的交易。
- 每個資料表都有索引:資料列索引鍵。每個資料列索引鍵都必須是唯一的。如要建立次要索引,請使用持續性 materialized view。詳情請參閱「建立非同步次要索引」。
- 資料列索引鍵會依字典順序排序資料列,從最低到最高位元組字串。這個順序為大端序 (有時稱為網路位元組順序),相當於字母順序的二進位表示法。
- 資料欄系列不會以任何特定順序儲存。
- 資料欄會依資料欄系列分組,並在資料欄系列中依字典順序排序。舉例來說,在名為
SysMonitor的資料欄系列中,如果資料欄限定詞為ProcessName、User、%CPU、ID、Memory、DiskRead和Priority,Bigtable 會依下列順序儲存資料欄:
| SysMonitor | ||||||
|---|---|---|---|---|---|---|
| %CPU | DiskRead | ID | 記憶體 | 優先順序 | ProcessName | 使用者 |
- 資料列與資料欄的交集可以包含多個加上時間戳記的儲存格。每個儲存格都包含該列和資料欄的資料版本,並附上時間戳記。
- 匯總資料欄系列包含匯總儲存格。您可以建立只包含匯總儲存格的資料欄系列。匯總功能可將新資料與儲存格中現有的資料合併。
- 所有作業在資料列層級都是不可分割的。作業會影響整列,或完全不影響該列。
- 理想情況下,讀取和寫入作業應平均分配到資料表的列空間中。
- Bigtable 資料表空間稀疏。如果資料列未使用資料欄,該資料欄就不會佔用任何空間。
最佳做法
良好的結構定義可帶來優異的效能和擴充性,設計不良的結構定義則可能導致系統效能不佳。每個用途都不盡相同,需要各自的設計,但下列最佳做法適用於大多數用途。如有任何例外狀況,我們會另外註明。
以下各節將從資料表層級開始,逐步說明結構定義設計的最佳做法,直到資料列索引鍵層級:
設計所有表格元素時,尤其是資料列索引鍵,應考量規劃的讀取要求。請查看所有表格元素的建議和硬性大小限制配額和限制。
由於執行個體中的所有資料表都儲存在相同的平板電腦上,因此如果某個資料表的結構設計導致熱點,可能會影響同一執行個體中其他資料表的延遲。如果短時間內經常存取表格的某個部分,就會造成熱點。
Tables
將具有類似結構定義的資料集儲存在同一個資料表,而不是分開儲存。
在其他資料庫系統中,您可能會根據主題和資料欄數量,選擇將資料儲存在多個資料表中。不過,在 Bigtable 中,最好將所有資料儲存在一個資料表。您可以為每個資料集指派專屬的資料列索引鍵前置字串,這樣 Bigtable 就會將相關資料儲存在連續的資料列範圍中,方便您透過資料列索引鍵前置字串查詢。
每個執行個體的 Bigtable 資料表上限為 1,000 個,但基於下列原因,我們建議您避免建立大量資料表:
- 如果將要求傳送至許多不同的資料表,可能會增加後端連線的負荷,導致尾端延遲時間增加。
- 建立更多表格不會改善負載平衡,反而會增加管理負擔。
如果不同用途需要不同的結構定義,您可能需要使用不同的資料表,但類似的資料不應使用不同的資料表。舉例來說,您不應因為新的一年到來或有新客戶,就建立新的資料表。
資料欄系列
將相關資料欄放在同一個資料欄系列。如果資料列包含多個相關值,建議您將含有這些值的資料欄歸入同一個資料欄系列。盡可能將資料分組,避免設計複雜的篩選器,並在最常執行的讀取要求中,只取得所需資訊。
每個資料表最多可建立約 100 個資料欄系列。 建立超過 100 個資料欄系列可能會導致效能下降。
為資料欄系列選擇簡稱。系統會將名稱納入每個要求轉移的資料中。
將資料保留需求不同的資料欄放在不同的資料欄系列中。如要控管儲存空間費用,請務必採用這項做法。 垃圾收集政策是在資料欄系列層級設定,而非資料欄層級。舉例來說,如果您只需要保留特定資料的最新版本,請勿將該資料儲存在設定為儲存 1,000 個其他項目版本的資料欄系列中。否則,您將支付儲存 999 個不需要的資料格費用。
資料欄
在表格中建立所需欄數。Bigtable 資料表空間稀疏,且如果資料列未使用某個資料欄,就不會受到空間限制。只要資料列不超過每列 256 MB 的上限,資料表就能包含數百萬個資料欄。
避免在單一列中使用過多欄。雖然資料表可以有數百萬個資料欄,但資料列不應有這麼多。這項最佳做法有以下幾項優點:
- Bigtable 處理資料列中的每個儲存格需要時間。
- 每個儲存格都會增加儲存在表格中和透過網路傳送的資料量。舉例來說,如果您要儲存 1 KB (1,024 位元組) 的資料,將資料儲存在單一儲存格中,會比將資料分散到 1,024 個各含 1 個位元組的儲存格中,更節省空間。
如果資料集在邏輯上需要比 Bigtable 能有效處理的更多資料欄,請考慮將資料儲存為單一資料欄中的 protobuf。
您可以選擇將資料欄限定詞視為資料。由於您必須為每個資料欄儲存資料欄限定詞,因此可以將資料欄命名為值,藉此節省空間。舉例來說,假設有一個資料表,其中儲存了 Friends 資料欄系列中的友誼資料。每一列代表一個人及其所有友誼。每個資料欄限定詞可以是好友的 ID。然後,該列中每個資料欄的值可以是好友所屬的社交圈。在這個範例中,資料列可能如下所示:
| 資料列索引鍵 | Fred | Gabriel | Hiroshi | Seo Yoon | Jakob |
|---|---|---|---|---|---|
| Jose | book-club | 公司 | 網球 | ||
| 索非亞 | 公司 | school | chess-club |
請比較這個結構定義與相同資料的結構定義,後者「不會」將資料欄限定符視為資料,而是每個資料列都有相同的資料欄:
| 資料列索引鍵 | 好友 | 圓形 |
|---|---|---|
| Jose#1 | Fred | book-club |
| Jose#2 | Gabriel | 公司 |
| Jose#3 | Hiroshi | 網球 |
| Sofia#1 | Hiroshi | 公司 |
| Sofia#2 | Seo Yoon | school |
| Sofia#3 | Jakob | chess-club |
第二個結構定義設計會導致資料表成長速度快上許多。
如果使用資料欄限定詞儲存資料,請為資料欄限定詞提供簡短但有意義的名稱。這種做法可減少每個要求傳輸的資料量。大小上限為 16 KB。
資料列
單一列中所有值的大小不得超過 100 MB。請確認單一資料列中的資料未超過 256 MB。如果資料列超過這個上限,讀取效能可能會降低。
將實體的所有資訊放在同一列。在大多數情況下,請避免將必須以不可分割方式讀取或一次讀取的資料,儲存在多個資料列中,以免發生不一致的情況。舉例來說,如果您更新表格中的兩列,其中一列可能更新成功,另一列則更新失敗。請確認結構定義不會要求同時更新多列,以確保相關資料的準確度。這麼做可確保寫入要求的部分內容失敗或必須重新傳送時,該資料不會暫時不完整。
例外狀況:如果將實體保留在單一資料列中,會導致資料列大小達到數百 MB,請將資料分割到多個資料列。
將相關實體儲存在相鄰的資料列中,提高讀取效率。
儲存格
請勿在單一儲存格中儲存超過 10 MB 的資料。請注意,儲存格是針對特定資料列和資料欄儲存的資料,且具有專屬時間戳記,而該資料列和資料欄的交集可以儲存多個儲存格。資料欄中保留的儲存格數量,取決於您為包含該資料欄的資料欄系列設定的垃圾收集政策。
使用匯總儲存格儲存及更新匯總資料。如果您只關心實體的事件匯總值,例如零售商店每位員工的每月銷售總額,可以使用匯總。詳情請參閱「在寫入時匯總值」。
資料列索引鍵
根據要用來擷取資料的查詢,設計資料列索引鍵。設計完善的資料列索引鍵可讓 Bigtable 發揮最佳效能。 最有效率的 Bigtable 查詢會使用下列其中一種方法擷取資料:
- 資料列索引鍵
- 資料列索引鍵前置字串
- 由起始和結束資料列索引鍵定義的資料列範圍
其他類型的查詢會觸發完整資料表掃描,效率較低。 現在選擇正確的資料列索引鍵,日後就能避免痛苦的資料遷移程序。
縮短資料列索引鍵。資料列索引鍵不得超過 4 KB。較長的資料列索引鍵會佔用額外的記憶體和儲存空間,並增加從 Bigtable 伺服器取得回應所需的時間。
在每個資料列索引鍵中儲存多個以分隔符號區隔的值。因為查詢 Bigtable 的最佳方式是使用資料列索引鍵,所以通常會在資料列索引鍵中加入多個 ID。如果資料列索引鍵包含多個值,請務必清楚瞭解資料的使用方式。
資料列索引鍵區隔通常會以分隔符號分隔,例如半形冒號、斜線或井號。第一個區隔或一組連續區隔是資料列索引鍵前置字元,最後一個區隔或一組連續區隔則是資料列索引鍵後置字元。
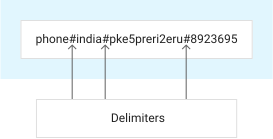
妥善規劃資料列索引鍵前置字元,即可利用 Bigtable 的內建排列順序,將相關資料儲存在連續資料列中。將相關資料儲存在連續資料列中,可讓您以資料列範圍的形式存取相關資料,而不必執行效率不彰的資料表掃描。
如果資料包含要以數值方式儲存或排序的整數,請在整數開頭填入零。Bigtable 會依字典順序儲存資料。舉例來說,以字典順序而言,3 > 20,但 20 > 03。在 3 前方加上零,可確保系統依數值排序數字。如果使用以範圍為準的查詢,這項策略就非常重要。
請務必建立資料列索引鍵,以便擷取明確定義的資料列範圍。否則查詢需要掃描資料表,這比擷取特定資料列慢得多。
舉例來說,如果應用程式會追蹤行動裝置資料,您可以建立由裝置類型、裝置 ID 和資料記錄日期組成的資料列鍵。這類資料的資料列索引鍵可能如下所示:
        phone#4c410523#20200501
        phone#4c410523#20200502
        tablet#a0b81f74#20200501
        tablet#a0b81f74#20200502
這個資料列索引鍵設計可讓您透過單一要求擷取下列資料:
- 裝置類型
- 裝置類型和裝置 ID 的組合
如果您想擷取特定日期的所有資料,這個資料列索引鍵設計就不是最佳選擇。由於日期儲存在第三個區隔或資料列索引鍵尾碼中,因此您無法只根據尾碼或資料列索引鍵的中間區隔要求資料列範圍。您必須改為傳送含有篩選條件的讀取要求,掃描整個資料表以尋找日期值。
盡可能在資料列索引鍵中使用人類可讀的字串值。這麼做可讓您更輕鬆地使用 Key Visualizer 工具,排解 Bigtable 的問題。
通常,您應設計以常見值開頭,並以精細值結尾的資料列索引鍵。舉例來說,如果資料列索引鍵包含洲、國家/地區和城市,您可以建立類似下列的資料列索引鍵,讓系統自動先依基數較低的值排序:
        asia#india#bangalore
        asia#india#mumbai
        asia#japan#osaka
        asia#japan#sapporo
        southamerica#bolivia#cochabamba
        southamerica#bolivia#lapaz
        southamerica#chile#santiago
        southamerica#chile#temuco
結構化資料列索引鍵
如果您打算使用 SQL 查詢資料表,可以定義結構化資料列索引鍵,以便使用多部分索引鍵存取 Bigtable 資料,類似於關聯式資料庫中的複合索引鍵。為資料表定義結構化資料列索引鍵後,您就能使用 GoogleSQL 查詢 Bigtable,存取資料列索引鍵的特定區隔。
建立連續 materialized view時,系統會自動建立結構化資料列索引鍵。如要為 Bigtable 資料表實作結構化資料列索引鍵,您可以建立資料列索引鍵結構定義,定義資料列索引鍵各部分的資料類型和編碼方式。Bigtable 會以依字母順序排序的位元組儲存資料列索引鍵,而資料列索引鍵結構定義會告知 GoogleSQL for Bigtable 如何解碼及解讀這些位元組。
使用 Bigtable 用戶端程式庫,透過 Bigtable Data API ReadRows 方法查詢資料表時,系統會忽略資料列索引鍵結構定義。
詳情請參閱「管理資料列索引鍵結構定義」和「結構化資料列索引鍵查詢」。
避免使用資料列索引鍵的情況
某些類型的資料列索引鍵可能會導致查詢資料時發生困難,有些則會導致效能不佳。本節說明您應避免在 Bigtable 中使用的資料列索引鍵類型。
以時間戳記開頭的資料列索引鍵。這種模式會導致循序寫入作業推送至單一節點,建立熱點。如果要在資料列索引鍵中加入時間戳記,請先加入高基數值 (例如使用者 ID),以免出現熱點。
導致相關資料無法分組的資料列索引鍵。請避免使用導致相關資料儲存在不連續資料列範圍的資料列索引鍵,因為這樣一起讀取資料的效率會很低。
連續數字 ID。假設系統會為每個應用程式使用者指派數字 ID。您可能會想使用使用者的數字 ID 做為資料表的資料列索引鍵。不過,由於新使用者較有可能成為活躍使用者,這種做法可能會將大部分流量推送到少數節點。
較安全的方法是使用使用者 ID 的反向版本,這樣一來,Bigtable 資料表的所有節點就能更平均地分配流量。
經常更新的 ID。避免使用單一資料列索引鍵來識別必須經常更新的值。舉例來說,如果您每秒儲存多部裝置的記憶體用量資料,請不要為每部裝置使用單一資料列索引鍵 (由裝置 ID 和儲存的指標組成),例如 4c410523#memusage,並重複更新資料列。這類作業會過度使用儲存常用資料列的平板電腦。此外,由於系統會在垃圾收集期間移除儲存格,因此欄先前的值會佔用空間,也可能導致資料列超出大小限制。
請改為將每項新讀數儲存在新資料列中。以記憶體用量為例,每個資料列索引鍵可以包含裝置 ID、指標類型和時間戳記,因此資料列索引鍵類似於 4c410523#memusage#1423523569918。這項策略很有效率,因為在 Bigtable 中,建立新資料列所需的時間不會超過建立新儲存格。此外,您也可以計算適當的開始和結束鍵,藉此快速讀取特定日期範圍的資料。
對於經常變更的值 (例如每分鐘更新數百次的計數器),最好將資料保留在應用程式層的記憶體中,並定期將新資料列寫入 Bigtable。
雜湊值。雜湊處理資料列索引鍵後,您就無法再利用 Bigtable 的自然排列順序,也無法以最適合查詢的方式儲存資料列。基於相同原因,雜湊值會導致難以使用 Key Visualizer 工具排解 Bigtable 問題。請使用人類可讀的值,而非雜湊值。
以原始位元組表示的值,而非人類可讀的字串。資料欄值使用原始位元組即可,但為了方便閱讀及進行疑難排解,請在資料列索引鍵中使用字串值。
特殊用途
您可能擁有獨特的資料集,在設計結構定義時,需要特別考量如何將資料集儲存在 Bigtable 中。本節說明部分 (但並非全部) 不同類型的 Bigtable 資料,以及以最佳方式儲存資料的一些建議策略。
以時間為準的資料
如果您經常根據資料記錄時間擷取資料,可以在資料列索引鍵中加入時間戳記。
舉例來說,您的應用程式可能會每秒記錄多部機器的 CPU 和記憶體用量等效能相關資料。這項資料的資料列索引鍵可以結合機器 ID 和資料的時間戳記 (例如 machine_4223421#1425330757685)。請注意,資料列索引鍵會依字典順序排序。
如果在資料列索引鍵中加入時間戳記,請勿單獨使用時間戳記,或將時間戳記放在資料列索引鍵開頭。這種模式會導致連續寫入作業推送至單一節點,進而產生熱點。
如果您通常會在查詢中先擷取最新記錄,可以考慮在資料列索引鍵中使用反向時間戳記。這個模式會將資料列從最新到最舊排序,因此資料表中的資料越新越靠前。與任何時間戳記一樣,請避免以反向時間戳記開頭的資料列索引鍵,以免造成資源使用率不均。
如要取得反向時間戳記,請從程式設計語言的長整數最大值中減去時間戳記 (在 Java 中為 java.lang.Long.MAX_VALUE)。
如要瞭解如何處理時間序列資料,請參閱「時間序列資料的結構定義設計」。
多用戶群架構
資料列索引鍵前置字元可為「多租戶」用途提供可擴充的解決方案。在這種情況下,您會代表多個用戶端,使用相同的資料模型儲存類似資料。使用單一表格儲存及存取所有房客的資料,是效率最高的方法。
舉例來說,假設您代表許多公司儲存及追蹤購買記錄,您可以將每間公司的專屬 ID 做為資料列索引鍵前置字元。所有房客的資料都會儲存在同一資料表的連續資料列中,您可以使用資料列索引鍵前置字元查詢或篩選資料。接著,當某公司不再是您的客戶,而您需要刪除為該公司儲存的購買記錄資料時,可以捨棄使用該客戶資料列鍵前置字元的資料列範圍。
舉例來說,如果您要儲存顧客的行動裝置資料 altostrat 和 examplepetstore,可以建立如下所示的資料列索引鍵。接著,如果 altostrat 不再是您的客戶,請捨棄所有以 altostrat 為資料列索引鍵前置字元的列。
        altostrat#phone#4c410523#20190501
        altostrat#phone#4c410523#20190502
        altostrat#tablet#a0b41f74#20190501
        examplepetstore#phone#4c410523#20190502
        examplepetstore#tablet#a6b81f79#20190501
        examplepetstore#tablet#a0b81f79#20190502
反之,如果您代表每間公司將資料儲存在各自的資料表中,可能會遇到效能和擴充性問題。此外,您也更有可能在無意間達到每個執行個體 1,000 個資料表的 Bigtable 上限。執行個體達到這個上限後,Bigtable 會禁止您在執行個體中建立更多資料表。
隱私權
除非您的用途需要,否則請避免在資料列鍵或資料欄系列 ID 中使用個人識別資訊 (PII) 或使用者資料。資料列索引鍵和資料欄系列中的值都是客戶資料和服務資料,而使用這些值的應用程式 (例如加密或記錄) 可能會不慎將這些值公開給不應存取私人資料的使用者。
如要進一步瞭解服務資料的處理方式,請參閱Google Cloud 隱私權 聲明。
網域名稱
您可以將網域名稱儲存為 Bigtable 資料。
網域名稱種類繁多
如果您儲存的實體資料可表示為網域名稱,請考慮使用反向網域名稱 (例如 com.company.product) 做為資料列索引鍵。如果每個資料列的資料容易與相鄰資料列重疊,就特別適合使用反向網域名稱。在這種情況下,Bigtable 可以更有效率地壓縮資料。
反之,如果使用未反轉的標準網域名稱,系統可能會以不當方式排序資料列,導致相關資料無法集中顯示,進而降低壓縮和讀取效率。
如果資料分散在許多不同的反向網域名稱中,這個方法最適合您。
為說明這一點,請參考下列網域名稱,這些網域名稱會由 Bigtable 自動依字典順序排序:
      drive.google.com
      en.wikipedia.org
      maps.google.com
如果您想查詢所有資料列的 google.com,這並非理想做法。相反地,請考慮網域名稱已反轉的相同資料列:
      com.google.drive
      com.google.maps
      org.wikipedia.en
在第二個範例中,系統會自動排序相關資料列,方便您以資料列範圍的形式擷取資料。
網域名稱數量較少
如果您預期只會為一或少數幾個網域名稱儲存大量資料,請考慮使用其他資料列索引鍵值。否則,您可能會將寫入作業推送至叢集中的單一節點,導致熱點,或列可能會變得過大。
以 Protobuf 格式儲存資料
如要降低儲存費用並提高讀取和寫入效率,您可以將相關資料分組為 通訊協定緩衝區 (protobuf) 訊息,並儲存在單一資料欄中,不必將每個欄位都儲存在各自的資料欄中。如果您通常會一起讀取一組欄位,將這些欄位儲存在單一資料欄中做為一個值,會更有效率,因為讀取單一資料欄的速度比讀取多個個別資料欄更快。如果將資料儲存為 protobuf 訊息,即可運用下列 Bigtable 功能:
- 使用通訊協定緩衝區儲存彈性資料結構,可避免資料重複,並將資料保留在原處,進而降低儲存空間成本。
- 將 protobuf 結構定義上傳至 Bigtable 的結構定義套件,即可啟用伺服器端查詢。Bigtable 可透過結構定義套件,在查詢執行期間瞭解及剖析序列化資料的結構。
- 在 Bigtable 中使用 GoogleSQL 直接查詢及篩選 protobuf 訊息中的個別欄位,既快速又有效率。在伺服器端還原序列化資料,即可執行精細的查詢和投影,不必將整個 protobuf 物件傳輸至用戶端。
- 使用 BigQuery 外部資料表分析 Bigtable 中儲存的 protobuf 資料,可簡化分析作業。
詳情請參閱「建立及管理 protobuf 結構定義」。