


Praktik terbaik desain skema
Skema Bigtable yang efektif memungkinkan Anda memaksimalkan throughput baca dan tulis, mencegah hotspot, dan menskalakan penyimpanan secara efisien. Sebelum Anda memulai, tinjau ringkasan Bigtable untuk memahami arsitektur dan model penyimpanan yang mendasarinya.
Konsep umum
Mendesain skema Bigtable berbeda dengan mendesain skema untuk database relasional. Skema Bigtable ditentukan oleh logika aplikasi, bukan oleh objek atau file definisi skema. Anda dapat menambahkan grup kolom ke tabel saat membuat atau memperbarui tabel, tetapi kolom dan pola row key ditentukan oleh data yang Anda tulis ke tabel.
Di Bigtable, skema adalah cetak biru atau model tabel, termasuk struktur komponen tabel berikut:
- Kunci baris
- Grup kolom, termasuk kebijakan pengumpulan sampah
- Kolom
Di Bigtable, desain skema terutama didorong oleh kueri, atau permintaan baca, yang akan Anda kirim ke tabel. Karena membaca rentang baris adalah cara tercepat untuk membaca data Bigtable, rekomendasi di halaman ini dirancang untuk membantu Anda mengoptimalkan pembacaan rentang baris. Dalam sebagian besar kasus, hal ini berarti mengirimkan kueri berdasarkan awalan kunci baris.
Pertimbangan sekunder adalah menghindari hotspot – untuk mencegah hotspot, Anda perlu mempertimbangkan pola penulisan dan cara menghindari akses ke ruang kunci kecil dalam waktu singkat.
Konsep umum berikut berlaku untuk desain skema Bigtable:
- Bigtable adalah penyimpanan nilai/kunci, bukan penyimpanan relasional. Tabel ini tidak mendukung penggabungan, dan transaksi hanya didukung dalam satu baris.
- Setiap tabel memiliki indeks: kunci baris. Setiap kunci baris harus unik. Untuk membuat indeks sekunder, gunakan tampilan terwujud berkelanjutan. Untuk mengetahui informasi selengkapnya, lihat Membuat indeks sekunder asinkron.
- Row key mengurutkan baris secara leksikografis dari string byte terendah hingga tertinggi. Urutan ini adalah big-endian (terkadang disebut urutan byte jaringan), setara biner dengan urutan abjad.
- Grup kolom tidak disimpan dalam urutan tertentu.
- Kolom dikelompokkan menurut grup kolom dan diurutkan dalam urutan leksikografis
dalam grup kolom. Misalnya, dalam grup kolom yang disebut
SysMonitordengan penentu kolomProcessName,User,%CPU,ID,Memory,DiskRead, danPriority, Bigtable menyimpan kolom dalam urutan ini:
| SysMonitor | ||||||
|---|---|---|---|---|---|---|
| %CPU | DiskRead | ID | Memori | Prioritas | ProcessName | Pengguna |
- Persimpangan baris dan kolom dapat berisi beberapa sel yang diberi stempel waktu. Setiap sel berisi versi data yang unik dan diberi stempel waktu untuk baris dan kolom tersebut.
- Grup kolom gabungan berisi sel gabungan. Anda dapat membuat grup kolom yang hanya berisi sel gabungan. Agregat memungkinkan Anda menggabungkan data baru dengan data yang sudah ada di sel.
- Semua operasi bersifat atomik di tingkat baris. Operasi memengaruhi seluruh baris atau tidak ada baris sama sekali.
- Idealnya, operasi baca dan tulis harus didistribusikan secara merata di seluruh ruang baris tabel.
- Tabel Bigtable bersifat sparse. Kolom tidak menggunakan ruang apa pun dalam baris yang tidak menggunakan kolom tersebut.
Praktik terbaik
Skema yang baik menghasilkan performa dan skalabilitas yang sangat baik, dan skema yang dirancang dengan buruk dapat menyebabkan sistem berperforma buruk. Setiap kasus penggunaan berbeda dan memerlukan desainnya sendiri, tetapi praktik terbaik berikut berlaku untuk sebagian besar kasus penggunaan. Pengecualian dicatat.
Mulai dari tingkat tabel dan berlanjut ke tingkat row key, bagian berikut menjelaskan praktik terbaik untuk desain skema:
Semua elemen tabel, terutama kunci baris, harus didesain dengan mempertimbangkan permintaan baca yang direncanakan. Periksa kuota dan batas untuk batas ukuran yang direkomendasikan dan batas ukuran tetap untuk semua elemen tabel.
Karena semua tabel dalam instance disimpan di tablet yang sama, desain skema yang menghasilkan hotspot dalam satu tabel dapat memengaruhi latensi tabel lain dalam instance yang sama. Hotspot disebabkan oleh seringnya mengakses satu bagian tabel dalam jangka waktu singkat.
Tabel
Simpan set data dengan skema serupa dalam tabel yang sama, bukan dalam tabel terpisah.
Di sistem database lain, Anda dapat memilih untuk menyimpan data dalam beberapa tabel berdasarkan subjek dan jumlah kolom. Namun, di Bigtable, biasanya lebih baik menyimpan semua data Anda dalam satu tabel. Anda dapat menetapkan awalan row key unik untuk digunakan bagi setiap set data, sehingga Bigtable menyimpan data terkait dalam rentang baris berdekatan yang kemudian dapat Anda kueri berdasarkan awalan row key.
Bigtable memiliki batas 1.000 tabel per instance, tetapi sebaiknya hindari membuat banyak tabel karena alasan berikut:
- Mengirim permintaan ke banyak tabel yang berbeda dapat meningkatkan overhead koneksi backend, sehingga meningkatkan latensi ekor.
- Membuat lebih banyak tabel tidak akan meningkatkan load balancing dan dapat meningkatkan overhead pengelolaan.
Anda mungkin ingin membuat tabel terpisah untuk kasus penggunaan yang berbeda yang memerlukan skema yang berbeda, tetapi Anda tidak boleh menggunakan tabel terpisah untuk data yang serupa. Misalnya, Anda tidak boleh membuat tabel baru hanya karena tahun baru atau Anda memiliki pelanggan baru.
Grup kolom
Tempatkan kolom terkait dalam grup kolom yang sama. Jika baris berisi beberapa nilai yang terkait satu sama lain, sebaiknya kelompokkan kolom yang berisi nilai tersebut dalam grup kolom yang sama. Kelompokkan data sedekat mungkin untuk menghindari kebutuhan merancang filter yang kompleks dan agar Anda mendapatkan hanya informasi yang Anda butuhkan, tetapi tidak lebih, dalam permintaan baca yang paling sering Anda lakukan.
Buat hingga sekitar 100 grup kolom per tabel. Membuat lebih dari 100 grup kolom dapat menyebabkan penurunan performa.
Pilih nama pendek untuk grup kolom Anda. Nama disertakan dalam data yang ditransfer untuk setiap permintaan.
Tempatkan kolom yang memiliki kebutuhan retensi data yang berbeda dalam kolom keluarga yang berbeda. Praktik ini penting jika Anda ingin membatasi biaya penyimpanan. Kebijakan pengumpulan sampah ditetapkan di tingkat grup kolom, bukan di tingkat kolom. Misalnya, jika Anda hanya perlu menyimpan versi terbaru dari sepotong data tertentu, jangan menyimpannya di grup kolom yang ditetapkan untuk menyimpan 1.000 versi dari sesuatu yang lain. Jika tidak, Anda membayar untuk menyimpan 999 sel data yang tidak Anda perlukan.
Kolom
Buat kolom sebanyak yang Anda butuhkan dalam tabel. Tabel Bigtable renggang, dan tidak ada penalti ruang untuk kolom yang tidak digunakan dalam baris. Anda dapat memiliki jutaan kolom dalam tabel, asalkan tidak ada baris yang melebihi batas maksimum 256 MB per baris.
Hindari penggunaan terlalu banyak kolom dalam satu baris. Meskipun tabel dapat memiliki jutaan kolom, baris tidak boleh. Beberapa faktor berkontribusi pada praktik terbaik ini:
- Bigtable memerlukan waktu untuk memproses setiap sel dalam baris.
- Setiap sel menambahkan beberapa overhead ke jumlah data yang disimpan dalam tabel dan dikirim melalui jaringan. Misalnya, jika Anda menyimpan data berukuran 1 KB (1.024 byte), akan jauh lebih efisien jika data tersebut disimpan dalam satu sel, daripada menyebarkan data ke 1.024 sel yang masing-masing berisi 1 byte.
Jika set data Anda secara logis memerlukan lebih banyak kolom per baris daripada yang dapat diproses Bigtable secara efisien, pertimbangkan untuk menyimpan data sebagai protobuf dalam satu kolom.
Secara opsional, Anda dapat memperlakukan penentu kolom sebagai data. Karena Anda harus menyimpan
penentu kolom untuk setiap kolom, Anda dapat menghemat ruang dengan memberi nama kolom
dengan nilai. Sebagai contoh, pertimbangkan tabel yang menyimpan data tentang persahabatan dalam grup kolom Friends. Setiap baris mewakili seseorang dan semua
persahabatannya. Setiap penentu kolom dapat berupa ID teman. Kemudian, nilai untuk
setiap kolom dalam baris tersebut dapat berupa lingkaran sosial tempat teman berada. Dalam
contoh ini, baris mungkin terlihat seperti ini:
| Row key | Fred | Gabriel | Hiroshi | Seo Yoon | Jakob |
|---|---|---|---|---|---|
| Jose | klub buku | kantor | tenis | ||
| Sofia | kantor | school | klub catur |
Bandingkan skema ini dengan skema untuk data yang sama yang tidak memperlakukan kualifikasi kolom sebagai data dan memiliki kolom yang sama di setiap baris:
| Row key | Teman | Circle |
|---|---|---|
| Jose#1 | Fred | klub buku |
| Jose#2 | Gabriel | kantor |
| Jose#3 | Hiroshi | tenis |
| Sofia#1 | Hiroshi | kantor |
| Sofia#2 | Seo Yoon | school |
| Sofia#3 | Jakob | klub catur |
Desain skema kedua menyebabkan tabel berkembang jauh lebih cepat.
Jika Anda menggunakan penentu kolom untuk menyimpan data, beri penentu kolom nama yang pendek tetapi bermakna. Pendekatan ini memungkinkan Anda mengurangi jumlah data yang ditransfer untuk setiap permintaan. Ukuran maksimumnya adalah 16 KB.
Baris
Pertahankan ukuran semua nilai dalam satu baris di bawah 100 MB. Pastikan data dalam satu baris tidak melebihi 256 MB. Baris yang melebihi batas ini dapat menyebabkan penurunan performa baca.
Simpan semua informasi untuk suatu entity dalam satu baris. Untuk sebagian besar kasus penggunaan, hindari menyimpan data yang harus Anda baca secara atomik, atau sekaligus, di lebih dari satu baris untuk menghindari inkonsistensi. Misalnya, jika Anda memperbarui dua baris dalam tabel, ada kemungkinan satu baris akan berhasil diperbarui dan pembaruan lainnya akan gagal. Pastikan skema Anda tidak memerlukan lebih dari satu baris untuk diperbarui secara bersamaan agar data terkait akurat. Praktik ini memastikan bahwa jika sebagian permintaan tulis gagal atau harus dikirim lagi, bagian data tersebut tidak akan tidak lengkap untuk sementara.
Pengecualian: Jika menyimpan entitas dalam satu baris menghasilkan baris yang berukuran ratusan MB, Anda harus membagi data di beberapa baris.
Simpan entity terkait dalam baris yang berdekatan, agar pembacaan lebih efisien.
Sel
Jangan menyimpan lebih dari 10 MB data dalam satu sel. Ingatlah bahwa sel adalah data yang disimpan untuk baris dan kolom tertentu dengan stempel waktu unik, dan beberapa sel dapat disimpan di persimpangan baris dan kolom tersebut. Jumlah sel yang dipertahankan dalam kolom diatur oleh kebijakan pengumpulan sampah yang Anda tetapkan untuk grup kolom yang berisi kolom tersebut.
Gunakan sel gabungan untuk menyimpan dan memperbarui data gabungan. Jika Anda hanya ingin mengetahui nilai gabungan peristiwa untuk suatu entitas, seperti jumlah bulanan penjualan per karyawan di toko retail, Anda dapat menggunakan agregat. Untuk mengetahui informasi selengkapnya, lihat Menghitung nilai agregat saat penulisan.
Kunci baris
Rancang row key Anda berdasarkan kueri yang akan Anda gunakan untuk mengambil data. Row key yang didesain dengan baik akan mendapatkan performa terbaik dari Bigtable. Kueri Bigtable yang paling efisien mengambil data menggunakan salah satu hal berikut:
- Row key
- Awalan row key
- Rentang baris yang ditentukan oleh row key awal dan akhir
Jenis kueri lainnya memicu pemindaian tabel penuh, yang jauh kurang efisien. Dengan memilih kunci baris yang benar sekarang, Anda dapat menghindari proses migrasi data yang menyakitkan di kemudian hari.
Buat row key Anda tetap singkat. Kunci baris harus berukuran 4 KB atau kurang. Kunci baris yang panjang memerlukan memori dan penyimpanan tambahan serta meningkatkan waktu yang diperlukan untuk mendapatkan respons dari server Bigtable.
Simpan beberapa nilai yang dibatasi dalam setiap row key. Karena cara terbaik untuk mengirim kueri Bigtable secara efisien adalah dengan row key, sering kali berguna untuk menyertakan beberapa ID dalam row key Anda. Jika row key Anda menyertakan beberapa nilai, Anda harus memahami dengan jelas cara Anda menggunakan data.
Segmen row key biasanya dipisahkan oleh pembatas, seperti titik dua, garis miring, atau simbol hash. Segmen pertama atau kumpulan segmen yang berdekatan adalah awalan row key, dan segmen terakhir atau kumpulan segmen yang berdekatan adalah akhiran row key.
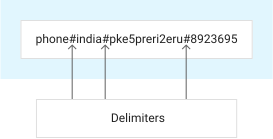
Awalan row key yang direncanakan dengan baik memungkinkan Anda memanfaatkan urutan pengurutan bawaan Bigtable untuk menyimpan data terkait dalam baris yang berdekatan. Menyimpan data terkait dalam baris yang berdekatan memungkinkan Anda mengakses data terkait sebagai rentang baris, bukan menjalankan pemindaian tabel yang tidak efisien.
Jika data Anda menyertakan bilangan bulat yang ingin Anda simpan atau urutkan secara numerik, isi bilangan bulat dengan nol di depannya. Bigtable menyimpan data secara leksikografis. Misalnya, secara leksikografis, 3 > 20 tetapi 20 > 03. Menambahkan angka nol di depan angka 3 memastikan angka diurutkan secara numerik. Taktik ini penting untuk stempel waktu saat kueri berbasis rentang digunakan.
Penting untuk membuat row key yang memungkinkan Anda mengambil rentang baris yang terdefinisi dengan baik. Jika tidak, kueri Anda memerlukan pemindaian tabel, yang jauh lebih lambat daripada mengambil baris tertentu.
Misalnya, jika aplikasi Anda melacak data perangkat seluler, Anda dapat memiliki kunci baris yang terdiri dari jenis perangkat, ID perangkat, dan hari saat data direkam. Kunci baris untuk data ini mungkin terlihat seperti ini:
        phone#4c410523#20200501
        phone#4c410523#20200502
        tablet#a0b81f74#20200501
        tablet#a0b81f74#20200502
Desain row key ini memungkinkan Anda mengambil data dengan satu permintaan untuk:
- Jenis perangkat
- Kombinasi jenis perangkat dan ID perangkat
Desain row key ini tidak optimal jika Anda ingin mengambil semua data untuk hari tertentu. Karena hari disimpan di segmen ketiga, atau sufiks kunci baris, Anda tidak dapat hanya meminta rentang baris berdasarkan sufiks atau segmen tengah kunci baris. Sebagai gantinya, Anda harus mengirim permintaan baca dengan filter yang memindai seluruh tabel untuk mencari nilai hari.
Gunakan nilai string yang dapat dibaca manusia di row key Anda jika memungkinkan. Praktik ini mempermudah penggunaan alat Key Visualizer untuk memecahkan masalah Bigtable.
Sering kali, Anda harus merancang row key yang dimulai dengan nilai umum dan diakhiri dengan nilai terperinci. Misalnya, jika kunci baris Anda menyertakan benua, negara, dan kota, Anda dapat membuat kunci baris yang terlihat seperti berikut agar otomatis diurutkan terlebih dahulu berdasarkan nilai dengan kardinalitas yang lebih rendah:
        asia#india#bangalore
        asia#india#mumbai
        asia#japan#osaka
        asia#japan#sapporo
        southamerica#bolivia#cochabamba
        southamerica#bolivia#lapaz
        southamerica#chile#santiago
        southamerica#chile#temuco
Row key terstruktur
Jika berencana membuat kueri tabel menggunakan SQL, Anda dapat menentukan kunci baris terstruktur, yang memungkinkan Anda mengakses data Bigtable menggunakan kunci multi-bagian, mirip dengan kunci komposit dalam database relasional. Menentukan kunci baris terstruktur untuk tabel memungkinkan Anda mengakses segmen tertentu dari kunci baris menggunakan kueri GoogleSQL untuk Bigtable.
Kunci baris terstruktur dibuat secara otomatis saat Anda membuat tampilan terwujud berkelanjutan. Untuk menerapkan kunci baris terstruktur untuk tabel Bigtable, Anda dapat membuat skema kunci baris yang menentukan jenis data dan encoding setiap segmen kunci baris. Bigtable menyimpan row key sebagai byte yang diurutkan secara leksikografis, dan skema row key memberi tahu GoogleSQL untuk Bigtable cara mendekode dan menafsirkan byte tersebut.
Skema row key diabaikan saat Anda membuat kueri tabel menggunakan metode Bigtable Data API ReadRows dengan library klien Bigtable.
Untuk mengetahui informasi selengkapnya, lihat Mengelola skema row key dan Kueri row key terstruktur.
Kunci baris yang harus dihindari
Beberapa jenis row key dapat mempersulit pembuatan kueri data Anda, dan beberapa jenis row key dapat menyebabkan performa yang buruk. Bagian ini menjelaskan beberapa jenis kunci baris yang sebaiknya tidak Anda gunakan di Bigtable.
Kunci baris yang dimulai dengan stempel waktu. Pola ini menyebabkan penulisan berurutan didorong ke satu node, sehingga membuat hotspot. Jika Anda menempatkan stempel waktu di row key, awali dengan nilai berkardinalitas tinggi seperti ID pengguna untuk menghindari hotspot.
Kunci baris yang menyebabkan data terkait tidak dikelompokkan. Hindari row key yang menyebabkan data terkait disimpan dalam rentang baris yang tidak berdekatan, yang tidak efisien untuk dibaca bersama.
ID numerik berurutan. Misalkan sistem Anda menetapkan ID numerik kepada setiap pengguna aplikasi Anda. Anda mungkin tergoda untuk menggunakan ID numerik pengguna sebagai kunci baris untuk tabel Anda. Namun, karena pengguna baru lebih cenderung menjadi pengguna aktif, pendekatan ini kemungkinan akan mendorong sebagian besar traffic Anda ke sejumlah kecil node.
Pendekatan yang lebih aman adalah menggunakan versi terbalik dari ID numerik pengguna, yang menyebarkan traffic secara lebih merata di semua node untuk tabel Bigtable Anda.
ID yang sering diperbarui. Hindari penggunaan satu kunci baris untuk mengidentifikasi nilai yang harus sering diperbarui. Misalnya, jika Anda menyimpan data penggunaan memori untuk sejumlah perangkat sekali per detik, jangan gunakan satu row key untuk setiap perangkat yang terdiri dari ID perangkat dan metrik yang disimpan, seperti 4c410523#memusage, dan perbarui baris berulang kali. Jenis operasi ini
membebani tablet yang menyimpan baris yang sering digunakan. Hal ini juga dapat menyebabkan baris melebihi batas ukurannya, karena nilai kolom sebelumnya menggunakan ruang hingga sel dihapus selama pengumpulan sampah.
Sebagai gantinya, simpan setiap data bacaan baru dalam baris baru. Dengan menggunakan contoh penggunaan memori, setiap row key dapat berisi ID perangkat, jenis metrik, dan stempel waktu, sehingga row key serupa dengan 4c410523#memusage#1423523569918. Strategi ini efisien karena di Bigtable, membuat baris baru tidak memerlukan waktu lebih lama daripada membuat sel baru. Selain itu, strategi ini memungkinkan Anda membaca data dengan cepat dari rentang tanggal tertentu dengan menghitung kunci awal dan akhir yang sesuai.
Untuk nilai yang sering berubah, seperti penghitung yang diperbarui ratusan kali setiap menit, sebaiknya simpan data dalam memori, di lapisan aplikasi, dan tulis baris baru ke Bigtable secara berkala.
Nilai hash. Melakukan hashing pada row key akan menghilangkan kemampuan Anda untuk memanfaatkan tata urutan alami Bigtable, sehingga tidak mungkin menyimpan baris dengan cara yang optimal untuk pembuatan kueri. Karena alasan yang sama, nilai hashing menyulitkan penggunaan alat Key Visualizer untuk memecahkan masalah pada Bigtable. Gunakan nilai yang dapat dibaca manusia, bukan nilai hash.
Nilai dinyatakan sebagai byte mentah, bukan string yang dapat dibaca manusia. Byte mentah tidak masalah untuk nilai kolom, tetapi untuk keterbacaan dan pemecahan masalah, gunakan nilai string di row key.
Kasus penggunaan khusus
Anda mungkin memiliki set data unik yang memerlukan pertimbangan khusus saat mendesain skema untuk menyimpannya di Bigtable. Bagian ini menjelaskan beberapa, tetapi tidak semua, jenis data Bigtable yang berbeda dan beberapa taktik yang disarankan untuk menyimpannya dengan cara yang paling optimal.
Data berbasis waktu
Jika Anda sering mengambil data berdasarkan waktu saat data tersebut dicatat, Anda dapat menyertakan stempel waktu sebagai bagian dari row key Anda.
Misalnya, aplikasi Anda dapat merekam data terkait performa, seperti penggunaan CPU dan memori, sekali per detik untuk banyak mesin. Kunci baris untuk data ini dapat menggabungkan ID untuk mesin dengan stempel waktu untuk data (misalnya, machine_4223421#1425330757685). Perlu diingat bahwa kunci baris diurutkan secara leksikografis.
Jika Anda menyertakan stempel waktu di row key, jangan gunakan stempel waktu itu sendiri atau di awal row key. Pola ini menyebabkan penulisan berurutan didorong ke satu node, sehingga membuat hotspot.
Jika biasanya Anda mengambil rekaman terbaru terlebih dahulu dalam kueri, pola yang perlu dipertimbangkan adalah menggunakan stempel waktu terbalik di row key. Pola ini menyebabkan baris diurutkan dari yang paling baru hingga yang paling lama, sehingga data yang lebih baru berada di bagian awal tabel. Seperti stempel waktu lainnya, hindari memulai row key dengan stempel waktu terbalik agar tidak menyebabkan hotspot.
Anda bisa mendapatkan stempel waktu terbalik dengan mengurangi stempel waktu dari nilai maksimum bilangan bulat panjang bahasa pemrograman Anda (di Java, java.lang.Long.MAX_VALUE).
Untuk informasi khusus tentang cara menggunakan data deret waktu, lihat Desain skema untuk data deret waktu.
Multi-tenancy
Awalan row key memberikan solusi yang dapat diskalakan untuk kasus penggunaan "multi-tenancy", yaitu skenario saat Anda menyimpan data serupa, menggunakan model data yang sama, atas nama beberapa klien. Menggunakan satu tabel untuk semua tenant adalah cara paling efisien untuk menyimpan dan mengakses data multi-tenant.
Misalnya, Anda menyimpan dan melacak histori pembelian atas nama banyak perusahaan. Anda dapat menggunakan ID unik untuk setiap perusahaan sebagai awalan kunci baris. Semua data untuk tenant disimpan dalam baris yang berdekatan di tabel yang sama, dan Anda dapat melakukan kueri atau memfilter menggunakan awalan row key. Kemudian, jika perusahaan tidak lagi menjadi pelanggan Anda dan Anda perlu menghapus data histori pembelian yang Anda simpan untuk perusahaan tersebut, Anda dapat menghapus rentang baris yang menggunakan awalan row key pelanggan tersebut.
Misalnya, jika Anda menyimpan data perangkat seluler untuk pelanggan altostrat dan examplepetstore, Anda dapat membuat row key seperti berikut. Kemudian, jika
altostrat bukan lagi pelanggan Anda, Anda akan menghapus semua baris dengan awalan
row key altostrat.
        altostrat#phone#4c410523#20190501
        altostrat#phone#4c410523#20190502
        altostrat#tablet#a0b41f74#20190501
        examplepetstore#phone#4c410523#20190502
        examplepetstore#tablet#a6b81f79#20190501
        examplepetstore#tablet#a0b81f79#20190502
Sebaliknya, jika Anda menyimpan data atas nama setiap perusahaan dalam tabelnya sendiri, Anda dapat mengalami masalah performa dan skalabilitas. Anda juga lebih cenderung secara tidak sengaja mencapai batas Bigtable,yaitu 1.000 tabel per instance. Setelah instance mencapai batas ini, Bigtable akan mencegah Anda membuat lebih banyak tabel di instance tersebut.
Privasi
Kecuali kasus penggunaan Anda memerlukannya, hindari penggunaan informasi identitas pribadi (PII) atau data pengguna dalam kunci baris atau ID family kolom. Nilai dalam row key dan grup kolom adalah data pelanggan dan data layanan, dan aplikasi yang menggunakannya, seperti enkripsi atau logging, dapat secara tidak sengaja mengeksposnya kepada pengguna yang seharusnya tidak memiliki akses ke data pribadi.
Untuk mengetahui informasi selengkapnya tentang cara data layanan ditangani, lihat Google CloudPemberitahuan Privasi.
Nama domain
Anda dapat menyimpan nama domain sebagai data Bigtable.
Berbagai nama domain
Jika Anda menyimpan data tentang entitas yang dapat direpresentasikan sebagai nama domain, pertimbangkan untuk menggunakan nama domain terbalik (misalnya, com.company.product) sebagai kunci baris. Menggunakan nama domain terbalik adalah ide yang sangat baik jika data setiap baris cenderung tumpang-tindih dengan baris yang berdekatan. Dalam hal ini, Bigtable
dapat mengompresi data Anda secara lebih efisien.
Sebaliknya, nama domain standar yang tidak dibalik dapat menyebabkan baris diurutkan sedemikian rupa sehingga data terkait tidak dikelompokkan bersama di satu tempat, yang dapat menghasilkan kompresi yang kurang efisien dan pembacaan yang kurang efisien.
Pendekatan ini paling efektif jika data Anda tersebar di banyak nama domain terbalik yang berbeda.
Untuk mengilustrasikan hal ini, pertimbangkan nama domain berikut, yang otomatis diurutkan dalam urutan leksikografis oleh Bigtable:
      drive.google.com
      en.wikipedia.org
      maps.google.com
Hal ini tidak diinginkan untuk kasus penggunaan saat Anda ingin mengkueri semua baris untuk
google.com. Sebaliknya, pertimbangkan baris yang sama dengan nama domain yang telah dibalik:
      com.google.drive
      com.google.maps
      org.wikipedia.en
Dalam contoh kedua, baris terkait diurutkan secara otomatis sehingga lebih mudah diambil sebagai rentang baris.
Beberapa nama domain
Jika Anda berencana menyimpan banyak data hanya untuk satu atau beberapa nama domain, pertimbangkan nilai lain untuk row key Anda. Jika tidak, Anda dapat mendorong penulisan ke satu node di cluster, yang mengakibatkan hotspot, atau baris Anda mungkin bertambah terlalu besar.
Menyimpan data dalam format protobuf
Untuk mengurangi biaya penyimpanan dan meningkatkan efisiensi baca dan tulis, Anda dapat mengelompokkan data terkait ke dalam pesan protocol buffer (protobuf) dan menyimpannya dalam satu kolom, bukan menyimpan setiap kolom dalam kolomnya sendiri. Jika Anda biasanya membaca sekumpulan kolom bersama-sama, menyimpan kolom tersebut dalam satu kolom sebagai satu nilai akan lebih efisien, karena membaca satu kolom lebih cepat daripada membaca banyak kolom individual. Jika menyimpan data sebagai pesan protobuf, Anda dapat memanfaatkan fitur Bigtable berikut:
- Menggunakan buffer protokol untuk menyimpan struktur data yang fleksibel akan mengurangi biaya penyimpanan dengan menyimpan data di tempatnya dan menghindari duplikasi.
- Mengupload skema protobuf ke Bigtable dalam paket skema memungkinkan pembuatan kueri sisi server. Paket skema memungkinkan Bigtable memahami dan mengurai struktur data berseri Anda selama eksekusi kueri.
- Penggunaan GoogleSQL untuk membuat kueri dan memfilter setiap kolom dalam pesan protobuf secara langsung di Bigtable akan berjalan cepat dan efisien. Dengan melakukan deserialisasi data di sisi server, Anda dapat melakukan kueri dan proyeksi terperinci tanpa perlu mentransfer seluruh objek protobuf ke klien Anda.
- Dengan menggunakan tabel eksternal BigQuery untuk menganalisis data protobuf yang disimpan di Bigtable, Anda dapat menyederhanakan analisis.
Untuk mengetahui informasi selengkapnya, lihat Membuat dan mengelola skema protobuf.
Langkah berikutnya
- Mendesain skema untuk data deret waktu.
- Tinjau langkah-langkah yang terlibat dalam perencanaan skema.
- Pelajari jenis permintaan tulis yang dapat Anda kirim ke Bigtable.
- Terapkan penghitung menggunakan sel gabungan.
- Tinjau kuota dan batas yang berlaku.
- Kueri data protobuf.