


Panoramica di Bigtable
Bigtable è una tabella scarsamente popolata che può scalare fino a miliardi di righe e migliaia di colonne, consentendoti di archiviare terabyte o persino petabyte di dati. Bigtable è ideale per archiviare grandi quantità di dati con chiave singola a bassa latenza. Supporta un'elevata velocità effettiva di lettura e scrittura a bassa latenza ed è un'origine dati ideale per le operazioni MapReduce.
Bigtable è esposto alle applicazioni tramite più librerie client, tra cui un'estensione supportata della libreria Apache HBase per Java. Di conseguenza, si integra con l'ecosistema Apache esistente di software open source per big data.
I potenti server di backend di Bigtable offrono diversi vantaggi chiave:
- Incredibile scalabilità. Bigtable scala in proporzione diretta al numero di macchine nel cluster. Un'installazione HBase autogestita presenta un collo di bottiglia di progettazione che limita le prestazioni dopo il raggiungimento di una determinata soglia. Bigtable non ha questo collo di bottiglia, quindi puoi fare lo scale up del cluster per gestire più letture e scritture.
- Amministrazione semplice. Bigtable gestisce gli upgrade e i riavvii in modo trasparente e mantiene automaticamente un'elevata durabilità dei dati. Per replicare i dati, aggiungi un secondo cluster all'istanza e la replica verrà avviata automaticamente. Non è più necessario gestire repliche o regioni: basta progettare gli schemi delle tabelle e Bigtable si occuperà del resto.
- Ridimensionamento del cluster senza tempi di inattività. Puoi aumentare le dimensioni di un cluster Bigtable per alcune ore per gestire un carico elevato, quindi ridurle di nuovo, il tutto senza tempi di inattività. Dopo aver modificato le dimensioni di un cluster, in genere Bigtable impiega solo pochi minuti sotto carico per bilanciare le prestazioni tra tutti i nodi del cluster.
- Archiviazione a livelli (anteprima). Puoi archiviare i dati a cui accedi raramente in un livello di archiviazione separato e a un costo inferiore. L'archiviazione a livelli ti consente di scegliere il livello di archiviazione più adatto alle tue esigenze di accesso ai dati Bigtable.
- Scalabilità automatica. Puoi configurare Bigtable in modo che monitori continuamente la capacità della CPU del cluster e regoli automaticamente il numero di nodi in un cluster, se necessario.
- Prova senza costi. Puoi esplorare le caratteristiche e le funzionalità di Bigtable senza costi per 10 giorni, con la possibilità di estendere la prova senza costi a 90 giorni. Bigtable fornisce un'istanza Bigtable di prova senza costi con un massimo di 500 GB di spazio di archiviazione SSD e un cluster a 1 nodo, che ti consente di testare le prestazioni della tua applicazione eseguendo operazioni di lettura e scrittura ad alto volume sulle tabelle Bigtable per vedere come Bigtable gestisce le operazioni con prestazioni supportate da SSD.
- Livello in memoria (anteprima). Puoi ottenere una latenza di lettura inferiore al millisecondo e un throughput elevato per i tuoi dati critici e sensibili al fattore tempo. Il livello in memoria estende l'unità a stato solido (SSD) permanente esistente di Bigtable e l'archiviazione a livelli conveniente con l'archiviazione del livello in memoria (RAM) per fornire un tiering dei dati integrato all'interno di un servizio unificato.
Versioni di Bigtable
Le versioni di Bigtable sono un modello di prezzi che fornisce funzionalità diverse a prezzi diversi. Puoi scegliere tra la versione Enterprise standard e la versione Enterprise Plus premium. Per saperne di più, consulta la panoramica delle versioni.
A cosa serve
Bigtable è ideale per applicazioni che richiedono throughput elevato e scalabilità elevata per i dati coppia chiave-valore, in cui ogni valore, di solito, non è più grande di 10 MB. Bigtable eccelle anche come motore di archiviazione per operazioni MapReduce batch, elaborazione di flussi/analisi e applicazioni di machine learning.
Puoi utilizzare Bigtable per archiviare ed eseguire query su tutti i seguenti tipi di dati:
- Dati di serie temporali,ad esempio l'utilizzo della CPU e la memoria utilizzata nel tempo per più server.
- Dati di marketing,come cronologia acquisti e preferenze dei clienti.
- Dati finanziari, come cronologia delle transazioni, prezzi delle azioni e tassi di cambio delle valute.
- Dati IoT (Internet of Things) come report sull'utilizzo di contatori di energia ed elettrodomestici.
- Dati dei grafi,ad esempio informazioni su come gli utenti sono collegati tra loro.
Modello di archiviazione Bigtable
Bigtable archivia i dati in tabelle ad altissima scalabilità, ciascuna delle quali è una mappa chiave/valore ordinata. La tabella è composta da righe, ciascuna delle quali generalmente descrive una singola entità, e colonne, che contengono singoli valori per ciascuna riga. Viene indicizzato un singolo valore in ogni riga. Questo valore è noto come chiave di riga. Le colonne correlate una all'altra sono generalmente raggruppate insieme in una famiglia di colonne. Ciascuna colonna è identificata da una combinazione della famiglia di colonne e di un qualificatore di colonna, che è un nome univoco all'interno della famiglia di colonne.
Ogni intersezione di una riga e di una colonna può contenere più celle. Ogni cella contiene una versione univoca con timestamp dei dati per la riga e la colonna. L'archiviazione di più celle in una colonna fornisce un record delle modifiche apportate ai dati archiviati per quella riga e colonna nel tempo. Le tabelle di Bigtable sono sparse; se una colonna non viene utilizzata in una riga specifica, non occupa alcuno spazio.
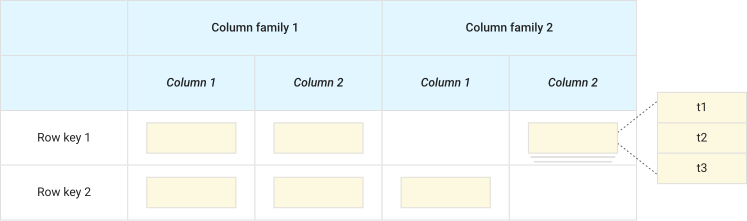
Alcuni elementi da notare in questa illustrazione:
- Le colonne possono non essere utilizzate in una riga.
- Ogni cella in una determinata riga e colonna ha un timestamp (t) univoco.
Architettura di Bigtable
Il seguente diagramma mostra una versione semplificata dell'architettura complessiva delle risorse di Bigtable:
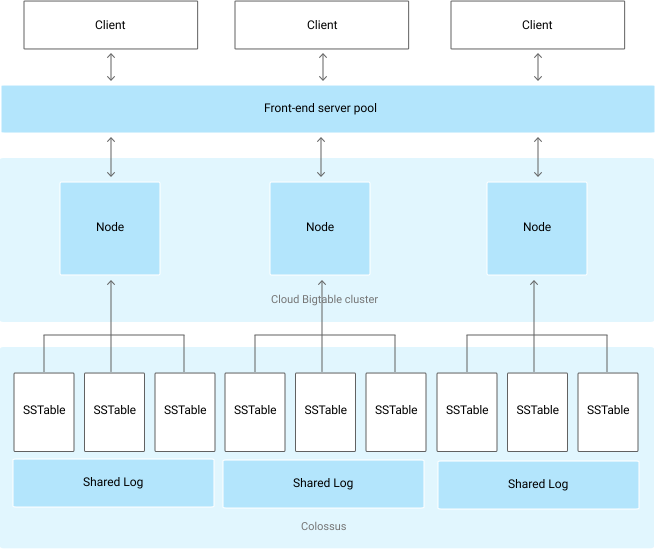
Come illustrato nel diagramma, tutte le richieste dei client passano attraverso un server frontend prima di essere inviate a un nodo Bigtable. (Nel documento originale su Bigtable, questi nodi sono chiamati "tablet server"). I nodi sono organizzati in un cluster Bigtable, che appartiene a un'istanza Bigtable, un container per il cluster.
Ogni nodo nel cluster gestisce un sottoinsieme delle richieste al cluster. Aggiungendo nodi a un cluster, puoi aumentare il numero di richieste simultanee che il cluster può gestire. L'aggiunta di nodi aumenta anche il throughput massimo del cluster. Se abiliti la replica aggiungendo altri cluster, puoi anche inviare diversi tipi di traffico a cluster diversi. In questo modo, se un cluster non è disponibile, puoi eseguire il failover su un altro cluster.
Una tabella Bigtable viene partizionata orizzontalmente in blocchi di righe contigue, denominati tablet, per consentire il bilanciamento del carico di lavoro delle query. (I tablet sono simili alle regioni di HBase.) I tablet vengono archiviati su Colossus, un file system sviluppato da Google, in formato SSTable. Una tabella SSTable fornisce un mapping permanente, ordinato e immutabile delle chiavi ai valori, in cui sia le chiavi che i valori sono stringhe di byte arbitrarie. Ogni tablet è associato a un nodo Bigtable specifico. Oltre ai file SSTable, tutte le scritture vengono archiviate nel log condiviso di Colossus non appena vengono confermate da Bigtable, garantendo una maggiore durabilità.
È importante sottolineare che i dati non vengono mai archiviati nei nodi Bigtable stessi; ogni nodo ha puntatori a un insieme di tablet archiviati su Colossus. Di conseguenza:
- Il ribilanciamento dei tablet da un nodo all'altro avviene rapidamente, perché i dati effettivi non vengono copiati. Bigtable aggiorna i puntatori per ogni nodo.
- Il ripristino in caso di errore di un nodo Bigtable è rapido, perché solo i metadati devono essere migrati al nodo sostitutivo.
- Se un nodo Bigtable non funziona, non viene perso alcun dato.
Per saperne di più su come utilizzare questi componenti di base, consulta Istanze, cluster e nodi. Per informazioni dettagliate sull'interazione con i dati in questi livelli, consulta Accesso ai dati.
Bilanciamento del carico
Ogni zona Bigtable è gestita da un processo principale, che bilancia il workload e il volume di dati all'interno dei cluster. Questo processo divide a metà i tablet più occupati o più grandi e unisce i tablet meno utilizzati/più piccoli, ridistribuendoli tra i nodi in base alle esigenze. Se un determinato tablet riceve un picco di traffico, Bigtable lo divide in due e sposta uno dei nuovi tablet in un altro nodo. Bigtable gestisce automaticamente la suddivisione, l'unione e il ribilanciamento, risparmiandoti l'onere di amministrare manualmente i tablet. La sezione Analizza il rendimento fornisce ulteriori dettagli su questa procedura.
Per ottenere le migliori prestazioni di scrittura da Bigtable, è importante distribuire le scritture nel modo più uniforme possibile tra i nodi. Un modo per raggiungere questo obiettivo è utilizzare chiavi di riga che non seguono un ordine prevedibile. Ad esempio, i nomi utente tendono a essere distribuiti in modo più o meno uniforme nell'alfabeto, quindi l'inclusione di un nome utente all'inizio della chiave di riga tenderà a distribuire le scritture in modo uniforme.
Allo stesso tempo, è utile raggruppare le righe correlate in modo che siano adiacenti, il che rende molto più efficiente la lettura di più righe contemporaneamente. Ad esempio, se memorizzi diversi tipi di dati meteorologici nel tempo, la chiave di riga potrebbe essere la località in cui sono stati raccolti i dati, seguita da un timestamp (ad esempio, WashingtonDC#201803061617). Questo tipo di chiave di riga raggruppa tutti i dati di una località in un intervallo di righe contigue. Per altre località, la riga inizierebbe con un identificatore diverso. Con molte località che raccolgono dati alla stessa velocità, le scritture verrebbero comunque distribuite in modo uniforme tra i tablet.
Per ulteriori dettagli sulla scelta di una chiave di riga appropriata per i tuoi dati, consulta Scelta di una chiave di riga.
Computing
Bigtable offre diverse opzioni di computing a seconda dei requisiti del tuo workload. Per impostazione predefinita, Bigtable utilizza i nodi del cluster sia per l'archiviazione che per il calcolo.
Per i job di lettura con throughput elevato, puoi utilizzare Data Boost per Bigtable per il computing. Data Boost ti consente di inviare job di lettura e query di grandi dimensioni utilizzando il serverless computing, mentre l'applicazione principale continua a utilizzare i nodi del cluster per il computing. Enterprise Plus estende le funzionalità di questi job per includere il supporto SQL, nonché l'accesso ai dati di archiviazione su HDD e a livelli. Per saperne di più, consulta la panoramica di Bigtable Data Boost.
Per i workload specializzati che richiedono un throughput elevato e una latenza di lettura dei punti inferiore al millisecondo, puoi attivare il livello in memoria per i nodi Bigtable.
Tipi di dati supportati
Bigtable tratta tutti i dati come stringhe di byte non elaborate per la maggior parte degli scopi. L'unico caso in cui Bigtable tenta di determinare il tipo è per le operazioni di incremento, in cui la destinazione deve essere un numero intero a 64 bit codificato come valore big-endian a 8 byte.
Utilizzo della memoria e del disco
Le sezioni seguenti descrivono in che modo diversi componenti di Bigtable influiscono sull'utilizzo della memoria e del disco per l'istanza.
Colonne inutilizzate
Le colonne non utilizzate in una riga Bigtable non occupano spazio in quella riga. Ogni riga è essenzialmente una raccolta di coppie chiave-valore, in cui la chiave è una combinazione di famiglia di colonne, qualificatore di colonna e timestamp. Se una riga non include un valore per una colonna specifica, la coppia chiave-valore non è presente.
Qualificatori di colonna
I qualificatori di colonna occupano spazio in una riga, poiché ogni qualificatore di colonna utilizzato in una riga viene archiviato in quella riga. Di conseguenza, spesso è efficiente utilizzare i qualificatori di colonna come dati.
Per saperne di più sui qualificatori di colonna, consulta Colonne.
Compattazioni
Bigtable riscrive periodicamente le tabelle per rimuovere le voci eliminate, riorganizzare i dati in modo che le operazioni di lettura e scrittura siano più efficienti e spostare i dati nell'ambito dell'archiviazione a livelli. Questo processo è noto come compattazione. Non esistono impostazioni di configurazione per le compattazioni: Bigtable compatta i dati automaticamente. In media, è necessaria una settimana per completare una compattazione ed eseguire attività come l'eliminazione dei dati o lo spostamento dei dati nello spazio di archiviazione a più livelli.La compattazione esegue le eliminazioni identificate dal processo di garbage collection. La compattazione non avvia la compressione dei dati; Bigtable comprime automaticamente i blocchi di dati quando vengono salvati nello spazio di archiviazione. Per saperne di più, consulta Compressione dei dati e Garbage collection. Per saperne di più sulle compattazioni nello spazio di archiviazione a livelli, consulta Come funziona lo spazio di archiviazione a livelli.
Mutazioni ed eliminazioni
Le mutazioni, o modifiche, di una riga occupano spazio di archiviazione aggiuntivo, perché Bigtable archivia le mutazioni in sequenza e le compatta solo periodicamente. Quando Bigtable compatta una tabella, rimuove i valori che non sono più necessari. Se aggiorni il valore in una cella, sia il valore originale sia il nuovo valore verranno archiviati sul disco per un certo periodo di tempo fino alla compattazione dei dati.
Inoltre, le eliminazioni occupano spazio di archiviazione aggiuntivo, almeno a breve termine, perché sono in realtà un tipo di mutazione specializzato. Finché la tabella non viene compattata, un'eliminazione utilizza spazio di archiviazione aggiuntivo anziché liberare spazio.
Compressione dei dati
Bigtable comprime automaticamente i dati utilizzando un algoritmo intelligente quando i dati vengono salvati su disco. Non puoi configurare le impostazioni di compressione per la tabella.
Compressione e compattazione
La compressione dei dati è diversa dalla compattazione della tabella:
La compressione avviene automaticamente quando i dati vengono scritti e resi persistenti nello spazio di archiviazione. La compressione riduce le dimensioni fisiche in byte dei blocchi di dati sul disco. Le metriche di utilizzo dello spazio di archiviazione e gli addebiti di fatturazione riflettono questa dimensione compressa anziché la dimensione dei dati logici non compressi.
La compattazione è un processo di manutenzione in background asincrono. La compattazione unisce periodicamente i file di archiviazione e rimuove definitivamente i dati eliminati e scaduti. La compattazione non avvia la compressione dei dati, che sono già archiviati in formato compresso.
È utile sapere come archiviare i dati in modo che possano essere compressi in modo efficiente:
I dati casuali non possono essere compressi con la stessa efficienza dei dati strutturati. I dati strutturati includono il testo, ad esempio la pagina che stai leggendo in questo momento.
La compressione funziona meglio se i valori identici sono vicini tra loro,nella stessa riga o in righe adiacenti. Se disponi le chiavi di riga in modo che le righe con blocchi di dati identici siano adiacenti, i dati possono essere compressi in modo efficiente.
Bigtable comprime i valori di dimensioni fino a 1 MiB. Se memorizzi valori superiori a 1 MiB, comprimili prima di scriverli in Bigtable, in modo da risparmiare cicli della CPU, memoria del server e larghezza di banda della rete.
Durabilità dei dati
Quando utilizzi Bigtable, i tuoi dati vengono archiviati su Colossus, un file system altamente durevole sviluppato da Google, utilizzando dispositivi di archiviazione nei data center diGoogle Cloud. Non è necessario eseguire un cluster HDFS o un altro file system per utilizzare Bigtable. Dietro le quinte, Colossus utilizza metodi di archiviazione proprietari per ottenere una durabilità dei dati superiore a quella fornita dalla replica a tre vie standard di HDFS.
La durabilità è ulteriormente migliorata quando si utilizza la replica. Bigtable conserva una copia separata dei tuoi dati nella località che selezioni per ogni cluster di un'istanza replicata.
Modello di coerenza
Le istanze Bigtable a cluster singolo offrono un'elevata coerenza. Per impostazione predefinita, le istanze con più di un cluster forniscono la coerenza finale, ma per alcuni casi d'uso possono essere configurate per fornire la coerenza di lettura delle scritture o l'elevata coerenza, a seconda del workload e delle impostazioni del profilo dell'app.
Sicurezza
L'accesso alle tabelle Bigtable è controllato dal tuo progetto Google Cloud e dai ruoli di Identity and Access Management (IAM) che assegni agli utenti. Ad esempio, puoi assegnare ruoli IAM che impediscono ai singoli utenti di leggere dalle tabelle, scrivere nelle tabelle o creare nuove istanze. Se un utente non ha accesso al tuo progetto o non dispone di un ruolo IAM con le autorizzazioni appropriate per Bigtable, non può accedere alle tue tabelle.
Puoi anche controllare l'accesso ai dati della tabella creando una vista autorizzata di una tabella che rappresenta un sottoinsieme dei dati della tabella. Puoi quindi concedere autorizzazioni a livello di vista autorizzata ad alcuni utenti senza concedere loro autorizzazioni a livello di tabella. Puoi gestire la sicurezza a livello di progetto, istanza, tabella o visualizzazione autorizzata. Bigtable non supporta le limitazioni di sicurezza a livello di riga, colonna o cella.Crittografia
Per impostazione predefinita, tutti i dati archiviati in Google Cloud, inclusi i dati nelle tabelle Bigtable, sono criptati at-rest utilizzando gli stessi sistemi avanzati di gestione delle chiavi che utilizziamo per i nostri dati criptati.
Se vuoi un maggiore controllo sulle chiavi utilizzate per criptare i tuoi dati Bigtable at-rest, puoi utilizzare le chiavi di crittografia gestite dal cliente (CMEK).
Backup
I backup di Bigtable consentono di salvare una copia dello schema e dei dati di una tabella e di ripristinarli in una nuova tabella in un secondo momento. Utilizzando i backup e le copie di backup, puoi eseguire il ripristino in una nuova tabella in qualsiasi regione o progetto in cui hai un'istanza Bigtable, indipendentemente dalla posizione della tabella di origine.
Change Data Capture (CDC)
Bigtable fornisce Change Data Capture (CDC) sotto forma di feed delle modifiche. Le modifiche in tempo reale consentono di acquisire e trasmettere le modifiche ai dati di una tabella man mano che si verificano. Puoi leggere le modifiche in tempo reale utilizzando un servizio come Dataflow per supportare casi d'uso tra cui dati e analisi, audit, requisiti di archiviazione e attivazione della logica delle applicazioni downstream. Per saperne di più, consulta la panoramica delle modifiche in tempo reale.
Routing delle richieste con i profili dell'app
Le policy di routing del profilo dell'app ti consentono di controllare quali cluster gestiscono le richieste in entrata dalle tue applicazioni. Bigtable offre i seguenti tipi di profili app in base al modello di computing utilizzato:
Profili dell'app standard: utilizzano i nodi del cluster di cui è stato eseguito il provisioning per gestire le richieste. Supportano le seguenti policy di routing:
Routing a un cluster singolo: invia tutte le richieste a un singolo cluster.
Puoi abilitare il livello in memoria (anteprima) solo per i profili app che utilizzano il routing a cluster singolo. Quando configuri un profilo dell'app per utilizzare il livello in memoria su un cluster, tutto il traffico di lettura puntuale idoneo utilizza il livello in memoria.
Routing multi-cluster a qualsiasi cluster: invia le richieste al cluster disponibile più vicino in un'istanza, tra tutti i cluster o un gruppo di cluster specificato.
Profili dell'app Data Boost: utilizza il serverless computing anziché i nodi del cluster per isolare i job di lettura con throughput elevato dal traffico dell'applicazione principale. Questi profili sono limitati a una policy di routing a cluster singolo.
Altre opzioni di archiviazione e database
Bigtable non è un database relazionale tradizionale. Sebbene supporti le query SQL, alcuni casi d'uso potrebbero essere più adatti per un'altra opzione di database.
- Se devi archiviare oggetti altamente strutturati in un database di documenti con supporto per le transazioni ACID e le query di tipo SQL, prendi in considerazione Firestore.
- Per sincronizzare dati tra utenti in tempo reale, prendi in considerazione Firebase Realtime Database.
- Se hai bisogno di query interattive in un sistema di elaborazione analitica online (OLAP), prendi in considerazione BigQuery.
Per saperne di più su altre opzioni di database, consulta la panoramica dei servizi di database. Google Cloud offre anche varie opzioni di archiviazione.
Passaggi successivi
- Prova una guida rapida di Bigtable utilizzando l'
cbtinterfaccia a riga di comando, lo strumento a riga di comando per Bigtable. - Segui un codelab di Bigtable.
- Scopri di più su istanze, cluster e nodi Bigtable.
- Scopri di più sull'archiviazione a livelli di Bigtable.
- Scopri di più sulle versioni di Bigtable.
- Scopri di più sul livello in memoria di Bigtable.
- Scopri come creare un'istanza Bigtable.
- Scopri come eseguire la migrazione a Bigtable.
- Scopri di più sulle librerie client per Cloud Bigtable.
- Leggi il documento OSDI originale su Bigtable.