


Dokumen ini ditujukan bagi developer software dan administrator database yang ingin memigrasikan aplikasi yang ada atau mendesain aplikasi baru untuk digunakan dengan Bigtable sebagai database. Dokumen ini menerapkan pengetahuan Anda tentang Apache Cassandra untuk menggunakan Bigtable guna menjelaskan konsep yang harus Anda pahami sebelum bermigrasi. Untuk mengetahui informasi tentang alat open source yang dapat Anda gunakan untuk menyelesaikan migrasi, lihat Memigrasikan dari Cassandra ke Bigtable.
Bigtable dan Cassandra adalah database terdistribusi. Layanan ini menerapkan penyimpanan nilai kunci multidimensi yang dapat mendukung puluhan ribu kueri per detik (QPS), pembacaan dan penulisan latensi rendah, penyimpanan yang dapat menskalakan hingga petabyte data, dan toleransi untuk kegagalan node.
Kapan Bigtable menjadi tujuan yang tepat untuk workload Cassandra
Layanan Google Cloud terbaik untuk workload Cassandra Anda bergantung pada sasaran migrasi dan fungsi Cassandra yang Anda perlukan setelah migrasi.
Jika satu atau beberapa kondisi berikut berlaku, Bigtable adalah pilihan yang optimal:
- Anda menginginkan layanan terkelola sepenuhnya tanpa masa pemeliharaan dan ketersediaan tinggi.
- Anda memerlukan penskalaan elastis yang merespons perubahan traffic server secara otomatis.
- Anda memerlukan latensi milidetik satu digit yang konsisten untuk operasi baca dan tulis.
- Anda menggunakan jenis koleksi, penghitung, atau tampilan terwujud Cassandra selain jenis skalar, yang dioptimalkan untuk Bigtable.
- Anda memiliki aplikasi yang menggunakan parameter
USING TIMESTAMP. - Throughput dan latensi tulis Anda sama pentingnya dengan baca.
- Anda mengandalkan salah satu model replikasi Cassandra yang memiliki konsistensi tertunda.
- Kasus penggunaan Anda memerlukan penyimpanan yang hemat biaya.
Untuk memigrasikan aplikasi tanpa perubahan kode apa pun, Anda dapat memilih untuk mengelola Cassandra sendiri di GKE atau menggunakan partner Google Cloud seperti DataStax atau ScyllaDB. Jika aplikasi Anda banyak melakukan operasi baca dan Anda bersedia memfaktorkan ulang kode untuk mendapatkan kemampuan database relasional dan konsistensi yang kuat, Anda dapat mempertimbangkan Spanner.
Dokumen ini memberikan tips tentang hal-hal yang perlu dipertimbangkan saat melakukan refaktorisasi aplikasi, jika Anda memilih Bigtable sebagai target migrasi untuk workload Cassandra.
Cara menggunakan dokumen ini
Anda tidak perlu membaca dokumen ini dari awal hingga akhir. Meskipun dokumen ini memberikan perbandingan kedua database, Anda juga dapat berfokus pada topik yang berlaku untuk kasus penggunaan atau minat Anda.
Untuk membantu Anda membandingkan Bigtable dan Cassandra, dokumen ini melakukan hal berikut:
- Membandingkan terminologi, yang dapat berbeda antara kedua database.
- Memberikan ringkasan tentang kedua sistem database.
- Melihat cara setiap database menangani pemodelan data untuk memahami berbagai pertimbangan desain.
- Membandingkan jalur yang diambil oleh data selama penulisan dan pembacaan.
- Memeriksa tata letak data fisik untuk memahami aspek arsitektur database.
- Menjelaskan cara mengonfigurasi replikasi geografis untuk memenuhi persyaratan Anda, dan cara menentukan ukuran cluster.
- Meninjau detail tentang pengelolaan, pemantauan, dan keamanan cluster.
Perbandingan terminologi
Meskipun banyak konsep yang digunakan di Bigtable dan Cassandra serupa, setiap database memiliki konvensi penamaan yang sedikit berbeda dan perbedaan kecil.
Salah satu elemen penyusun inti kedua database adalah tabel string yang diurutkan (SSTable). Dalam kedua arsitektur, SSTable dibuat untuk menyimpan data ke dalam penyimpanan non-volatil yang digunakan untuk merespons kueri baca.
Dalam postingan blog (2012), Ilya Grigorik menulis sebagai berikut: "SSTable adalah abstraksi sederhana untuk menyimpan sejumlah besar pasangan nilai kunci secara efisien sambil mengoptimalkan throughput tinggi, beban kerja baca atau tulis berurutan."
Tabel berikut menguraikan dan menjelaskan konsep bersama serta terminologi terkait yang digunakan setiap produk:
| Cassandra | Bigtable |
|---|---|
|
kunci utama: nilai unik satu atau beberapa kolom yang menentukan penempatan dan pengurutan data. kunci partisi: nilai satu atau beberapa kolom yang menentukan penempatan data berdasarkan hash yang konsisten. kolom pengelompokan: nilai satu atau multi-bidang yang menentukan pengurutan data leksikografis dalam partisi. |
kunci baris: string byte tunggal unik yang menentukan penempatan data dengan pengurutan leksikografis. Kunci komposit ditiru dengan menggabungkan data dari beberapa kolom menggunakan pembatas umum—misalnya, simbol hash (#) atau persen (%). |
| node: mesin yang bertanggung jawab untuk membaca dan menulis data yang terkait dengan serangkaian rentang hash partisi kunci utama. Di Cassandra, data disimpan di penyimpanan tingkat blok yang terpasang ke server node. | node: resource komputasi virtual yang bertanggung jawab untuk membaca dan menulis data yang terkait dengan serangkaian rentang row key. Di Bigtable, data tidak ditempatkan bersama dengan node komputasi. Sebagai gantinya, data disimpan di Colossus, sistem file terdistribusi Google. Node diberi tanggung jawab sementara untuk menyalurkan berbagai rentang data berdasarkan beban operasi dan kesehatan node lain dalam cluster. |
|
pusat data: mirip dengan cluster Bigtable, tetapi beberapa aspek topologi dan strategi replikasi dapat dikonfigurasi di Cassandra. rak: pengelompokan node di pusat data yang memengaruhi penempatan replika. |
cluster: sekelompok node di zona geografisGoogle Cloud yang sama, yang ditempatkan bersama untuk masalah latensi dan replikasi. |
| cluster: deployment Cassandra yang terdiri dari kumpulan pusat data. | instance: grup cluster Bigtable di zona atau region Google Cloud yang berbeda yang di antaranya terjadi replikasi dan perutean koneksi. |
| vnode: rentang tetap nilai hash yang ditetapkan ke node fisik tertentu. Data dalam vnode disimpan secara fisik di node Cassandra dalam serangkaian SSTable. | tablet: SSTable yang berisi semua data untuk rentang berkelanjutan dari row key yang diurutkan secara leksikografis. Tablet tidak disimpan di node di Bigtable, tetapi disimpan dalam serangkaian SSTable di Colossus. |
| faktor replikasi: jumlah replika vnode yang dipertahankan di semua node di pusat data. Faktor replikasi dikonfigurasi secara independen untuk setiap pusat data. | replikasi: proses mereplikasi data yang disimpan di Bigtable ke semua cluster dalam instance. Replikasi dalam cluster zona ditangani oleh lapisan penyimpanan Colossus. |
| table (sebelumnya grup kolom): organisasi nilai logis yang diindeks oleh kunci utama yang unik. | tabel: organisasi nilai logis yang diindeks oleh row key unik. |
| keyspace: namespace tabel logis yang menentukan faktor replikasi untuk tabel yang dimuatnya. | Tidak berlaku. Bigtable menangani masalah keyspace secara transparan. |
| map: jenis koleksi Cassandra yang menyimpan key-value pair. | grup kolom: namespace yang ditentukan pengguna yang mengelompokkan pengubah kolom untuk pembacaan dan penulisan yang lebih efisien. Saat membuat kueri Bigtable menggunakan SQL, grup kolom diperlakukan seperti peta Cassandra. |
| kunci peta: kunci yang secara unik mengidentifikasi entri nilai kunci dalam peta Cassandra | penentu kolom: label untuk nilai yang disimpan dalam tabel yang diindeks oleh row key unik. Saat membuat kueri Bigtable menggunakan SQL, kolom diperlakukan seperti kunci peta. |
| kolom: label untuk nilai yang disimpan dalam tabel yang diindeks oleh kunci utama unik. | kolom: label untuk nilai yang disimpan dalam tabel yang diindeks oleh row key unik. Nama kolom dibuat dengan menggabungkan grup kolom dengan penentu kolom. |
| cell: nilai stempel waktu dalam tabel yang terkait dengan perpotongan kunci utama dengan kolom. | sel: nilai stempel waktu dalam tabel yang terkait dengan persimpangan row key dengan nama kolom. Beberapa versi dengan stempel waktu dapat disimpan dan diambil untuk setiap sel. |
| counter: jenis kolom yang dapat ditingkatkan dan dioptimalkan untuk operasi penjumlahan bilangan bulat. | penghitung: sel yang menggunakan jenis data khusus untuk operasi penjumlahan bilangan bulat. Untuk mengetahui informasi selengkapnya, lihat Membuat dan memperbarui penghitung. |
| kebijakan load balancing: kebijakan yang Anda konfigurasi dalam logika aplikasi untuk merutekan operasi ke node yang sesuai dalam cluster. Kebijakan ini memperhitungkan topologi pusat data dan rentang token vnode. | profil aplikasi: setelan yang memberi tahu Bigtable cara merutekan panggilan API klien ke cluster yang sesuai dalam instance. Anda juga dapat menggunakan profil aplikasi sebagai tag untuk menyegmentasikan metrik. Anda mengonfigurasi profil aplikasi di layanan. |
| CQL: Cassandra Query Language, bahasa seperti SQL yang digunakan untuk pembuatan tabel, perubahan skema, mutasi baris, dan kueri. | Klien Cassandra ke Bigtable untuk Java adalah pengganti yang lancar untuk driver Cassandra Anda. Klien Java memahami kueri CQL Anda, dan memungkinkan Anda menggunakan Bigtable secara transparan dengan aplikasi berbasis Cassandra yang ada tanpa menulis ulang kode. Cassandra to Bigtable proxy adapter adalah lapisan mandiri yang dapat Anda jalankan secara paralel dengan aplikasi dan hubungkan ke Bigtable sebagai node Cassandra lain. Adaptor proxy memberikan kompatibilitas dengan CQL serta mendukung penulisan ganda dan migrasi massal. Fungsi ini mirip dengan yang ditawarkan oleh klien Cassandra ke Bigtable untuk Java. Bigtable API adalah library klien dan gRPC API yang digunakan untuk pembuatan instance dan cluster, pembuatan tabel dan grup kolom, mutasi baris, dan eksekusi kueri. SQL API Bigtable sudah tidak asing lagi bagi pengguna CQL. |
tampilan terwujud: pernyataan SELECT yang menentukan sekumpulan
baris yang sesuai dengan baris dalam tabel sumber yang mendasarinya. Saat tabel sumber berubah, Cassandra akan otomatis memperbarui tampilan terwujud.
|
tampilan terwujud berkelanjutan: hasil kueri SQL yang telah dihitung sebelumnya dan dikelola sepenuhnya, yang diupdate secara inkremental dan otomatis dari tabel sumber. Untuk mengetahui informasi selengkapnya, lihat Tampilan terwujud berkelanjutan. |
Ringkasan Produk
Bagian berikut memberikan ringkasan filosofi desain dan atribut utama Bigtable dan Cassandra.
Bigtable
Bigtable menyediakan banyak fitur inti yang dijelaskan dalam makalah Bigtable: A Distributed Storage System for Structured Data. Bigtable memisahkan node komputasi, yang melayani permintaan klien, dari pengelolaan penyimpanan yang mendasarinya. Data disimpan di Colossus. Lapisan penyimpanan secara otomatis mereplikasi data untuk memberikan ketahanan yang melampaui tingkat yang diberikan oleh replikasi tiga arah Hadoop Distributed File System (HDFS) standar.
Arsitektur ini menyediakan operasi baca dan tulis yang konsisten dalam cluster, menskalakan naik dan turun tanpa biaya redistribusi penyimpanan, serta dapat menyeimbangkan ulang workload tanpa mengubah cluster atau skema. Jika ada node pemrosesan data yang terganggu, layanan Bigtable akan menggantinya secara transparan. Bigtable juga mendukung replikasi asinkron.
Selain gRPC dan library klien untuk berbagai bahasa pemrograman, Bigtable mempertahankan kompatibilitas dengan library klien Java HBase open source Apache, yang merupakan implementasi mesin database open source alternatif dari makalah Bigtable.
Diagram berikut menunjukkan cara Bigtable memisahkan node pemrosesan dari lapisan penyimpanan secara fisik:
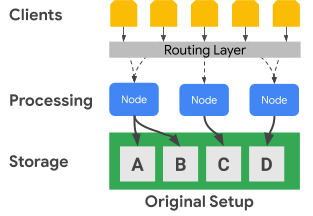
Dalam diagram sebelumnya, node pemrosesan tengah hanya bertanggung jawab untuk melayani permintaan data untuk set data C di lapisan penyimpanan. Jika Bigtable mengidentifikasi bahwa penyeimbangan ulang penetapan rentang diperlukan untuk set data, rentang data untuk node pemrosesan mudah diubah karena lapisan penyimpanan dipisahkan dari lapisan pemrosesan.
Diagram berikut menunjukkan, dalam istilah yang disederhanakan, penyeimbangan ulang rentang kunci dan pengubahan ukuran cluster:
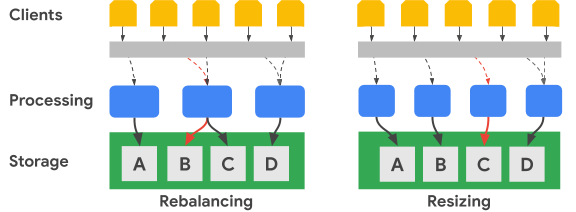
Gambar Penyeimbangan ulang mengilustrasikan status cluster Bigtable setelah node pemrosesan paling kiri menerima peningkatan jumlah permintaan untuk set data A. Setelah penyeimbangan ulang terjadi, node tengah, bukan node paling kiri, bertanggung jawab untuk melayani permintaan data untuk set data B. Node paling kiri terus melayani permintaan untuk set data A.
Bigtable dapat mengatur ulang rentang row key untuk menyeimbangkan rentang set data di seluruh jumlah node pemrosesan yang tersedia. Gambar Mengubah ukuran menunjukkan status cluster Bigtable setelah Anda menambahkan node.
Cassandra
Apache Cassandra adalah database open source yang sebagian dipengaruhi oleh konsep dari dokumen Bigtable. Solusi ini menggunakan arsitektur node terdistribusi, dengan penyimpanan yang ditempatkan bersama server yang merespons operasi data. Serangkaian node virtual (vnode) ditetapkan secara acak ke setiap server untuk menyajikan sebagian keyspace cluster.
Data disimpan di vnode berdasarkan kunci partisi. Biasanya, fungsi hash yang konsisten digunakan untuk membuat token guna menentukan penempatan data. Seperti Bigtable, Anda dapat menggunakan partisi yang mempertahankan urutan untuk pembuatan token, dan dengan demikian juga untuk penempatan data. Namun, dokumentasi Cassandra tidak menyarankan pendekatan ini karena cluster kemungkinan akan menjadi tidak seimbang, kondisi yang sulit diperbaiki. Oleh karena itu, dokumen ini mengasumsikan bahwa Anda menggunakan strategi hashing yang konsisten untuk menghasilkan token yang menghasilkan distribusi data di seluruh node.
Cassandra menyediakan fault tolerance melalui tingkat ketersediaan yang berkorelasi dengan tingkat konsistensi yang dapat disesuaikan, sehingga memungkinkan cluster melayani klien saat satu atau beberapa node terganggu. Anda menentukan replikasi geografis melalui strategi topologi replikasi data yang dapat dikonfigurasi.
Anda menentukan tingkat konsistensi untuk setiap operasi. Setelan umumnya adalah
QUORUM (atau LOCAL_QUORUM dalam topologi pusat data ganda tertentu). Setelan tingkat konsistensi ini memerlukan sebagian besar node replika untuk merespons node koordinator agar operasi dianggap berhasil. Faktor replikasi, yang Anda konfigurasi untuk setiap keyspace, menentukan jumlah replika data yang disimpan di setiap pusat data dalam cluster. Misalnya, nilai faktor replikasi 3 biasanya digunakan untuk memberikan keseimbangan praktis antara daya tahan dan volume penyimpanan.
Diagram berikut menunjukkan secara sederhana cluster yang terdiri dari enam node dengan rentang kunci setiap node dibagi menjadi lima vnode. Dalam praktiknya, Anda dapat memiliki lebih banyak node, dan kemungkinan akan memiliki lebih banyak vnode.
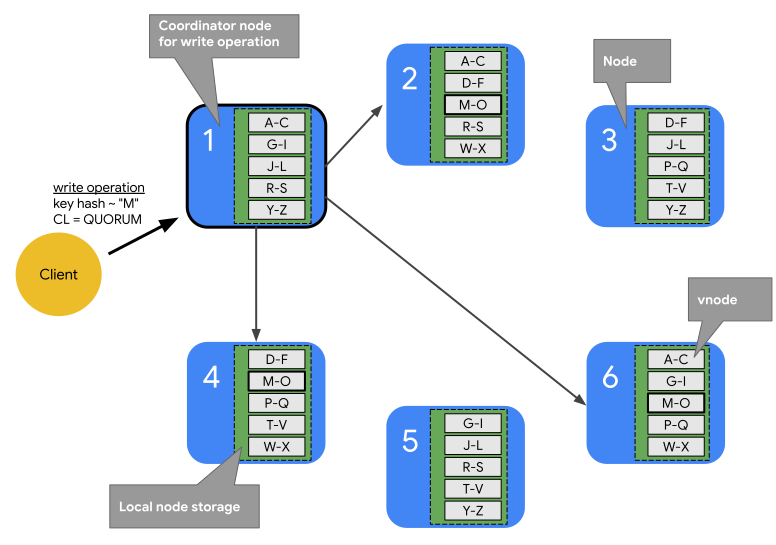
Pada diagram sebelumnya, Anda dapat melihat jalur operasi tulis, dengan tingkat konsistensi QUORUM, yang berasal dari aplikasi klien atau layanan (Client). Untuk tujuan diagram ini, rentang kunci ditampilkan sebagai rentang alfabet. Pada kenyataannya, token yang dihasilkan oleh hash kunci utama adalah bilangan bulat bertanda yang sangat besar.
Dalam contoh ini, hash kuncinya adalah M, dan vnode untuk M ada di node 2,
4, dan 6. Koordinator harus menghubungi setiap node tempat rentang hash kunci disimpan secara lokal agar penulisan dapat diproses. Karena tingkat konsistensi
adalah QUORUM, dua replika (mayoritas) harus merespons node koordinator
sebelum klien diberi tahu bahwa penulisan telah selesai.
Berbeda dengan Bigtable, memindahkan atau mengubah rentang kunci di Cassandra mengharuskan Anda menyalin data secara fisik dari satu node ke node lainnya. Jika satu node kelebihan beban dengan permintaan untuk rentang hash token tertentu, penambahan pemrosesan untuk rentang token tersebut lebih rumit di Cassandra dibandingkan dengan Bigtable.
Replikasi dan konsistensi geografis
Bigtable dan Cassandra menangani replikasi dan konsistensi geografis (juga dikenal sebagai multi-region) secara berbeda. Cluster Cassandra terdiri dari node pemrosesan yang dikelompokkan ke dalam rak, dan rak dikelompokkan ke dalam pusat data. Cassandra menggunakan strategi topologi jaringan yang Anda konfigurasi untuk menentukan cara replika vnode didistribusikan di seluruh host di pusat data. Strategi ini mengungkapkan akar Cassandra sebagai database yang awalnya di-deploy di pusat data on-premise fisik. Konfigurasi ini juga menentukan faktor replikasi untuk setiap pusat data dalam cluster.
Cassandra menggunakan konfigurasi pusat data dan rak untuk meningkatkan fault tolerance replika data. Selama operasi baca dan tulis, topologi menentukan node peserta yang diperlukan untuk memberikan jaminan konsistensi. Anda harus mengonfigurasi node, rak, dan pusat data secara manual saat membuat atau memperluas cluster. Dalam lingkungan cloud, deployment Cassandra standar memperlakukan zona cloud sebagai rak dan region cloud sebagai pusat data.
Anda dapat menggunakan kontrol kuorum Cassandra untuk menyesuaikan jaminan konsistensi untuk setiap operasi baca atau tulis. Tingkat kekuatan konsistensi tertunda dapat
bervariasi, termasuk opsi yang memerlukan satu node replika (ONE), mayoritas node replika pusat data tunggal (LOCAL_QUORUM), atau mayoritas semua
node replika di semua pusat data (QUORUM).
Di Bigtable, cluster adalah resource zona. Instance Bigtable dapat berisi satu cluster, atau dapat berupa grup cluster yang direplikasi sepenuhnya. Anda dapat menempatkan cluster instance di kombinasi zona mana pun di seluruh region yang ditawarkan Google Cloud . Anda dapat menambahkan dan menghapus cluster dari instance dengan dampak minimal pada cluster lain dalam instance.
Di Bigtable, penulisan dilakukan (dengan konsistensi baca-tulis Anda) pada satu cluster dan pada akhirnya akan konsisten di cluster instance lainnya. Karena setiap sel diberi versi berdasarkan stempel waktu, tidak ada penulisan yang hilang, dan setiap cluster menyajikan sel yang memiliki stempel waktu terbaru yang tersedia.
Layanan ini mengekspos status konsistensi cluster. Cloud Bigtable API menyediakan mekanisme untuk mendapatkan token konsistensi tingkat tabel. Anda dapat menggunakan token ini untuk memastikan apakah semua perubahan yang dilakukan pada tabel tersebut sebelum token dibuat telah direplikasi sepenuhnya.
Dukungan transaksi
Meskipun tidak ada database yang mendukung transaksi multi-baris yang kompleks, setiap database memiliki beberapa dukungan transaksi.
Cassandra memiliki metode transaksi ringan (LWT) yang menyediakan atomisitas untuk update pada nilai kolom dalam satu partisi. Cassandra juga memiliki semantik compare and set yang menyelesaikan operasi baca baris dan perbandingan nilai sebelum penulisan dimulai.
Bigtable mendukung operasi tulis baris tunggal yang sepenuhnya konsisten dalam cluster. Transaksi satu baris dapat dilakukan lebih lanjut melalui operasi baca-ubah-tulis dan periksa-dan-ubah. Profil aplikasi pemilihan rute multi-cluster tidak mendukung transaksi satu baris.
Model data
Bigtable dan Cassandra mengatur data ke dalam tabel yang mendukung pencarian dan pemindaian rentang menggunakan ID unik baris. Kedua sistem diklasifikasikan sebagai penyimpanan kolom lebar NoSQL.
Di Cassandra, Anda harus menggunakan CQL untuk membuat skema tabel lengkap terlebih dahulu, termasuk definisi kunci utama beserta nama kolom dan jenisnya. Kunci utama di Cassandra adalah nilai gabungan unik yang terdiri dari kunci partisi wajib dan kunci cluster opsional. Kunci partisi menentukan penempatan node baris, dan kunci cluster menentukan tata urutan dalam partisi. Saat membuat skema, Anda harus menyadari potensi kompromi antara menjalankan pemindaian yang efisien dalam satu partisi dan biaya sistem yang terkait dengan mempertahankan partisi besar.
Di Bigtable, Anda hanya perlu membuat tabel dan menentukan grup kolomnya terlebih dahulu. Kolom tidak dideklarasikan saat tabel dibuat, tetapi dibuat saat panggilan API aplikasi menambahkan sel ke baris tabel.
Row key diurutkan secara leksikografis di seluruh cluster Bigtable. Node dalam Bigtable secara otomatis menyeimbangkan tanggung jawab node untuk rentang kunci, yang sering disebut sebagai tablet dan terkadang sebagai pemisahan . Row key Bigtable sering kali terdiri dari beberapa nilai kolom yang digabungkan menggunakan karakter pemisah yang umum digunakan yang Anda pilih (seperti tanda persen). Jika dipisahkan, setiap komponen string akan serupa dengan kolom kunci utama Cassandra.
Desain row key
Di Bigtable, ID unik baris tabel adalah row key. Kunci baris harus berupa nilai unik tunggal di seluruh tabel. Anda dapat membuat kunci multi-bagian dengan menggabungkan elemen berbeda yang dipisahkan oleh pembatas umum. Kunci baris menentukan urutan pengurutan data global dalam tabel. Layanan Bigtable secara dinamis menentukan rentang kunci yang ditetapkan ke setiap node.
Berbeda dengan Cassandra, yang hash kunci partisinya menentukan penempatan baris dan kolom pengelompokan menentukan pengurutan, kunci baris Bigtable menyediakan penetapan dan pengurutan nodal. Seperti Cassandra, Anda harus mendesain row key di Bigtable sehingga baris yang ingin Anda ambil bersama-sama disimpan bersama-sama. Namun, di Bigtable, Anda tidak diwajibkan untuk mendesain row key untuk penempatan dan pengurutan sebelum menggunakan tabel.
Jenis data
Layanan Bigtable tidak menerapkan jenis data kolom yang dikirim klien. Library klien menyediakan metode bantuan untuk menulis nilai sel sebagai byte, string berenkode UTF-8, dan bilangan bulat 64-bit berenkode big-endian (bilangan bulat berenkode big-endian diperlukan untuk operasi penambahan atomik).
Grup kolom
Di Bigtable, grup kolom menentukan kolom mana dalam tabel yang disimpan dan diambil bersama. Setiap tabel memerlukan setidaknya satu grup kolom, meskipun tabel sering kali memiliki lebih banyak (batasnya adalah 100 grup kolom untuk setiap tabel). Anda harus membuat grup kolom secara eksplisit sebelum aplikasi dapat menggunakannya dalam operasi.
Penentu kolom
Setiap nilai yang disimpan dalam tabel pada row key dikaitkan dengan label yang disebut penentu kolom. Karena penentu kolom hanya berupa label, tidak ada batasan praktis untuk jumlah kolom yang dapat Anda miliki dalam grup kolom. Penentu kolom sering digunakan di Bigtable untuk merepresentasikan data aplikasi.
Sel
Di Bigtable, sel adalah persimpangan row key dan nama kolom (grup kolom yang digabungkan dengan penentu kolom). Setiap sel berisi satu atau beberapa nilai berstempel waktu yang dapat diberikan oleh klien atau diterapkan secara otomatis oleh layanan. Nilai sel lama diklaim kembali berdasarkan kebijakan pembersihan sampah memori yang dikonfigurasi di tingkat grup kolom.
Indeks sekunder
Anda dapat menggunakan tampilan terwujud berkelanjutan sebagai indeks sekunder asinkron untuk tabel guna membuat kueri data yang sama menggunakan pola atau atribut penelusuran yang berbeda. Untuk mengetahui informasi selengkapnya, lihat Membuat indeks sekunder asinkron.
Pemodelan data: fleksibilitas dengan koleksi
Adaptor proxy Cassandra ke Bigtable mengubah jenis koleksi Cassandra, seperti peta, set, dan daftar, menjadi family kolom di Bigtable. Hal ini membuat penggunaan Bigtable dengan jenis koleksi Cassandra sangat efisien, karena kolom individual dapat ditulis dan dibaca jauh lebih cepat daripada blob tunggal.
Dengan Bigtable, Anda dapat membangun aplikasi dengan koleksi besar dan dinamis tanpa mengorbankan performa yang diperlukan oleh Cassandra, karena alasan berikut:
- Bigtable menyimpan elemen koleksi sebagai sel individual, sehingga operasi pada elemen sangat terperinci. Artinya, satu update peta diterjemahkan menjadi penulisan sel ringan, yang memberikan performa dan skalabilitas tinggi.
- Koleksi Bigtable tidak memiliki batas ukuran praktis, selain batas ukuran baris umum.
- Bigtable mempertahankan latensi rendah yang konsisten, terlepas dari seberapa besar koleksi berkembang, seperti yang ditunjukkan pada Gambar 4.
Sebaliknya, dokumentasi Cassandra mendorong Anda untuk membatasi penggunaan jenis koleksi secara ketat dan sering kali membatasi jumlah elemen ke angka kecil karena penurunan performa. Karena Cassandra membaca kolom koleksi secara keseluruhan, koleksi besar pasti menyebabkan lonjakan latensi baca dan potensi ketidakstabilan node.
Anda dapat melewati batas ini dengan solusi seperti koleksi yang dibekukan atau menyimpan data sebagai string JSON, yang mengorbankan performa dengan memperkenalkan biaya baca-ubah-tulis. Overhead ini memaksa database untuk membaca, melakukan deserialisasi, mengupdate, dan menulis ulang seluruh objek untuk setiap perubahan. Selain itu, Cassandra memperlakukan blob JSON ini sebagai teks buram, yang memerlukan semua logika penguraian di lapisan aplikasi Anda. Hal ini berbeda dengan Bigtable, yang menyediakan pemrosesan sisi server bawaan untuk string JSON melalui fungsi SQL API.
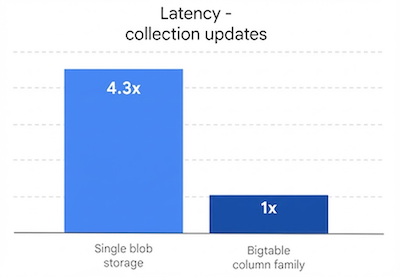
Bigtable memungkinkan Anda menggabungkan elemen skema tetap dengan elemen dinamis tanpa kompromi. Hal ini memberi aplikasi Anda fleksibilitas untuk menerapkan struktur di tempat yang penting sekaligus tetap gesit, sehingga Anda dapat mengembangkan model data tanpa migrasi atau waktu non-operasional yang ekstensif. Layanan ini juga mendukung workload modern, seperti machine learning dan AI, yang memerlukan iterasi yang sering pada Feature Store dan penayangan real-time dalam skala global.
Load balancing dan failover klien
Di Cassandra, klien mengontrol load balancing permintaan. Driver klien menetapkan kebijakan yang ditentukan sebagai bagian dari konfigurasi atau secara terprogram selama pembuatan sesi. Cluster memberi tahu kebijakan tentang pusat data yang paling dekat dengan aplikasi, dan klien mengidentifikasi node dari pusat data tersebut untuk melayani operasi.
Layanan Bigtable merutekan panggilan API ke cluster tujuan berdasarkan parameter (ID profil aplikasi) yang diberikan dengan setiap operasi. Profil aplikasi dikelola dalam layanan Bigtable; operasi klien yang tidak memilih profil menggunakan profil default.
Bigtable memiliki dua jenis kebijakan perutean profil aplikasi: cluster tunggal dan multi-cluster. Profil multi-cluster merutekan operasi ke cluster terdekat yang tersedia. Cluster di region yang sama dianggap berjarak sama dari perspektif perute operasi. Jika node yang bertanggung jawab atas rentang kunci yang diminta kelebihan beban atau tidak tersedia untuk sementara di cluster, jenis profil ini menyediakan failover otomatis.
Dalam hal Cassandra, kebijakan multi-cluster memberikan manfaat failover dari kebijakan load balancing yang mengetahui pusat data.
Profil aplikasi yang memiliki pemilihan rute cluster tunggal mengarahkan semua traffic ke satu cluster. Konsistensi baris yang kuat dan transaksi satu baris hanya tersedia di profil yang memiliki pemilihan rute cluster tunggal.
Kelemahan pendekatan cluster tunggal adalah bahwa dalam failover, aplikasi harus dapat mencoba ulang menggunakan ID profil aplikasi alternatif, atau Anda harus melakukan failover secara manual pada profil pemilihan rute cluster tunggal yang terpengaruh.
Pemilihan rute operasi
Cassandra dan Bigtable menggunakan metode yang berbeda untuk memilih node pemrosesan untuk operasi baca dan tulis. Di Cassandra, kunci partisi diidentifikasi, sedangkan di Bigtable, row key digunakan.
Di Cassandra, klien terlebih dahulu memeriksa kebijakan load balancing. Objek sisi klien ini menentukan pusat data yang menjadi tujuan perutean operasi.
Setelah pusat data diidentifikasi, Cassandra akan menghubungi node koordinator untuk mengelola operasi. Jika kebijakan mengenali token, koordinator adalah node yang menyalurkan data dari partisi vnode target; jika tidak, koordinator adalah node acak. Node koordinator mengidentifikasi node tempat replika data untuk kunci partisi operasi berada, lalu menginstruksikan node tersebut untuk melakukan operasi.
Di Bigtable, seperti yang telah dibahas sebelumnya, setiap operasi menyertakan ID profil aplikasi. Profil aplikasi ditentukan di tingkat layanan. Lapisan perutean Bigtable memeriksa profil untuk memilih cluster tujuan yang sesuai untuk operasi. Lapisan perutean kemudian menyediakan jalur bagi operasi untuk mencapai node pemrosesan yang benar dengan menggunakan row key operasi.
Proses penulisan data
Kedua database dioptimalkan untuk penulisan cepat dan menggunakan proses yang serupa untuk menyelesaikan penulisan. Namun, langkah-langkah yang diambil database sedikit berbeda, terutama untuk Cassandra, yang mungkin memerlukan komunikasi dengan node peserta tambahan, bergantung pada tingkat konsistensi operasi.
Setelah permintaan tulis dirutekan ke node yang sesuai (Cassandra) atau node (Bigtable), penulisan akan dipertahankan terlebih dahulu ke disk secara berurutan dalam log commit (Cassandra) atau log bersama (Bigtable). Selanjutnya, penulisan dimasukkan ke dalam tabel dalam memori (juga dikenal sebagai memtable) yang diurutkan seperti SSTable.
Setelah kedua langkah ini, node akan merespons untuk menunjukkan bahwa penulisan telah selesai. Di Cassandra, beberapa replika (bergantung pada tingkat konsistensi yang ditentukan untuk setiap operasi) harus merespons sebelum koordinator memberi tahu klien bahwa penulisan telah selesai. Di Bigtable, karena setiap row key hanya ditetapkan ke satu node pada waktu tertentu, respons dari node tersebut sudah cukup untuk mengonfirmasi bahwa penulisan berhasil.
Nantinya, jika perlu, Anda dapat mengosongkan memtable ke disk dalam bentuk SSTable baru. Di Cassandra, flush terjadi saat log commit mencapai ukuran maksimum, atau saat memtable melebihi batas yang Anda konfigurasi. Di Bigtable, flush dimulai untuk membuat SSTable baru yang immutable saat memtable mencapai ukuran maksimum yang ditentukan oleh layanan. Secara berkala, proses pemadatan menggabungkan SSTable untuk rentang kunci tertentu menjadi satu SSTable.
Pembaruan data
Kedua database menangani update data dengan cara yang sama. Namun, Cassandra hanya mengizinkan satu nilai untuk setiap sel, sedangkan Bigtable dapat menyimpan sejumlah besar nilai berversi untuk setiap sel.
Jika nilai di persimpangan ID baris dan kolom yang unik diubah, update akan dipertahankan seperti yang dijelaskan sebelumnya di bagian proses penulisan data. Stempel waktu penulisan disimpan bersama nilai dalam struktur SSTable.
Jika belum mengosongkan sel yang diperbarui ke SSTable, Anda hanya dapat menyimpan nilai sel di memtable, tetapi database berbeda dalam hal apa yang disimpan. Cassandra hanya menyimpan nilai terbaru dalam memtable, sedangkan Bigtable menyimpan semua versi dalam memtable.
Atau, jika Anda telah menghapus setidaknya satu versi nilai sel ke disk dalam SSTable terpisah, database akan menangani permintaan untuk data tersebut secara berbeda. Saat sel diminta dari Cassandra, hanya nilai terbaru menurut stempel waktu yang ditampilkan; dengan kata lain, penulisan terakhir yang menang. Di Bigtable, Anda menggunakan filter untuk mengontrol versi sel yang ditampilkan oleh permintaan baca.
Penghapusan baris
Karena kedua database menggunakan file SSTable yang tidak dapat diubah untuk menyimpan data ke disk, baris tidak dapat dihapus secara langsung. Untuk memastikan kueri menampilkan hasil yang benar setelah baris dihapus, kedua database menangani penghapusan menggunakan mekanisme yang sama. Penanda (disebut tombstone di Cassandra) ditambahkan terlebih dahulu ke memtable. Pada akhirnya, SSTable yang baru ditulis berisi penanda bertanda waktu yang menunjukkan bahwa ID baris unik dihapus dan tidak boleh ditampilkan dalam hasil kueri.
Time to live (TTL)
Kemampuan time to live (TTL) di kedua database serupa, kecuali untuk satu perbedaan. Di Cassandra, Anda dapat menetapkan TTL untuk kolom atau tabel, sedangkan di Bigtable, Anda hanya dapat menetapkan TTL untuk grup kolom. Ada metode untuk Bigtable yang dapat menyimulasikan TTL tingkat sel.
Pengumpulan sampah
Karena pembaruan atau penghapusan data langsung tidak dapat dilakukan dengan SSTable yang tidak dapat diubah, seperti yang telah dibahas sebelumnya, pembersihan sampah memori terjadi selama proses yang disebut pemadatan. Proses ini menghapus sel atau baris yang tidak boleh ditampilkan dalam hasil kueri.
Proses pembersihan sampah memori mengecualikan baris atau sel saat penggabungan SSTable terjadi. Jika ada penanda atau tombstone untuk suatu baris, baris tersebut tidak akan disertakan dalam SSTable yang dihasilkan. Kedua database dapat mengecualikan sel dari SSTable yang digabungkan. Jika stempel waktu sel melebihi kualifikasi TTL, database akan mengecualikan sel tersebut. Jika ada dua versi yang diberi stempel waktu untuk sel tertentu, Cassandra hanya menyertakan nilai terbaru dalam SSTable gabungan.
Jalur pembacaan data
Saat operasi baca mencapai node pemrosesan yang sesuai, proses baca untuk mendapatkan data guna memenuhi hasil kueri sama untuk kedua database.
Untuk setiap SSTable di disk yang mungkin berisi hasil kueri, filter Bloom diperiksa untuk menentukan apakah setiap file berisi baris yang akan ditampilkan. Karena filter Bloom tidak pernah memberikan negatif palsu, semua SSTable yang memenuhi syarat akan ditambahkan ke daftar kandidat untuk disertakan dalam pemrosesan hasil baca lebih lanjut.
Operasi baca dilakukan menggunakan tampilan gabungan yang dibuat dari memtable dan SSTable kandidat di disk. Karena semua kunci diurutkan secara leksikografis, akan lebih efisien untuk mendapatkan tampilan gabungan yang dipindai untuk mendapatkan hasil kueri.
Di Cassandra, sekumpulan node pemrosesan yang ditentukan oleh tingkat konsistensi operasi harus berpartisipasi dalam operasi. Di Bigtable, hanya node yang bertanggung jawab atas rentang kunci yang perlu dikonsultasikan. Untuk Cassandra, Anda perlu mempertimbangkan implikasi ukuran komputasi karena kemungkinan beberapa node akan memproses setiap pembacaan.
Hasil pembacaan dapat dibatasi di node pemrosesan dengan cara yang sedikit berbeda.
Di Cassandra, klausa WHERE dalam kueri CQL membatasi baris yang ditampilkan. Batasan yang ada adalah kolom dalam kunci utama atau kolom yang disertakan dalam indeks sekunder dapat digunakan untuk membatasi hasil.
Bigtable menawarkan berbagai macam filter yang memengaruhi baris atau sel yang diambil oleh kueri baca.
Ada tiga kategori filter:
- Filter pembatasan, yang mengontrol baris atau sel yang disertakan dalam respons.
- Mengubah filter, yang memengaruhi data atau metadata untuk setiap sel.
- Menyusun filter, yang memungkinkan Anda menggabungkan beberapa filter menjadi satu filter.
Filter pembatas adalah yang paling umum digunakan—misalnya, ekspresi reguler grup kolom dan ekspresi reguler penentu kolom.
Penyimpanan data fisik
Bigtable dan Cassandra menyimpan data di SSTable, yang digabungkan secara rutin selama fase pemadatan. Kompresi data SSTable menawarkan manfaat serupa untuk mengurangi ukuran penyimpanan. Namun, kompresi diterapkan secara otomatis di Bigtable dan merupakan opsi konfigurasi di Cassandra.
Saat membandingkan kedua database, Anda harus memahami cara setiap database menyimpan data secara fisik dengan cara yang berbeda dalam aspek berikut:
- Strategi distribusi data
- Jumlah versi sel yang tersedia
- Jenis disk penyimpanan
- Mekanisme ketahanan dan replikasi data
Distribusi data
Di Cassandra, hash yang konsisten dari kolom partisi kunci utama adalah metode yang direkomendasikan untuk menentukan distribusi data di berbagai SSTable yang disajikan oleh node cluster.
Bigtable menggunakan awalan variabel untuk row key lengkap guna menempatkan data secara leksikografis di SSTable.
Versi sel
Cassandra hanya menyimpan satu versi nilai sel yang aktif. Jika dua penulisan dilakukan ke sel, kebijakan penulisan terakhir yang menang memastikan bahwa hanya satu nilai yang ditampilkan.
Bigtable tidak membatasi jumlah versi yang diberi stempel waktu untuk setiap sel. Batas ukuran baris lainnya mungkin berlaku. Jika tidak ditetapkan oleh permintaan klien, stempel waktu ditentukan oleh layanan Bigtable pada saat node pemrosesan menerima mutasi. Versi sel dapat dipangkas menggunakan kebijakan pembersihan sampah memori yang dapat berbeda untuk setiap grup kolom tabel, atau dapat difilter dari set hasil kueri melalui API.
Penyimpanan disk
Cassandra menyimpan SSTable di disk yang terpasang ke setiap node cluster. Untuk menyeimbangkan kembali data di Cassandra, file harus disalin secara fisik di antara server.
Bigtable menggunakan Colossus untuk menyimpan SSTable. Karena Bigtable menggunakan sistem file terdistribusi ini, layanan Bigtable dapat menetapkan ulang SSTable ke node yang berbeda hampir secara instan.
Ketahanan dan replikasi data
Cassandra memberikan ketahanan data melalui setelan faktor replikasi. Faktor replikasi menentukan jumlah salinan SSTable yang disimpan di node yang berbeda dalam cluster. Setelan umum untuk faktor replikasi adalah
3, yang tetap memungkinkan jaminan konsistensi kuat dengan QUORUM atau
LOCAL_QUORUM meskipun terjadi kegagalan node.
Dengan Bigtable, jaminan ketahanan data yang tinggi diberikan melalui replikasi yang disediakan Colossus.
Diagram berikut mengilustrasikan tata letak data fisik, node pemrosesan komputasi, dan lapisan pemilihan rute untuk Bigtable:
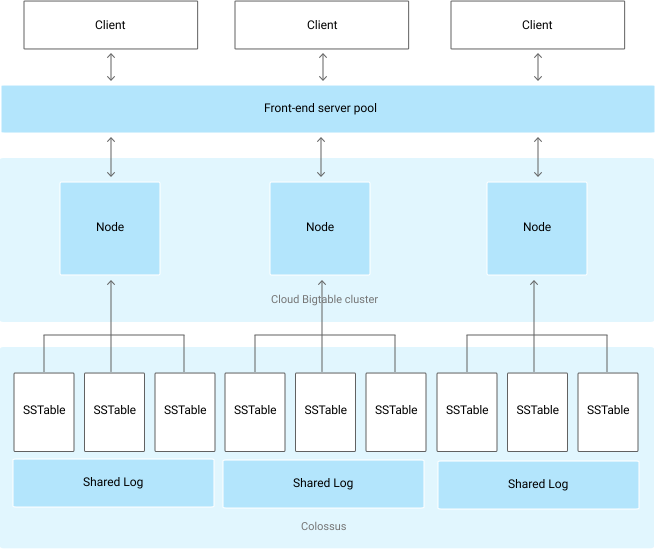
Di lapisan penyimpanan Colossus, setiap node ditetapkan untuk menyajikan data yang disimpan dalam serangkaian SSTable. SSTable tersebut berisi data untuk rentang row key yang ditetapkan secara dinamis ke setiap node. Meskipun diagram menunjukkan tiga SSTable untuk setiap node, kemungkinan ada lebih banyak karena SSTable terus dibuat saat node menerima perubahan data baru.
Setiap node memiliki log bersama. Penulisan yang diproses oleh setiap node akan langsung dipertahankan ke log bersama sebelum klien menerima konfirmasi penulisan. Karena penulisan ke Colossus direplikasi beberapa kali, ketahanan data tetap terjamin meskipun terjadi kegagalan hardware nodal sebelum data disimpan ke SSTable untuk rentang baris.
Antarmuka aplikasi
Awalnya, akses database Cassandra diekspos melalui Thrift API, tetapi metode akses ini tidak digunakan lagi. Interaksi klien yang direkomendasikan adalah melalui CQL.
Serupa dengan Thrift API asli Cassandra, akses database Bigtable disediakan melalui API yang membaca dan menulis data berdasarkan row key yang disediakan.
Seperti Cassandra, Bigtable memiliki antarmuka command line, yang disebut cbt CLI, dan library klien yang mendukung banyak bahasa pemrograman umum. Library ini dibangun di atas API gRPC dan REST. Aplikasi yang ditulis untuk Hadoop dan mengandalkan library Apache HBase open source untuk Java dapat terhubung tanpa perubahan signifikan ke Bigtable. Untuk aplikasi yang tidak memerlukan kompatibilitas HBase, sebaiknya gunakan klien Java Bigtable bawaan.
Kontrol Identity and Access Management (IAM) Bigtable terintegrasi sepenuhnya dengan Google Cloud, dan tabel juga dapat digunakan sebagai sumber data eksternal dari BigQuery.
Penyiapan database
Saat menyiapkan cluster Cassandra, Anda harus membuat beberapa keputusan konfigurasi dan menyelesaikan langkah-langkahnya. Pertama, Anda harus mengonfigurasi node server untuk menyediakan kapasitas komputasi dan menyediakan penyimpanan lokal. Jika Anda menggunakan faktor replikasi tiga, yang merupakan setelan paling umum dan direkomendasikan, Anda harus menyediakan penyimpanan untuk menyimpan data tiga kali lebih banyak dari jumlah data yang akan disimpan di cluster Anda. Anda juga harus menentukan dan menetapkan konfigurasi untuk vnode, rack, dan replikasi.
Pemisahan komputasi dari penyimpanan di Bigtable menyederhanakan penskalaan cluster naik dan turun dibandingkan dengan Cassandra. Dalam cluster yang berjalan normal, Anda biasanya hanya perlu memperhatikan total penyimpanan yang digunakan oleh tabel terkelola, yang menentukan jumlah minimum node, dan memiliki cukup banyak node untuk mempertahankan QPS saat ini.
Anda dapat menyesuaikan ukuran cluster Bigtable dengan cepat jika cluster terlalu besar atau terlalu kecil berdasarkan beban produksi.
Penyimpanan Bigtable
Selain lokasi geografis cluster awal, satu-satunya pilihan yang perlu Anda buat saat membuat instance Bigtable adalah jenis penyimpanan. Bigtable menawarkan dua opsi untuk penyimpanan: solid-state drive (SSD) atau hard disk drive (HDD). Semua cluster dalam satu instance harus memiliki jenis penyimpanan yang sama.
Saat memperhitungkan kebutuhan penyimpanan dengan Bigtable, Anda tidak perlu memperhitungkan replika penyimpanan seperti yang Anda lakukan saat mengukur cluster Cassandra. Tidak ada penurunan kepadatan penyimpanan untuk mencapai fault tolerance seperti yang terlihat di Cassandra. Selain itu, karena penyimpanan tidak perlu disediakan secara eksplisit, Anda hanya ditagih untuk penyimpanan yang digunakan.
SSD
Kapasitas node SSD sebesar 5 TB, yang lebih disukai untuk sebagian besar workload, memberikan kepadatan penyimpanan yang lebih tinggi dibandingkan dengan konfigurasi yang direkomendasikan untuk mesin Cassandra, yang memiliki kepadatan penyimpanan maksimum praktis kurang dari 2 TB untuk setiap node. Saat menilai kebutuhan kapasitas penyimpanan, ingatlah bahwa Bigtable hanya menghitung satu salinan data; sebagai perbandingan, Cassandra perlu memperhitungkan tiga salinan data dalam sebagian besar konfigurasi.
Meskipun QPS tulis untuk SSD hampir sama dengan HDD, SSD memberikan QPS baca yang jauh lebih tinggi daripada HDD. Penyimpanan SSD dihargai sama atau mendekati biaya disk persisten SSD yang di-provisioning dan bervariasi menurut region.
HDD
Jenis penyimpanan HDD memungkinkan kepadatan penyimpanan yang cukup besar—16 TB untuk setiap node. Sebagai gantinya, pembacaan acak menjadi jauh lebih lambat, hanya mendukung pembacaan 500 baris per detik untuk setiap node. HDD lebih disukai untuk workload yang memerlukan banyak penulisan, dengan pembacaan yang diperkirakan berupa pemindaian rentang yang terkait dengan batch processing. Penyimpanan HDD diberi harga sesuai atau mendekati biaya yang terkait dengan Cloud Storage dan bervariasi menurut region.
Pertimbangan ukuran cluster
Saat Anda menentukan ukuran instance Bigtable untuk bersiap memigrasikan workload Cassandra, ada beberapa pertimbangan saat Anda membandingkan cluster Cassandra pusat data tunggal dengan instance Bigtable cluster tunggal, dan cluster Cassandra multi-pusat data dengan instance Bigtable multi-cluster. Panduan di bagian berikut mengasumsikan bahwa tidak ada perubahan model data yang signifikan yang diperlukan untuk migrasi, dan ada kompresi penyimpanan yang setara antara Cassandra dan Bigtable.
Cluster pusat data tunggal
Saat membandingkan cluster pusat data tunggal dengan instance Bigtable cluster tunggal, Anda harus mempertimbangkan persyaratan penyimpanan terlebih dahulu. Anda dapat memperkirakan ukuran yang tidak direplikasi dari setiap keyspace menggunakan
perintah tablestats
nodetool
dan membagi total ukuran penyimpanan yang di-flush dengan faktor replikasi
keyspace. Kemudian, Anda membagi jumlah penyimpanan yang tidak direplikasi dari semua keyspace dengan
3,5 TB (5 TB *
0,70
) untuk menentukan jumlah node SSD yang disarankan untuk menangani penyimpanan saja. Seperti yang telah dibahas, Bigtable menangani replikasi dan ketahanan penyimpanan dalam tingkat terpisah yang transparan bagi pengguna.
Selanjutnya, Anda harus mempertimbangkan persyaratan komputasi untuk jumlah node. Anda dapat melihat metrik server Cassandra dan aplikasi klien untuk mendapatkan perkiraan jumlah baca dan tulis berkelanjutan yang telah dieksekusi. Untuk memperkirakan jumlah node SSD minimum untuk menjalankan workload Anda, bagi metrik tersebut dengan 10.000. Anda mungkin memerlukan lebih banyak node untuk aplikasi yang memerlukan hasil kueri latensi rendah. Google merekomendasikan agar Anda menguji performa Bigtable dengan data dan kueri yang representatif untuk menetapkan metrik QPS per node yang dapat dicapai untuk workload Anda.
Jumlah node yang diperlukan untuk cluster harus sama dengan kebutuhan penyimpanan dan komputasi yang lebih besar. Jika ragu dengan kebutuhan penyimpanan atau throughput, Anda dapat mencocokkan jumlah node Bigtable dengan jumlah mesin Cassandra standar. Anda dapat meningkatkan atau menurunkan skala cluster Bigtable agar sesuai dengan kebutuhan workload dengan upaya minimal dan tanpa periode nonaktif.
Cluster multi-pusat data
Dengan cluster multi-pusat data, akan lebih sulit untuk menentukan konfigurasi instance Bigtable. Idealnya, Anda harus memiliki cluster dalam instance untuk setiap pusat data dalam topologi Cassandra. Setiap cluster Bigtable dalam instance harus menyimpan semua data dalam instance dan harus dapat menangani total rasio penyisipan di seluruh cluster. Cluster dalam instance dapat dibuat di region cloud yang didukung di seluruh dunia.
Teknik untuk memperkirakan kebutuhan penyimpanan mirip dengan pendekatan untuk cluster pusat data tunggal. Anda menggunakan nodetool untuk merekam ukuran penyimpanan
setiap keyspace di cluster Cassandra, lalu membagi ukuran tersebut dengan jumlah
replika. Anda perlu ingat bahwa keyspace tabel mungkin memiliki faktor replikasi yang berbeda untuk setiap pusat data.
Jumlah node di setiap cluster dalam instance harus dapat menangani semua penulisan di seluruh cluster dan semua pembacaan ke setidaknya dua pusat data untuk mempertahankan tujuan tingkat layanan (SLO) selama gangguan cluster. Pendekatan umum adalah memulai dengan semua cluster yang memiliki kapasitas node yang setara dengan pusat data tersibuk di cluster Cassandra. Cluster Bigtable dalam instance dapat ditingkatkan atau diturunkan skalanya secara terpisah agar sesuai dengan kebutuhan beban kerja tanpa periode nonaktif.
Administrasi
Bigtable menyediakan komponen yang terkelola sepenuhnya untuk fungsi administrasi umum yang dilakukan di Cassandra.
Pencadangan dan pemulihan
Bigtable menyediakan dua metode untuk memenuhi kebutuhan pencadangan umum: pencadangan Bigtable dan ekspor data terkelola.
Anda dapat menganggap pencadangan Bigtable sebagai analogi dari versi terkelola fitur snapshot nodetool Cassandra. Cadangan Bigtable membuat salinan tabel yang dapat dipulihkan, yang disimpan sebagai objek anggota cluster. Anda dapat memulihkan cadangan sebagai tabel baru di cluster yang memulai pencadangan. Cadangan dirancang untuk membuat titik pemulihan jika terjadi kerusakan pada tingkat aplikasi. Cadangan yang Anda buat melalui utilitas ini tidak menggunakan resource node dan dikenai harga yang sama atau mendekati harga Cloud Storage. Anda dapat memanggil cadangan Bigtable secara terprogram atau melalui konsol Google Cloud untuk Bigtable.
Cara lain untuk mencadangkan Bigtable adalah dengan menggunakan ekspor data terkelola ke Cloud Storage. Anda dapat mengekspor ke format file Avro, Parquet, atau Hadoop Sequence. Dibandingkan dengan cadangan Bigtable, ekspor memerlukan waktu lebih lama untuk dieksekusi dan menimbulkan biaya komputasi tambahan karena ekspor menggunakan Dataflow. Namun, ekspor ini membuat file data portabel yang dapat Anda kueri secara offline atau impor ke sistem lain.
Mengubah ukuran
Karena Bigtable memisahkan penyimpanan dan komputasi, Anda dapat menambahkan atau menghapus node Bigtable sebagai respons terhadap permintaan kueri dengan lebih lancar daripada di Cassandra. Arsitektur homogen Cassandra mengharuskan Anda menyeimbangkan ulang node (atau vnode) di seluruh mesin dalam cluster.
Anda dapat mengubah ukuran cluster secara manual di konsol Google Cloud atau secara terprogram menggunakan Cloud Bigtable API. Menambahkan node ke cluster dapat menghasilkan peningkatan performa yang terlihat dalam beberapa menit. Beberapa pelanggan telah berhasil menggunakan penskala otomatis open source yang dikembangkan oleh Spotify .
Pemeliharaan internal
Layanan Bigtable menangani tugas pemeliharaan internal Cassandra yang umum dengan lancar, seperti patching OS, pemulihan node, perbaikan node, pemantauan pemadatan penyimpanan, dan rotasi sertifikat SSL.
Pemantauan
Menghubungkan Bigtable ke visualisasi atau pemberitahuan metrik tidak memerlukan upaya administrasi atau pengembangan. Halaman konsolGoogle Cloud Bigtable dilengkapi dengan dasbor bawaan untuk melacak metrik throughput dan pemakaian di tingkat instance, cluster, dan tabel. Tampilan dan pemberitahuan kustom dapat dibuat di dasbor Cloud Monitoring, tempat metrik tersedia secara otomatis.
Key Visualizer Bigtable, fitur pemantauan di konsol Google Cloud , memungkinkan Anda melakukan penyesuaian performa lanjutan.
IAM dan keamanan
Di Bigtable, otorisasi sepenuhnya terintegrasi ke dalam framework IAMGoogle Clouddan memerlukan penyiapan dan pemeliharaan minimal. Akun pengguna dan sandi lokal tidak dibagikan ke aplikasi klien; sebagai gantinya, izin dan peran terperinci diberikan kepada pengguna tingkat organisasi dan akun layanan.
Bigtable otomatis mengenkripsi semua data dalam penyimpanan dan dalam pengiriman. Tidak ada opsi untuk menonaktifkan fitur ini. Semua akses administratif dicatat sepenuhnya . Anda dapat menggunakan Kontrol Layanan VPC untuk mengontrol akses ke instance Bigtable dari luar jaringan yang disetujui.
Langkah berikutnya
- Baca desain skema Bigtable.
- Cari tahu selengkapnya tentang Apache Cassandra.
- Coba codelab Bigtable untuk pengguna Cassandra.
- Pelajari emulator Bigtable.
- Pelajari arsitektur referensi, diagram, dan praktik terbaik tentang Google Cloud. Lihat Cloud Architecture Center kami.