


Mit dem Lakehouse-Laufzeitkatalog können Sie Tabellenmetadaten in einem vollständig verwalteten, serverlosen Metastore zentralisieren, der als einzige zuverlässige Informationsquelle für Ihre Daten in Borderless Lakehouse dient. Mit zentralisierten Metadaten können Verarbeitungs-Engines wie Apache Spark, Apache Flink, Apache Hive und BigQuery Tabellen direkt gemeinsam nutzen, ohne Dateien zu duplizieren.
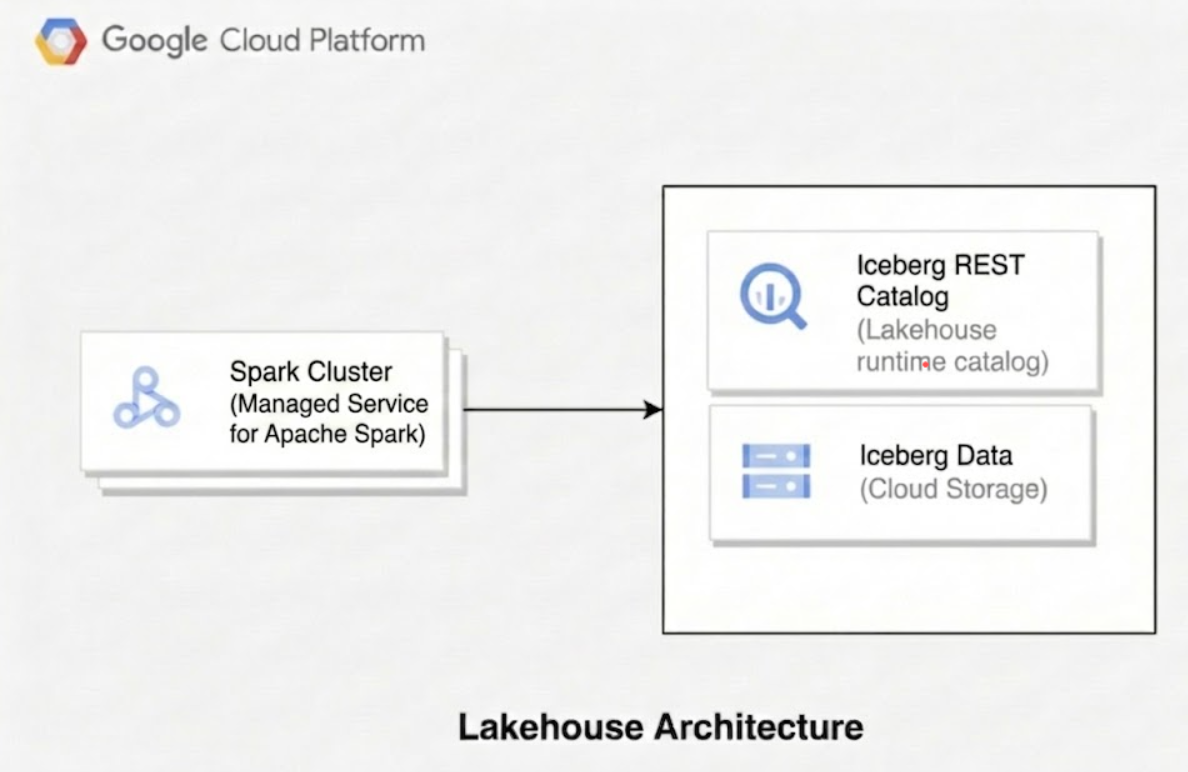
Wenn Sie einen Clientendpunkt wie den Apache Iceberg REST-Katalog konfigurieren, fungiert er als Verwaltungsoberfläche, die Abfrage-Engines mit dem Lakehouse-Laufzeitkatalog verbindet. Der Endpunkt verarbeitet Tabellenmetadaten und Cloud Storage speichert die zugrunde liegenden Metadaten und Datendateien.
Als Kernkomponente von Lakehouse bietet der Lakehouse-Laufzeitkatalog eine offene API-Interoperabilität und unterstützt in Kombination mit BigQuery Analyse-, Streaming- und KI-Arbeitslasten. Weitere Informationen zu diesen architektonischen Vorteilen finden Sie unter Was ist Borderless Lakehouse?
Lakehouse-Integration mit Google Cloud
Informationen dazu, wie Lakehouse Ihre Daten verwaltet, finden Sie unter der Lakehouse-Architektur in Kombination mit Google Cloud Diensten. Apache Iceberg speichert keine Daten in monolithischen Tabellen. Stattdessen wird eine mehrschichtige Architektur von Metadatendateien verwendet, um Datendateien in einer zusammenhängenden Tabellenstruktur mit ACID-Transaktionsunterstützung zu organisieren.
Das folgende Diagramm zeigt, wie Compute-Engines wie Managed Service for Apache Spark den Lakehouse-Laufzeitkatalog verwenden, um Tabellenmetadaten zu verwalten und zugrunde liegende Parquet-Datendateien direkt in Cloud Storage zu lesen und zu schreiben.
Wenn Sie Lakehouse verwenden, besteht die technische Architektur aus drei verschiedenen Ebenen:
Katalogebene:
- Wichtiges Iceberg-Konzept: Der Katalog speichert den aktuellen Status der Tabelle, indem er einen Zeiger auf die neueste Metadatendatei verwaltet. Diese Ebene erleichtert die ACID-Compliance und die Transaktionsisolation, um zu verhindern, dass sich gleichzeitige Schreibvorgänge gegenseitig beeinträchtigen.
- Lakehouse-Implementierung: Der Lakehouse-Laufzeitkatalog fungiert als regionaler Metastore-Dienst der obersten Ebene. In diesem Dienst erstellen Sie einzelne Kataloge, um Ihre Datenhierarchie zu verwalten. Client-Abfrage-Engines stellen eine Verbindung zu diesen Katalogen her, indem sie bestimmte Endpunkt-Katalogtypen verwenden, z. B. den Endpunkt Apache Iceberg REST-Katalog. Der Metastore verwaltet Transaktions-Commits, die Bereitstellung von Anmeldedaten für die Delegierung des Speicherzugriffs und die Zeigerverwaltung in Ihren Katalogen.
Metadatenebene:
- Wichtiges Iceberg-Konzept: Auf dieser Ebene werden die Tabellenstruktur,
Snapshots und Dateispeicherorte mithilfe einer Hierarchie von drei Dateitypen verfolgt:
- Metadatendateien: Speichern das Schema der Tabelle, die Partition spezifikation und ein Logbuch mit Snapshot-Zeigern.
- Manifestlisten: Stellen einen einzelnen Snapshot der Tabelle dar, indem sie eine Sammlung von Manifestdateien gruppieren.
- Manifestdateien: Verfolgen Daten auf der Ebene einzelner Dateien, speichern Dateipfade, Partitionierungsinformationen und Statistiken auf Spaltenebene, z. B. Zeilenanzahl und Minimal- und Maximalwerte, die für die Abfrageoptimierung und das Partition Pruning verwendet werden.
- Lakehouse-Implementierung: In einem Katalogcontainer
organisieren Sie Ihre Daten in logischen Namespaces (ähnlich wie
Datasets) und Tabellen. Für jede Tabelle generiert und verwaltet der Lakehouse-Laufzeitkatalog die zugrunde liegende Iceberg-Metadatenhierarchie, beginnend mit einer
metadata.json-Stammdatei, die auf die Manifestlisten und Manifestdateien verweist. Der Lakehouse-Laufzeitkatalog speichert diese Dateien direkt am angegebenen Speicherort des Data Warehouse.
- Wichtiges Iceberg-Konzept: Auf dieser Ebene werden die Tabellenstruktur,
Snapshots und Dateispeicherorte mithilfe einer Hierarchie von drei Dateitypen verfolgt:
Datenebene:
- Wichtiges Iceberg-Konzept: Diese Komponente ist der zugrunde liegende Speicher, in dem sich die eigentlichen Rohdatensätze befinden, in der Regel in optimierten spaltenbasierten oder zeilenbasierten offenen Dateiformaten wie Parquet, ORC oder Avro.
- Lakehouse-Implementierung: Wenn Sie Cloud
Storage-Speicherorte für Data Warehouses (
gs://) konfigurieren, werden die physischen Datendateien, auf die in Ihren Tabellen verwiesen wird, sicher in Ihren Buckets gespeichert. Der Lakehouse-Laufzeitkatalog verwaltet den Zugriff über die Delegierung des Speicherzugriffs (Bereitstellung von Anmeldedaten), indem er kurzlebige Zugriffstokens direkt an Client-Engines bereitstellt. So können Engines Datendateien sicher lesen und schreiben, ohne dass umfassende, direkte IAM Berechtigungen für die zugrunde liegenden Buckets erforderlich sind.
Implementierung der Apache Iceberg REST Catalog API in Lakehouse
Der Lakehouse-Laufzeitkatalog implementiert die Open-Source- Apache Iceberg REST Catalog API zur Verwaltung von Namespaces und Tabellen. Außerdem wird eine Erweiterungs API speziell für die Katalogverwaltung bereitgestellt.
Client-Abfrage-Engines interagieren mit dem Metastore über diese Standard-REST-Katalog-APIs. Details zu Google Cloud-Ressourcen und -Endpunkten finden Sie in der Lakehouse REST API-Referenz.
Sie können diese Ressourcen über die Google Cloud Console, die gcloud CLI, die REST API oder Terraform erstellen, konfigurieren und verwalten. Weitere Informationen finden Sie auf den folgenden Seiten:
- Iceberg REST-Katalogressourcen verwalten
- Apache Iceberg-Tabellen verwalten
- Terraform mit Lakehouse verwenden
- Regionale Endpunkte mit dem Lakehouse-Laufzeitkatalog verwenden
Kompatibilität und Konfiguration von Abfrage-Engines
Zum Analysieren und Verwalten von Daten im Lakehouse-Laufzeitkatalog können Sie verschiedene Open-Source- und Enterprise-Abfrage-Engines verbinden. Je nach vorhandener Architektur und Arbeitslastanforderungen können Sie aus mehreren unterstützten Engines auswählen und den entsprechenden Katalogendpunkt konfigurieren.
Unterstützte Engines
Der Lakehouse-Laufzeitkatalog ist mit mehreren Abfrage-Engines kompatibel, darunter Apache Spark, Apache Flink, Apache Hive und Trino. Die folgende Tabelle enthält Links zur Dokumentation für jede Engine:
| Engine | Dokumentation |
|---|---|
| Apache Spark | Mit Apache Spark verwenden |
| Apache Hive | Mit Spark und dem Hive-Katalog verwenden |
| Apache Flink | Mit Apache Flink verwenden |
| Trino | Mit Trino verwenden |
Katalogtypen und Endpunktkonfiguration
Wenn Sie Client-Engines für die Verbindung mit dem Metastore des Lakehouse-Laufzeitkatalogs konfigurieren, wählen Sie einen bestimmten Katalogendpunkt aus, z. B. den Endpunkt Apache Iceberg REST-Katalog oder den Apache Hive-Endpunkt. Die beste Option hängt von Ihrem Anwendungsfall ab, wie in der folgenden Tabelle dargestellt:
| Anwendungsfall | Empfehlung |
|---|---|
| Neue Nutzer des Lakehouse-Laufzeitkatalogs, die mit ihrer Open Source-Engine auf Daten in Cloud Storage zugreifen möchten und Interoperabilität mit anderen Engines benötigen, darunter BigQuery und AlloyDB for PostgreSQL. | Verwenden Sie den Endpunkt des Apache Iceberg REST-Katalogs. |
| Nutzer, die Apache Hive- oder Spark Arbeitslasten ausführen, die von der Hive Metastore-Oberfläche abhängen und einen vollständig verwalteten Metastore-Dienst benötigen. | Verwenden Sie den Endpunkt des Apache Hive-Katalogs. |
| Vorhandene Nutzer des Lakehouse-Laufzeitkatalogs, die aktuelle Tabellen mit dem benutzerdefinierten Apache Iceberg-Katalog für den BigQuery-Endpunkt erstellt haben. | Verwenden Sie weiterhin den benutzerdefinierten Apache Iceberg-Katalog für den BigQuery-Endpunkt, aber verwenden Sie den Apache Iceberg REST-Katalog für neue Arbeitsabläufe. |
Einschränkungen des Lakehouse-Laufzeitkatalogs
Die folgenden allgemeinen Einschränkungen gelten für Tabellen im Lakehouse-Laufzeitkatalog, wenn sie über BigQuery abgefragt werden. Für einzelne Katalogendpunkte (z. B. Apache Iceberg REST oder Apache Hive) gelten möglicherweise zusätzliche endpunktspezifische Einschränkungen.
Tabellenverwaltung
- Apache Iceberg V2-Tabellen (allgemeine Verfügbarkeit) und V3-Tabellen (Vorabversion) werden unterstützt. Iceberg V1-Tabellen werden nicht unterstützt. Bevor Sie vorhandene V1-Tabellen mit dem Lakehouse-Laufzeitkatalog verwenden, müssen Sie ein Upgrade auf eine unterstützte Version durchführen. Weitere Informationen finden Sie unter Upgrade von Iceberg V1 Tabellen auf V2.
- Tabellen im Lakehouse-Laufzeitkatalog unterstützen
keine Umbenennungsvorgänge oder die
ALTER TABLE ... RENAME TOSpark SQL-Anweisung. - Tabellen im Lakehouse-Laufzeitkatalog unterstützen kein Clustering.
- Tabellen im Lakehouse-Laufzeitkatalog unterstützen keine
Extraktionsjobs. Diese Einschränkung gilt sowohl für
EXPORT DATA-Anweisungen als auch für denbq extract-CLI-Befehl. - Der Lakehouse-Laufzeitkatalog unterstützt keine Datenbank- oder Metastore-Ansichten.
- Der Lakehouse-Laufzeitkatalog unterstützt keine Apache Iceberg-Ansichten.
Abfragen
- Die Abfrageleistung für Tabellen im Lakehouse-Laufzeitkatalog über die BigQuery-Engine ist möglicherweise langsamer als bei der Abfrage von Daten in Standard-BigQuery-Tabellen. Im Allgemeinen sollte die Abfragegeschwindigkeit dem Lesen von Daten aus Cloud Storage entsprechen.
- Ein BigQuery-Probelauf einer Abfrage, die eine Tabelle im Lakehouse-Laufzeitkatalog verwendet, kann eine Untergrenze von 0 Byte an Daten melden, auch wenn Zeilen zurückgegeben werden. Dieses Ergebnis tritt auf, weil die Menge der Daten, die aus der Tabelle verarbeitet werden, erst nach Ausführung der vollständigen Abfrage bestimmt werden kann. Für die Ausführung der Abfrage fallen Kosten für die Verarbeitung dieser Daten an.
- Sie können in einer Abfrage mit einer Platzhaltertabelle nicht auf eine Tabelle im Lakehouse-Laufzeitkatalog verweisen.
API und Metadaten
- Sie können die
tabledata.listMethode nicht verwenden, um Daten aus Tabellen im Lakehouse-Laufzeitkatalog abzurufen. Stattdessen können Sie Abfrageergebnisse in einer BigQuery-Tabelle speichern und dann die Methodetabledata.listfür diese Tabelle verwenden. - Die Anzeige von Tabellenspeicherstatistiken für Tabellen im Lakehouse-Laufzeitkatalog wird nicht unterstützt.
Kontingente und Limits
- Für Tabellen im Lakehouse-Laufzeitkatalog in BigQuery gelten die gleichen Kontingente und Limits wie für Standardtabellen.
Unterschiede zum BigLake Metastore (klassisch)
Zu den wichtigsten Unterschieden zwischen dem Lakehouse-Laufzeitkatalog und dem BigLake Metastore (klassisch) gehören:
- Der Lakehouse-Laufzeitkatalog unterstützt eine direkte Integration mit Open-Source-Engines wie Spark, was die Redundanz beim Speichern von Metadaten und Ausführen von Jobs reduziert. Auf Tabellen im Lakehouse-Laufzeitkatalog kann direkt von mehreren Open-Source-Engines und BigQuery aus zugegriffen werden.
- Der Lakehouse-Laufzeitkatalog unterstützt den Endpunkt des Apache Iceberg REST-Katalogs, der BigLake Metastore (klassisch) jedoch nicht.
Nächste Schritte
- Informationen zum Endpunkt des Apache Iceberg REST-Katalogs.
- Regionale Endpunkte konfigurieren.