


O modelo RAG de IA generativa com o Cloud SQL no App Design Center permite implantar um aplicativo de conversa com IA generativa que usa a geração aumentada por recuperação (RAG) para fundamentar as respostas nos dados da sua organização. É possível personalizar os componentes pré-configurados do Cloud Run, da Vertex AI e do banco de dados vetorial do Cloud SQL para se adequar à sua carga de trabalho e implantá-los como um aplicativo.
Por exemplo, é possível implementar esse modelo para atender às seguintes necessidades de negócios:
| Exemplo | Necessidade comercial | Implementação |
|---|---|---|
| Chatbot de suporte ao cliente | As empresas precisam oferecer suporte instantâneo ao cliente. | Hospedar a interface de chat no Cloud Run. A Vertex AI processa embeddings e gera respostas com base na documentação técnica armazenada como vetores no Cloud SQL. |
| Assistente de RH interno | Os funcionários precisam encontrar informações sobre benefícios, políticas da empresa e procedimentos internos. | Hospedar o assistente de RH no Cloud Run. Quando os funcionários consultam a ferramenta, a Vertex AI recupera as informações relevantes da política no Cloud SQL para gerar respostas precisas e baseadas na fonte. |
| Pesquisador de documentos jurídicos | As equipes jurídicas precisam encontrar rapidamente jurisprudências ou cláusulas contratuais relevantes em grandes repositórios de documentos. | Hospedar o portal de pesquisa no Cloud Run. A Vertex AI resume precedentes relevantes e identifica linguagem específica em contratos usando documentos jurídicos armazenados como vetores no Cloud SQL. |
| Pesquisa semântica de produtos | As empresas de e-commerce querem facilitar as pesquisas de produtos usando descrições em linguagem natural em vez de palavras-chave exatas. | Hospedar a interface de pesquisa no Cloud Run. A Vertex AI processa as descrições dos usuários para retornar os produtos mais relevantes semanticamente dos catálogos de produtos armazenados como vetores no Cloud SQL. |
Arquitetura
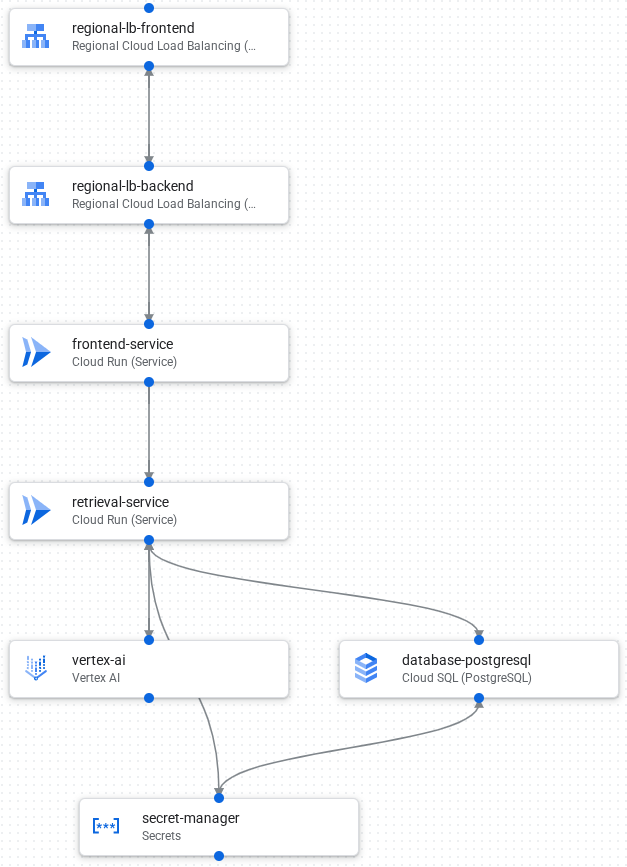
A imagem a seguir mostra os componentes e as conexões no aplicativo:
Confira a seguir o fluxo de processamento de solicitações do aplicativo:
- Carregar dados em um banco de dados PostgreSQL no Cloud SQL.
- A Vertex AI cria embeddings de campos de texto e os armazena como vetores no banco de dados.
- Um front-end do Cloud Load Balancing recebe solicitações externas e distribui o tráfego para o back-end do Cloud Load Balancing.
- O back-end do Cloud Load Balancing distribui o tráfego para o serviço de front-end do Cloud Run.
- O serviço de front-end se comunica com um serviço de recuperação para uma chamada de IA generativa.
- O serviço de recuperação usa o Secret Manager para acessar com segurança as chaves de API e as credenciais necessárias para acessar a Vertex AI e o Cloud SQL.
- O serviço de recuperação converte a solicitação em um embedding e pesquisa vetores semelhantes no banco de dados do Cloud SQL.
- O serviço de recuperação envia os resultados da pesquisa, com o comando original, para a Vertex AI para criar uma resposta.
A seguir
- Para saber como duplicar e personalizar esse modelo, consulte Guia de início rápido: personalizar e implantar um modelo do Google.
- Defina suas próprias configurações criando modelos de aplicativo.
- Identificar as práticas recomendadas gerais de arquitetura com o Google Cloud Framework de arquitetura.