


TPU v4
本文說明 Cloud TPU v4 的架構和支援的設定。
系統架構
每顆 TPU v4 晶片包含 2 個 TensorCore。每個 TensorCore 有 4 個矩陣乘法單元 (MXU)、1 個向量單元和 1 個純量單元。下表列出 v4 TPU Pod 的主要規格。
| 規格 | 值 |
|---|---|
| 每顆晶片的尖峰運算效能 | 每秒 275 兆次浮點運算 (bf16 或 int8) |
| HBM2 容量和頻寬 | 32 GiB,1200 GBps |
| 測得的最小/平均/最大功率 | 90/170/192 瓦 |
| TPU Pod 大小 | 4096 個晶片 |
| 互連網路拓撲 | 3D 網格 |
| 每個 Pod 的尖峰運算效能 | 每秒 110 萬兆次浮點運算 (bf16 或 int8) |
| 每個 Pod 的 All-reduce 頻寬 | 每秒 1.1 PB |
| 每個 Pod 的對分頻寬 | 24 TB/秒 |
下圖為 TPU v4 晶片。
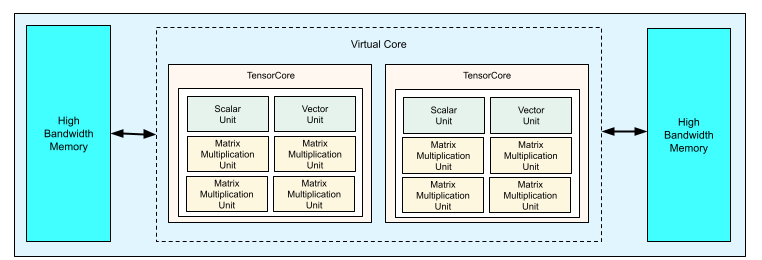
如要進一步瞭解 TPU v4 的架構細節和效能特性,請參閱「TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning with Hardware Support for Embeddings」(TPU v4:具備嵌入硬體支援的光學可重新設定機器學習超級電腦)。
3D 網格和 3D 環面
v4 TPU 會直接與 3D 空間中最鄰近的晶片相連,形成 3D 網格網路連線。一或多個完整 4x4x4 立方體 (AxBxC 拓撲中的每個維度 A、B 和 C 都是 4 的倍數) 的配量包含環繞連結,可將配量的相對兩側連結至 3D 環面,而較小的配量則會形成沒有環繞連結的 3D 網格。如果配量的拓撲 AxBxC 為 2A=B=C 或 2A=2B=C,且每個維度都是 4 的倍數 (例如 4x4x8、4x8x8 或 12x12x24),則連線也可以配置成扭曲 3D 環面。一般來說,3D 環面設定的效能優於 3D 網狀設定。如要進一步瞭解扭曲環面設定,請參閱「扭曲環面拓撲」。
TPU v4 相較於 v3 的效能優勢
本節說明如何在 TPU v4 上執行範例訓練指令碼,並比較 TPU v4 和 TPU v3 的效能提升。
記憶體系統
非統一記憶體存取 (NUMA) 是一種電腦記憶體架構,適用於具有多個 CPU 的機器。每個 CPU 都能直接存取高速記憶體區塊。CPU 及其記憶體稱為 NUMA 節點。NUMA 節點會與其他直接相鄰的 NUMA 節點連結。某個 NUMA 節點的 CPU 可以存取另一個 NUMA 節點的記憶體,但這種存取速度比存取 NUMA 節點內的記憶體慢。
在多 CPU 機器上執行的軟體,可將 CPU 所需的資料放在其 NUMA 節點中,提高記憶體處理量。如要進一步瞭解 NUMA,請參閱維基百科的「非統一記憶體存取」一文。
您可以將訓練指令碼繫結至 NUMA 節點 0,充分運用 NUMA 區域性優勢。
如要啟用 NUMA 節點繫結,請按照下列步驟操作:
安裝 numactl 指令列工具。numactl 可讓您使用特定 NUMA 排程或記憶體配置政策執行程序。
 $ sudo apt-get update
 $ sudo apt-get install numactl
將指令碼程式碼繫結至 NUMA 節點 0。將 your-training-script 替換為訓練指令碼的路徑。
$ numactl --cpunodebind=0 python3 your-training-script
在下列情況下,請啟用 NUMA 節點繫結:
- 如果工作負載高度依賴 CPU 工作負載 (例如圖片分類、推薦工作負載),無論架構為何。
- 如果您使用的 TPU 執行階段版本沒有 -pod 後置字串 (例如
tpu-vm-tf-2.10.0-v4)。
其他記憶體系統差異:
- v4 TPU 晶片在整個晶片上具有統合的 32 GiB HBM 記憶體空間,可讓兩個晶片上 TensorCore 之間更協調。
- 採用最新記憶體標準和速度,提升 HBM 效能。
- 改善 DMA 效能設定檔,內建支援 512B 精細度的高效能跨步。
TensorCores
- MXU 數量加倍,時脈頻率更高,最高可達 275 TFLOPS。
- 轉置與排序頻寬加倍。
- 通用記憶體 (Cmem) 的載入儲存記憶體存取模型。
- MXU 權重載入頻寬更快,並支援 8 位元模式,可降低批次大小並縮短推論延遲時間。
晶片間互連
每個晶片有六個互連連結,可啟用網路直徑較小的網路拓撲。
其他
- x16 PCIE Gen3 介面,可直接連線至主機。
- 改善安全性模型。
- 提升能源效率。
設定
TPU v4 Pod 由 4096 個晶片組成,這些晶片透過可重新設定的高速連結互連。TPU v4 的彈性網路可讓您以多種方式連結相同大小配量中的晶片。建立 TPU 配量時,您會指定所需的 TPU 版本和 TPU 資源數量。
您可以使用 3 元組 AxBxC 指定 TPU 拓撲,其中 A<=B<=C,且 A、B、C 皆 <= 4 或皆為 4 的整數倍數。值 A、B 和 C 是三個維度中各維度的晶片數量。
2A=B=C 或 2A=2B=C 的拓撲也有拓撲變體,已針對全對全通訊進行最佳化,例如 4×4×8、8×8×16 和 12×12×24。這稱為扭曲環面拓撲。
下圖顯示一些常見的 TPU v4 拓撲。
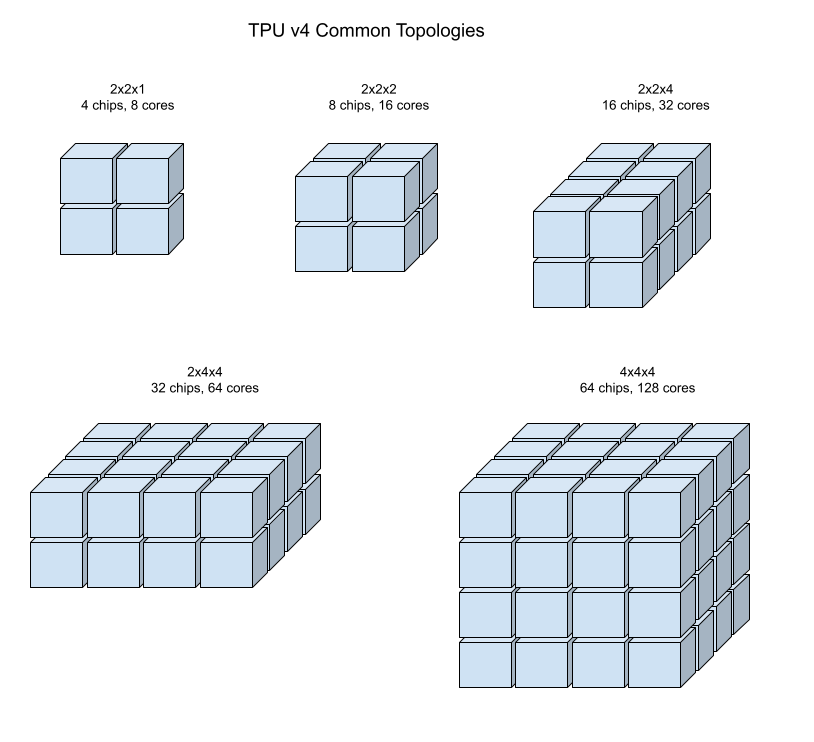
較大的切片可以由一或多個 4x4x4 的晶片「立方體」組成。
如要進一步瞭解如何管理 TPU,請參閱「管理 TPU」。如要進一步瞭解 Cloud TPU 的系統架構,請參閱「系統架構」。
扭曲環面拓撲
對於某些 3D 配量形狀,您可以使用扭曲環面拓撲。這些拓撲可提供大幅提高的平分頻寬。舉例來說,相較於非扭曲的 4x4x8 切片,4x4x8 扭曲拓撲的理論平分頻寬可增加 70%。頻寬增加後,有助於使用全域通訊模式的工作負載。扭曲拓撲可提升大多數模型的效能,其中大型 TPU 嵌入工作負載的效益最大。TPU 軟體支援扭曲拓撲,但切片的每個維度必須等於或兩倍於最小維度。例如 4x4x8、4×8×8 或 12x12x24。TPU v4 和 TPU v5p 支援扭曲拓撲,可透過 Cloud TPU API 使用。
如果工作負載僅採用資料平行處理策略,扭曲拓撲的效能可能會稍微好一點。使用大型語言模型 (LLM) 時,扭曲拓撲的效能會因採用的平行處理類型 (例如資料平行處理或模型平行處理) 而異。如要找出模型的最佳效能,請在有和沒有扭曲拓撲的情況下訓練 LLM。在 FSDP MaxText 模型上進行的部分實驗顯示,使用扭曲拓撲時,模型 FLOPs 使用率 (MFU) 提高了 1 到 2 個百分點。
扭曲拓撲的主要優點,是能將非對稱環面拓撲 (例如 4×4×8) 變更為對稱拓撲。對稱拓撲的優點如下:
- 改善負載平衡
- 更高的對分頻寬
- 縮短封包路徑
這些優勢可提升許多全域通訊模式的效能。
舉例來說,假設有一個 4×2 環面拓撲,其中的 TPU 標有切片中的 X 和 Y 座標:
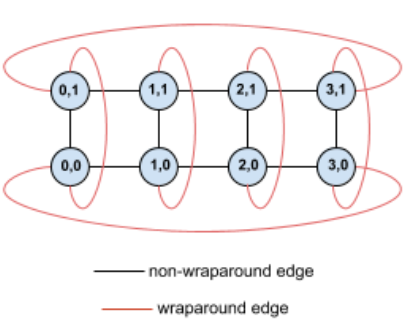
為求明確,圖表會將連線顯示為無向邊。在實際操作中,每個邊緣都是 TPU 之間的雙向連線。這個網格一側與對側之間的邊緣是環繞邊緣。
扭轉這個拓撲,會建立對稱的 4×2 扭轉環面拓撲:
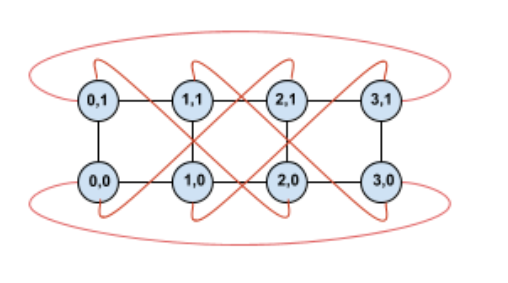
這個扭曲圖表與未扭曲圖表的差異在於 Y 軸環繞邊緣。這些環繞邊緣不會連接到 X 座標相同的其他 TPU,而是會轉移到座標 X+2 mod 4 的 TPU。
這個原則適用於不同的維度大小和維度數量。如果每個維度都等於或兩倍於最小維度的大小,則產生的網路是對稱的。
下表列出部分支援的扭曲拓撲,以及相較於未扭曲拓撲,扭曲拓撲在理論上可增加的平分頻寬。
| 拓撲 | 與非扭曲環面相比,理論上的平分頻寬增幅 |
|---|---|
| 4×4×8 | ~70% |
| 8x8x16 | |
| 12×12×24 | |
| 4×8×8 | ~40% |
| 8×16×16 |
TPU v4 拓撲變化版本
某些拓撲包含相同數量的晶片,但可以透過不同方式排列。舉例來說,具有 512 個晶片 (1024 個 TensorCore) 的 TPU 切片,可以使用下列拓撲進行設定:4x4x32、4x8x16 或 8x8x8。具有 2048 個晶片 (4096 個 TensorCore) 的 TPU 配量提供更多拓撲選項:4x4x128、4x8x64、4x16x32 和 8x16x16。
與指定晶片數量相關聯的預設拓撲,是最接近立方體的拓撲。這個形狀可能是資料平行機器學習訓練的最佳選擇。其他拓撲則適用於具有多種平行處理方式的工作負載,例如模型和資料平行處理,或模擬的空間分區。如果拓撲與使用的平行處理方式相符,這些工作負載的效能最佳。舉例來說,在 X 維度上放置 4 向模型平行處理,並在 Y 和 Z 維度上放置 256 向資料平行處理,會符合 4x16x16 拓撲。
如果模型有多個平行處理維度,將這些維度對應至 TPU 拓撲維度,可達到最佳效能。這類模型通常是資料和模型平行的大型語言模型 (LLM)。舉例來說,如果 TPU v4 切片的拓撲為 8x16x16,則 TPU 拓撲維度為 8、16 和 16。使用 8 向或 16 向模型平行處理 (對應至其中一個實體 TPU 拓撲維度) 的效能較佳。如果採用這種拓撲,4 向模型平行處理並非最佳做法,因為這與任何 TPU 拓撲維度都不一致,但如果採用 4x16x32 拓撲,則可在相同數量的晶片上達到最佳效果。
TPU v4 設定分為兩組,一組拓撲小於 64 個晶片 (小型拓撲),另一組拓撲大於 64 個晶片 (大型拓撲)。
小型 v4 拓撲
Cloud TPU 支援下列 TPU v4 配量,其大小小於 64 個晶片 (4x4x4 立方體)。您可以使用 TensorCore 名稱 (例如 v4-32) 或拓撲 (例如 2x2x4) 建立這些小型 v4 拓撲:
| 名稱 (根據 TensorCore 數量) | 晶片數量 | 拓撲 |
| v4-8 | 4 | 2x2x1 |
| v4-16 | 8 | 2x2x2 |
| v4-32 | 16 | 2x2x4 |
| v4-64 | 32 | 2x4x4 |
大型 v4 拓撲
TPU v4 切片以 64 個晶片為單位遞增,形狀在三個維度上都是 4 的倍數。維度必須遞增。下表列出幾個範例。其中一些拓撲是「自訂」拓撲,只能使用 --type 和 --topology 旗標建立,因為有多種方式可以排列晶片。
| 名稱 (依 TensorCore 數量) | 晶片數量 | 拓撲 |
| v4-128 | 64 | 4x4x4 |
| v4-256 | 128 | 4x4x8 |
| v4-512 | 256 | 4x8x8 |
自訂拓撲:必須使用 --type 和 --topology 旗標 |
256 | 4x4x16 |
| v4-1024 | 512 | 8x8x8 |
| v4-1536 | 768 | 8x8x12 |
| v4-2048 | 1024 | 8x8x16 |
自訂拓撲:必須使用 --type 和 --topology 旗標 |
1024 | 4x16x16 |
| v4-4096 | 2048 | 8x16x16 |
| … | … | … |