


TPU 架構
Tensor Processing Unit (TPU) 是 Google 設計的特殊應用積體電路 (ASIC),專門用來加速機器學習的工作負載。您可以透過 Compute Engine、Google Kubernetes Engine 和 Vertex AI 使用 TPU。
TPU 專為快速執行矩陣運算而設計,非常適合機器學習工作負載。您可以使用 PyTorch 和 JAX 等框架,在 TPU 上執行機器學習工作負載。
TPU 如何運作?
如要瞭解 TPU 的運作方式,請先瞭解其他加速器如何解決訓練機器學習模型時的運算難題。
CPU 的運作方式
CPU 是以馮紐曼架構為基礎的一般用途處理器。這表示 CPU 與軟體和記憶體的互動方式如下:
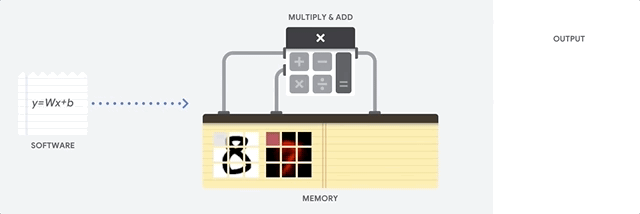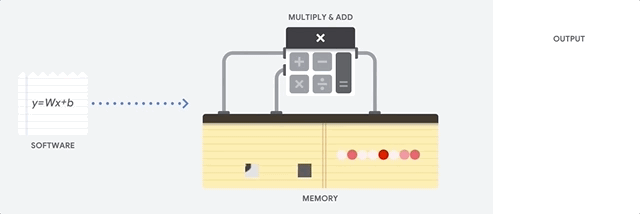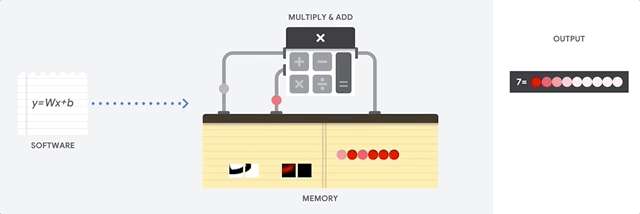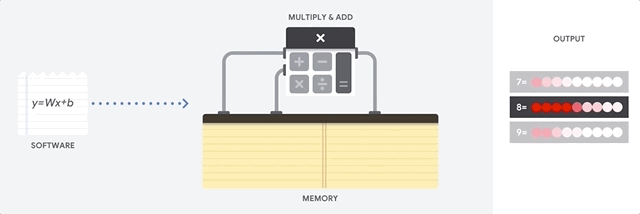
CPU 的最大優勢在於彈性。您可以在 CPU 上載入任何類型的軟體,用於許多不同類型的應用程式。例如,您可以使用 CPU 在電腦上處理文字、控制火箭引擎、執行銀行交易,或使用類神經網路分類圖片。
CPU 會從記憶體載入值、對值執行計算,並將結果存回記憶體,每次計算都是如此。與運算速度相比,記憶體存取速度較慢,可能會限制 CPU 的總處理量。這通常稱為馮紐曼瓶頸。
GPU 運作方式
為提高處理量,GPU 在單一處理器中包含數千個算術邏輯單元 (ALU)。現代 GPU 通常包含 2,500 到 5,000 個 ALU。正因為擁有這麼多處理單元,GPU 能同時執行數以千計的乘法與加法計算。
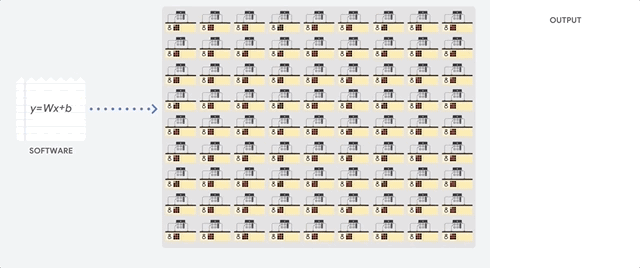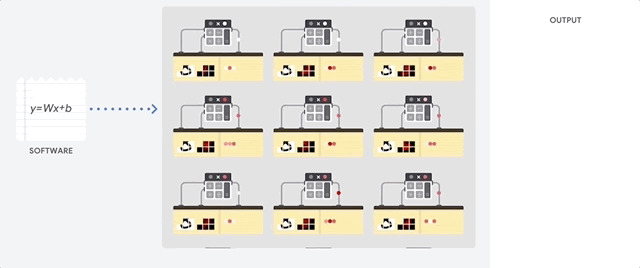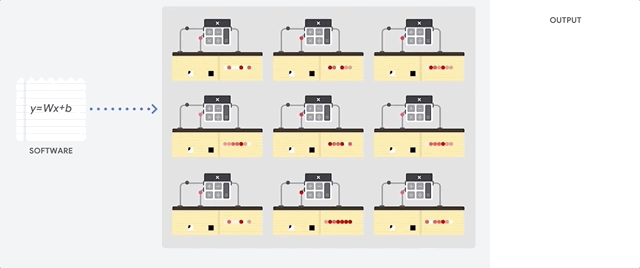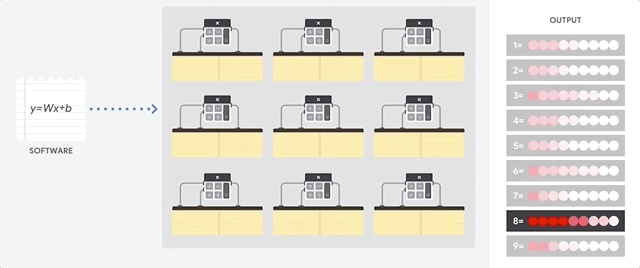
這種 GPU 架構適合需要大量平行作業的應用程式,例如神經網路中的矩陣運算。事實上,在深度學習的一般訓練工作負載中,GPU 的處理量可能比 CPU 高幾十倍。
不過,GPU 仍屬於一般用途處理器,必須支援許多不同的應用程式和軟體。因此,GPU 也會遇到與 CPU 相同的問題。在數千個 ALU 中,每項運算都需要 GPU 存取暫存器或共用記憶體,才能讀取運算元並儲存中間運算結果。
TPU 運作方式
Google 設計的 Cloud TPU 是專門用於類神經網路工作負載的矩陣處理器。TPU 無法執行文字處理器、控制火箭引擎或執行銀行交易,但能快速處理神經網路中使用的大量矩陣運算。
TPU 的主要任務是矩陣處理,也就是乘法和累加運算的組合。TPU 包含數千個直接互連的乘積累加器,形成大型實體矩陣。這稱為脈動陣列架構。Cloud TPU v3 在單一處理器上包含兩個 128 x 128 ALU 的脈動陣列。
TPU 主機會將資料串流至饋入佇列。TPU 會從饋入佇列載入資料,並儲存至高頻寬記憶體 (HBM)。運算完成後,TPU 會將結果載入輸出佇列。接著,TPU 主機會從輸出佇列讀取結果,並儲存至主機記憶體。
為執行矩陣運算,TPU 會將參數從 HBM 載入矩陣乘法單元 (MXU)。
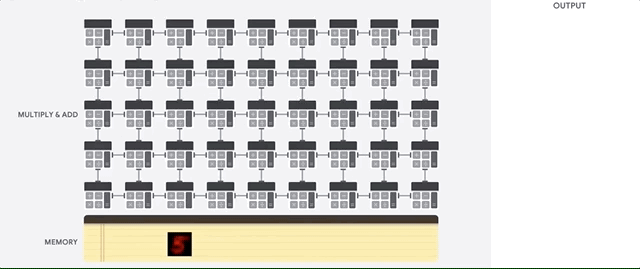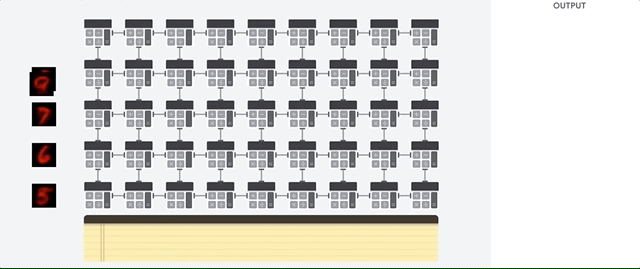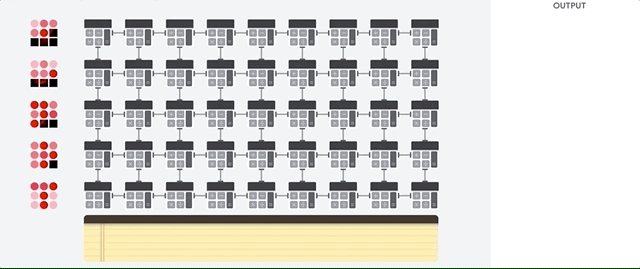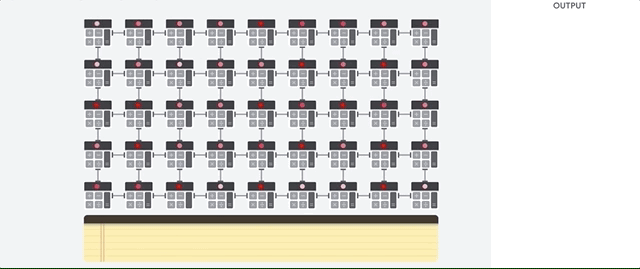
接著,TPU 會從 HBM 載入資料。每次執行乘法運算時,結果都會傳遞至下一個乘積累加器。輸出結果是資料和參數之間所有乘法結果的總和。在矩陣乘法過程中,不需要存取記憶體。
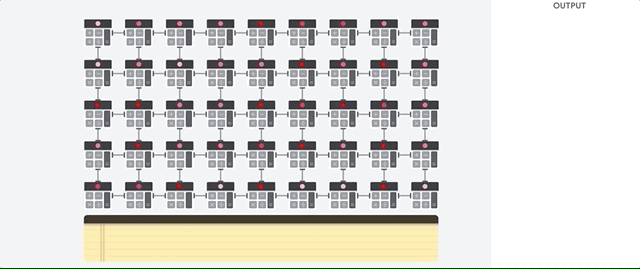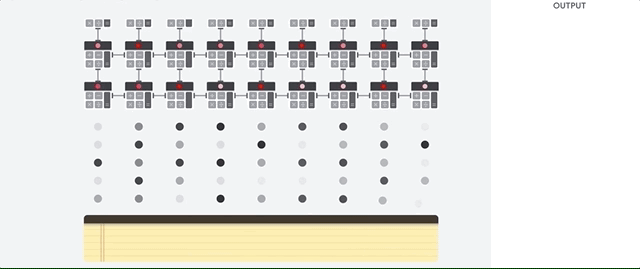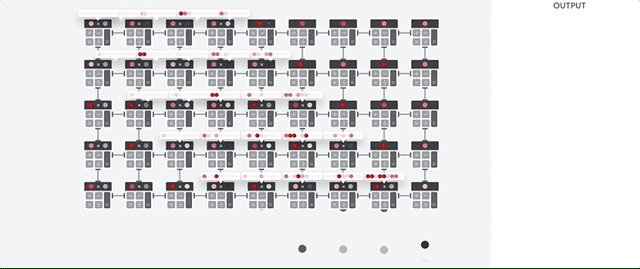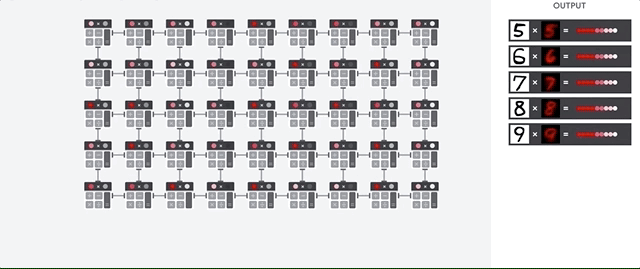
因此,TPU 可以在神經網路計算中達到高運算處理量。
TPU 系統架構
以下各節說明 TPU 系統的重要概念。如要進一步瞭解常見的機器學習術語,請參閱機器學習詞彙表。
如果您是 Cloud TPU 新手,請參閱 TPU 說明文件首頁。
TPU 晶片
TPU 晶片包含一或多個 TensorCore。TensorCore 數量取決於 TPU 晶片版本。每個 TensorCore 包含一或多個矩陣乘法單元 (MXU)、一個向量單元和一個純量單元。如要進一步瞭解 TensorCore,請參閱「用於訓練深層類神經網路的特定領域超級電腦」。
MXU 由 256 x 256 (TPU v6e 和 TPU7x) 或 128 x 128 (v6e 之前的 TPU 版本) 乘法累加器組成,採用脈動陣列。MXU 提供 TensorCore 的大部分運算能力。每個 128 x 128 MXU (TPU v5p 和更早版本) 每個週期會執行 16K 次乘積累加運算。每個 256 x 256 MXU (TPU v6e 和 TPU7x) 每個週期會執行 128K bfloat16 乘法累加運算。所有乘法運算都採用 bfloat16 輸入,以及支援世代的較低精確度格式 (例如 TPU v5e 和 v6e 上的 8 位元整數,以及 TPU v5p 和 TPU7x 上的 FP8),而累加運算則採用 FP32 數字格式。
向量單元用於執行一般運算,例如活化函數和 softmax。純量單元用於控制流程、計算記憶體位址和其他維護作業。
TPU Pod
TPU Pod 是透過專用網路分組在一起的一組連續 TPU。TPU Pod 中的 TPU 晶片數量取決於 TPU 版本。
配量
配量是一組晶片,全部位於同一個 TPU Pod 內,並透過高速晶片間互連 (ICI) 連接。配量通常會以晶片或 TensorCore 表示,視 TPU 版本而定。
拓撲
拓撲定義了 TPU 配量中 TPU 的實體排列方式。TPU 配量具有二維 (2D) 或三維 (3D) 拓撲,具體取決於 TPU 版本。指定拓撲時,請按照下列格式輸入各維度的 TPU 晶片數量:
- 3D 拓撲:您將拓撲定義為 3 元組 (
{A}x{B}x{C}),例如4x4x4。{A}x{B}x{C}的乘積定義了配量中的 TPU 晶片數量。如果使用的拓撲超過 64 個晶片,指派給{A}、{B}和{C}的值必須符合下列條件:{A}、{B}和{C}必須是 4 的倍數。- 指派的值必須符合以下模式:
{A}≤{B}≤{C}。例如4x4x8或8x8x8。
- 2D 拓撲:將拓撲定義為 2 元組 (
{A}x{B}),例如2x4。{A}x{B}的乘積定義了配量中的 TPU 晶片數量。
「單主機拓撲」是指 TPU 晶片來自單一運算主機的拓撲。舉例來說,TPU7x 的每個主機都連至四個晶片。2x2x1 切片有四個晶片,連接至單一主機,因此 2x2x1 是單一主機拓撲。
「多主機拓撲」是指 TPU 晶片來自多個運算主機的拓撲。舉例來說,如果是 TPU7x,2x2x2 (兩部主機的八個晶片) 和更大的配量都是多主機拓撲。
多配量與單配量
多配量是一組配量,可將 TPU 連線能力延伸至晶片間互連 (ICI) 連線之外,並利用資料中心網路 (DCN) 傳輸配量以外的資料。每個配量內的資料仍透過 ICI 傳輸。透過這種混合連線能力,多配量可跨配量平行處理,讓單一工作能使用的 TPU 核心數量,超過單一配量的上限。
TPU 可用於在單一或多個配量上執行工作。詳情請參閱「多配量簡介」。
TPU 立方體
由 64 個互連 TPU 晶片組成的 4x4x4 拓撲。這種架構僅適用於 3D 拓撲 (自 TPU v4 起採用)。在立方體中,相鄰的 TPU 晶片會使用高速銅線晶片間互連 (ICI) 連結。如要在 TPU Pod (適用於 TPU v4、v5p 和 TPU7x) 形成多立方體配量,每個 4x4x4 立方體的邊界連結會透過光學連結和可重新設定的光學電路交換器 (OCS),連線至 3D 環面或扭曲 3D 環面拓撲。
SparseCore
SparseCore 是資料流處理器,可使用稀疏作業加速模型。主要用途是加速推薦模型,這類模型高度依賴嵌入。v5p 和 TPU7x 每個晶片有四個 SparseCore,v6e 每個晶片有兩個 SparseCore。如要深入瞭解 SparseCore 的使用方式,請參閱「深入探討大型嵌入模型 (LEM) 的 SparseCore」。您可以使用 XLA 旗標,控管 XLA 編譯器使用 SparseCore 的方式。詳情請參閱「TPU XLA 旗標」。
Cloud TPU ICI 韌性
ICI 韌性可提升光學連結和光學電路交換器 (OCS) 的容錯能力,這些元件用於連接立方體之間的 TPU。(機櫃內的 ICI 連線使用銅線,不受影響)。ICI 復原力可讓 ICI 連線繞過 OCS 和光學 ICI 故障。因此,這項功能可提高 TPU slice 的排程可用性,但代價是 ICI 效能會暫時下降。
對於 Cloud TPU v4、v5p 和 TPU7x,系統會為一個立方體或更大規模的配量預設啟用 ICI 韌性功能,例如:
- 指定加速器類型時,請使用 v5p-128
- 指定加速器設定時,4x4x4
TPU 版本
TPU 晶片的確切架構取決於您使用的 TPU 版本。每個 TPU 版本也支援不同的切片大小和設定。如要進一步瞭解系統架構和支援的設定,請參閱下列頁面:
TPU 雲端架構
Google Cloud 透過 TPU VM 將 TPU 做為運算資源。您可以透過 Compute Engine、Google Kubernetes Engine、Vertex AI,將 TPU 用於工作負載。以下各節說明 TPU 雲端架構的重要元件。
TPU VM 架構
TPU VM 架構可讓您使用 SSH,直接連線至與 TPU 裝置實體連結的 VM。TPU VM (也稱為 worker) 是執行 Linux 的虛擬機器,可存取基礎 TPU。您擁有 VM 的根存取權,因此可以執行任意程式碼。您可以存取編譯器和執行階段偵錯記錄檔,以及錯誤訊息。
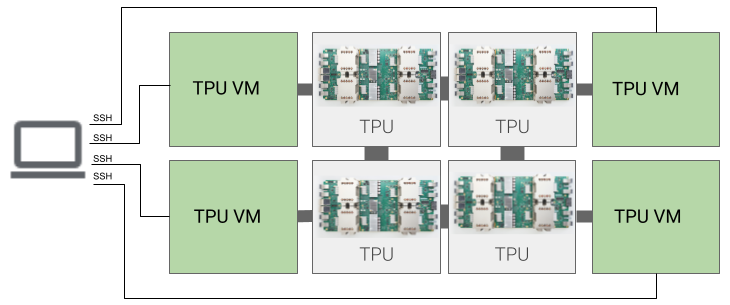
單一主機、多主機和子主機
TPU 主機是在實體電腦上運作的 VM,連接至 TPU 硬體。TPU 工作負載可以使用一或多部主機。
單一主機工作負載僅限一個 TPU VM。多主機工作負載會將訓練作業分配至多個 TPU VM。子主機工作負載不會使用 TPU VM 上的所有晶片。
TPU 拓撲視覺化工具
TPU 拓撲視覺化工具可讓您以視覺化方式,查看實體資料中心內 TPU 的實體配置和相關網路基礎架構。使用這項工具,即可瞭解不同 TPU 世代和拓撲的實體基礎架構版面配置。