


Arsitektur TPU
Tensor Processing Unit (TPU) adalah sirkuit terintegrasi khusus aplikasi (ASIC) yang dirancang oleh Google untuk mempercepat workload machine learning. Anda dapat menggunakan TPU melalui Compute Engine, Google Kubernetes Engine, dan Vertex AI.
TPU dirancang untuk melakukan operasi matriks dengan cepat, sehingga ideal untuk workload machine learning. Anda dapat menjalankan workload machine learning di TPU menggunakan framework seperti PyTorch dan JAX.
Bagaimana cara kerja TPU?
Untuk memahami cara kerja TPU, sebaiknya pahami cara akselerator lain mengatasi tantangan komputasi dalam melatih model ML.
Cara kerja CPU
CPU adalah prosesor tujuan umum yang didasarkan pada arsitektur von Neumann. Artinya, CPU bekerja dengan software dan memori seperti ini:
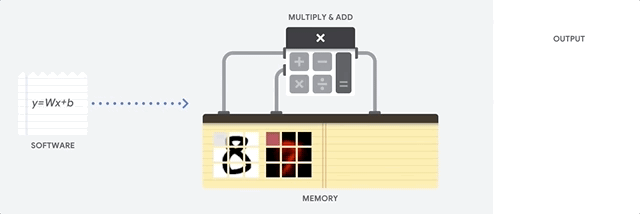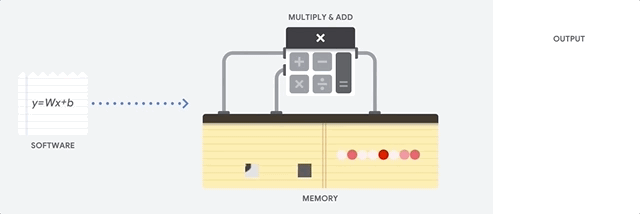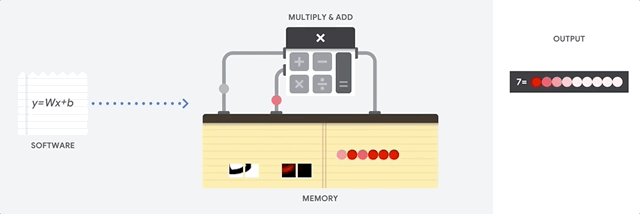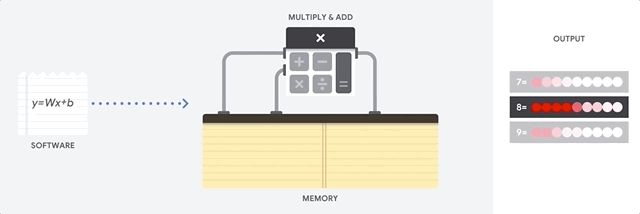
Manfaat terbesar CPU adalah fleksibilitasnya. Anda dapat memuat berbagai jenis software di CPU untuk berbagai jenis aplikasi. Misalnya, Anda dapat menggunakan CPU untuk pengolah kata di PC, mengendalikan mesin roket, menjalankan transaksi bank, atau mengklasifikasikan gambar dengan jaringan neural.
CPU memuat nilai dari memori, melakukan penghitungan pada nilai, dan menyimpan hasilnya kembali ke memori untuk setiap penghitungan. Akses memori lambat jika dibandingkan dengan kecepatan penghitungan dan dapat membatasi total throughput CPU. Hal ini sering disebut sebagai Von Neumann bottleneck.
Cara kerja GPU
Untuk mendapatkan throughput yang lebih tinggi, GPU berisi ribuan Unit Logika Aritmetika (ALU) dalam satu prosesor. GPU modern biasanya berisi antara 2.500–5.000 ALU. Jumlah prosesor yang besar berarti Anda dapat menjalankan ribuan perkalian dan penambahan secara bersamaan.
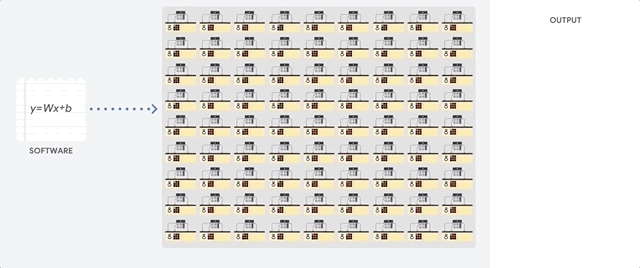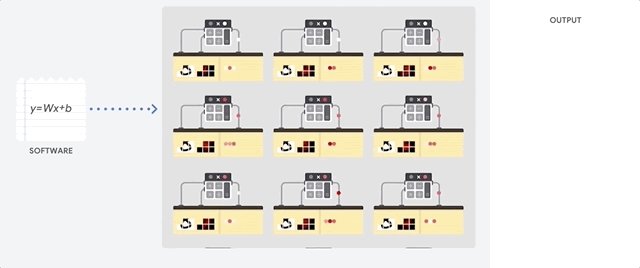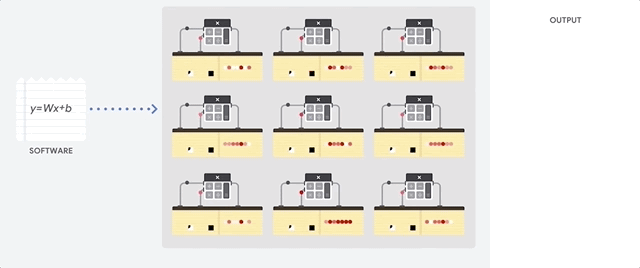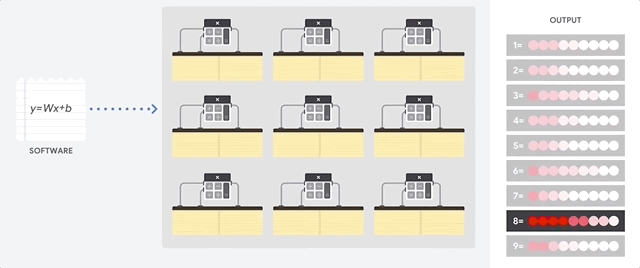
Arsitektur GPU ini berfungsi dengan baik pada aplikasi dengan paralelisme besar, seperti operasi matriks dalam jaringan neural. Bahkan, pada workload pelatihan umum untuk deep learning, GPU dapat memberikan throughput yang jauh lebih tinggi dibandingkan CPU.
Namun, GPU tetap merupakan prosesor dengan tujuan umum yang harus mendukung banyak aplikasi dan software yang berbeda. Oleh karena itu, GPU memiliki masalah yang sama dengan CPU. Untuk setiap penghitungan dalam ribuan ALU, GPU harus mengakses register atau memori bersama untuk membaca operand dan menyimpan hasil penghitungan sementara.
Cara kerja TPU
Google mendesain Cloud TPU sebagai prosesor matriks yang dikhususkan untuk workload jaringan neural. TPU tidak dapat menjalankan pengolah kata, mengontrol mesin roket, atau mengeksekusi transaksi bank, tetapi dapat menangani operasi matriks masif yang digunakan dalam neural network dengan kecepatan tinggi.
Tugas utama TPU adalah pemrosesan matriks, yang merupakan kombinasi dari operasi perkalian dan akumulasi. TPU berisi ribuan multiply-accumulator yang terhubung langsung satu sama lain untuk membentuk matriks fisik yang besar. Ini disebut arsitektur array sistolik. Cloud TPU v3, berisi dua array sistolik ALU 128 x 128, pada satu prosesor.
Host TPU mengalirkan data ke antrean infeed. TPU memuat data dari antrean infeed dan menyimpannya di High Bandwidth Memory (HBM). Setelah komputasi selesai, TPU akan memuat hasilnya ke dalam antrean outfeed. Host TPU kemudian membaca hasil dari antrean outfeed dan menyimpannya di memori host.
Untuk melakukan operasi matriks, TPU memuat parameter dari HBM ke dalam Matrix Multiplication Unit (MXU).
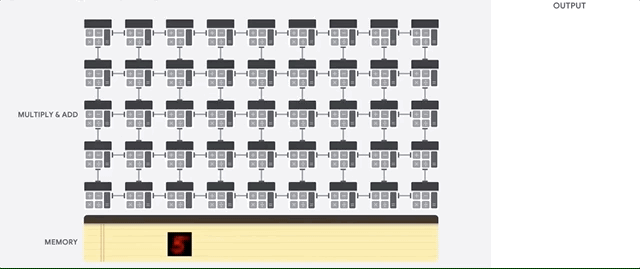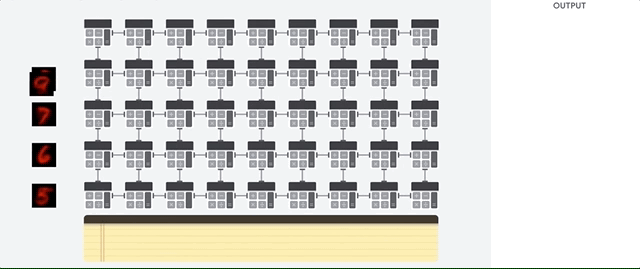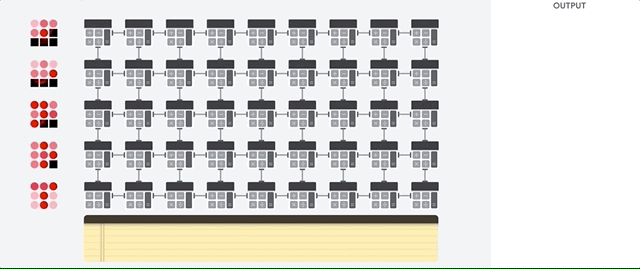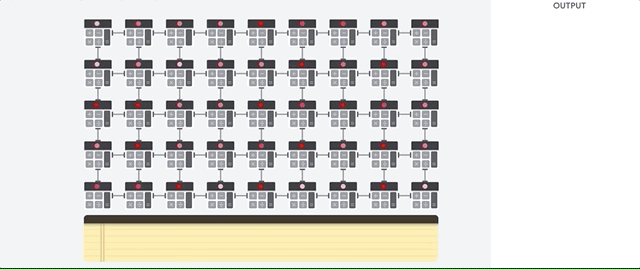
Kemudian, TPU memuat data dari HBM. Saat setiap perkalian dijalankan, hasilnya diteruskan ke multiply-accumulator berikutnya. Outputnya adalah penjumlahan dari semua hasil perkalian antara data dan parameter. Tidak diperlukan akses memori selama proses perkalian matriks.
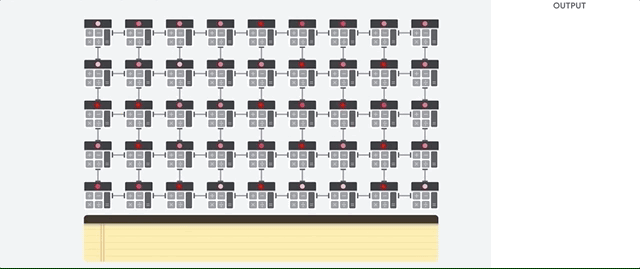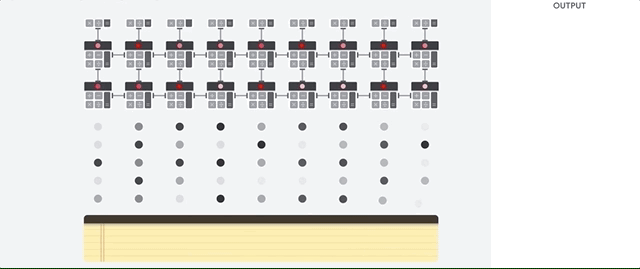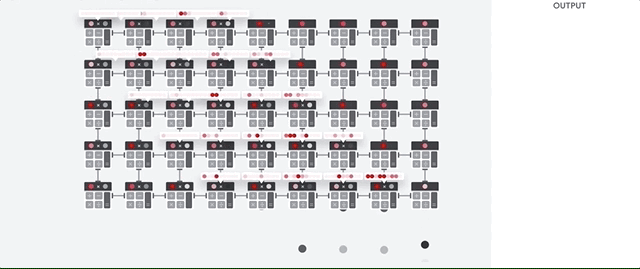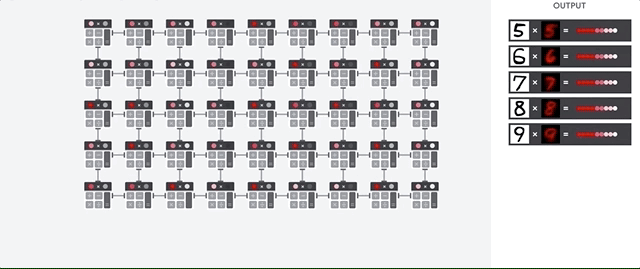
Hasilnya, TPU dapat mencapai throughput komputasi yang tinggi pada penghitungan jaringan neural.
Arsitektur sistem TPU
Bagian berikut menjelaskan konsep utama sistem TPU. Untuk mengetahui informasi selengkapnya tentang istilah machine learning umum, lihat Glosarium Machine Learning.
Jika Anda baru menggunakan Cloud TPU, lihat halaman beranda dokumentasi TPU.
TPU chip
Chip TPU berisi satu atau beberapa TensorCore. Jumlah TensorCore bergantung pada versi TPU chip. Setiap TensorCore terdiri dari satu atau beberapa matrix-multiply unit (MXU), satu unit vektor, dan satu unit skalar. Untuk mengetahui informasi selengkapnya tentang TensorCore, lihat Superkomputer Khusus Domain untuk Melatih Jaringan Neural Dalam.
MXU terdiri dari 256 x 256 (TPU v6e dan TPU7x) atau 128 x 128 (versi TPU sebelum v6e) multiply-accumulator dalam array sistolik. MXU menyediakan sebagian besar daya komputasi di TensorCore. Setiap MXU 128 x 128 (TPU v5p dan yang lebih lama) melakukan 16 ribu operasi multiply-accumulate per siklus. Setiap MXU 256 x 256 (TPU v6e dan TPU7x) melakukan 128 ribu operasi perkalian-akumulasi bfloat16 per siklus. Semua perkalian menggunakan input bfloat16, serta format presisi yang lebih rendah pada generasi yang didukung (seperti bilangan bulat 8-bit pada TPU v5e dan v6e, serta FP8 pada TPU v5p dan TPU7x), sedangkan akumulasi dilakukan dalam format angka FP32.
Unit vektor digunakan untuk komputasi umum seperti aktivasi dan softmax. Unit skalar digunakan untuk alur kontrol, menghitung alamat memori, dan operasi pemeliharaan lainnya.
Pod TPU
Pod TPU adalah kumpulan TPU yang berdekatan dan dikelompokkan bersama melalui jaringan khusus. Jumlah TPU chip dalam Pod TPU bergantung pada versi TPU.
Slice
Slice adalah kumpulan chip yang semuanya terletak di dalam Pod TPU yang sama dan terhubung oleh interkoneksi antar-chip (ICI) berkecepatan tinggi. Slice dideskripsikan berdasarkan chip atau TensorCore, bergantung pada versi TPU.
Topologi
Topologi menentukan susunan fisik TPU dalam slice TPU. Slice TPU memiliki topologi dua dimensi (2D) atau tiga dimensi (3D), bergantung pada versi TPU. Anda menentukan topologi sebagai jumlah TPU chip di setiap dimensi sebagai berikut:
- Topologi 3D: Anda menentukan topologi sebagai 3-tuple (
{A}x{B}x{C}), misalnya,4x4x4. Produk{A}x{B}x{C}menentukan jumlah chip TPU dalam slice. Jika Anda menggunakan topologi dengan lebih dari 64 chip, nilai yang Anda tetapkan ke{A},{B}, dan{C}harus memenuhi kondisi berikut:{A},{B}, dan{C}harus merupakan kelipatan empat.- Nilai yang ditetapkan harus mengikuti pola ini:
{A}≤{B}≤{C}. Contohnya,4x4x8atau8x8x8.
- Topologi 2D: Anda menentukan topologi sebagai 2-tuple (
{A}x{B}), misalnya,2x4. Produk{A}x{B}menentukan jumlah TPU chip dalam slice.
Topologi host tunggal mengacu pada topologi dengan chip TPU dari satu host komputasi. Misalnya, untuk TPU7x, setiap host terhubung ke empat chip. Slice 2x2x1 memiliki empat chip yang terhubung ke satu host, sehingga 2x2x1 adalah topologi host tunggal.
Topologi multi-host mengacu pada topologi dengan chip TPU dari lebih dari satu
host komputasi. Misalnya, untuk TPU7x, 2x2x2 (delapan chip dari dua host) dan slice yang lebih besar adalah topologi multi-host.
Multislice versus slice tunggal
Multislice adalah sekelompok slice, yang memperluas konektivitas TPU melampaui koneksi inter-chip interconnect (ICI) dan memanfaatkan jaringan pusat data (DCN) untuk mengirimkan data di luar slice. Data dalam setiap slice masih ditransmisikan oleh ICI. Dengan menggunakan konektivitas hybrid ini, Multislice memungkinkan paralelisme di seluruh slice dan memungkinkan Anda menggunakan jumlah core TPU yang lebih besar untuk satu tugas daripada yang dapat ditampung oleh satu slice.
TPU dapat digunakan untuk menjalankan tugas di satu slice atau beberapa slice. Lihat Pengantar Multislice untuk mengetahui detail selengkapnya.
Kubus TPU
Topologi 4x4x4 dari 64 TPU chip yang saling terhubung. Kubus ini hanya berlaku untuk topologi 3D (mulai dari TPU v4). Dalam sebuah kubus, chip TPU yang berdekatan terhubung menggunakan link inter-chip interconnect (ICI) tembaga berkecepatan tinggi. Untuk membentuk slice multi-kubus di seluruh Pod TPU (untuk TPU v4, v5p, dan TPU7x), link batas setiap kubus 4x4x4 dihubungkan melalui link optik dan optical circuit switch (OCS) yang dapat dikonfigurasi ulang menjadi topologi torus 3D atau torus 3D twisted.
SparseCore
SparseCore adalah prosesor aliran data yang mempercepat model menggunakan operasi sparse. Kasus penggunaan utamanya adalah mempercepat model rekomendasi, yang sangat bergantung pada embedding. v5p dan TPU7x memiliki empat SparseCore per chip, dan v6e memiliki dua SparseCore per chip. Untuk penjelasan mendalam tentang cara penggunaan SparseCore, lihat Pembahasan mendalam tentang SparseCore untuk Model Embedding Besar (LEM). Anda mengontrol cara compiler XLA menggunakan SparseCore menggunakan flag XLA. Untuk mengetahui informasi selengkapnya, lihat: Flag XLA TPU.
Resiliensi ICI Cloud TPU
Resiliensi ICI membantu meningkatkan fault tolerance link optik dan sakelar sirkuit optik (OCS) yang menghubungkan TPU antar-kubus. (Koneksi ICI dalam kubus menggunakan link tembaga yang tidak terpengaruh). Ketahanan ICI memungkinkan koneksi ICI dirutekan di sekitar OCS dan kesalahan ICI optik. Hasilnya, ketersediaan penjadwalan slice TPU meningkat, dengan konsekuensi penurunan performa ICI untuk sementara.
Untuk Cloud TPU v4, v5p, dan TPU7x, ketahanan ICI diaktifkan secara default untuk slice yang berukuran satu kubus atau lebih besar, misalnya:
- v5p-128 saat menentukan jenis akselerator
- 4x4x4 saat menentukan konfigurasi akselerator
Versi TPU
Arsitektur pasti dari TPU chip bergantung pada versi TPU yang Anda gunakan. Setiap versi TPU juga mendukung ukuran dan konfigurasi slice yang berbeda. Untuk mengetahui informasi selengkapnya tentang arsitektur sistem dan konfigurasi yang didukung, lihat halaman berikut:
Arsitektur cloud TPU
Google Cloud menyediakan TPU sebagai resource komputasi melalui VM TPU. Anda dapat menggunakan TPU untuk workload Anda melalui Compute Engine, Google Kubernetes Engine, Vertex AI. Bagian berikut menjelaskan komponen utama arsitektur cloud TPU.
Arsitektur VM TPU
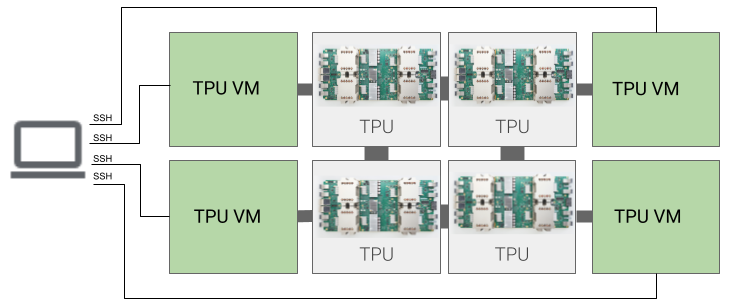
Arsitektur VM TPU memungkinkan Anda terhubung langsung ke VM yang terhubung secara fisik ke perangkat TPU menggunakan SSH. VM TPU, yang juga dikenal sebagai worker, adalah virtual machine yang menjalankan Linux yang memiliki akses ke TPU yang mendasarinya. Anda memiliki akses root ke VM, sehingga Anda dapat menjalankan kode arbitrer. Anda dapat mengakses log debug dan pesan error compiler dan runtime.
Satu host, multi-host, dan sub-host
Host TPU adalah VM yang berjalan di komputer fisik yang terhubung ke hardware TPU. Workload TPU dapat menggunakan satu atau beberapa host.
Workload host tunggal dibatasi untuk satu VM TPU. Workload multi-host mendistribusikan pelatihan ke beberapa VM TPU. Workload sub-host tidak menggunakan semua chip di VM TPU.
Visualizer topologi TPU
Visualizer topologi TPU adalah alat yang memungkinkan Anda memvisualisasikan tata letak fisik TPU dan infrastruktur jaringan terkaitnya dalam pusat data fisik. Gunakan alat ini untuk memahami tata letak infrastruktur fisik untuk berbagai generasi dan topologi TPU.