


PyTorch di Cloud TPU
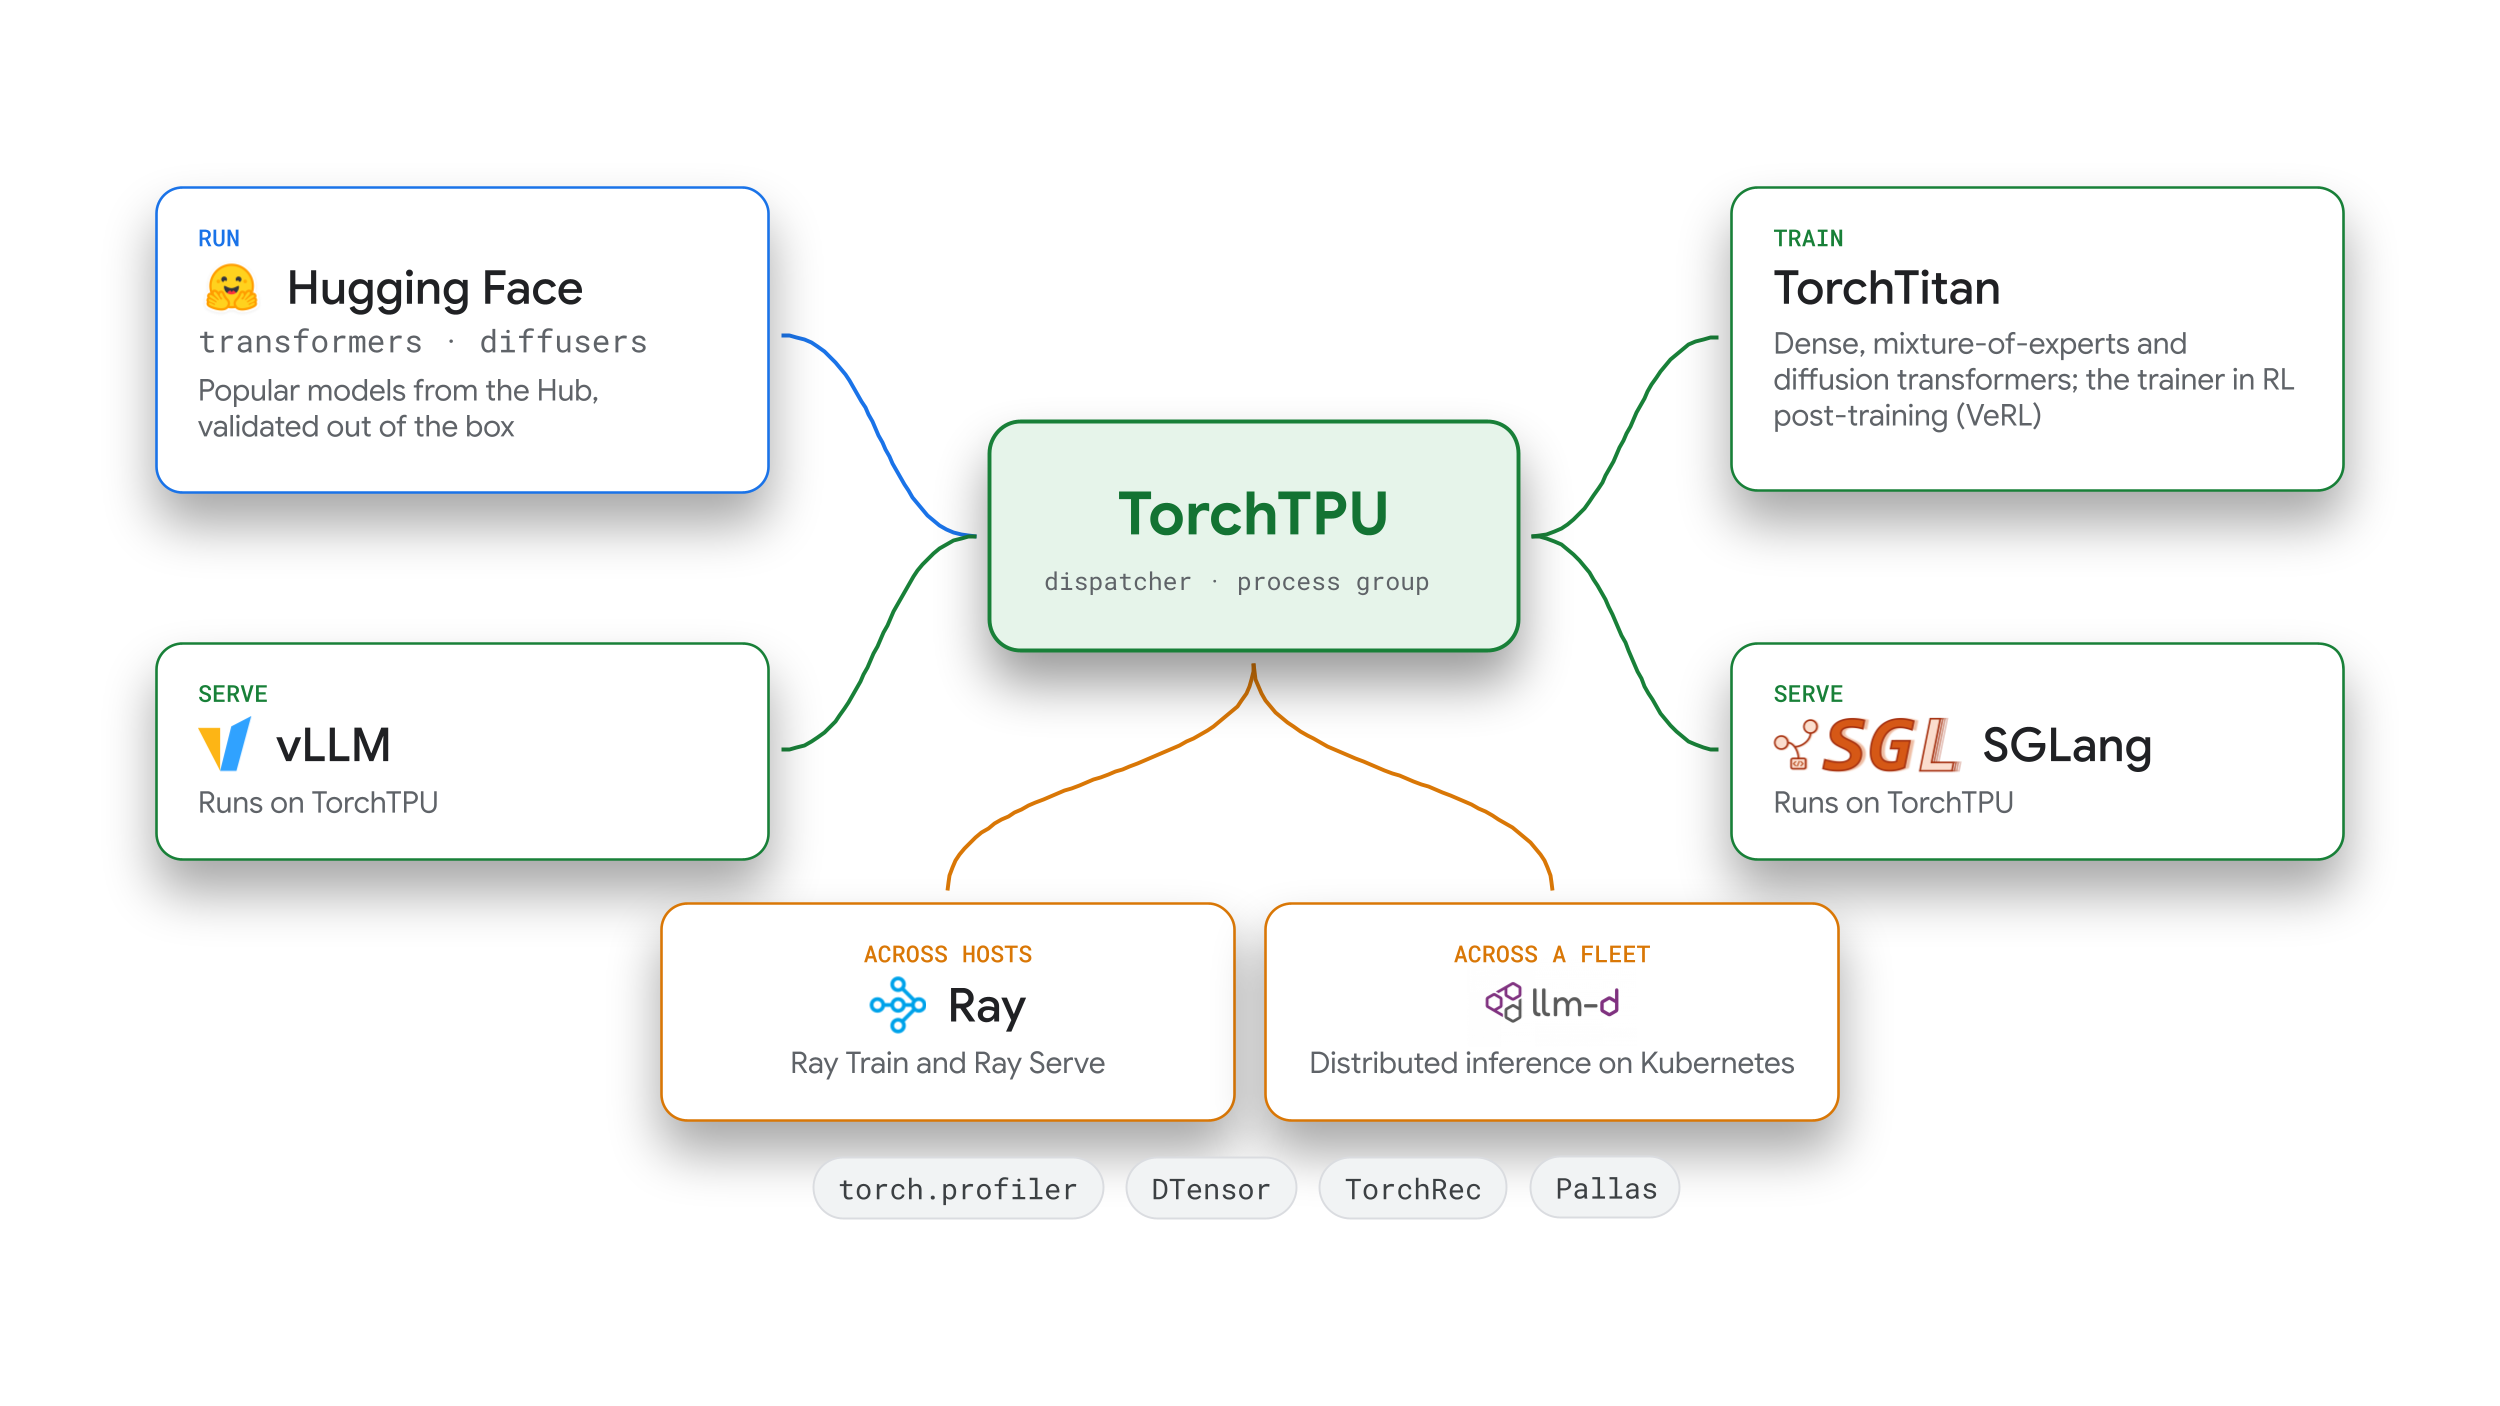
PyTorch di Cloud TPU memungkinkan Anda melatih, menyesuaikan, dan menyajikan model terbuka di hardware Cloud TPU menggunakan semantik PyTorch standar dan API terdistribusi. Stack ini terintegrasi dengan alat ekosistem yang sudah Anda gunakan, termasuk Hugging Face, vLLM, SGLang, llm-d, TorchTitan, TorchRec, dan Ray.
Di dasar stack ini terdapat TorchTPU, backend native PyTorch open source yang dikembangkan bersama tim PyTorch di Meta. TorchTPU menyediakan library, framework, dan alat untuk setiap tahap siklus proses machine learning, mulai dari eksekusi runtime inti dan kernel kustom hingga inferensi produksi, pelatihan skala besar, dan orkestrasi cluster.
Mulai
- Menjalankan model PyTorch di TPU: mulai dengan TorchTPU dan dokumentasi TorchTPU.
- Menyajikan model bahasa besar (LLM) dan model multimodal: gunakan vLLM-TorchTPU atau SGLang-TorchTPU.
- Merutekan permintaan di seluruh fleet Kubernetes: gunakan llm-d.
- Melakukan pra-pelatihan atau penyesuaian model dasar: gunakan TorchTitan di TPU (atau TorchRec untuk model rekomendasi).
- Menskalakan pipeline pemrosesan data, pelatihan, reinforcement learning (RL), dan penyajian: gunakan Ray.
- Melakukan orientasi, membuat profil, dan menyesuaikan model dengan asisten coding Anda: gunakan TPU agent suite (Pratinjau).
TorchTPU: Backend native PyTorch untuk Cloud TPU
TorchTPU menyediakan backend perangkat, integrasi compiler grafik, dan API kernel kustom untuk PyTorch di Cloud TPU. Dibuat bersama tim PyTorch, TorchTPU memungkinkan Anda men-debug model secara interaktif dalam mode eager, mengompilasi kode model dengan torch.compile, dan menskalakan di seluruh slice dengan torch.distributed (tpu_dist).
Untuk menginstal TorchTPU, jalankan perintah berikut:
pip install torch_tpu
Untuk menjalankan operasi tensor di Cloud TPU, jalankan kode Python berikut:
import torch

device = torch.device("tpu")

x = torch.randn((4, 4), device=device)
y = torch.ones((4, 4), device=device)
result = torch.matmul(x, y).cpu()

print(f"Executed on device: {x.device}")
print(f"Result shape on CPU: {result.shape}, sum: {result.sum():.4f}")
Video berikut memberikan ringkasan singkat tentang TorchTPU:
Untuk informasi lebih mendalam, lihat Cara kerja TorchTPU.
Motivasi
Meskipun Cloud TPU secara historis telah dipasangkan dengan JAX dan TensorFlow, menjalankan PyTorch di TPU sebelumnya memerlukan perekaman grafik lazy-tensor (PyTorch/XLA), yang sering kali berarti menambahkan kode untuk menandai region yang dapat dikompilasi. TorchTPU menjalankan operasi secara eager secara default menggunakan model eksekusi satu proses per perangkat standar PyTorch, sehingga workload dan library yang ada berjalan tanpa penulisan ulang struktural.
Desain
TorchTPU menghadirkan dukungan TPU native PyTorch ke PyTorch dengan tiga sasaran desain:
- Semantik PyTorch standar: menjalankan satu proses per perangkat dan mempertahankan tampilan tensor PyTorch serta mutasi di tempat tanpa dependensi runtime JAX.
- Eksekusi segera secara default: menjalankan model PyTorch standar secara langsung dalam mode segera untuk proses debug interaktif dan pemeriksaan langkah demi langkah.
- Pengoptimalan compiler dan kernel: menyediakan fusi operator dalam mode eager
(selain eksekusi segera operator demi operator), integrasi
torch.compiledengan batas bentuk dinamis untuk mengurangi kompilasi ulang, dan API kernel kustom.
Untuk kompilasi grafik, torch.compile menangkap grafik komputasi PyTorch
dengan TorchDynamo dan mengompilasinya ke dalam kode mesin TPU melalui OpenXLA dan
StableHLO. Operasi kolektif berjalan di tingkat grup proses torch.distributed (tpu_dist).
Kekuatan utama
- Dukungan operator, model, dan Hugging Face: TorchTPU mendukung operator PyTorch (ATen) standar dalam penerusan maju dan mundur, serta terus diuji terhadap model Hugging Face populer. Anda dapat men-deploy model di
Transformers v5 dengan meneruskan
device_map="tpu", menjalankan pipeline Diffusers dengan mode eager,torch.compile, dan paralelisme tensor, serta membuat profil workload dengantorch.profilerdi TensorBoard dan XProf. - Penskalaan Chip tunggal ke Multislice: backend
tpu_distmendukungDistributedDataParallel(DDP),FullyShardedDataParallel(FSDP2), danDTensor. Selain itu,torch.tpu.distributed.topology_aware_meshmemetakan dimensi paralelisme ke interkoneksi TPU fisik. - Mode eksekusi segera yang dapat dikonfigurasi: menyediakan tiga mode eksekusi segera:
Strict(default): mengirimkan operator satu per satu dan secara asinkron, dengan semantik PyTorch imperatif standar.Debug: berjalan secara sinkron dengan pemeriksaan batas tensor.DeferAndFuse: menggabungkan urutan operator eager untuk mengurangi traffic memori bandwidth tinggi (HBM).
- Kompilasi dan penyimpanan ke dalam cache grafik penuh:
torch.compile(backend="tpu")mengompilasi grafik menjadi file yang dapat dieksekusi TPU dan menyimpannya ke dalam cache di seluruh proses, host, dan mulai ulang tugas. - Kernel TPU kustom: Anda dapat memanggil kernel Pallas kustom, termasuk kernel yang berkomunikasi langsung antar-chip, sebagai fungsi PyTorch standar. Anda juga dapat menggunakan kernel bawaan dari library Tokamax atau menulis kernel berbasis ubin portabel dengan Helion.
Untuk mengetahui informasi selengkapnya, lihat dokumentasi TorchTPU, ajukan pertanyaan di forum diskusi PyTorch di TPU, atau laporkan masalah di Issue tracker TorchTPU.
Inferensi dan penyajian produksi
Untuk deployment produksi, PyTorch di Cloud TPU terintegrasi dengan mesin inferensi open source dan infrastruktur penyaluran terdistribusi native Kubernetes.
vLLM-TorchTPU dan SGLang-TorchTPU: Mesin inferensi
vLLM-TorchTPU dan SGLang-TorchTPU adalah backend TorchTPU untuk mesin inferensi vLLM dan SGLang. Kedua backend menjalankan model terbuka seperti Qwen, DeepSeek, GLM, Kimi, GPT-OSS, dan Gemma 4.
Untuk mengetahui informasi selengkapnya, lihat dokumentasi vLLM-TorchTPU dan Mengumumkan mesin inferensi vLLM dan SGLang baru di TPU.
Motivasi
Menyajikan workload penalaran, multimodal, dan penggunaan alat sering kali memerlukan definisi model kustom, metode decoding spekulatif, dan skema kuantisasi. Membangun backend vLLM dan SGLang di TorchTPU memungkinkan Anda menyesuaikan dan men-debug stack inferensi langsung di PyTorch.
Desain
Kedua backend mempertahankan penjadwal vLLM dan SGLang standar, pengelola cache nilai kunci (KV), dan server API saat menggunakan eksekusi TorchTPU dan operator Pallas kustom di bawahnya. Sebagian besar model menjalankan definisi model PyTorch standar, sedangkan blok komputasi intensif memanggil kernel Pallas di dalam grafik yang dikompilasi sehingga kernel khusus hardware dapat diupdate secara independen.
Kekuatan utama
- Paralelisme, kuantisasi, dan decoding spekulatif: mendukung paralelisme tensor, data, pakar, pipeline, dan konteks di seluruh host, serta input multimodal (gambar dan video) dan embedding. Metode decoding spekulatif yang didukung mencakup prediksi multi-token (MTP), EAGLE-3, DFlash, DSpark, dan pencocokan n-gram. Format kuantisasi yang didukung mencakup cache KV 8-bit (FP8) serta checkpoint model floating point 8-bit (FP8) dan 4-bit (MXFP4 dan NVFP4).
- Caching awalan dua tingkat, panggilan alat, dan output terstruktur: caching awalan otomatis mempertahankan awalan aktif di HBM dan memindahkan awalan yang lebih lama ke memori host untuk menghindari komputasi ulang pada permintaan multi-giliran. Caching ini mendukung model perhatian hibrid dan berulang, serta panggilan alat dan output terstruktur sudah disertakan.
- Transfer cache KV yang tumpang-tindih dengan TPU Sync: mendukung inferensi pengisian awal dan dekode yang terpisah (memisahkan pemrosesan perintah dan pembuatan token ke pool worker yang berbeda) di seluruh host dan offload KV host menggunakan TPU Sync. TPU Sync adalah library C++ open source yang membaca buffer perangkat PyTorch langsung di thread latar belakang tanpa menyalin data melalui memori CPU host.
Untuk mengetahui informasi selengkapnya tentang vLLM-TorchTPU, lihat repositori vLLM-TorchTPU dan resep vLLM-TorchTPU untuk TPU7x, ajukan pertanyaan di saluran Slack vLLM, atau laporkan masalah di Issue Tracker vLLM-TorchTPU.
Untuk mengetahui informasi selengkapnya tentang SGLang-TorchTPU, lihat repositori SGLang-TorchTPU atau laporkan masalah di Issue Tracker SGLang-TorchTPU.
llm-d: Inferensi terdistribusi berbasis Kubernetes
llm-d adalah framework sandbox Cloud Native Computing Foundation (CNCF) open source untuk inferensi LLM terdistribusi di Kubernetes. Knative dikembangkan bersama Red Hat, IBM, Google Cloud, dan komunitas yang terdiri dari lebih dari 500 kontributor dan 35 organisasi.
Motivasi
Meskipun mesin inferensi instance tunggal mengelola eksekusi per replika, fleet produksi harus menangani lonjakan traffic, prioritas multi-tenant, berbagi konteks di seluruh fleet, dan peluncuran tanpa periode nonaktif. llm-d menyediakan lapisan perutean dan operasi tingkat cluster untuk mengoordinasikan fleet server inferensi.
Desain
llm-d berjalan di depan server model seperti vLLM dan SGLang di Kubernetes. llm-d menyediakan hal berikut:
- Merutekan permintaan berdasarkan status cache awalan dan beban replika.
- Mengoordinasikan kumpulan worker prefill dan dekode yang dipisahkan.
- Mendukung sharding mixture-of-experts (MoE) dan inferensi batch asinkron.
- Mengelola offload cache KV bertingkat di seluruh memori perangkat, memori host, dan penyimpanan.
Kekuatan utama
- Pemilihan rute sesi multi-turn: mengarahkan percakapan multi-turn ke replika yang menyimpan konteks yang di-cache. Penjadwalan prioritas giliran dan dukungan Responses API stateful memungkinkan agen menggunakan kembali konteks di seluruh giliran untuk mengurangi komputasi ulang.
- Kualitas layanan multi-tenant: kontrol alur prioritas dan keadilan memungkinkan permintaan yang sensitif terhadap latensi dan workload agen yang bursty berbagi fleet tanpa kekurangan resource.
- Operasi fleet dan update bertahap: menyediakan API konfigurasi v1, ketersediaan tinggi router, dan update bertahap terkoordinasi yang mengelola replika pra-pengisian dan dekode sebagai satu unit logis.
- Penyajian TorchTPU native di Google Kubernetes Engine (GKE): Anda dapat menyajikan Cloud TPU bersama akselerator lain di balik satu endpoint llm-d dan mengelola replika vLLM-TorchTPU dan SGLang-TorchTPU dengan alat Kubernetes standar.
Untuk mengetahui informasi selengkapnya, lihat llm-d Router di Tentang GKE Inference Gateway dan panduan GKE Gateway llm-d, ajukan pertanyaan di saluran Slack llm-d, atau laporkan masalah di Issue Tracker llm-d.
Library pelatihan, penyesuaian, dan domain
Untuk melakukan pra-pelatihan, penyesuaian, dan adaptasi model besar, TorchTPU menyediakan resep pelatihan referensi dan library khusus domain yang disesuaikan untuk hardware TPU.
TorchTitan di TPU: Referensi pelatihan berskala besar
TorchTitan di TPU memperluas TorchTitan, platform referensi modular PyTorch untuk pelatihan AI generatif, dengan penerusan sharding TPU, kernel kustom, dan resep pelatihan.
Motivasi
Penskalaan pelatihan di seluruh slice TPU multi-host memerlukan parameter sharding di seluruh interkoneksi chip dan komunikasi yang tumpang-tindih dengan komputasi. Google dan Meta bersama-sama mengembangkan sharding TPU dan penerusan kompilasi di dalam TorchTitan, sehingga Anda tidak perlu merancang strategi sharding TPU kustom atau menjadwalkan komunikasi secara manual.
Desain
Anda menulis model di PyTorch perangkat tunggal tanpa kode khusus akselerator. TorchTitan mengonfigurasi lapisan model dari file konfigurasi, sehingga Anda dapat mengganti lapisan individual dengan kernel Pallas kustom (seperti Splash Attention) tanpa mengedit definisi model atau loop pelatihan.
Implementasi SimpleFSDP TorchTitan menempatkan operasi sharding parameter langsung di dalam grafik yang dikompilasi sehingga compiler XLA dapat tumpang-tindih komunikasi perangkat dengan komputasi. Selain itu, kompilasi grafik langkah penuh
menangkap seluruh langkah pelatihan sebagai satu program XLA. Untuk
operasi Multislice, sharding hybrid (HSDP) melakukan sharding dalam setiap slice
melalui interkoneksi antar-chip (ICI) dan mereplikasi di seluruh slice melalui
jaringan pusat data (DCN). Tata letak ini membatasi traffic lintas-slice menjadi satu
pengurangan gradien per langkah.
Kekuatan utama
- Resep pra-pelatihan dan pasca-pelatihan RL: mencakup resep referensi untuk LLM padat (Llama 3, Qwen 3, dan MuseGlimmer 30B), model MoE (Qwen 3 235B, divalidasi pada hingga 8.192 chip TPU7x), dan transformer difusi (FLUX.1). Untuk pasca-pelatihan RL (seperti pengoptimalan kebijakan relatif grup, atau GRPO), VeRL (Pratinjau) mendelegasikan pembaruan parameter ke TorchTitan. Kemudian, model ini mengirimkan bobot yang diperbarui ke mesin inferensi untuk menghasilkan lintasan pelatihan (peluncuran).
- Setelan compiler dan paralelisme yang telah dikonfigurasi sebelumnya: konfigurasi resep mencakup setelan compiler dan paralelisme yang telah dikonfigurasi sebelumnya sehingga Anda dapat menyesuaikan pemanfaatan FLOP model (MFU) melalui file konfigurasi, bukan perubahan kode.
- Orientasi untuk arsitektur baru: backend pemodelan Hugging Face Transformers menjalankan checkpoint model Hugging Face Hub (termasuk model MoE tanpa paralelisme pakar) melalui pelatih TorchTitan. Untuk port model lengkap, TorchTitan menyertakan keterampilan orientasi langkah demi langkah untuk engineer dan agen coding.
- Penggunaan kembali komponen mandiri: Anda dapat mengadopsi TorchTitan secara menyeluruh atau mengimpor modul individual, operator kustom, dan flag compiler ke codebase pelatihan yang ada.
Untuk mengetahui informasi selengkapnya, lihat panduan memulai TorchTitan di TPU dan resep pelatihan TorchTitan Qwen3-8B untuk TPU7x, ajukan pertanyaan di forum diskusi TorchTitan, atau laporkan masalah di Issue Tracker TorchTitan.
TorchRec: Sistem rekomendasi
TorchRec adalah library domain PyTorch yang menyediakan tabel embedding terdistribusi dan primitif sharding untuk model rekomendasi. Di Cloud TPU, TorchRec memindahkan pencarian tabel embedding sparse ke prosesor TPU SparseCore khusus sambil menjalankan operasi matriks dense di TPU TensorCore.
Untuk mengetahui informasi selengkapnya tentang TorchRec, lihat dokumentasi TorchRec, ajukan pertanyaan di forum diskusi PyTorch di TPU, atau laporkan masalah di Issue tracker TorchRec.
Alat developer dan orkestrasi cluster
Untuk menskalakan pipeline multi-node dan mengotomatiskan orientasi model, ekosistem TorchTPU terintegrasi dengan Ray dan menyediakan ekstensi agen coding dengan akses ke dokumentasi TPU.
Ray: Pelatihan, inferensi, dan RL terdistribusi
Ray menskalakan workload Python dan AI di seluruh cluster menggunakan Ray Train, Ray Serve, [Ray Data](https://docs.ray.io/en/latest/ray-core/walkthrough.html, Ray Core, dan framework RL seperti VeRL (Pratinjau).
Untuk mengetahui informasi selengkapnya, lihat Mengumumkan Ray di Google Cloud.
Motivasi
Pelatihan multislice dan pipeline multi-level (seperti alur kerja RL yang menggabungkan prapemrosesan data, pelatihan, dan pembuatan peluncuran) memerlukan penyediaan slice otomatis, penemuan topologi, dan koordinasi worker yang fault-tolerant. Utilitas peluncuran mandiri seperti torchrun tidak menyediakan slice TPU atau mengoordinasikan pipeline aktor multi-level, sehingga Ray mengelola penjadwalan dan penempatan di seluruh cluster untuk workload TorchTPU.
Desain
Saat Anda mengirimkan tugas yang menentukan pembuatan, topologi, dan jumlah worker TPU,
Ray akan mencadangkan slice TPU lengkap sehingga semua worker dalam slice dijadwalkan
bersama. Ray kemudian menemukan alamat interkoneksi chip dan memulai satu worker PyTorch per perangkat TPU. Backend PyTorch Ray Train menginisialisasi perangkat tpu
dan grup proses tpu_dist secara otomatis sebelum memulai tugas.
Kekuatan utama
- Penempatan yang sesuai topologi: mencocokkan penempatan worker di seluruh host dengan generasi TPU fisik dan tata letak slice.
- Pemulihan kegagalan otomatis: menjalankan tugas pelatihan terdistribusi di beberapa slice TPU di GKE dengan pemulihan otomatis saat worker atau slice gagal.
- Pengambilan data langsung ke TPU: Metode
iter_torch_batchesRay Data mengambil batch sebagai tensor PyTorch langsung ke memori perangkat TPU. - Orkestrasi inferensi multi-host: mengelola deployment inferensi multi-host untuk vLLM-TorchTPU dan SGLang-TorchTPU.
TPU agent suite: Agen coding untuk TPU (Pratinjau)
TPU agent suite adalah ekstensi open source untuk bantuan coding—termasuk Claude Code dan Google Antigravity—yang berfokus pada inferensi transformer (LLM padat dan model MoE) di TPU v6e dan TPU7x.
Untuk mengetahui informasi selengkapnya, tonton ringkasan TPU agent suite open source:
Motivasi
Asisten coding tujuan umum sering kali tidak memiliki konteks terkini tentang topologi hardware TPU, flag compiler XLA, telemetri XProf, dan batasan kernel Pallas. TPU agent suite memberi asisten Anda akses ke dokumentasi TPU resmi dan alur kerja terstruktur. Hal ini membantu mencegah saran flag yang tidak valid dan mengotomatiskan pembuatan profil dan tolok ukur iteratif.
Desain
Suite ini menambahkan pusat informasi TPU dan empat sub-agen khusus tugas ke
asisten coding yang sudah ada. Agen pengarah (tpu-agent) mendelegasikan setiap perintah
ke sub-agen yang sesuai tanpa menjalankan perintah itu sendiri. Setiap eksekusi perintah
pada VM TPU atau cluster GKE Anda memerlukan persetujuan Anda,
dan loop penyesuaian menjalankan sejumlah upaya yang tercatat sebelum menampilkan
hasil.
Kekuatan utama
- Orientasi model dan verifikasi akurasi: agen
tpu-model-onboardingmenyelesaikan operator yang tidak didukung dan memilih jalur inferensi (vLLM-TorchTPU atau PyTorch standar). Model ini juga membandingkan output lapisan demi lapisan dengan model referensi CPU untuk memverifikasi akurasi numerik. - Diagnostik error dan bottleneck: agen
tpu-diagnosticsmenganalisis log error, memeriksa profil XProf dan trace compiler XLA, serta mengisolasi bottleneck runtime. - Pengembangan kernel Pallas kustom: agen
tpu-kernel-developmentmembantu menulis dan menyesuaikan otomatis kernel TPU Pallas kustom dalam anggaran iterasi yang terbatas. - Pencarian dokumentasi dengan kutipan: agen
tpu-knowledge-basemenjawab pertanyaan teknis dengan kutipan eksplisit ke dokumentasi dan tutorial TPU resmi, serta menyatakan jika suatu topik tidak dibahas.
Untuk mengetahui informasi selengkapnya, lihat dokumentasi TPU agent suite, bagikan masukan dan ajukan pertanyaan di Diskusi GitHub TPU agent suite, atau laporkan masalah di Issue tracker TPU agent suite.
Langkah berikutnya
- Mulai menggunakan dokumentasi TorchTPU.
- Coba resep TorchTitan di TPU.
- Men-deploy workload inferensi dengan vLLM-TorchTPU dan SGLang-TorchTPU.
- Ajukan pertanyaan di forum diskusi PyTorch di TPU.
- Untuk mendiskusikan kasus penggunaan tertentu dengan tim produk dan engineering Google, kirim email ke torchtpu-feedback@google.com.