


PyTorch su Cloud TPU
PyTorch su Cloud TPU ti consente di addestrare, ottimizzare e gestire modelli open source su hardware Cloud TPU utilizzando la semantica PyTorch standard, le API distribuite e gli strumenti dell'ecosistema che già utilizzi, tra cui Hugging Face, vLLM, SGLang, llm-d, TorchTitan, TorchRec e Ray.
Alla base dello stack c'è TorchTPU, un backend open source nativo di PyTorch sviluppato in collaborazione con il team di PyTorch di Meta. TorchTPU fornisce librerie, framework e strumenti per ogni fase del ciclo di vita del machine learning, dall'esecuzione del runtime di base e dei kernel personalizzati all'inferenza di produzione, all'addestramento su larga scala e all'orchestrazione dei cluster.
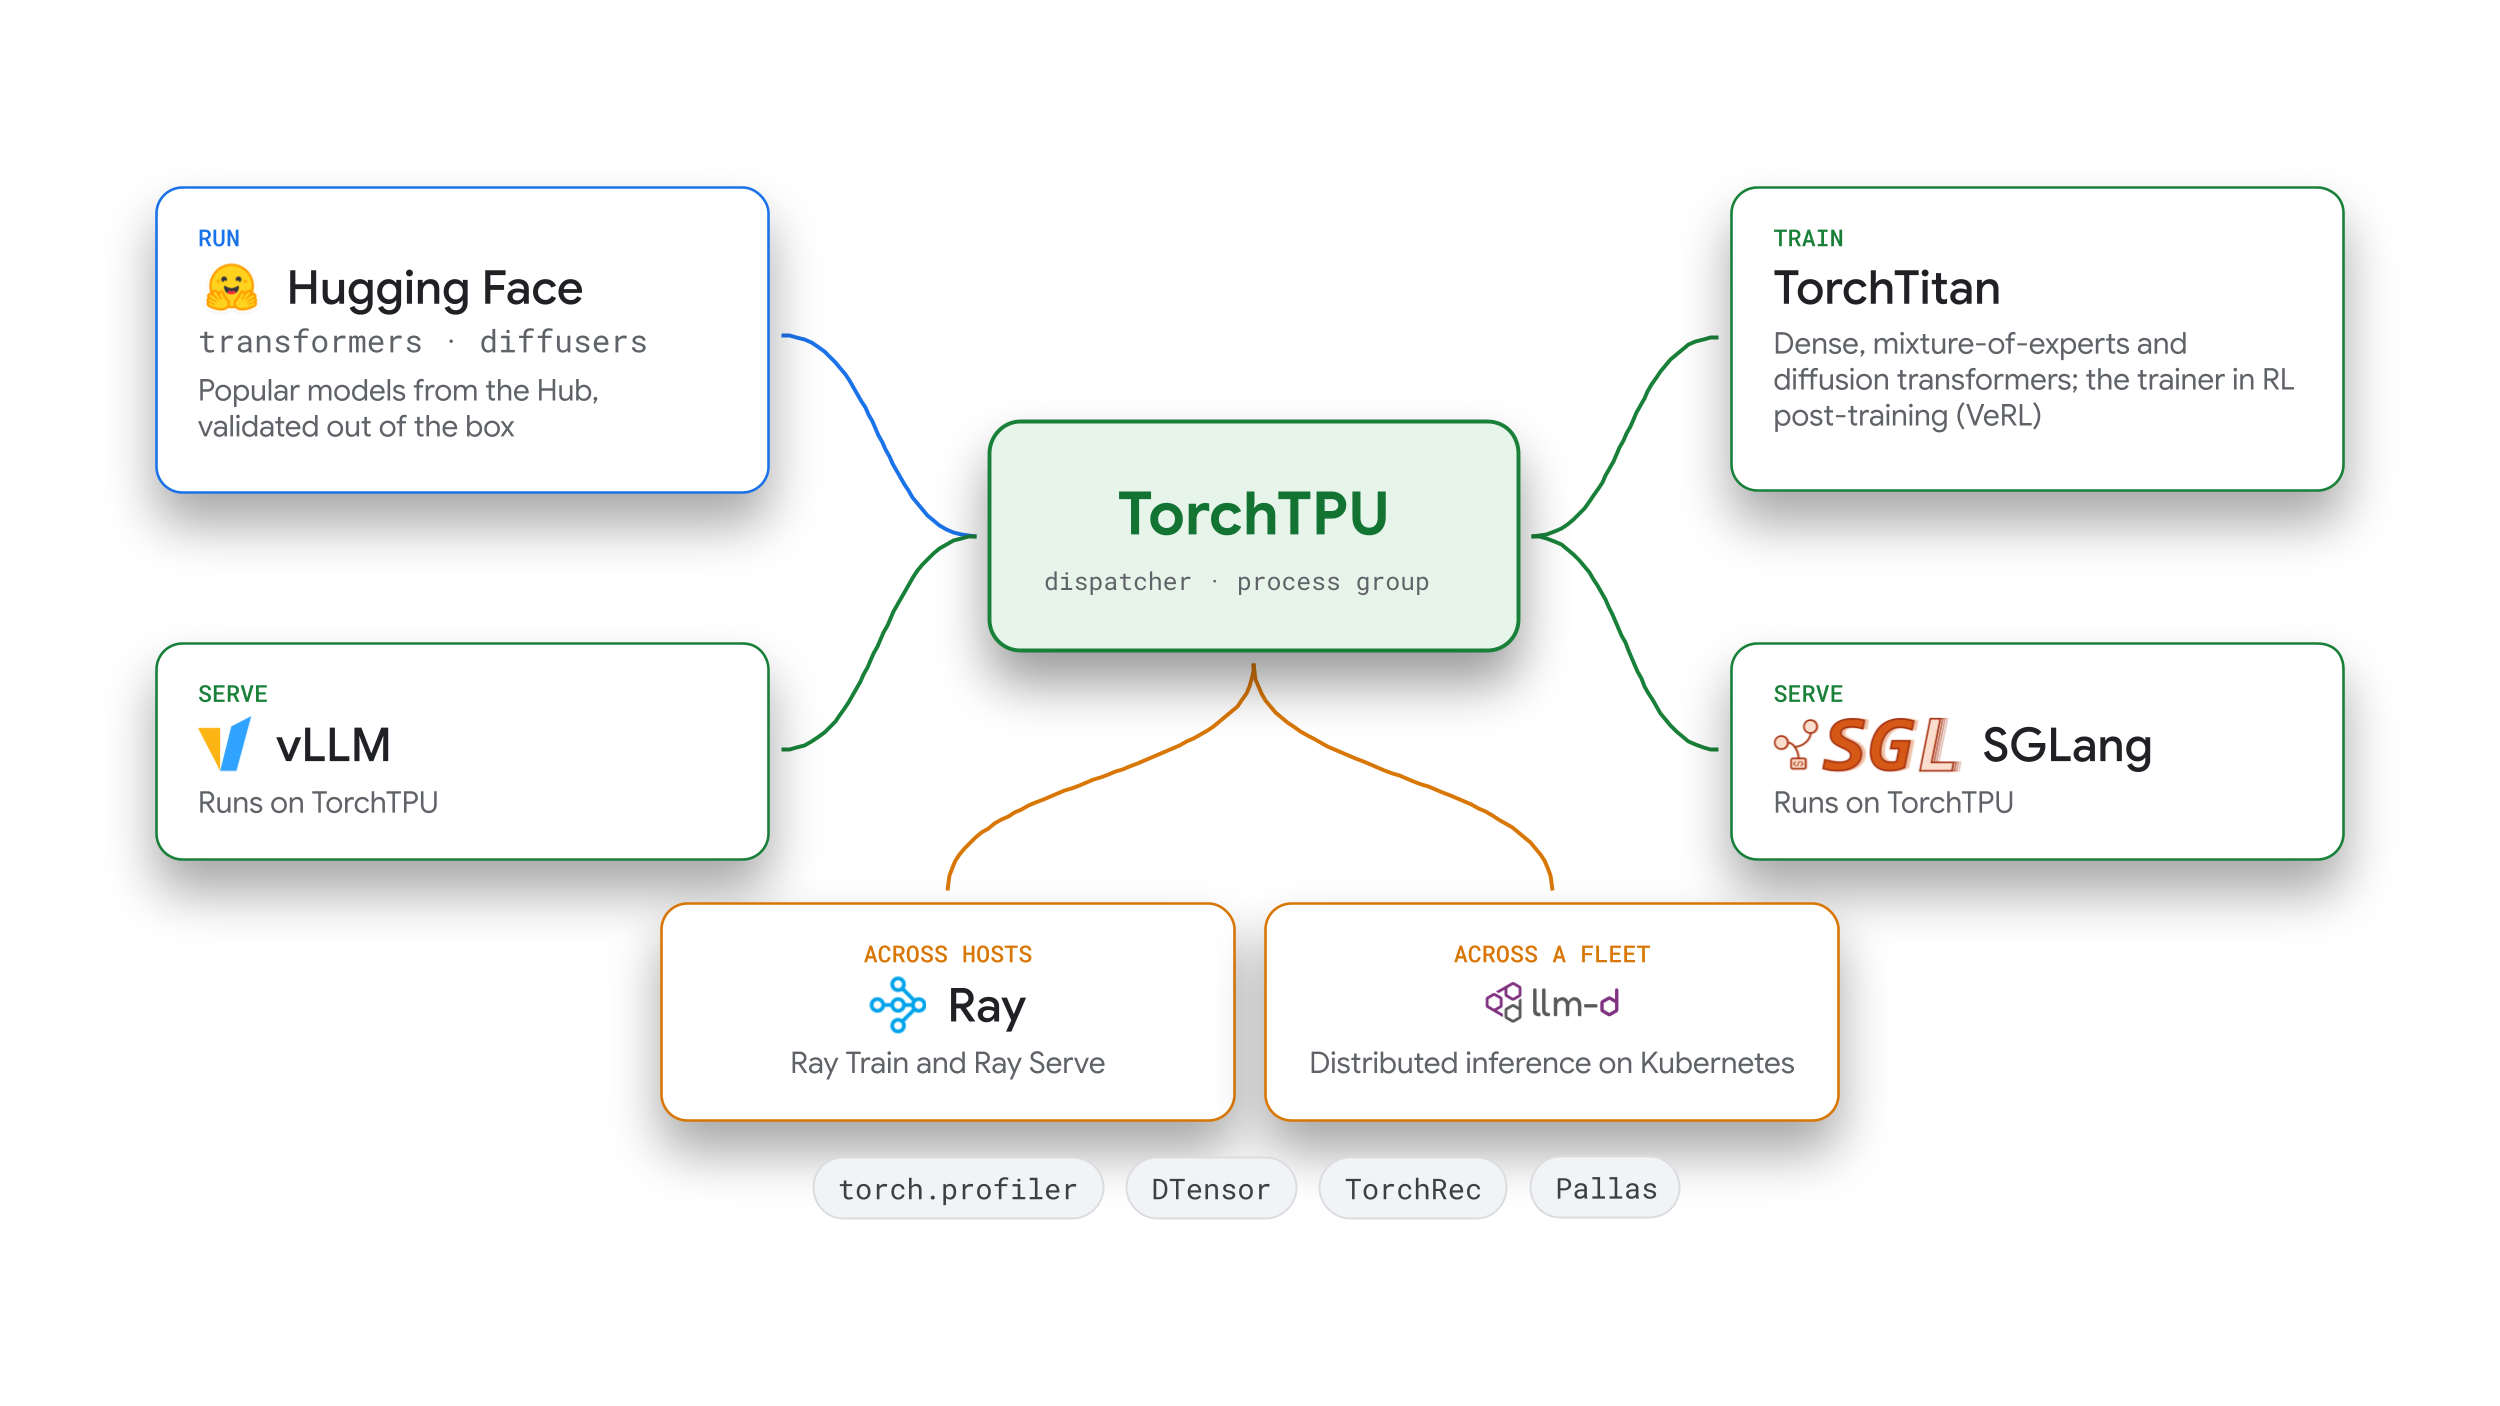
Inizia
- Esegui modelli PyTorch su TPU: inizia con TorchTPU e la documentazione di TorchTPU.
- Eroga LLM e modelli multimodali: utilizza vLLM-TorchTPU o SGLang-TorchTPU.
- Instradare le richieste in un parco risorse Kubernetes: utilizza llm-d.
- Pre-addestra o ottimizza i foundation model: utilizza TorchTitan su TPU (o TorchRec per i modelli di suggerimenti).
- Scala le pipeline di trattamento dati, addestramento, RL e distribuzione: utilizza Ray.
- Esegui l'onboarding, la profilazione e l'ottimizzazione dei modelli con l'assistente al coding: utilizza la suite di agenti TPU (anteprima).
TorchTPU: backend nativo di PyTorch per Cloud TPU
TorchTPU fornisce il backend del dispositivo, l'integrazione del compilatore di grafici e le API del kernel personalizzate per PyTorch su Cloud TPU. Sviluppato con il team di PyTorch, TorchTPU ti consente di eseguire il debug dei modelli in modo interattivo in modalità eager, compilare il codice del modello con torch.compile e scalare tra le sezioni con torch.distributed (tpu_dist).
Per installare TorchTPU ed eseguire un'operazione del tensore su una Cloud TPU:
pip install torch_tpu
import torch

device = torch.device("tpu")

x = torch.randn((4, 4), device=device)
y = torch.ones((4, 4), device=device)
result = torch.matmul(x, y).cpu()

print(f"Executed on device: {x.device}")
print(f"Result shape on CPU: {result.shape}, sum: {result.sum():.4f}")
Motivazione
Sebbene le Cloud TPU siano state storicamente associate a JAX e TensorFlow, l'esecuzione di PyTorch sulle TPU richiedeva in precedenza la registrazione di grafici lazy-tensor (PyTorch/XLA), il che spesso significava aggiungere codice per contrassegnare le regioni compilabili. TorchTPU esegue le operazioni in modalità eager per impostazione predefinita utilizzando il modello di esecuzione standard di PyTorch, ovvero un processo per dispositivo, in modo che i workload e le librerie esistenti vengano eseguiti senza riscritture strutturali.
Design
TorchTPU offre il supporto di TPU nativo di PyTorch a PyTorch con tre obiettivi di progettazione:
- Semantica PyTorch standard: esegue un processo per dispositivo e conserva le visualizzazioni dei tensori PyTorch e le mutazioni in loco senza una dipendenza dal runtime JAX.
- Esecuzione eager per impostazione predefinita: i modelli PyTorch standard vengono eseguiti immediatamente in modalità eager per il debug interattivo e l'ispezione passo passo.
- Ottimizzazioni del compilatore e del kernel: oltre all'esecuzione eager operatore per operatore, TorchTPU fornisce la fusione degli operatori in modalità eager, l'integrazione di
torch.compilecon limiti di forma dinamici per ridurre le ricompilazioni e le API del kernel personalizzate.
Per la compilazione del grafico, torch.compile acquisisce il grafico di calcolo PyTorch con TorchDynamo e lo compila in codice macchina TPU tramite OpenXLA e StableHLO. Le operazioni collettive vengono eseguite a livello di gruppo di processi torch.distributed (tpu_dist).
Punti di forza principali
- Supporto di operatori, modelli e Hugging Face: TorchTPU supporta gli operatori PyTorch (ATen) standard nei passaggi in avanti e indietro ed è continuamente testato con i modelli Hugging Face più diffusi. Puoi eseguire il deployment dei modelli in Transformers v5 passando
device_map="tpu", eseguire pipeline Diffusers con la modalità eager,torch.compilee il parallelismo dei tensori e profilare i workload contorch.profilerin TensorBoard e XProf. - Scalabilità da singolo chip a più slice: il backend
tpu_distsupportaDistributedDataParallel(DDP),FullyShardedDataParallel(FSDP2) eDTensor. Inoltre,torch.tpu.distributed.topology_aware_meshmappa le dimensioni del parallelismo sulle interconnessioni TPU fisiche. - Modalità di esecuzione eager configurabili: offre tre modalità di esecuzione eager:
Strict(predefinito): invia gli operatori singolarmente e in modo asincrono, con la semantica PyTorch imperativa standard.Debug: viene eseguito in modo sincrono con il controllo dei limiti del tensore.DeferAndFuse: unisce sequenze di operatori eager per ridurre il traffico della memoria ad alta larghezza di banda (HBM).
- Compilazione e memorizzazione nella cache di grafi completi:
torch.compile(backend="tpu")compila i grafi in eseguibili TPU e li memorizza nella cache tra processi, host e riavvii dei job. - Kernel TPU personalizzati: puoi chiamare kernel Pallas personalizzati, inclusi i kernel che comunicano direttamente tra i chip, come funzioni PyTorch standard, utilizzare kernel predefiniti della libreria Tokamax o creare kernel portatili basati su tile con Helion.
Per saperne di più, consulta la documentazione di TorchTPU, fai domande nel forum di discussione di PyTorch su TPU o segnala problemi su GitHub.
Inferenza ed erogazione in produzione
Per il deployment in produzione, PyTorch su Cloud TPU si integra con motori di inferenza open source e infrastruttura di distribuzione distribuita nativa di Kubernetes.
vLLM-TorchTPU e SGLang-TorchTPU: motori di inferenza
vLLM-TorchTPU e SGLang-TorchTPU sono backend TorchTPU per i motori di inferenza vLLM e SGLang. Entrambi i backend eseguono modelli aperti come Qwen, DeepSeek, GLM, Kimi, GPT-OSS e Gemma 4. Per maggiori informazioni, leggi il blog post Annuncio dei nuovi motori di inferenza vLLM e SGLang su TPU.
Motivazione
La gestione di workload di ragionamento, multimodali e che utilizzano strumenti spesso richiede definizioni di modelli personalizzati, metodi di decodifica speculativa e schemi di quantizzazione. La creazione dei backend vLLM e SGLang su TorchTPU ti consente di personalizzare ed eseguire il debug dello stack di distribuzione direttamente in PyTorch.
Design
Entrambi i backend mantengono gli scheduler vLLM e SGLang standard, i gestori della cache KV e i server API, utilizzando l'esecuzione TorchTPU e gli operatori Pallas personalizzati sottostanti. La maggior parte dei modelli esegue le definizioni dei modelli PyTorch standard, mentre i blocchi ad alta intensità di calcolo richiamano i kernel Pallas all'interno del grafico compilato, in modo che i kernel specifici dell'hardware possano essere aggiornati in modo indipendente.
Punti di forza principali
- Parallelismo, quantizzazione e decodifica speculativa: supporta il parallelismo di tensori, dati, esperti, pipeline e contesto tra host, oltre a input multimodali (immagini e video) e di embedding. I metodi di decodifica speculativa supportati includono la previsione multi-token (MTP), EAGLE-3, DFlash, DSpark e la corrispondenza n-gram. I formati di quantizzazione supportati includono cache KV a 8 bit (
FP8) e checkpoint dei modelli con rappresentazione in virgola mobile a 8 bit (FP8) e 4 bit (MXFP4eNVFP4). - Caching dei prefissi a due livelli, chiamate di strumenti e output strutturato: il caching automatico dei prefissi (anche per l'attenzione ibrida e i modelli ricorrenti) conserva i prefissi attivi nell'HBM e scarica i prefissi meno recenti nella memoria host per evitare il ricalcolo delle richieste multi-turn. La chiamata degli strumenti e l'output strutturato sono integrati.
- Trasferimenti di cache KV sovrapposti con TPU Sync: supporta il pre-riempimento e la decodifica disaggregati (separando l'elaborazione dei prompt e la generazione di token in pool di worker distinti) tra gli host e l'offload KV dell'host utilizzando TPU Sync. TPU Sync è una libreria C++ open source che legge i buffer dei dispositivi PyTorch direttamente sui thread in background senza copiare i dati tramite la memoria della CPU host.
Per ulteriori informazioni su vLLM-TorchTPU, consulta il repository vLLM-TorchTPU, fai domande nel canale Slack vLLM o segnala problemi di vLLM-TorchTPU su GitHub.
Per saperne di più su SGLang-TorchTPU, consulta il repository SGLang-TorchTPU o segnala i problemi di SGLang-TorchTPU su GitHub.
llm-d: inferenza distribuita nativa di Kubernetes
llm-d è un framework sandbox open source della Cloud Native Computing Foundation (CNCF) per l'inferenza LLM distribuita su Kubernetes, sviluppato con Red Hat, IBM, Google Cloude una community di oltre 500 collaboratori e 35 organizzazioni.
Motivazione
Mentre i motori di inferenza a istanza singola gestiscono l'esecuzione per replica, i parchi risorse di produzione devono gestire i picchi di traffico, le priorità multi-tenant, la condivisione del contesto a livello di parco risorse e i rollout senza tempi di inattività. llm-d fornisce il livello di routing e operazioni a livello di cluster per coordinare un parco risorse di server di inferenza.
Design
llm-d viene eseguito davanti ai server di modelli come vLLM e SGLang su Kubernetes. llm-d fornisce quanto segue:
- Instrada le richieste in base allo stato della cache del prefisso e al carico della replica.
- Coordina i pool di worker di precompilazione e decodifica disaggregati.
- Supporta lo sharding MoE e l'inferenza batch asincrona.
- Gestisce l'offload della cache KV a più livelli tra la memoria del dispositivo, la memoria host e lo spazio di archiviazione.
Punti di forza principali
- Routing delle sessioni multi-turno: instrada le conversazioni multi-turno alle repliche che contengono il contesto memorizzato nella cache. La pianificazione con priorità dei turni e il supporto dell'API Stateful Responses consentono agli agenti di riutilizzare il contesto tra i turni per ridurre il ricalcolo.
- Qualità del servizio multi-tenant: il controllo del flusso di priorità e correttezza consente alle richieste sensibili alla latenza e ai workload degli agenti con burst di condividere un parco risorse senza esaurimento delle risorse.
- Operazioni del parco risorse e aggiornamenti in sequenza: fornisce un'API di configurazione v1, alta affidabilità del router e aggiornamenti in sequenza coordinati che gestiscono le repliche di precompilazione e decodifica come un'unica unità logica.
- Pubblicazione nativa di TorchTPU su GKE: puoi pubblicare Cloud TPU insieme ad altri acceleratori dietro un endpoint llm-d e gestire le repliche vLLM-TorchTPU e SGLang-TorchTPU con gli strumenti standard di Kubernetes.
Per saperne di più, fai domande nel canale Slack llm-d o segnala problemi su GitHub.
Librerie di addestramento, ottimizzazione e dominio
Per preaddestrare, ottimizzare e adattare modelli di grandi dimensioni, TorchTPU fornisce ricette di addestramento di riferimento e librerie specifiche per il dominio ottimizzate per l'hardware TPU.
TorchTitan su TPU: riferimento per l'addestramento su larga scala
TorchTitan su TPU estende TorchTitan, la piattaforma di riferimento modulare PyTorch per l'addestramento dell'AI generativa, con passaggi di sharding TPU, kernel personalizzati e ricette di addestramento. Per saperne di più, leggi il blog post Integrazione di TorchTPU in TorchTitan e ottimizzazione dei modelli per TPU.
Motivazione
La scalabilità dell'addestramento su sezioni TPU multi-host richiede lo sharding dei parametri tra l'interconnessione dei chip e la sovrapposizione della comunicazione con il calcolo. Google e Meta hanno sviluppato insieme le fasi di compilazione e sharding delle TPU all'interno di TorchTitan, quindi non è necessario progettare strategie di sharding delle TPU personalizzate o pianificare manualmente la comunicazione.
Design
I modelli sono scritti in PyTorch per un singolo dispositivo senza codice specifico per l'acceleratore. TorchTitan configura i livelli del modello dai file di configurazione, consentendoti di sostituire i singoli livelli con kernel Pallas personalizzati (come Splash Attention) senza modificare la definizione del modello o il ciclo di addestramento.
L'implementazione di SimpleFSDP di TorchTitan posiziona le operazioni di sharding dei parametri direttamente all'interno del grafico compilato, in modo che il compilatore XLA possa sovrapporre la comunicazione del dispositivo con il calcolo, mentre la compilazione del grafico in un unico passaggio acquisisce l'intero passaggio di addestramento come un singolo programma XLA. Per le esecuzioni multislice, lo sharding ibrido (HSDP) esegue lo sharding all'interno di ogni slice tramite l'interconnessione tra chip (ICI) e la replica tra slice tramite la rete di data center (DCN). Questo layout limita il traffico tra sezioni a una singola riduzione del gradiente per passaggio.
Punti di forza principali
- Ricette di pre-addestramento e post-addestramento RL: include ricette di riferimento per LLM densi (Llama 3, Qwen 3 e MuseGlimmer 30B), modelli Mixture of Experts (MoE) (Qwen 3 235B, convalidato su un massimo di 8192 chip TPU7x) e trasformatori di diffusione (FLUX.1). Per il post-addestramento RL (come Group Relative Policy Optimization o GRPO), VeRL (anteprima) delega gli aggiornamenti dei parametri a TorchTitan e invia i pesi aggiornati ai motori di distribuzione per generare traiettorie di addestramento (rollout).
- Impostazioni preconfigurate del compilatore e del parallelismo: le configurazioni delle formule includono impostazioni preconfigurate del compilatore e del parallelismo, in modo da poter ottimizzare l'utilizzo dei FLOP del modello (MFU) tramite file di configurazione anziché modifiche al codice.
- Onboarding per nuove architetture: il backend di modellazione Hugging Face Transformers esegue i checkpoint dei modelli Hugging Face Hub (inclusi i modelli MoE senza parallelismo degli esperti) tramite l'addestratore TorchTitan. Per i porting completi dei modelli, TorchTitan include una competenza di onboarding passo passo per ingegneri e agenti di programmazione.
- Riutilizzo dei componenti autonomi: puoi adottare TorchTitan end-to-end o importare singoli moduli, operatori personalizzati e flag del compilatore in un codebase di addestramento esistente.
Per saperne di più, consulta la guida introduttiva a TorchTitan su TPU, fai domande nel forum di discussione di PyTorch o segnala problemi su GitHub.
TorchRec: sistemi di suggerimenti
TorchRec è una libreria di dominio PyTorch che fornisce tabelle di embedding distribuite e primitive di sharding per i modelli di suggerimento. Su Cloud TPU, TorchRec esegue l'offload delle ricerche di tabelle di incorporamento sparse su processori TPU SparseCore dedicati, mentre esegue operazioni di matrici dense sui TPU TensorCore.
Per saperne di più su TorchRec, consulta la documentazione di TorchRec, fai domande nel forum di discussione di PyTorch su TPU o segnala problemi su GitHub.
Orchestrazione dei cluster e strumenti per sviluppatori
Per scalare le pipeline multi-nodo e automatizzare l'onboarding dei modelli, l'ecosistema TorchTPU si integra con Ray e fornisce estensioni degli agenti di programmazione con accesso alla documentazione delle TPU.
Ray: addestramento, distribuzione e RL distribuiti
Ray scala i workload Python e AI tra i cluster utilizzando Ray Train, Ray Serve, Ray Data, Ray Core e framework RL come verl.
Motivazione
L'addestramento multislice e le pipeline multifase (come i workflow RL che combinano pre-elaborazione dei dati, addestramento e generazione di rollout) richiedono il provisioning automatico degli slice, il rilevamento della topologia e il coordinamento dei worker con tolleranza di errore. Le utilità di avvio autonome come torchrun non eseguono il provisioning delle sezioni TPU o il coordinamento delle pipeline di attori multifase, quindi Ray gestisce la pianificazione e il posizionamento a livello di cluster per i workload TorchTPU.
Design
Quando invii un job specificando la generazione, la topologia e il numero di worker della TPU, Ray prenota sezioni TPU complete in modo che tutti i worker di una sezione vengano pianificati insieme, individua gli indirizzi di interconnessione dei chip e avvia un worker PyTorch per dispositivo TPU. Il backend PyTorch di Ray Train inizializza automaticamente il dispositivo tpu
e il gruppo di processi tpu_dist prima di avviare il job.
Punti di forza principali
- Posizionamento con corrispondenza della topologia: abbina il posizionamento dei worker tra gli host alla generazione di TPU fisica e al layout della sezione.
- Ripristino automatico in caso di errore: esegue job di addestramento distribuiti su più sezioni TPU su GKE con ripristino automatico in caso di errore di un worker o di una sezione.
- Prefetch dei dati direttamente sulla TPU: il metodo
iter_torch_batchesdi Ray Data esegue il prefetch dei batch come tensori PyTorch direttamente nella memoria del dispositivo TPU. - Orchestrazione dell'inferenza multi-host: gestisce i deployment di gestione multi-host per vLLM-TorchTPU e SGLang-TorchTPU.
TPU agent suite: (anteprima) agenti di programmazione per TPU
La TPU agent suite è un'estensione open source per l'assistenza al coding, tra cui Claude Code e Google Antigravity, con altri agenti di programmazione in arrivo, incentrata sull'inferenza dei transformer (LLM densi e modelli MoE) su TPU v6e e TPU7x.
Motivazione
Gli assistenti al coding per uso generico spesso non dispongono di un contesto aggiornato sulle topologie hardware delle TPU, sui flag del compilatore XLA, sulla telemetria XProf e sui vincoli del kernel Pallas. La TPU agent suite consente all'assistente di accedere alla documentazione ufficiale di TPU e ai workflow strutturati. In questo modo, si evitano suggerimenti di flag non validi e si automatizzano la profilazione e il benchmarking iterativi.
Design
La suite aggiunge una knowledge base sulle TPU e sei sub-agenti specifici per le attività al tuo assistente al coding esistente. Un agente di routing delega ogni prompt al sub-agente appropriato senza eseguire comandi autonomamente. Qualsiasi esecuzione di comando sulla tua VM TPU o sul tuo cluster GKE richiede la tua approvazione e i loop di ottimizzazione eseguono un numero limitato di tentativi registrati prima di restituire i risultati.
Punti di forza principali
- Onboarding del modello e verifica dell'accuratezza: l'agente TPU Model Onboarding risolve gli operatori non supportati, seleziona un percorso di distribuzione (vLLM-TorchTPU o PyTorch standard) e confronta gli output strato per strato con il modello di riferimento della CPU per verificare l'accuratezza numerica.
- Diagnostica di arresti anomali e colli di bottiglia: l'agente TPU Diagnostics analizza i log degli arresti anomali, ispeziona i profili XProf e le tracce del compilatore XLA e isola i colli di bottiglia del runtime.
- Ottimizzazione di kernel, compilatore e sharding: l'agente TPU Kernel Development aiuta con i kernel Pallas personalizzati, l'agente TPU Performance Optimization esegue il benchmark delle combinazioni di flag del compilatore XLA e l'agente TPU Sharding pianifica i layout di parallelismo multislice.
- Ricerca nella documentazione con citazioni: l'agente della knowledge base di TPU risponde alle domande tecniche con citazioni esplicite alla documentazione e ai tutorial ufficiali di TPU e indica quando un argomento non è trattato.
Per saperne di più, consulta la documentazione di TPU agent suite, condividi feedback e fai domande in GitHub Discussions o segnala problemi su GitHub.
Passaggi successivi
- Inizia a utilizzare la documentazione di TorchTPU.
- Prova le ricette di TorchTitan su TPU.
- Esegui il deployment dei workload di inferenza con vLLM-TorchTPU e SGLang-TorchTPU.
- Fai domande nel forum di discussione di PyTorch su TPU.
- Per discutere di un caso d'uso specifico con il team di progettazione e di prodotto di Google, invia un'email all'indirizzo torchtpu-feedback@google.com.