


Membangun AI produksi di Cloud TPU dengan JAX
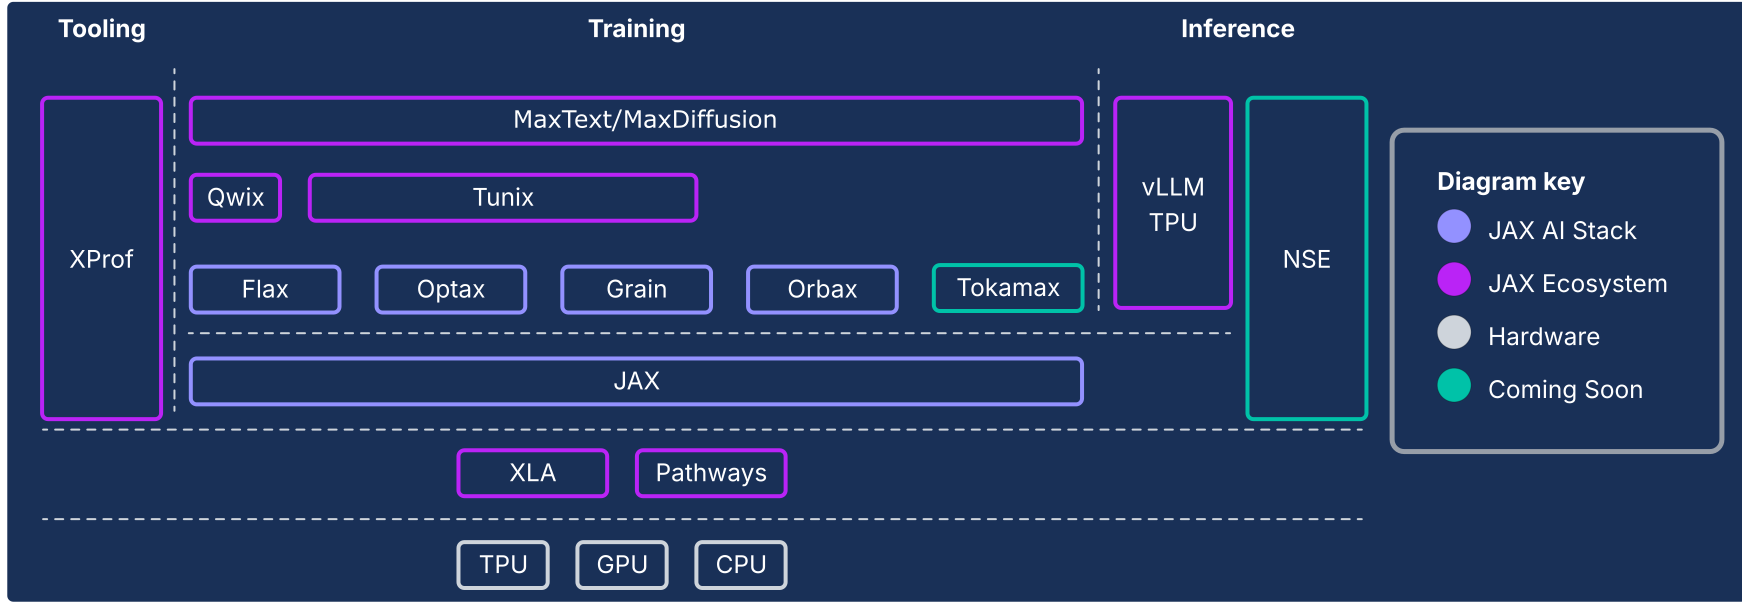
JAX AI stack memperluas inti numerik JAX dengan koleksi library composable yang didukung Google, sehingga mengembangkannya menjadi platform open source end-to-end yang tangguh untuk Machine Learning dalam skala ekstrem. Oleh karena itu, stack AI JAX terdiri dari ekosistem yang komprehensif dan tangguh yang menangani seluruh siklus proses ML:
Fondasi skala industri: JAX AI Stack dirancang untuk skala besar, memanfaatkan ML Pathways untuk mengatur pelatihan di puluhan ribu chip dan Orbax untuk checkpointing asinkron yang tangguh dan memiliki throughput tinggi, sehingga memungkinkan pelatihan model canggih tingkat produksi.
Toolkit lengkap dan siap produksi: JAX AI stack menyediakan serangkaian library yang komprehensif untuk seluruh proses pengembangan: Flax untuk penulisan model yang fleksibel, Optax untuk strategi pengoptimalan yang dapat dikomposisi, dan Grain untuk pipeline data deterministik yang penting untuk eksekusi skala besar yang dapat direproduksi.
Performa khusus yang maksimal: Untuk mencapai pemanfaatan hardware maksimum, stack AI JAX menawarkan library khusus termasuk Tokamax untuk kernel kustom yang canggih, Qwix untuk kuantisasi non-intrusif yang meningkatkan kecepatan pelatihan dan inferensi, serta XProf untuk pembuatan profil performa yang mendalam dan terintegrasi dengan hardware.
Jalur lengkap ke produksi: JAX AI Stack menyediakan transisi yang lancar dari riset ke deployment. Hal ini mencakup MaxText sebagai referensi yang skalabel untuk pelatihan model dasar, Tunix untuk reinforcement learning (RL) dan penyelarasan yang canggih, serta solusi inferensi terpadu dengan vLLM-JAX dan runtime inferensi JAX.
Filosofi stack JAX AI adalah salah satu komponen yang digabungkan secara longgar, yang masing-masing melakukan satu hal dengan baik. Alih-alih menjadi framework ML monolitik, JAX sendiri memiliki cakupan yang sempit dan berfokus pada operasi array dan transformasi program yang efisien. Ekosistem ini dibangun di atas framework inti ini untuk menyediakan berbagai fungsi, yang terkait dengan pelatihan model ML dan jenis workload lainnya seperti komputasi ilmiah.
Sistem komponen yang digabungkan secara longgar ini memungkinkan Anda memilih dan menggabungkan library dengan cara terbaik untuk memenuhi kebutuhan Anda. Dari perspektif rekayasa software, arsitektur ini juga memungkinkan Anda memperbarui fungsionalitas yang secara tradisional dianggap sebagai komponen framework inti (misalnya, pipeline data dan checkpointing) secara iteratif tanpa risiko mengganggu stabilitas framework inti atau terjebak dalam siklus rilis. Mengingat sebagian besar fungsi diimplementasikan dalam library, bukan perubahan pada framework monolitik, hal ini membuat library numerik inti lebih tahan lama dan dapat beradaptasi dengan perubahan lanskap teknologi di masa mendatang.
Bagian berikut memberikan ringkasan teknis tentang JAX AI Stack, fitur utamanya, keputusan desain di baliknya, dan cara fitur tersebut digabungkan untuk membangun platform yang tahan lama untuk workload ML modern.
Stack AI JAX dan komponen ekosistem lainnya
| Komponen | Fungsi / Deskripsi |
|---|---|
| Komponen dan inti stack JAX AI1 | |
| JAX | Komputasi array dan transformasi program yang berorientasi pada akselerator (JIT, grad, vmap, pmap). |
| Flax | Library penulisan jaringan neural yang fleksibel untuk pembuatan dan modifikasi model yang intuitif. |
| Optax | Library transformasi pengoptimalan dan pemrosesan gradien yang dapat dikomposisi. |
| Orbax | Library checkpointing terdistribusi "skala apa pun" untuk ketahanan pelatihan skala besar. |
| Grain | Library pipeline data input yang skalabel, deterministik, dan dapat di-checkpoint. |
| JAX AI stack - Infrastruktur | |
| XLA | Compiler machine learning open source untuk TPU, CPU, dan GPU. |
| Pathways | Runtime terdistribusi untuk mengorkestrasi komputasi di puluhan ribu chip. |
| JAX AI stack - Adv. Pengembangan | |
| Pallas | Ekstensi JAX untuk menulis kernel kustom berperforma tinggi dan level rendah yang diimplementasikan di Python. |
| Tokamax | Library pilihan yang berisi kernel kustom canggih dan berperforma tinggi (misalnya, Attention). |
| Qwix | Library yang komprehensif dan tidak mengganggu untuk kuantisasi (PTQ, QAT, QLoRA). |
| JAX AI stack - Aplikasi | |
| MaxText / MaxDiffusion | Framework referensi unggulan yang skalabel untuk melatih model dasar (misalnya, LLM dan Diffusion). |
| Tunix | Framework untuk pasca-pelatihan dan penyelarasan yang canggih (RLHF, DPO). |
| vLLM-JAX | Solusi inferensi LLM berperforma tinggi menggunakan integrasi bawaan framework vLLM. |
| XProf | Profiler mendalam yang terintegrasi dengan hardware untuk analisis performa di seluruh sistem. |
1Disertakan dalam paket Python jax-ai-stack.
Gambar 1: Stack JAX AI dan komponen ekosistem
Kebutuhan arsitektur: performa di luar framework
Seiring dengan konvergensi arsitektur model — misalnya, pada Transformer Mixture-of-Experts (MoE) multimodal — upaya untuk mencapai performa puncak mengarah pada kemunculan Megakernel. Megakernel secara efektif merupakan seluruh penerusan maju (atau sebagian besar) dari satu model tertentu, yang dikodekan secara manual menggunakan API tingkat rendah seperti CUDA SDK pada GPU NVIDIA. Pendekatan ini mencapai pemanfaatan hardware maksimum dengan secara agresif menumpang tindih komputasi, memori, dan komunikasi. Pekerjaan terbaru dari komunitas riset telah menunjukkan bahwa pendekatan ini dapat menghasilkan peningkatan throughput yang signifikan, lebih dari 22% dalam beberapa kasus, untuk inferensi pada GPU. Tren ini tidak terbatas pada inferensi; bukti menunjukkan bahwa beberapa upaya pelatihan berskala besar telah melibatkan kontrol hardware tingkat rendah untuk mencapai peningkatan efisiensi yang substansial.
Jika tren ini meningkat, semua framework tingkat tinggi yang ada saat ini berisiko menjadi kurang relevan, karena akses tingkat rendah ke hardware adalah hal yang pada akhirnya penting untuk performa pada arsitektur yang matang dan stabil. Hal ini menjadi tantangan bagi semua stack ML modern: cara memberikan kontrol hardware tingkat pakar tanpa mengorbankan produktivitas dan fleksibilitas framework tingkat tinggi.
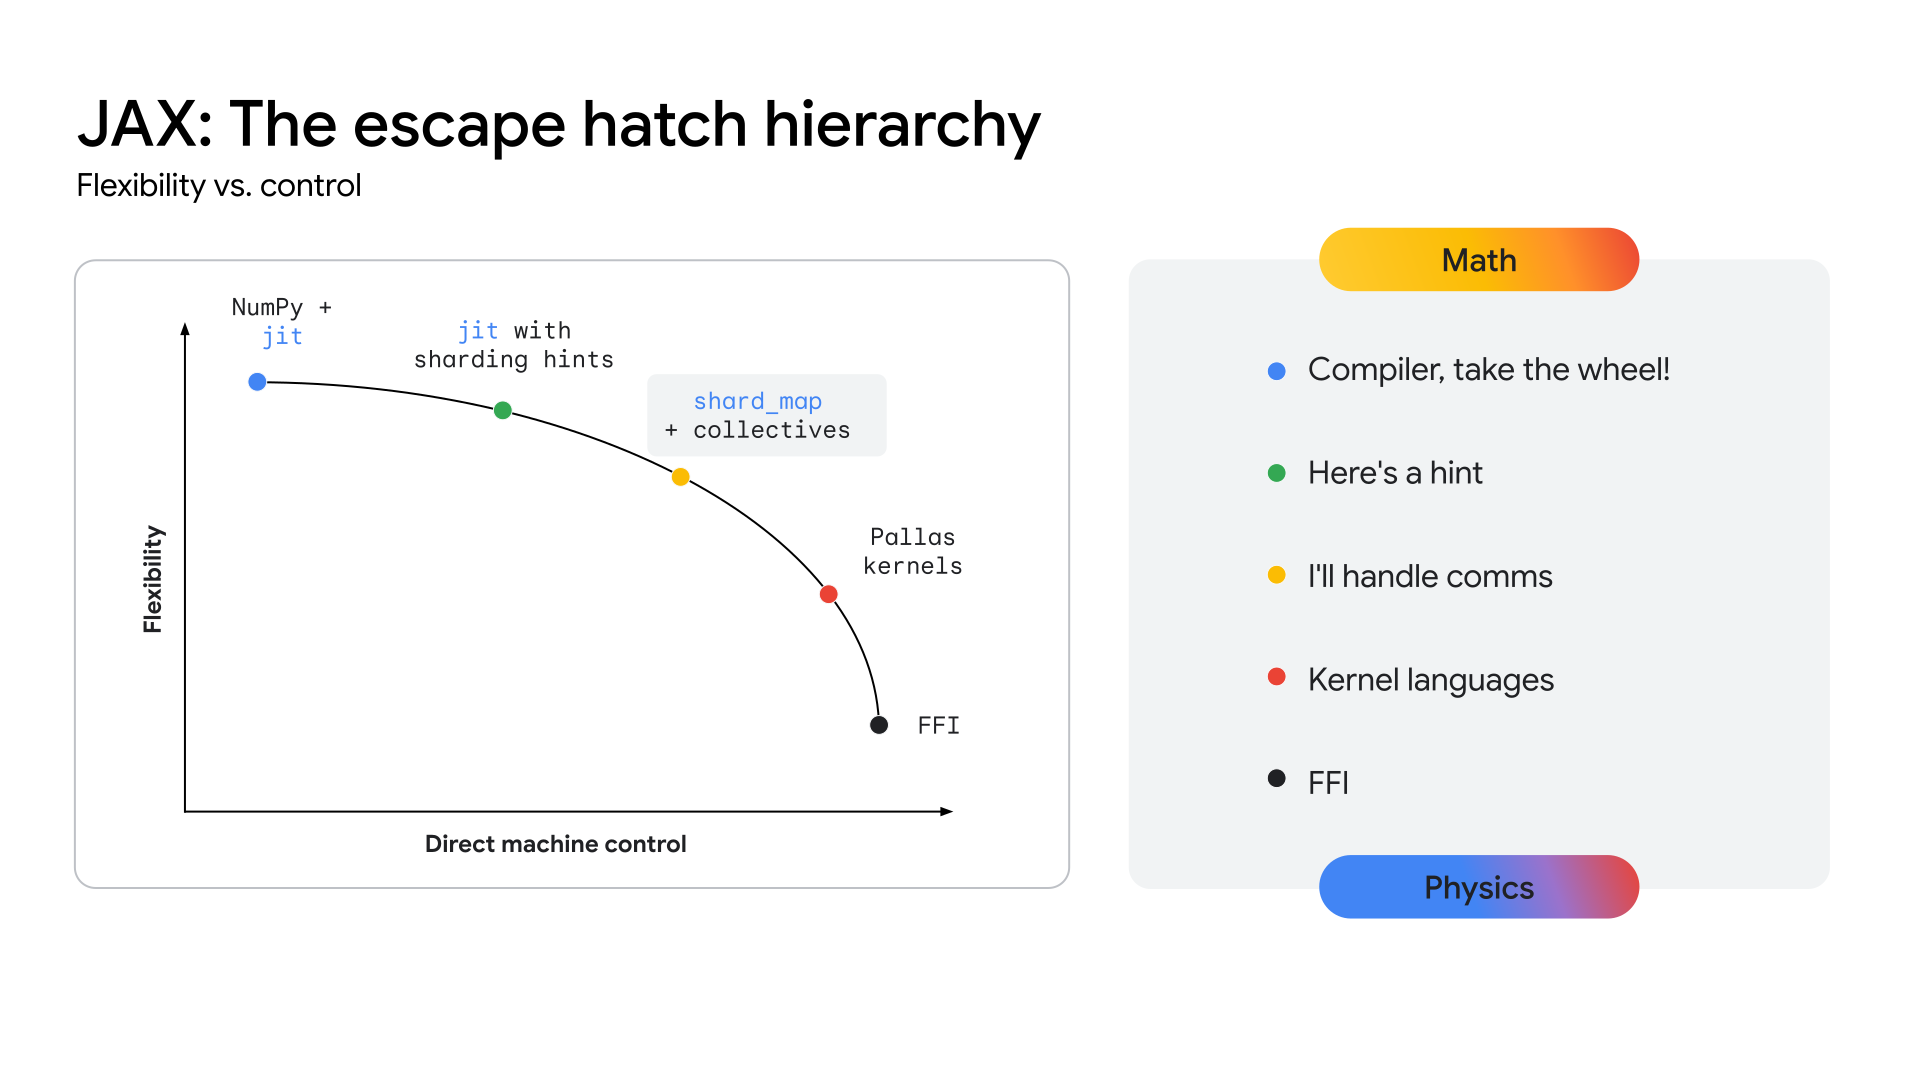
Agar TPU dapat memberikan jalur yang jelas ke tingkat performa ini, ekosistem harus mengekspos lapisan API yang lebih dekat ke hardware, sehingga memungkinkan pengembangan kernel yang sangat khusus ini. Stack JAX dirancang untuk menyelesaikan masalah ini dengan menawarkan rangkaian abstraksi (Lihat Gambar 2), mulai dari pengoptimalan tingkat tinggi otomatis dari compiler XLA hingga kontrol manual yang mendetail dari library penulisan kernel Pallas.
Gambar 2: Kontinum abstraksi JAX
Stack JAX AI inti
JAX AI Stack inti terdiri dari lima library utama yang menyediakan fondasi untuk pengembangan model:
JAX: Fondasi untuk transformasi program berperforma tinggi yang dapat dikomposisi
JAX adalah library Python untuk komputasi array dan transformasi program yang berorientasi pada akselerator, yang dirancang untuk komputasi numerik berperforma tinggi dan Machine Learning berskala besar. Dengan model pemrograman fungsional dan API yang mirip dengan NumPy, JAX memberikan fondasi yang kuat untuk library tingkat tinggi.
Dengan desain yang mengutamakan compiler, JAX secara inheren meningkatkan skalabilitas dengan memanfaatkan XLA (lihat bagian XLA) untuk analisis, pengoptimalan, dan penargetan hardware seluruh program yang agresif. Penekanan JAX pada pemrograman fungsional (misalnya, fungsi murni) membuat transformasi program intinya lebih mudah ditangani dan, yang terpenting, dapat dikomposisi.
Transformasi inti ini dapat dipadukan dan dicocokkan untuk mencapai performa tinggi dan penskalaan workload di berbagai ukuran model, ukuran cluster, dan jenis hardware:
- jit: Kompilasi just-in-time fungsi Python menjadi file yang dapat dieksekusi XLA yang dioptimalkan dan digabungkan.
- grad: Diferensiasi otomatis, yang mendukung mode maju dan mundur, serta turunan tingkat tinggi.
- vmap: Vektorisasi otomatis, yang memungkinkan pengelompokan dan paralelisme data yang lancar tanpa mengubah logika fungsi.
- pmap / shard_map: Paralelisasi otomatis di beberapa perangkat (misalnya, core TPU), yang menjadi dasar untuk pelatihan terdistribusi.
Integrasi yang lancar dengan model GSPMD (SPMD tujuan umum) XLA memungkinkan JAX memparalelkan komputasi secara otomatis di seluruh Pod TPU besar dengan perubahan kode minimal. Pada umumnya, penskalaan hanya memerlukan anotasi sharding tingkat tinggi.
Flax: Pembuatan jaringan neural yang fleksibel
Flax menyederhanakan pembuatan, proses debug, dan analisis jaringan neural di JAX dengan menyediakan pendekatan berorientasi objek yang intuitif untuk pembuatan model. Meskipun API fungsional JAX sangat canggih, API ini menawarkan abstraksi berbasis lapisan yang lebih familier bagi developer yang terbiasa dengan framework seperti PyTorch, tanpa mengurangi performa.
Desain ini menyederhanakan modifikasi atau penggabungan komponen model terlatih.
Teknik seperti LoRA dan kuantisasi memerlukan definisi model yang dapat dimanipulasi,
yang disediakan oleh API NNX Flax melalui antarmuka Pythonic. NNX mengenkapsulasi
status model, mengurangi beban kognitif pengguna, dan memungkinkan penjelajahan
serta modifikasi hierarki model secara terprogram.
Keunggulan utama:
- API Berorientasi Objek yang Intuitif: Menyederhanakan konstruksi model dan memungkinkan kasus penggunaan lanjutan seperti penggantian submodul dan inisialisasi parsial.
- Konsisten dengan Core JAX: Flax menyediakan transformasi yang diangkat dan sepenuhnya kompatibel dengan paradigma fungsional JAX, sehingga menawarkan performa JAX yang lengkap dengan kemudahan penggunaan yang ditingkatkan bagi developer.
Optax: Strategi pengoptimalan dan pemrosesan gradien yang dapat dikomposisi
Optax adalah library pemrosesan dan pengoptimalan gradien untuk JAX. Library ini dirancang untuk menyediakan elemen penyusun bagi pembuat model yang dapat digabungkan kembali dengan cara kustom untuk melatih model deep learning di antara aplikasi lainnya. Library ini dibangun berdasarkan kemampuan library JAX inti untuk menyediakan library fungsi loss dan pengoptimal berperforma tinggi yang telah teruji dengan baik serta teknik terkait yang dapat digunakan untuk melatih model ML.
Motivasi
Penghitungan dan minimalisasi kerugian adalah inti dari hal yang memungkinkan
pelatihan model ML. Dengan dukungannya untuk diferensiasi otomatis, library JAX inti menyediakan kemampuan numerik untuk melatih model, tetapi tidak menyediakan implementasi standar pengoptimal populer (misalnya, RMSProp atau Adam) atau kerugian (misalnya, CrossEntropy atau MSE). Meskipun Anda dapat mengimplementasikan fungsi ini (dan beberapa developer tingkat lanjut akan memilih untuk melakukannya), bug dalam implementasi pengoptimal akan menimbulkan masalah kualitas model yang sulit didiagnosis. Daripada meminta pengguna menerapkan bagian penting tersebut,
Optax menyediakan implementasi algoritma ini yang diuji
kebenaran dan performanya.
Bidang teori pengoptimalan berada tepat di ranah penelitian, tetapi peran utamanya dalam pelatihan juga menjadikannya bagian yang sangat diperlukan dalam melatih model ML produksi. Library yang menjalankan peran ini harus cukup fleksibel untuk mengakomodasi iterasi riset yang cepat, serta cukup andal dan berperforma tinggi agar dapat diandalkan untuk pelatihan model produksi. Library ini juga harus menyediakan implementasi algoritma canggih yang telah diuji dengan baik dan sesuai dengan persamaan standar. Library Optax, melalui arsitektur modular yang dapat dikomposisi dan penekanan pada kode yang benar dan mudah dibaca, dirancang untuk mencapai hal ini.
Desain
Optax dirancang untuk meningkatkan kecepatan riset dan transisi dari riset ke produksi dengan menyediakan implementasi algoritma inti yang mudah dibaca, teruji, dan efisien. Optax memiliki kegunaan di luar konteks deep learning, tetapi dalam konteks ini, Optax dapat dipandang sebagai kumpulan fungsi kerugian, algoritma pengoptimalan, dan transformasi gradien yang terkenal, yang diimplementasikan dalam mode fungsional murni sesuai dengan filosofi JAX. Kumpulan loss dan pengoptimal yang terkenal memungkinkan pengguna memulai dengan mudah dan percaya diri.
Pendekatan modular yang diambil oleh Optax memungkinkan Anda merangkai beberapa pengoptimal bersama-sama, diikuti dengan transformasi umum lainnya (misalnya, pemangkasan gradien) dan menggabungkannya menggunakan teknik umum seperti MultiStep atau Lookahead untuk mencapai strategi pengoptimalan yang efektif dengan beberapa baris kode. Antarmuka yang fleksibel memungkinkan Anda meneliti algoritma pengoptimalan baru dan menggunakan teknik pengoptimalan orde kedua yang canggih seperti shampoo atau muon.
# Optax implementation of a RMSProp optimizer with a custom learning rate
#  schedule, gradient clipping and gradient accumulation.
optimizer = optax.chain(
  optax.clip_by_global_norm(GRADIENT_CLIP_VALUE),
  optax.rmsprop(learning_rate=optax.cosine_decay_schedule(init_value=lr,decay_steps=decay)),
  optax.apply_every(k=ACCUMULATION_STEPS)
)

# The same thing, in PyTorch
optimizer = optim.RMSprop(model_params, lr=LEARNING_RATE)
scheduler = optim.lr_scheduler.CosineAnnealingLR(optimizer, T_max=TOTAL_STEPS)
for i, (inputs, targets) in enumerate(data_loader):
    # ... Training loop body ...
    if (i + 1) % ACCUMULATION_STEPS == 0:
        torch.nn.utils.clip_grad_norm_(model.parameters(), GRADIENT_CLIP_VALUE)
        optimizer.step()
        scheduler.step()
 optimizer.zero_grad()
Cuplikan kode sebelumnya menunjukkan cara menyiapkan pengoptimal dengan kecepatan pembelajaran kustom, pemangkasan gradien, dan akumulasi gradien.
Kekuatan utama
- Library yang Andal: Menyediakan library kerugian, pengoptimal, dan algoritma yang komprehensif dengan fokus pada kebenaran dan keterbacaan.
- Transformasi Modular yang Dapat Dirangkai: API fleksibel ini memungkinkan Anda membuat strategi pengoptimalan yang canggih dan kompleks secara deklaratif, tanpa mengubah loop pelatihan.
- Fungsional dan Skalabel: Implementasi fungsional murni terintegrasi dengan lancar dengan mekanisme paralelisasi JAX (misalnya, pmap), sehingga Anda dapat menggunakan kode yang sama untuk menskalakan dari satu host ke cluster besar.
Orbax / TensorStore - Checkpoint terdistribusi skala besar
Orbax adalah library checkpointing untuk JAX yang dirancang untuk skala apa pun, mulai dari pelatihan terdistribusi satu perangkat hingga skala besar. Tujuannya adalah untuk menyatukan implementasi checkpointing yang terfragmentasi dan menghadirkan fitur performa penting, seperti checkpointing asinkron dan multi-tingkat, kepada audiens yang lebih luas. Orbax memungkinkan ketahanan yang diperlukan untuk tugas pelatihan besar dan menyediakan format yang fleksibel untuk memublikasikan checkpoint.
Tidak seperti sistem checkpoint dan pemulihan umum yang membuat snapshot seluruh status sistem, checkpoint ML dengan Orbax secara selektif hanya mempertahankan informasi yang penting untuk melanjutkan pelatihan, yaitu bobot model, status pengoptimal, dan status loader data. Pendekatan yang ditargetkan ini meminimalkan periode nonaktif akselerator. Orbax mencapai hal ini dengan tumpang tindih operasi I/O dengan komputasi, fitur penting untuk workload besar. Waktu akselerator tidak ada aktivitas dikurangi menjadi durasi perangkat untuk menghosting transfer data, yang dapat tumpang-tindih lebih lanjut dengan langkah pelatihan berikutnya, sehingga membuat checkpointing hampir bebas dari perspektif performa.
Pada intinya, Orbax menggunakan TensorStore untuk pembacaan dan penulisan data array yang efisien dan paralel. Orbax API mengabstraksi kompleksitas ini, menawarkan antarmuka yang mudah digunakan untuk menangani PyTrees, yang merupakan representasi standar model di JAX.
Keunggulan utama:
- Adopsi yang luas: Dengan jutaan download bulanan, Orbax berfungsi sebagai media umum untuk berbagi artefak ML.
- Menyederhanakan kompleksitas: Orbax mengabstraksi kompleksitas checkpointing terdistribusi, termasuk penyimpanan asinkron, atomisitas, dan detail sistem file.
- Fleksibel: Meskipun menawarkan API untuk kasus penggunaan umum, Orbax memungkinkan Anda menyesuaikan alur kerja untuk menangani persyaratan khusus.
- Performa Tinggi dan Skalabel: Fitur seperti checkpointing asinkron, format penyimpanan yang efisien (OCDBT), dan strategi pemuatan data yang cerdas memastikan Orbax dapat diskalakan ke pelatihan yang melibatkan puluhan ribu node.
Grain: Pipeline data input yang deterministik dan skalabel
Grain adalah library Python untuk membaca dan memproses data guna melatih dan mengevaluasi model JAX. Framework ini fleksibel, cepat, dan deterministik, serta mendukung fitur lanjutan seperti checkpointing yang penting untuk berhasil melatih workload besar. Library ini mendukung format data dan backend penyimpanan populer, serta menyediakan API yang fleksibel untuk memperluas dukungan ke format dan backend khusus pengguna yang tidak didukung secara native. Meskipun Grain terutama dirancang untuk berfungsi dengan JAX, Grain tidak bergantung pada framework, tidak memerlukan JAX untuk dijalankan, dan dapat digunakan dengan framework lain juga.
Motivasi
Pipeline data merupakan bagian penting dari infrastruktur pelatihan - pipeline data harus fleksibel agar transformasi umum dapat dinyatakan secara efisien, dan cukup berperforma tinggi sehingga dapat membuat akselerator tetap sibuk setiap saat. Mereka juga harus dapat mengakomodasi beberapa format dan backend penyimpanan. Karena waktu langkahnya yang lebih tinggi, melatih model besar dalam skala besar menimbulkan persyaratan tambahan pada pipeline data di luar persyaratan yang diperlukan oleh workload pelatihan reguler, yang terutama berfokus pada determinisme dan reproduksibilitas2. Library Grain dirancang dengan arsitektur fleksibel yang memenuhi kebutuhan ini.
2Di Bagian 5.1 makalah PaLM, penulis mencatat bahwa mereka mengamati lonjakan kerugian yang sangat besar meskipun pemangkasan gradien diaktifkan. Solusinya adalah menghapus batch data yang bermasalah dan memulai ulang pelatihan dari checkpoint sebelum lonjakan loss. Hal ini hanya dapat dilakukan dengan penyiapan pelatihan yang sepenuhnya deterministik dan dapat direproduksi.
Desain
Pada tingkat tertinggi, ada dua cara untuk menyusun pipeline input, sebagai cluster worker data terpisah atau dengan menempatkan worker data bersama di host yang menggerakkan akselerator. Grain memilih opsi kedua karena berbagai alasan.
Akselerator digabungkan dengan host canggih yang biasanya tidak aktif selama langkah-langkah pelatihan, sehingga menjadikannya pilihan alami untuk menjalankan pipeline data input. Ada keuntungan tambahan dari implementasi ini - implementasi ini menyederhanakan tampilan sharding data Anda dengan memberikan tampilan sharding yang konsisten di seluruh input dan komputasi. Dapat dikatakan bahwa menempatkan worker data di host akselerator berisiko memenuhi CPU host, tetapi hal ini tidak menghalangi pemindahan transformasi yang intensif komputasi ke cluster lain menggunakan RPC3.
Di sisi API, dengan implementasi Python murni yang mendukung beberapa proses dan API yang fleksibel, Grain memungkinkan Anda mengimplementasikan transformasi data yang kompleks secara arbitrer dengan menyusun tahap pipeline bersama-sama berdasarkan paradigma transformasi yang dipahami dengan baik.
Secara mandiri, Grain mendukung format data akses acak yang efisien seperti
ArrayRecord dan Bagz bersama format data populer lainnya seperti Parquet
dan TFDS. Grain menyertakan dukungan untuk membaca dari sistem file lokal serta membaca dari Cloud Storage secara default. Selain mendukung format dan backend penyimpanan populer, abstraksi yang jelas ke lapisan penyimpanan memungkinkan Anda menambahkan dukungan atau menggabungkan sumber data yang ada agar kompatibel dengan library Grain.
3Inilah cara pipeline data multimodal harus beroperasi - misalnya, tokenizer gambar dan audio adalah model yang berjalan di clusternya sendiri pada akseleratornya sendiri dan pipeline input akan melakukan panggilan RPC untuk mengonversi contoh data menjadi aliran token.
Kekuatan utama
- Pemberian data deterministik: Menempatkan worker data bersama dengan akselerator dan menggabungkannya dengan shuffle global yang stabil dan iterator yang dapat di-checkpoint memungkinkan status model dan status pipeline data di-checkpoint bersama dalam snapshot yang konsisten menggunakan Orbax, sehingga meningkatkan determinisme proses pelatihan.
- API yang fleksibel untuk memungkinkan transformasi data yang canggih: API transformasi Python murni yang fleksibel memungkinkan Anda melakukan transformasi data yang ekstensif dalam pipeline pemrosesan input.
- Dukungan yang dapat diperluas untuk beberapa format dan backend: API sumber data yang dapat diperluas mendukung format dan backend penyimpanan populer serta memungkinkan Anda menambahkan dukungan untuk format dan backend baru.
- Antarmuka proses debug yang andal: Alat visualisasi pipeline data dan mode debug memungkinkan Anda mengintrospeksi, men-debug, dan mengoptimalkan performa pipeline data.
Stack JAX AI yang diperluas
Selain stack inti, ekosistem library khusus yang kaya menyediakan infrastruktur, alat canggih, dan solusi lapisan aplikasi yang diperlukan untuk pengembangan ML menyeluruh.
Infrastruktur dasar: compiler dan runtime
XLA: Mesin yang tidak bergantung pada hardware dan berpusat pada compiler
Motivasi
XLA atau Accelerated Linear Algebra adalah compiler khusus domain Google, yang terintegrasi dengan baik ke dalam JAX dan mendukung perangkat hardware TPU, CPU, dan GPU. XLA dirancang untuk menjadi generator kode yang tidak bergantung pada hardware dan menargetkan TPU, GPU, serta CPU.
Desain compiler-first dari compiler XLA adalah pilihan arsitektur mendasar yang menciptakan keunggulan tahan lama dalam lanskap riset yang berkembang pesat. Sebaliknya, pendekatan yang berfokus pada kernel yang berlaku di ekosistem lain mengandalkan library yang dioptimalkan secara manual untuk performa. Meskipun sangat efektif untuk arsitektur model yang stabil dan mapan, hal ini menciptakan bottleneck bagi inovasi. Saat riset baru memperkenalkan arsitektur baru, ekosistem harus menunggu kernel baru ditulis dan dioptimalkan. Namun, desain kami yang berfokus pada compiler sering kali dapat digeneralisasi ke pola baru, sehingga memberikan jalur berperforma tinggi untuk riset mutakhir sejak awal.
Desain
XLA bekerja dengan mengompilasi Just-In-Time (JIT) graf komputasi yang dihasilkan JAX selama proses pelacakannya (misalnya, saat fungsi didekorasi dengan @jax.jit).
Kompilasi ini mengikuti pipeline multi-level:
- Grafik Komputasi JAX
- High-Level Optimizer (HLO)
- Low-Level Optimizer (LLO)
- Kode Hardware
- Dari Grafik JAX ke HLO: Grafik komputasi JAX dikonversi menjadi representasi HLO XLA. Pada tingkat tinggi ini, pengoptimalan yang kuat dan tidak bergantung pada hardware, seperti penggabungan operator dan manajemen memori yang efisien, diterapkan. Dialek StableHLO berfungsi sebagai antarmuka yang tahan lama dan berversi untuk tahap ini.
- Dari HLO ke LLO: Setelah pengoptimalan tingkat tinggi, backend khusus hardware mengambil alih, menurunkan representasi HLO menjadi LLO yang berorientasi pada mesin.
- Dari LLO ke Kode Hardware: LLO akhirnya dikompilasi menjadi kode mesin yang sangat efisien. Untuk TPU, kode ini dipaketkan sebagai paket Very Long Instruction Word (VLIW) yang dikirim langsung ke hardware.
Untuk penskalaan, desain XLA dibuat berdasarkan paralelisme. XLA menggunakan algoritma untuk memanfaatkan unit perkalian matriks (MXU) secara maksimal pada chip. Di antara chip, XLA menggunakan SPMD (Single Program Multiple Data), teknik paralelisasi berbasis compiler yang menggunakan satu program di semua perangkat. Model canggih ini diekspos melalui JAX API, sehingga Anda dapat mengelola paralelisme data, model, atau pipeline dengan anotasi sharding tingkat tinggi.
Untuk pola paralelisme yang lebih kompleks, Multiple Program Multiple Data (MPMD)
juga dapat digunakan, dan library seperti PartIR:MPMD memungkinkan pengguna JAX memberikan
anotasi MPMD juga.
Kekuatan utama
- Kompilasi: kompilasi just in time dari grafik komputasi memungkinkan pengoptimalan tata letak memori, alokasi buffer, dan manajemen memori. Alternatif seperti metodologi berbasis kernel membebankan beban tersebut kepada developer. Pada umumnya, XLA dapat mencapai performa yang sangat baik tanpa mengorbankan kecepatan developer.
- Paralelisme: XLA menerapkan beberapa bentuk paralelisme dengan SPMD, dan hal ini diekspos di level JAX. Dengan demikian, Anda dapat mengekspresikan strategi sharding, sehingga memungkinkan eksperimen dan skalabilitas model di ribuan chip.
Pathways: Runtime terpadu untuk komputasi terdistribusi skala besar
Pathways menawarkan abstraksi untuk pelatihan dan inferensi terdistribusi dengan toleransi kesalahan dan pemulihan bawaan, sehingga peneliti ML dapat membuat kode seolah-olah menggunakan satu mesin yang canggih.
Motivasi
Untuk dapat melatih dan men-deploy model besar, diperlukan ratusan hingga ribuan chip. Chip ini tersebar di berbagai rak dan mesin host. Tugas pelatihan adalah program sinkron berskala besar yang memerlukan semua chip ini, dan host masing-masing untuk bekerja bersama-sama pada komputasi XLA yang telah diparalelkan (di-sharding). Dalam kasus model bahasa besar, yang mungkin memerlukan lebih dari puluhan ribu chip, layanan ini harus mampu menjangkau beberapa Pod di seluruh fabric pusat data, selain menggunakan fabric interkoneksi antar-chip (ICI) dan interkoneksi on-chip (OCI) dalam Pod.
Desain
ML Pathways adalah sistem yang kami gunakan untuk mengoordinasikan komputasi terdistribusi di seluruh host dan TPU chip. Arsitektur ini dirancang untuk skalabilitas dan efisiensi di ratusan ribu akselerator. Untuk pelatihan berskala besar, framework ini menyediakan satu klien Python untuk beberapa tugas Pod, integrasi Megascale XLA, layanan kompilasi, dan Python jarak jauh. Solusi ini juga mendukung paralelisme lintas slice dan toleransi preemption, sehingga memungkinkan pemulihan otomatis dari preemption resource.
Pathways menggabungkan kolektif lintas host yang dioptimalkan, sehingga memungkinkan grafik komputasi XLA meluas melampaui satu Pod TPU. Multislice memperluas dukungan XLA untuk paralelisme data, model, dan pipeline agar dapat bekerja di seluruh batas slice TPU menggunakan jaringan pusat data (DCN) dengan mengintegrasikan runtime terdistribusi yang mengelola komunikasi DCN dengan primitif komunikasi XLA.
Kekuatan utama
Arsitektur pengontrol tunggal, yang terintegrasi dengan JAX, adalah abstraksi utama. Dengan framework ini, peneliti dapat mengeksplorasi berbagai strategi sharding dan paralelisme untuk pelatihan dan deployment sekaligus menskalakan ke puluhan ribu chip dengan mudah.
Pengembangan lanjutan: performa, data, dan efisiensi
Pallas: Menulis kernel kustom berperforma tinggi di JAX
Meskipun JAX mengutamakan compiler, ada situasi saat Anda mungkin menginginkan kontrol
yang mendetail atas hardware untuk mencapai performa maksimum. Pallas adalah
ekstensi untuk JAX yang memungkinkan penulisan kernel kustom untuk GPU dan TPU. Tujuannya
adalah untuk memberikan kontrol yang tepat atas kode yang dihasilkan, yang dikombinasikan dengan ergonomi
tingkat tinggi dari pelacakan JAX dan jax.numpy API.
Pallas mengekspos model paralelisme berbasis petak tempat fungsi kernel yang ditentukan pengguna diluncurkan di seluruh petak multi-dimensi dari grup kerja paralel. Pallas memungkinkan pengelolaan hierarki memori secara eksplisit dengan memungkinkan Anda menentukan cara tensor disusun dan ditransfer antara memori yang lebih lambat dan lebih besar (misalnya, HBM) dan memori on-chip yang lebih cepat dan lebih kecil (misalnya, VMEM di TPU, Memori Bersama di GPU), menggunakan peta indeks untuk mengaitkan lokasi petak dengan blok data tertentu. Pallas dapat menurunkan definisi kernel yang sama agar dapat dieksekusi secara efisien di TPU Google dan berbagai GPU dengan mengompilasi kernel ke dalam representasi perantara yang sesuai untuk arsitektur target – Mosaic untuk TPU, atau memanfaatkan teknologi seperti Triton untuk GPU. Dengan Pallas, Anda dapat menulis kernel berperforma tinggi yang mengkhususkan blok seperti perhatian untuk mencapai performa model terbaik pada hardware target tanpa perlu mengandalkan toolkit khusus vendor.
Tokamax: Koleksi kernel canggih yang diseleksi
Jika Pallas adalah alat untuk menulis kernel, Tokamax adalah library kernel akselerator kustom canggih yang mendukung TPU dan GPU. Tokamax dibangun di atas JAX dan Pallas, serta memungkinkan Anda menggunakan kekuatan penuh hardware Anda. Framework ini juga menyediakan alat bagi Anda untuk membangun dan menyesuaikan kernel kustom secara otomatis.
Motivasi
JAX, yang berakar pada XLA, adalah framework yang mengutamakan compiler. Namun, ada beberapa kasus tertentu yang mengharuskan Anda mengontrol hardware secara langsung untuk mencapai performa maksimum4. Kernel kustom sangat penting untuk mendapatkan performa terbaik dari resource akselerator ML yang mahal seperti TPU dan GPU. Meskipun banyak digunakan untuk memungkinkan eksekusi operator utama yang berperforma tinggi seperti Attention, penerapannya memerlukan pemahaman mendalam tentang model dan arsitektur hardware target. Tokamax menyediakan satu sumber otoritatif kernel berperforma tinggi yang dikurasi dan diuji dengan baik, bersama dengan infrastruktur bersama yang tangguh untuk pengembangan, pemeliharaan, dan pengelolaan siklus prosesnya. Library tersebut juga dapat berfungsi sebagai implementasi referensi untuk Anda bangun dan sesuaikan seperlunya. Dengan begitu, Anda dapat berfokus pada upaya pemodelan tanpa perlu mengkhawatirkan infrastruktur.
4Ini adalah paradigma yang sudah mapan dan memiliki preseden di dunia CPU, di mana kode yang dikompilasi membentuk sebagian besar program dengan developer beralih ke intrinsik atau assembly inline untuk mengoptimalkan bagian-bagian yang penting bagi performa.
Desain
Untuk kernel tertentu, Tokamax menyediakan API umum yang mungkin didukung oleh beberapa implementasi. Misalnya, kernel TPU dapat diimplementasikan dengan penurunan XLA standar, atau secara eksplisit dengan Pallas/Mosaic-TPU. Kernel GPU dapat diimplementasikan dengan penurunan XLA standar, dengan Mosaic-GPU, atau Triton. Secara default, Tokamax API memilih implementasi yang paling dikenal untuk konfigurasi tertentu, yang ditentukan oleh hasil yang di-cache dari penyesuaian otomatis berkala dan operasi tolok ukur, meskipun Anda dapat memilih implementasi tertentu jika diperlukan. Implementasi baru dapat ditambahkan seiring waktu untuk memanfaatkan fitur tertentu dengan lebih baik dalam generasi hardware baru untuk performa yang lebih baik.
Komponen utama library Tokamax, selain kernel itu sendiri, adalah infrastruktur pendukung yang memungkinkan Anda menulis kernel kustom. Misalnya, infrastruktur penyesuaian otomatis memungkinkan Anda menentukan serangkaian parameter yang dapat dikonfigurasi (misalnya, ukuran ubin) yang dapat disapu secara menyeluruh oleh Tokamax, untuk menentukan dan meng-cache setelan yang disesuaikan sebaik mungkin. Regresi harian melindungi Anda dari masalah performa dan numerik yang tidak terduga yang disebabkan oleh perubahan pada infrastruktur compiler yang mendasarinya atau dependensi lainnya.
Kekuatan utama
- Pengalaman developer yang lancar: Library terpadu yang diseleksi menyediakan implementasi kernel utama yang berperforma tinggi dan terbukti baik, dengan ekspresi yang jelas tentang generasi hardware yang didukung dan performa yang diharapkan, baik secara terprogram maupun dalam dokumentasi. Hal ini meminimalkan fragmentasi dan churn.
- Fleksibilitas dan pengelolaan siklus proses: Anda dapat memilih implementasi yang berbeda, bahkan mengubahnya seiring waktu jika sesuai. Misalnya, jika compiler XLA meningkatkan dukungan untuk operasi tertentu yang tidak lagi memerlukan kernel kustom, ada jalur untuk penghentian penggunaan dan migrasi.
- Ekstensibilitas: Anda dapat mengimplementasikan kernel Anda sendiri, sekaligus memanfaatkan infrastruktur bersama yang didukung dengan baik, sehingga Anda dapat berfokus pada kemampuan dan pengoptimalan yang memberikan nilai tambah. Implementasi standar yang ditulis dengan jelas berfungsi sebagai titik awal bagi pengguna untuk belajar dan mengembangkannya.
Qwix: Kuantisasi yang komprehensif dan tidak mengganggu
Qwix adalah library kuantisasi yang komprehensif untuk stack AI JAX, yang mendukung LLM dan jenis model lainnya di semua tahap, termasuk pelatihan (Quantization Aware Training (QAT), Quantization Technique (QT), Quantized Low-Rank Adaptation (QLoRA)) dan inferensi Post Training Quantization (PTQ), yang menargetkan runtime XLA dan di perangkat.
Motivasi
Library kuantisasi yang ada, terutama dalam ekosistem PyTorch, sering kali memiliki tujuan terbatas (misalnya, hanya PTQ atau hanya QLoRA). Lanskap yang terfragmentasi ini memaksa Anda untuk beralih alat, sehingga menghambat penggunaan kode yang konsisten dan pencocokan numerik yang tepat antara pelatihan dan inferensi. Selain itu, banyak solusi memerlukan modifikasi model yang substansial, yang menggabungkan logika model dengan pengaitan erat logika kuantisasi.
Desain
Filosofi desain Qwix menekankan solusi yang komprehensif dan, yang terpenting, integrasi model yang tidak mengganggu. Arsitekturnya memiliki desain hierarkis yang dapat diperluas dan dibuat berdasarkan API fungsional yang dapat digunakan kembali.
Integrasi yang tidak mengganggu ini dicapai melalui mekanisme intersepsi yang dirancang dengan cermat yang mengalihkan fungsi JAX ke fungsi yang dikuantisasi. Hal ini memungkinkan Anda mengintegrasikan model tanpa modifikasi apa pun, sehingga sepenuhnya memisahkan kode kuantisasi dari definisi model.
Contoh berikut menunjukkan penerapan kuantisasi w4a4 (bobot 4-bit, aktivasi 4-bit) ke lapisan MLP LLM dan kuantisasi w8 (bobot 8-bit) ke embedder. Untuk mengubah resep kuantisasi, Anda hanya perlu
memperbarui daftar aturan.
fp_model = ModelWithoutQuantization(...)
rules = [
    qwix.QuantizationRule(
        module_path=r'embedder',
        weight_qtype='int8',
    ),
    qwix.QuantizationRule(
        module_path=r'layers_\d+/mlp',
        weight_qtype='int4',
        act_qtype='int4',
        tile_size=128,
        weight_calibration_method='rms,7',
    ),
]
quantized_model = qwix.quantize_model(fp_model, qwix.PtqProvider(rules))
Kekuatan utama
- Solusi Komprehensif: Qwix dapat diterapkan secara luas di berbagai skenario kuantisasi, sehingga memastikan penggunaan kode yang konsisten antara pelatihan dan inferensi.
- Integrasi Model Non-Intrusif: Seperti yang ditunjukkan contoh, Anda dapat mengintegrasikan model dengan satu baris kode. Hal ini memungkinkan Anda menggunakan hyperparameter di banyak skema kuantisasi untuk menemukan kompromi kualitas versus performa terbaik.
- Digabungkan dengan Library Lain: Qwix terintegrasi lancar dengan stack JAX AI. Misalnya, Tokamax otomatis beradaptasi untuk menggunakan versi kernel yang dikuantisasi, tanpa kode pengguna tambahan, saat model dikuantisasi dengan Qwix.
- Mendukung Riset: API dasar dan arsitektur Qwix yang dapat diperluas memberdayakan peneliti untuk mengeksplorasi algoritma baru dan memfasilitasi perbandingan langsung dengan alat tolok ukur dan evaluasi terintegrasi.
Lapisan aplikasi: pelatihan dan penyelarasan
Pelatihan model dasar: MaxText dan MaxDiffusion
MaxText dan MaxDiffusion adalah framework pelatihan model LLM dan Diffusion unggulan Google. Repositori ini berisi pilihan implementasi yang sangat dioptimalkan dari model open-weights populer. Model ini memiliki tujuan ganda: berfungsi sebagai codebase pelatihan model yang siap digunakan dan sebagai referensi yang dapat digunakan oleh pembuat model dasar untuk membangun model.
Motivasi
Ada pertumbuhan minat yang pesat di seluruh industri dalam melatih model GenAI. Popularitas model terbuka telah mempercepat tren ini, dengan menyediakan arsitektur yang terbukti. Pelatihan dan adaptasi model ini memerlukan performa tinggi, efisiensi, skalabilitas ke sejumlah besar chip, dan kode yang jelas serta mudah dipahami. MaxText dan MaxDiffusion adalah solusi komprehensif yang dapat digunakan di TPU atau GPU dan dirancang untuk memenuhi kebutuhan ini.
Desain
MaxText dan MaxDiffusion adalah codebase model dasar yang dirancang dengan mempertimbangkan keterbacaan dan performa. Model ini disusun dengan komponen yang dapat digunakan kembali dan telah teruji dengan baik: definisi model yang menggunakan kernel kustom (seperti Tokamax) untuk performa maksimum, harness pelatihan untuk orkestrasi dan pemantauan, serta sistem konfigurasi canggih yang memungkinkan Anda mengontrol detail seperti sharding dan kuantisasi (menggunakan Qwix) melalui antarmuka yang intuitif. Fitur keandalan tingkat lanjut seperti checkpointing multi-tingkat disertakan untuk memastikan goodput yang berkelanjutan.
MaxText dan MaxDiffusion menggunakan library JAX terbaik di kelasnya, yaitu Qwix, Tunix, Orbax, dan Optax untuk memberikan kemampuan inti. Library ini menyediakan infrastruktur yang tangguh dan skalabel, sehingga mengurangi beban pengembangan dan memungkinkan Anda berfokus pada tugas pemodelan. Untuk inferensi, kode model dibagikan untuk memungkinkan penyajian yang efisien dan skalabel.
Kekuatan utama
- Performa Tinggi sejak Awal: Dengan infrastruktur pelatihan yang disiapkan untuk "goodput" (throughput yang berguna) tinggi dan implementasi model yang dioptimalkan untuk MFU (Model Flops Utilization) tinggi, MaxText dan MaxDiffusion memberikan performa tinggi dalam skala besar secara langsung.
- Dibuat untuk Skala: Dengan memanfaatkan kecanggihan stack AI JAX (terutama Pathways), framework ini memungkinkan Anda melakukan penskalaan dengan lancar dari puluhan chip hingga puluhan ribu chip.
- Dasar yang Kuat untuk Builder Model Dasar: Implementasi yang berkualitas tinggi dan mudah dibaca berfungsi sebagai titik awal yang kuat bagi developer untuk digunakan sebagai solusi menyeluruh atau sebagai implementasi referensi untuk penyesuaian mereka sendiri.
Pasca-pelatihan dan penyelarasan: Framework Tunix
Tunix menawarkan algoritma reinforcement learning (RL) open source yang canggih, serta framework dan infrastruktur yang tangguh, sehingga memberikan jalur yang efisien bagi developer untuk bereksperimen dengan teknik pasca-pelatihan LLM, termasuk penyesuaian terpandu (SFT) dan penyelarasan menggunakan JAX dan TPU.
Motivasi
Pascapelatihan adalah langkah penting dalam mengoptimalkan kemampuan LLM yang sebenarnya. Tahap reinforcement learning (RL) sangat penting untuk mengembangkan kemampuan penyelarasan dan penalaran. Pengembangan open source di area ini hampir sepenuhnya didasarkan pada PyTorch dan GPU, sehingga menyisakan kesenjangan mendasar untuk solusi JAX dan TPU. Tunix (Tune-in-JAX) adalah library native JAX berperforma tinggi yang dirancang untuk mengisi kesenjangan ini.
Desain
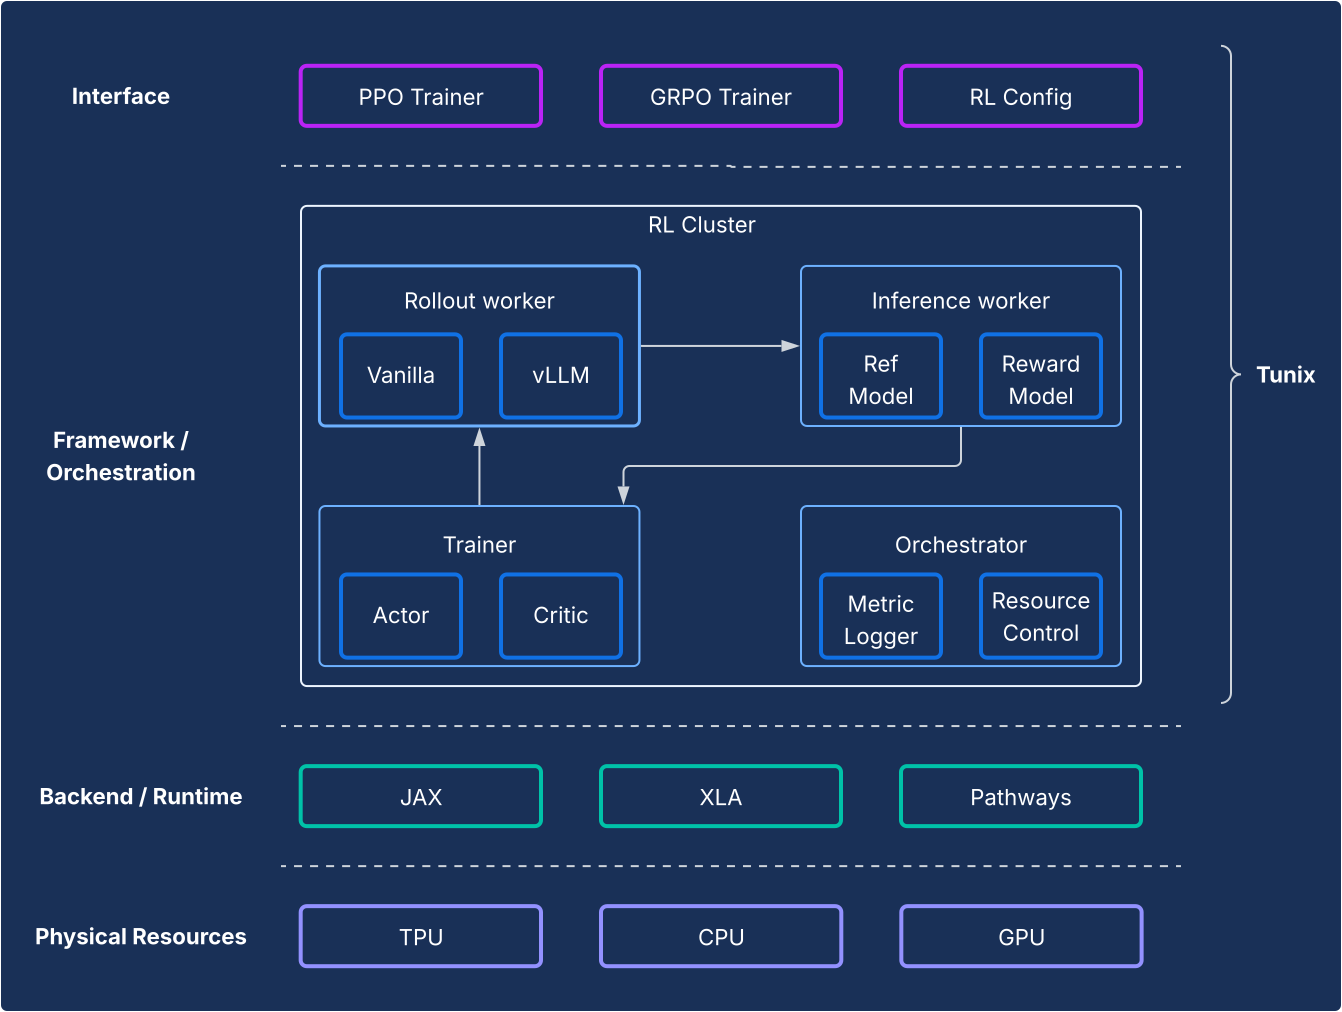
Dari perspektif framework, Tunix memungkinkan penyiapan canggih yang memisahkan algoritma RL dari infrastruktur dengan jelas. Library ini menawarkan API ringan seperti klien yang menyembunyikan kompleksitas infrastruktur RL, sehingga Anda dapat mengembangkan algoritma baru. Tunix menyediakan solusi siap pakai untuk algoritma populer, termasuk Proximal Policy Optimization (PPO), Direct Preference Optimization (DPO), dan lainnya.
Di sisi infrastruktur, Tunix memiliki integrasi dengan Pathways, yang memungkinkan arsitektur pengontrol tunggal yang membuat pelatihan RL multi-node dapat diakses. Di sisi pelatihan, Tunix secara native mendukung pelatihan yang efisien parameter (misalnya, LoRA) serta memanfaatkan sharding JAX dan XLA (General and Scalable Parallelization for ML Computation Graph (GSPMD)) untuk menghasilkan grafik komputasi yang berperforma tinggi. Layanan ini mendukung model open source populer seperti Gemma dan Llama secara langsung.
Kekuatan utama
- Kemudahan: Menyediakan API tingkat tinggi seperti klien yang mengabstraksi kompleksitas infrastruktur terdistribusi yang mendasarinya.
- Efisiensi Developer: Tunix mempercepat siklus proses R&D dengan algoritma dan "resep" bawaan, sehingga memberi Anda model yang berfungsi dan memungkinkan Anda melakukan iterasi dengan cepat.
- Performa dan Skalabilitas: Tunix memungkinkan infrastruktur pelatihan yang sangat efisien dan skalabel secara horizontal dengan memanfaatkan Pathways sebagai pengontrol tunggal di backend.
Lapisan aplikasi: Produksi dan inferensi
Tantangan historis untuk adopsi JAX adalah jalur dari riset ke produksi. Stack AI JAX kini menyediakan cerita produksi dua cabang yang matang, yang menawarkan kompatibilitas ekosistem dan performa JAX.
Inferensi LLM berperforma tinggi: Solusi vLLM-JAX
vLLM-JAX adalah backend inferensi berperforma tinggi dari Google yang dirancang untuk menjalankan model bahasa besar (LLM) JAX secara efisien di Cloud TPU. Model ini mengintegrasikan framework vLLM open source dengan ekosistem JAX dan TPU Google. Untuk menyajikan model PyTorch dengan vLLM di TPU, lihat PyTorch di Cloud TPU.
Motivasi
Industri ini berkembang pesat, dengan meningkatnya permintaan akan solusi inferensi yang lancar, berperforma tinggi, dan mudah digunakan. Developer sering kali menghadapi tantangan signifikan dari alat yang kompleks dan tidak konsisten, performa yang kurang optimal, dan kompatibilitas model yang terbatas. Stack vLLM mengatasi masalah ini dengan menyediakan platform yang terpadu, berperforma tinggi, dan intuitif.
Desain
Solusi ini memperluas framework vLLM, bukan menciptakannya kembali. vLLM-JAX adalah mesin inferensi LLM open source yang sangat dioptimalkan dan dikenal karena throughput-nya yang tinggi, yang dicapai menggunakan fitur-fitur utama seperti PagedAttention (yang mengelola cache KV seperti memori virtual untuk meminimalkan fragmentasi) dan Continuous Batching (yang secara dinamis menambahkan permintaan ke batch untuk meningkatkan pemanfaatan).
vLLM-JAX dibangun di atas fondasi ini dan mengembangkan komponen inti untuk penanganan permintaan, penjadwalan, dan manajemen memori. Solusi ini memperkenalkan backend berbasis JAX yang bertindak sebagai jembatan, menerjemahkan grafik komputasi dan operasi memori vLLM menjadi kode yang dapat dieksekusi TPU. Backend ini menangani interaksi perangkat, eksekusi model JAX, dan hal-hal spesifik terkait pengelolaan cache KV pada hardware TPU. JetStream menggabungkan pengoptimalan khusus TPU, seperti mekanisme atensi yang efisien (misalnya, memanfaatkan kernel JAX Pallas untuk Ragged Paged Attention) dan kuantisasi, yang semuanya disesuaikan untuk arsitektur TPU.
Kekuatan utama
- Biaya Aktivasi/Penonaktifan Nol untuk Pengguna: Pengguna dapat mengadopsi solusi ini tanpa hambatan yang signifikan. Dari perspektif pengalaman pengguna, pemrosesan permintaan inferensi di TPU harus sama dengan di GPU. CLI untuk memulai server, menerima perintah, dan menampilkan output semuanya dibagikan.
- Memanfaatkan Ekosistem Sepenuhnya: Pendekatan ini memanfaatkan dan berkontribusi pada antarmuka dan pengalaman pengguna vLLM, sehingga memastikan kompatibilitas dan kemudahan penggunaan.
- Fungibilitas antara TPU dan GPU: Solusi ini bekerja secara efisien di TPU dan GPU, sehingga memberi Anda fleksibilitas.
- Hemat Biaya (Performa/$ Terbaik): Mengoptimalkan performa untuk memberikan rasio performa terhadap biaya terbaik bagi model populer.
Inferensi JAX: Serialisasi Orbax dan mesin inferensi Neptune
Untuk model selain LLM, atau bagi pengguna yang menginginkan pipeline native JAX sepenuhnya, library serialisasi Orbax dan sistem Neptune serving engine (NSE) menyediakan solusi inferensi berperforma tinggi yang menyeluruh.
Motivasi
Secara historis, model JAX sering kali mengandalkan jalur yang berliku-liku ke produksi, seperti digabungkan dalam grafik TensorFlow dan di-deploy menggunakan TensorFlow Serving. Pendekatan ini menimbulkan batasan dan inefisiensi yang signifikan, sehingga memaksa developer untuk berinteraksi dengan ekosistem terpisah dan memperlambat iterasi. Sistem penyaluran khusus native JAX sangat penting untuk keberlanjutan, mengurangi kompleksitas, dan mengoptimalkan performa.
Desain
Solusi ini terdiri dari dua komponen inti, seperti yang diilustrasikan dalam diagram berikut.
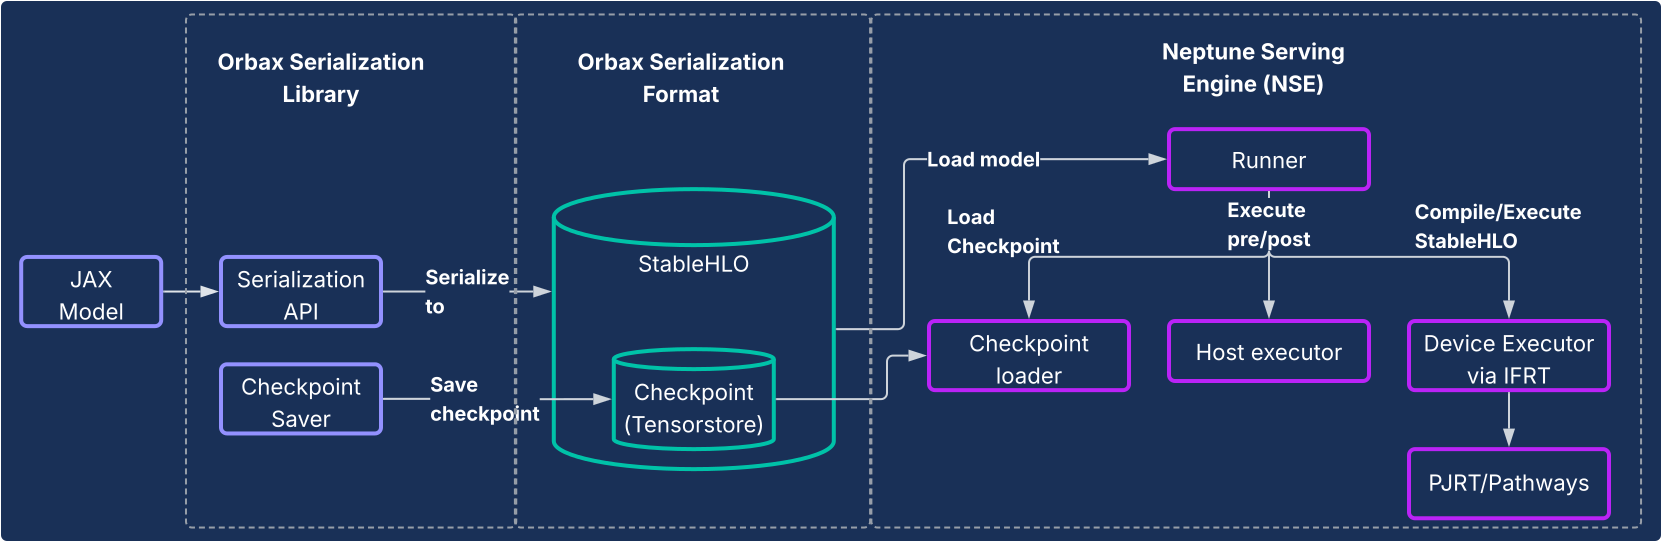
- Library Serialisasi Orbax: Menyediakan API yang mudah digunakan untuk melakukan serialisasi model JAX ke dalam format serialisasi Orbax baru yang andal. Format ini dioptimalkan untuk deployment produksi. Format ini secara langsung merepresentasikan komputasi model JAX menggunakan StableHLO, sehingga grafik komputasi dapat direpresentasikan secara native. Model ini juga memanfaatkan TensorStore untuk menyimpan bobot, sehingga memungkinkan pemuatan checkpoint yang cepat untuk inferensi.
- Neptune Serving Engine (NSE): Ini adalah mesin inferensi yang fleksibel dan berperforma tinggi (biasanya di-deploy sebagai biner C++) yang dirancang untuk menjalankan model JAX secara native dalam format Orbax. NSE menawarkan kemampuan penting untuk produksi, seperti pemuatan model yang cepat, penyajian serentak dengan throughput tinggi dan batching bawaan, dukungan untuk beberapa versi model, serta penyajian host tunggal dan multi-host (memanfaatkan PJRT dan Pathways). Gunakan Neptune
Serving Engine untuk:
- Model non-LLM: Ini adalah solusi tujuan umum yang ideal untuk beban kerja seperti sistem pemberi rekomendasi, model difusi, dan model AI lainnya.
- LLM kecil dan inferensi "one-shot": Dirancang untuk model non-autoregresif atau model yang lebih kecil yang disajikan dalam mode "unary", di mana seluruh output dihasilkan dalam satu proses tanpa memerlukan pengelolaan status yang kompleks seperti cache KV.
Singkatnya, Neptune Serving Engine mengisi celah untuk menyajikan berbagai macam model yang bukan model bahasa autoregresif besar, sehingga memberikan solusi native TPU berperforma tinggi untuk ekosistem ML yang lebih luas.
Kekuatan utama
- Penyajian Native JAX: Solusi ini dibuat secara native untuk JAX, sehingga menghilangkan overhead antar-framework dalam serialisasi dan penyajian model. Hal ini memastikan pemuatan model yang cepat dan eksekusi yang dioptimalkan di seluruh CPU, GPU, dan TPU.
- Deployment Produksi yang Mudah: Model yang diserialisasi menyediakan jalur deployment hermetis yang tidak terpengaruh oleh penyimpangan dalam dependensi Python dan memungkinkan pemeriksaan integritas model runtime. Hal ini memberikan jalur yang lancar dan intuitif untuk produksi model JAX.
- Pengalaman Developer yang Lebih Baik: Dengan menghilangkan kebutuhan akan penggabungan framework yang rumit, solusi ini secara signifikan mengurangi dependensi dan kompleksitas sistem, sehingga mempercepat iterasi bagi developer JAX.
Analisis dan pembuatan profil di seluruh sistem
XProf: Pembuatan profil performa yang mendalam dan terintegrasi dengan hardware
XProf adalah alat pembuatan profil dan analisis performa yang memberikan visibilitas mendalam ke berbagai aspek eksekusi workload ML, sehingga Anda dapat men-debug dan mengoptimalkan performa. Framework ini terintegrasi secara mendalam ke dalam ekosistem JAX dan TPU.
Motivasi
Di satu sisi, workload ML menjadi semakin rumit. Di sisi lain, ada ledakan kemampuan hardware khusus yang menargetkan workload ini. Mencocokkan keduanya secara efektif untuk memastikan performa dan efisiensi puncak sangatlah penting, mengingat biaya infrastruktur ML yang sangat besar. Hal ini memerlukan visibilitas mendalam ke workload dan hardware, yang disajikan dengan cara yang dapat digunakan dengan cepat. XProf unggul dalam hal ini.
Desain
XProf terdiri dari dua komponen utama: pengumpulan dan analisis.
- Pengumpulan: XProf mengambil informasi dari berbagai sumber: anotasi dalam kode JAX Anda, model biaya untuk operasi dalam compiler XLA, dan fitur pembuatan profil hardware yang dibuat khusus dalam TPU. Pengumpulan ini dapat dipicu secara terprogram atau on-demand, sehingga menghasilkan artefak peristiwa yang komprehensif.
- Analisis: XProf melakukan pascapemrosesan data yang dikumpulkan dan membuat serangkaian visualisasi yang efektif, yang diakses dengan browser.
Kekuatan utama
Keunggulan terbesar XProf berasal dari integrasinya yang mendalam dengan stack lengkap, yang memberikan analisis yang luas dan mendalam, yang merupakan manfaat nyata dari ekosistem JAX/TPU yang dirancang bersama.
- Didesain bersama TPU: XProf memanfaatkan fitur hardware yang dirancang khusus untuk pengumpulan profil yang lancar, sehingga overhead pengumpulan kurang dari 1%. Hal ini memungkinkan pembuatan profil menjadi bagian pengembangan yang ringan dan iteratif.
- Luas dan Kedalaman Analisis: XProf menghasilkan analisis mendalam di berbagai sumbu. Alatnya meliputi:
- Trace Viewer: Tampilan linimasa operasi eksekusi pada berbagai unit hardware (misalnya, TensorCore).
- HLO Op Profile: Menguraikan total waktu yang dihabiskan ke dalam berbagai kategori operasi.
- Memory Viewer: Menampilkan detail alokasi memori berdasarkan berbagai operasi selama periode pembuatan profil.
- Analisis Roofline: Membantu Anda mengidentifikasi apakah operasi tertentu terikat komputasi atau memori dan seberapa jauh operasi tersebut dari kemampuan puncak hardware.
- Penampil Grafik: Memberikan tampilan ke dalam grafik HLO lengkap yang dijalankan oleh hardware.
Perspektif komparatif: Stack JAX/TPU sebagai pilihan yang menarik
Lanskap Machine Learning modern menawarkan banyak toolchain yang sangat baik dan matang. JAX AI Stack menghadirkan serangkaian keunggulan yang unik dan menarik bagi developer yang berfokus pada ML skala besar dan berperforma tinggi, yang berasal langsung dari desain modular dan desain bersama hardware yang mendalam.
Meskipun banyak framework menawarkan beragam fitur, JAX AI Stack memberikan pembeda yang spesifik dan kuat di area utama siklus proses pengembangan:
- Pengalaman developer yang lebih sederhana dan lebih canggih: Paradigma transformasi gradien Optax yang dapat dirantai memungkinkan strategi pengoptimalan yang lebih canggih dan fleksibel yang dideklarasikan sekali, bukan dikelola secara imperatif dalam loop pelatihan. Pada tingkat sistem, antarmuka pengontrol tunggal Pathways yang lebih sederhana mengabstraksi kompleksitas pelatihan multislice, yang merupakan penyederhanaan signifikan bagi peneliti.
- Direkayasa untuk ketahanan skala hero: Stack JAX dirancang untuk pelatihan skala ekstrem. Orbax menyediakan fitur "ketahanan pelatihan skala besar" seperti checkpointing darurat dan multi-tingkat. Hal ini dilengkapi dengan Grain, yang menawarkan dukungan penuh untuk reproduksibilitas dengan pengacakan global deterministik dan loader data yang dapat di-checkpoint. Kemampuan untuk melakukan checkpoint status pipeline data (Grain) secara atomik dengan status model (Orbax) adalah kemampuan penting untuk menjamin reproduksibilitas dalam tugas yang berjalan lama.
- Ekosistem lengkap dan menyeluruh: Stack ini menyediakan solusi menyeluruh yang kohesif. Developer dapat menggunakan MaxText sebagai referensi SOTA untuk pelatihan, Tunix untuk penyelarasan, dan mengikuti jalur ganda yang jelas ke produksi dengan vLLM-JAX (untuk kompatibilitas vLLM) dan NSE (untuk performa JAX).
Meskipun banyak stack yang serupa dari sudut pandang software tingkat tinggi, faktor penentunya sering kali adalah Performa/TCO, yang merupakan keunggulan desain bersama JAX dan TPU. Manfaat Performa/TCO ini adalah hasil langsung dari integrasi vertikal di seluruh software dan hardware TPU. Kemampuan compiler XLA untuk menggabungkan operasi secara khusus untuk arsitektur TPU, atau profiler XProf untuk menggunakan hook hardware untuk pembuatan profil overhead <1%, adalah manfaat nyata dari integrasi mendalam ini.
Bagi organisasi yang mengadopsi stack ini, sifat JAX AI Stack yang berfitur lengkap meminimalkan biaya migrasi. Bagi pelanggan yang menggunakan arsitektur model terbuka yang populer, peralihan dari framework lain ke MaxText sering kali hanya memerlukan penyiapan file konfigurasi. Selain itu, kemampuan stack untuk menyerap format checkpoint populer seperti safetensors memungkinkan checkpoint yang ada dimigrasikan tanpa perlu pelatihan ulang yang mahal.
Tabel berikut memberikan pemetaan komponen yang disediakan oleh stack JAX AI dan padanannya dalam framework atau library lain.
| Fungsi | JAX | Alternatif/setara dalam framework lain5 |
| Compiler / runtime | XLA | Induktor, bersemangat |
| Pelatihan MultiPod | Pathways | Strategi Torch Lightning, Ray Train, Monarch (baru). |
| Framework inti | JAX | PyTorch |
| Pembuatan model | Model Flax, Max* | torch.nn.*,
NVidia TransformerEngine, HuggingFace Transformers
|
| Pengoptimal & loss | Optax | torch.optim.*, torch.nn.*Loss |
| Data Loader | Butiran | Ray Data, HuggingFace dataloaders |
| Checkpointing | Orbax | Checkpointing terdistribusi PyTorch, checkpointing NeMo |
| Kuantisasi | Qwix | TorchAO, bitsandbytes |
| Pembuatan kernel & implementasi umum | Pallas / Tokamax | Triton/Helion, Liger-kernel, TransformerEngine |
| Pasca-pelatihan / penyesuaian | Tunix | VERL, NeMoRL |
| Pembuatan profil | XProf | PyTorch profiler, NSight systems, NSight Compute |
| Pelatihan model dasar | MaxText, MaxDiffusion | NeMo-Megatron, DeepSpeed, TorchTitan |
| Inferensi LLM | vLLM | SGLang |
| Inferensi Non-LLM | NSE | Triton Inference Server, RayServe |
5Beberapa padanan di sini tidak selalu merupakan perbandingan yang benar karena framework lain menarik batas API secara berbeda dibandingkan dengan JAX. Daftar padanan ini tidak lengkap dan ada library baru yang sering muncul.
Kesimpulan: Platform yang tahan lama dan siap produksi untuk masa depan AI
Data yang diberikan dalam tabel sebelumnya menggambarkan kesimpulan yang jelas - stack ini memiliki kekuatan dan kelemahan masing-masing di sejumlah kecil area, tetapi secara keseluruhan sangat mirip dari sudut pandang software. Kedua stack ini menyediakan solusi siap pakai untuk pra-pelatihan, adaptasi pasca-pelatihan, dan deployment model dasar.
JAX AI Stack menawarkan solusi yang menarik dan tangguh untuk melatih dan men-deploy model ML dalam skala apa pun. TPU v5e memanfaatkan integrasi vertikal yang mendalam di seluruh software dan hardware TPU untuk memberikan performa dan total biaya kepemilikan yang terdepan di kelasnya.
Dengan memanfaatkan sistem internal yang telah teruji, stack ini telah berkembang untuk memberikan keandalan dan skalabilitas yang melekat, sehingga pengguna dapat mengembangkan dan men-deploy model terbesar sekalipun dengan percaya diri. Desainnya yang modular dan dapat dikomposisi, yang berakar pada filosofi stack JAX AI, memberi pengguna kebebasan dan kontrol yang tak tertandingi, sehingga mereka dapat menyesuaikan stack dengan kebutuhan spesifik mereka tanpa batasan framework monolitik.
Dengan XLA dan Pathways yang menyediakan basis yang skalabel dan fault-tolerant, JAX yang menyediakan library numerik yang berperforma tinggi dan ekspresif, library pengembangan inti yang canggih seperti Flax, Optax, Grain, dan Orbax, alat performa tingkat lanjut seperti Pallas, Tokamax, dan Qwix, serta lapisan aplikasi dan produksi yang tangguh di MaxText, vLLM, dan NSE, stack AI JAX menyediakan fondasi yang tahan lama bagi pengguna untuk membangun dan dengan cepat menghadirkan riset canggih ke produksi.