


使用 JAX 在 Cloud TPU 上建構正式環境 AI
JAX AI Stack 擴充 JAX 數值核心,加入一系列 Google 支援的可組合程式庫,演變成強大的端對端開放原始碼平台,適用於極大規模的機器學習。因此,JAX AI Stack 包含完善且強大的生態系統,可涵蓋整個機器學習生命週期:
工業級基礎:JAX AI Stack 專為大規模運算設計,運用 ML Pathways 協調數萬個晶片的訓練作業,並透過 Orbax 進行彈性、高處理量的非同步檢查點設定,實現最先進模型的正式環境級訓練。
完整、可用於正式環境的工具包:JAX AI Stack 提供一組完整的程式庫,涵蓋整個開發流程:Flax 可彈性編寫模型、Optax 可組合最佳化策略,Grain 則可提供確定性資料管道,這對可重現的大規模執行作業至關重要。
頂尖的專業效能:為充分利用硬體,JAX AI Stack 提供多個專用程式庫,包括用於先進自訂核心的 Tokamax、用於非侵入式量化以提升訓練和推論速度的 Qwix,以及用於深度硬體整合效能剖析的 XProf。
完整的正式環境路徑:JAX AI Stack 可讓您順暢地從研究階段轉換至部署階段。包括 MaxText (可擴充的基礎模型訓練參考資料)、Tunix (用於先進的強化學習 (RL) 和對齊),以及 vLLM-JAX 和 JAX 服務執行階段的統一推論解決方案。
JAX AI Stack 的理念是採用鬆耦合元件,每個元件都能妥善執行一項工作。JAX 本身並非單一機器學習框架,而是範圍狹窄,著重於高效陣列運算和程式轉換。這個生態系統以核心架構為基礎,提供多種功能,包括訓練機器學習模型,以及科學運算等其他類型的工作負載。
這個鬆耦合的元件系統可讓您以最符合需求的方式選取及組合程式庫。從軟體工程的角度來看,這種架構還能讓您反覆更新傳統上視為核心架構元件的功能 (例如資料管道和檢查點),而不會有核心架構不穩定的風險,也不會受限於發布週期。由於大多數功能都是在程式庫中實作,而非變更單一架構,因此核心數字程式庫更耐用,且能因應未來技術環境的變化。
以下各節將提供 JAX AI Stack 的技術總覽、主要功能、背後的設計決策,以及如何結合這些功能,建構出適用於現代機器學習工作負載的耐用平台。
JAX AI Stack 和其他生態系統元件
| Component | 函式 / 說明 |
|---|---|
| JAX AI Stack 核心和元件1 | |
| JAX | 加速器導向的陣列運算和程式轉換 (JIT、grad、vmap、pmap)。 |
| Flax | 靈活的類神經網路編寫程式庫,可直覺地建立及修改模型。 |
| Optax | 可組合的梯度處理和最佳化轉換程式庫。 |
| Orbax | 「任何規模」的分散式檢查點程式庫,可提供英雄級訓練韌性。 |
| 穀物 | 可擴充、確定性且可檢查點的輸入資料管道程式庫。 |
| JAX AI Stack - 基礎架構 | |
| XLA | 適用於 TPU、CPU 和 GPU 的開放原始碼機器學習編譯器。 |
| Pathways | 分散式執行階段,可跨數萬個晶片自動化調度管理運算作業。 |
| JAX AI Stack - 進階開發 | |
| Pallas | JAX 擴充功能,用於編寫以 Python 實作的低階高效能自訂核心。 |
| Tokamax | 精選最先進的高效能自訂核心 (例如 Attention)。 |
| Qwix | 全方位的非侵入式量化程式庫 (PTQ、QAT、QLoRA)。 |
| JAX AI Stack - 應用程式 | |
| MaxText / MaxDiffusion | 旗艦級、可擴充的參考架構,用於訓練基礎模型 (例如 LLM 和擴散模型)。 |
| Tunix | 用於最先進後訓練和對齊 (RLHF、DPO) 的架構。 |
| vLLM-JAX | 高效能 LLM 推論解決方案,內建整合 vLLM 架構。 |
| XProf | 與硬體深度整合的分析器,可分析整個系統的效能。 |
1 包含在 jax-ai-stack Python 套件中。
圖 1:JAX AI Stack 和生態系統元件
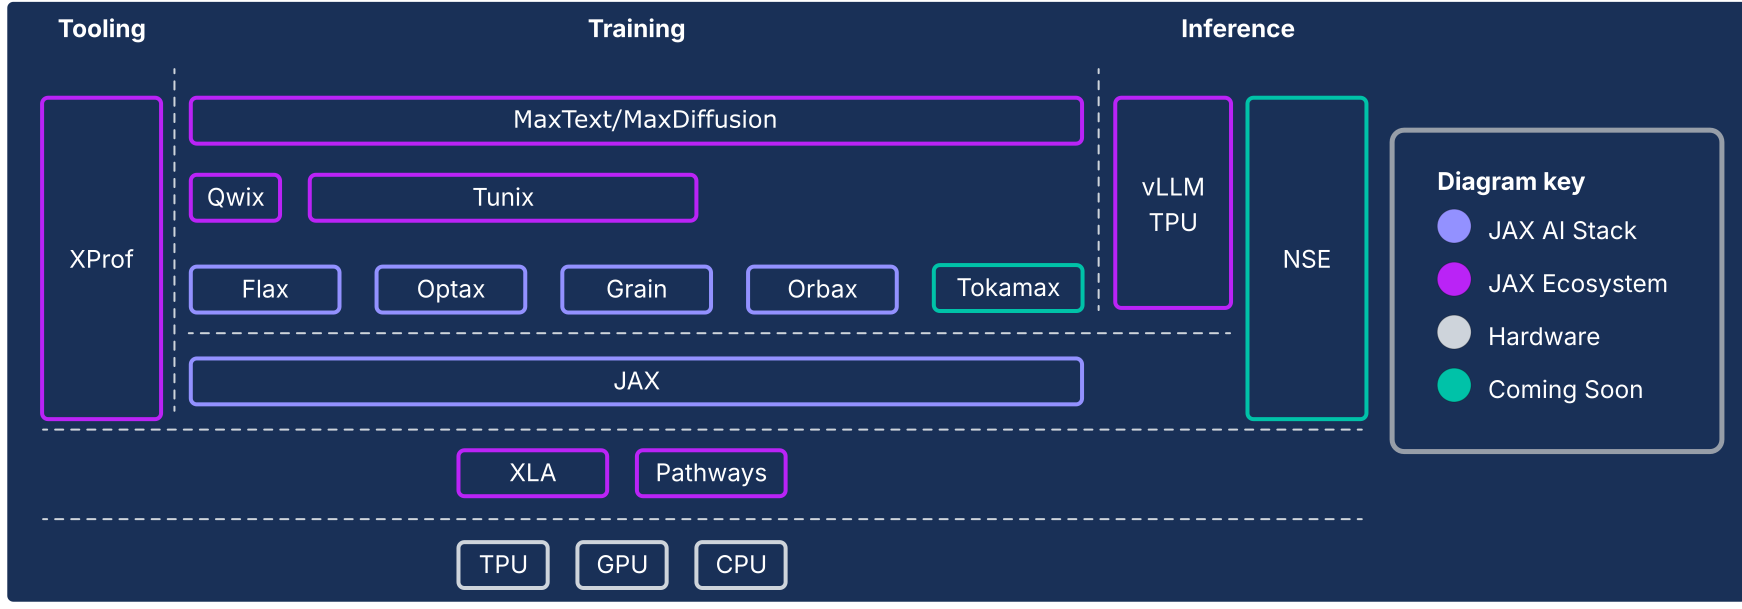
架構關鍵:超越框架的效能
隨著模型架構趨於一致 (例如多模態混合專家 (MoE) Transformer),為了追求極致效能,Megakernel 應運而生。Megakernel 實際上是特定模型的整個正向傳遞 (或大部分),使用較低階的 API (例如 NVIDIA GPU 上的 CUDA SDK) 手動編碼。這種做法會積極重疊運算、記憶體和通訊,盡可能提高硬體使用率。研究社群近期的研究顯示,這種方法可大幅提升 GPU 推論的處理量,在某些情況下甚至超過 22%。這種趨勢不限於推論,有證據顯示,部分大規模訓練工作涉及低階硬體控制,以大幅提升效率。
如果這個趨勢加速,目前所有高階架構都有可能變得不那麼重要,因為在成熟、穩定的架構上,低階硬體存取權才是影響效能的關鍵。這對所有現代機器學習堆疊來說都是一項挑戰:如何在不犧牲高階架構的效率和彈性的情況下,提供專家級的硬體控制。
為了讓 TPU 能夠提供這種效能,生態系統必須提供更接近硬體的 API 層,以便開發這些高度專業化的核心。JAX 堆疊旨在解決這個問題,提供連續的抽象層 (見圖 2),從 XLA 編譯器的自動化高階最佳化,到 Pallas 核心編寫程式庫的精細手動控制。
圖 2:JAX 抽象化連續體
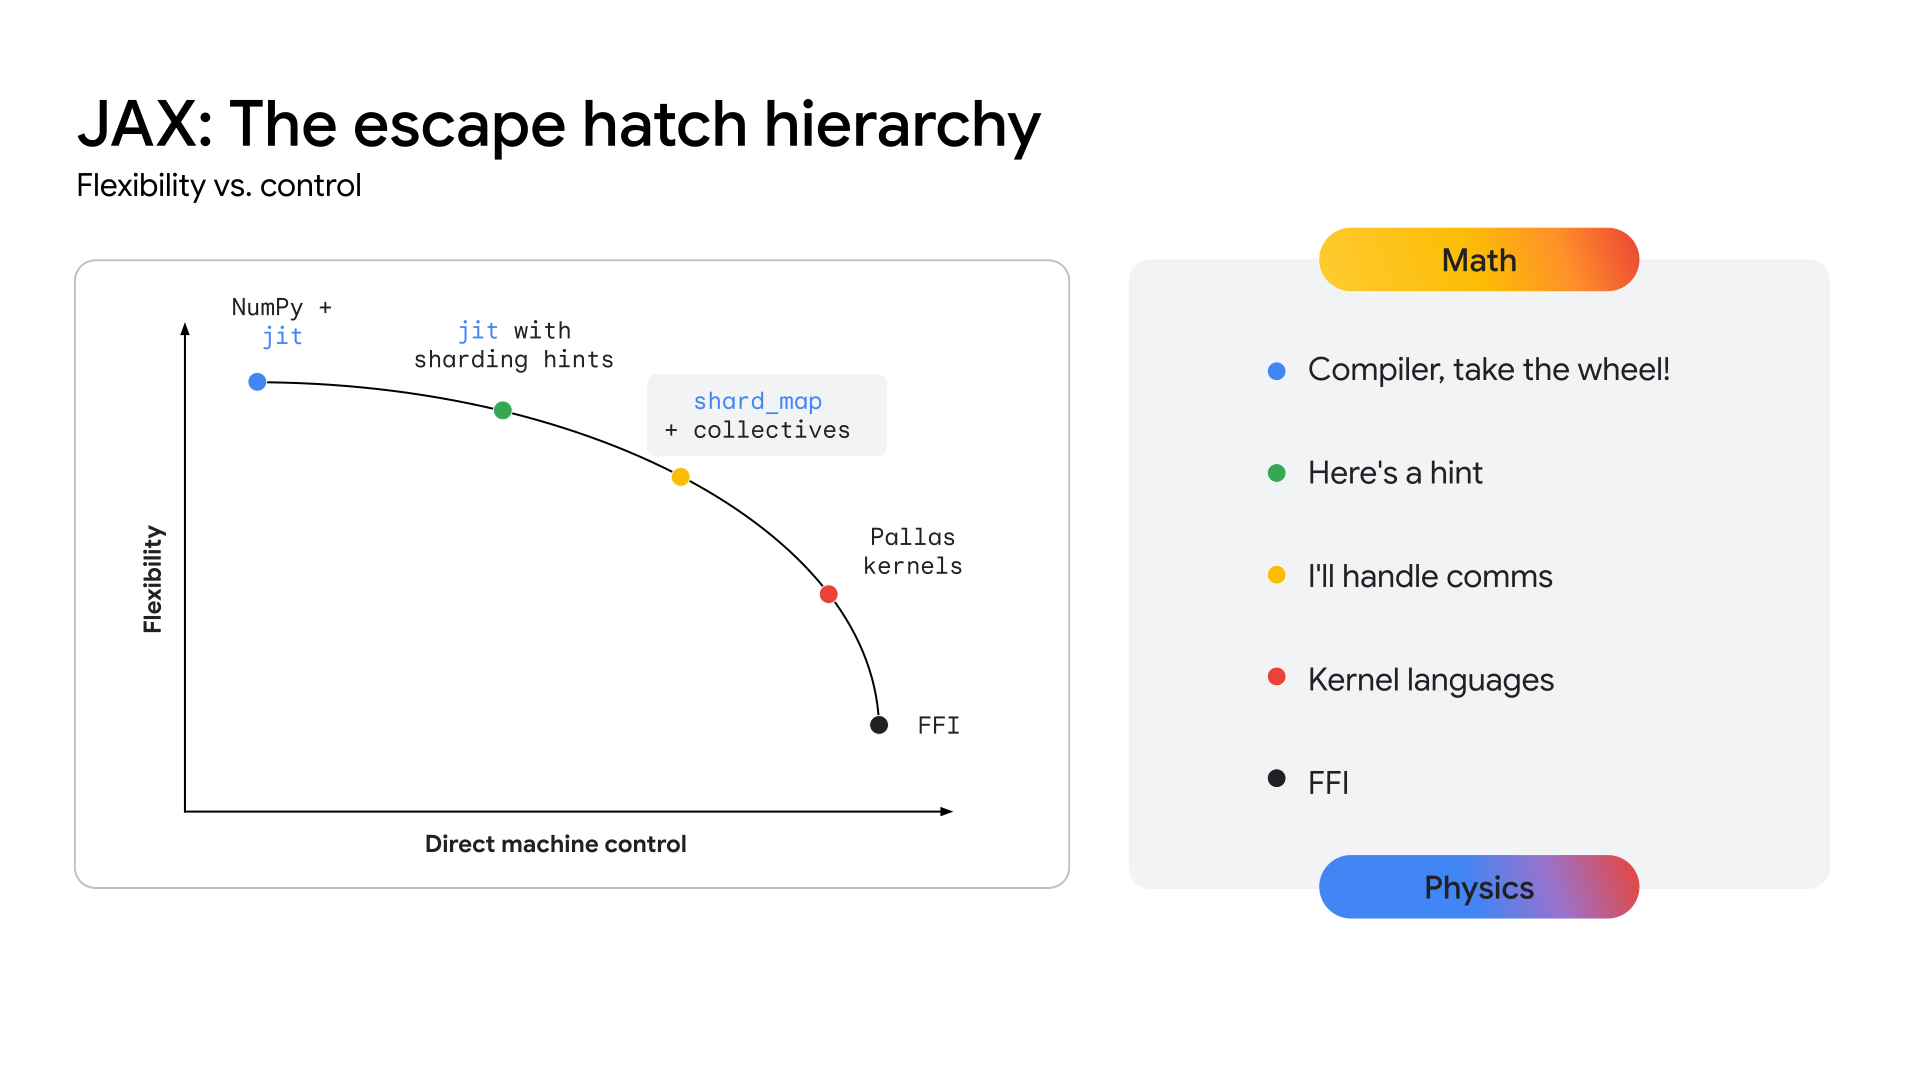
核心 JAX AI Stack
核心 JAX AI Stack 包含五個重要程式庫,為模型開發奠定基礎:
JAX:可組合的高效能程式轉換基礎
JAX 是 Python 程式庫,用於加速器導向的陣列運算和程式轉換,專為高效能數值運算和大規模機器學習而設計。JAX 採用函式程式設計模型和類似 NumPy 的 API,為高階程式庫奠定穩固基礎。
JAX 採用編譯器優先設計,本質上會運用 XLA (請參閱 XLA 區段) 進行積極的全程式分析、最佳化和硬體指定,藉此提升擴充性。JAX 強調函式程式設計 (例如純函式),因此其核心程式轉換更易於處理,且更重要的是,可組合。
您可以混合搭配這些核心轉換,在各種模型大小、叢集大小和硬體類型中,實現高效能和工作負載擴充:
- jit:將 Python 函式即時編譯為最佳化的融合 XLA 執行檔。
- grad:自動微分,支援正向和反向模式,以及高階導數。
- vmap:自動向量化,可順暢批次處理及平行處理資料,不需修改函式邏輯。
- pmap / shard_map:在多部裝置 (例如 TPU 核心) 上自動平行化,構成分散式訓練的基礎。
JAX 與 XLA 的 GSPMD (一般用途 SPMD) 模型完美整合,只需稍微修改程式碼,就能自動在大型 TPU Pod 之間平行處理運算。在大多數情況下,資源調度只需要高階資料分割註解。
Flax:彈性類神經網路編寫
Flax 提供直覺式的物件導向模型建構方法,簡化 JAX 中類神經網路的建立、偵錯和分析作業。雖然 JAX 的函式 API 功能強大,但對於習慣 PyTorch 等框架的開發人員來說,提供更熟悉的層級抽象化,且不會影響效能。
這種設計可簡化修改或結合訓練模型元件的作業。LoRA 和量化等技術需要可操控的模型定義,Flax 的 NNX API 透過 Pythonic 介面提供這項功能。NNX 會封裝模型狀態,減輕使用者認知負荷,並允許以程式輔助方式遍歷及修改模型階層。
主要優點:
- 直覺式物件導向 API:簡化模型建構作業,並支援子模組替換和部分初始化等進階用途。
- 與 Core JAX 一致:Flax 提供與 JAX 函式範式完全相容的提升轉換,在提供 JAX 完整效能的同時,也提升開發人員的友善度。
Optax:可組合的梯度處理和最佳化策略
Optax 是 JAX 的梯度處理和最佳化程式庫。這項服務旨在為模型建構人員提供構成要素,讓他們能以自訂方式重新組合,以便訓練深度學習模型和其他應用程式。它以核心 JAX 程式庫的功能為基礎,提供經過充分測試的高效能損失和最佳化工具函式程式庫,以及可用於訓練機器學習模型的相關技術。
動機
計算及盡可能減少損失,是訓練機器學習模型的核心。核心 JAX 程式庫支援自動微分,可提供訓練模型所需的數值功能,但未提供熱門最佳化工具 (例如 RMSProp 或 Adam) 或損失 (例如 CrossEntropy 或 MSE) 的標準實作。雖然您可以實作這些函式 (部分進階開發人員會選擇這麼做),但最佳化工具實作中的錯誤會導致難以診斷的模型品質問題。Optax 提供這些演算法的實作,並經過正確性和效能測試,使用者不必自行實作這些重要部分。
最佳化理論領域完全屬於研究範疇,但其在訓練中的核心角色,也使其成為訓練正式環境機器學習模型不可或缺的一部分。扮演這個角色的程式庫必須具備足夠的彈性,才能因應快速的研究疊代,同時也必須具備足夠的穩定性和效能,才能可靠地用於正式環境模型訓練。此外,也應提供經過充分測試、符合標準方程式的先進演算法實作。Optax 程式庫採用模組化可組合架構,並強調正確可讀的程式碼,旨在達成這個目標。
設計
Optax 旨在提升研究速度,並透過提供可讀、經過充分測試且有效率的核心演算法實作,促進從研究到實際應用的轉換。Optax 的用途不限於深度學習,但在這個情境中,Optax 可視為一系列知名的損失函式、最佳化演算法和梯度轉換,並以符合 JAX 理念的純函式方式實作。使用者可以輕鬆自信地開始使用一系列知名的損失和最佳化工具。
Optax 採用模組化方法,可讓您鏈結多個最佳化工具,接著進行其他常見的轉換 (例如梯度限幅),並使用 MultiStep 或 Lookahead 等常見技術包裝這些工具,只要幾行程式碼就能實現強大的最佳化策略。靈活的介面可讓您研究新的最佳化演算法,並使用強大的二階最佳化技術,例如 Shampoo 或 Muon。
# Optax implementation of a RMSProp optimizer with a custom learning rate
#  schedule, gradient clipping and gradient accumulation.
optimizer = optax.chain(
  optax.clip_by_global_norm(GRADIENT_CLIP_VALUE),
  optax.rmsprop(learning_rate=optax.cosine_decay_schedule(init_value=lr,decay_steps=decay)),
  optax.apply_every(k=ACCUMULATION_STEPS)
)

# The same thing, in PyTorch
optimizer = optim.RMSprop(model_params, lr=LEARNING_RATE)
scheduler = optim.lr_scheduler.CosineAnnealingLR(optimizer, T_max=TOTAL_STEPS)
for i, (inputs, targets) in enumerate(data_loader):
    # ... Training loop body ...
    if (i + 1) % ACCUMULATION_STEPS == 0:
        torch.nn.utils.clip_grad_norm_(model.parameters(), GRADIENT_CLIP_VALUE)
        optimizer.step()
        scheduler.step()
 optimizer.zero_grad()
上述程式碼片段說明如何設定最佳化工具,並自訂學習率、梯度限幅和梯度累積。
主要優點
- 強大的程式庫:提供完整的損失、最佳化工具和演算法程式庫,著重於正確性和可讀性。
- 模組化可鏈結轉換:這個彈性的 API 可讓您以宣告方式,制定強大、複雜的最佳化策略,而不必修改訓練迴圈。
- 功能強大且可擴充:純功能實作可與 JAX 的平行處理機制 (例如 pmap) 完美整合,讓您使用相同的程式碼,從單一主機擴充至大型叢集。
Orbax / TensorStore - 大規模分散式查核點
Orbax 是 JAX 的檢查點程式庫,適用於各種規模,從單一裝置到大規模分散式訓練皆可。這項計畫旨在整合分散的查核點實作,並向更多使用者提供重要的效能功能,例如非同步和多層級查核點。Orbax 可提供大規模訓練工作所需的彈性,並提供靈活的檢查點發布格式。
一般檢查點和還原系統會擷取整個系統狀態的快照,但 Orbax 的機器學習檢查點功能只會選擇性保留恢復訓練模型權重、最佳化工具狀態和資料載入器狀態所需的資訊。這種做法可盡量縮短加速器停機時間。Orbax 透過將 I/O 作業與運算重疊來達成此目的,這對大型工作負載來說是關鍵功能。加速器閒置時間縮短為裝置到主機資料移轉的時間長度,這段時間可進一步與下一個訓練步驟重疊,因此從效能角度來看,設定查核點幾乎不會造成影響。
Orbax 的核心是使用 TensorStore,以平行方式有效率地讀取及寫入陣列資料。Orbax API 簡化了這項複雜作業,提供容易使用的介面來處理 PyTrees,這是 JAX 中模型的標準表示法。
主要優點:
- 廣泛採用:Orbax 每月下載量達數百萬次,是分享機器學習構件的常用媒介。
- 簡化複雜作業:Orbax 會抽象化分散式檢查點的複雜作業,包括非同步儲存、原子性和檔案系統詳細資料。
- 彈性:Orbax 提供適用於常見用途的 API,同時可讓您自訂工作流程,處理特殊需求。
- 高效能與可擴充性:Orbax 具備非同步檢查點、高效率儲存格式 (OCDBT) 和智慧型資料載入策略等功能,可擴充至涉及數萬個節點的訓練執行作業。
Grain:確定性且可擴充的輸入資料管道
Grain 是 Python 程式庫,用於讀取及處理資料,以便訓練和評估 JAX 模型。這項服務靈活、快速且具確定性,並支援檢查點等進階功能,是成功訓練大型工作負載的關鍵。支援常見的資料格式和儲存空間後端,並提供彈性的 API,可擴充支援使用者特定格式和後端,這些格式和後端並非原生支援。雖然 Grain 主要是與 JAX 搭配使用,但它與架構無關,不需要 JAX 即可執行,也可以與其他架構搭配使用。
動機
資料管道是訓練基礎架構的重要部分,必須具備彈性,才能有效率地表達常見的轉換,並具備足夠的效能,讓加速器隨時保持忙碌。此外,也必須能容納多種儲存格式和後端。由於步驟時間較長,大規模訓練大型模型時,資料管道除了要滿足一般訓練工作負載的需求外,還須符合其他要求,主要著重於確定性和重現性2。Grain 程式庫採用彈性架構,可滿足這些需求。
2 在 PaLM 論文的第 5.1 節中,作者指出,儘管啟用了梯度限幅,他們仍觀察到非常大的損失尖峰。解決方法是移除有問題的資料批次,並從損失值激增前的檢查點重新開始訓練。只有在訓練設定完全確定且可重現時,才能做到這一點。
設計
從最高層級來看,輸入管道的結構有兩種,一種是將資料 worker 設為獨立叢集,另一種則是將資料 worker 與驅動加速器的主機放在同一位置。Grain 選擇後者的原因有很多。
加速器會與強大的主機結合,這些主機通常在訓練步驟中處於閒置狀態,因此很適合用來執行輸入資料管道。這種實作方式還有其他優點,可提供一致的輸入和運算資料分割檢視,簡化資料分割檢視。有人可能會認為,將資料工作站放在加速器主機上,可能會導致主機 CPU 飽和,但這並不妨礙使用 RPC 將運算密集型轉換卸載至其他叢集3。
在 API 方面,Grain 採用純 Python 實作,支援多個程序和彈性 API,可讓您根據容易理解的轉換範式,將管道階段組合在一起,實作任意複雜的資料轉換。
Grain 支援 ArrayRecord 和 Bagz 等高效隨機存取資料格式,以及 Parquet 和 TFDS 等其他熱門資料格式。Grain 支援從本機檔案系統讀取,也支援預設從 Cloud Storage 讀取。除了支援常見的儲存格式和後端,儲存層的簡潔抽象化功能還可讓您新增支援或包裝現有資料來源,以便與 Grain 程式庫相容。
3這就是多模態資料管道的運作方式,例如圖片和音訊權杖化工具本身就是模型,在自己的叢集和加速器上執行,而輸入管道會發出 RPC 呼叫,將資料樣本轉換為權杖串流。
主要優點
- 確定性資料饋送:將資料 worker 與加速器放在同一位置,並與穩定的全域隨機排序和可檢查點疊代器結合,即可使用 Orbax 在一致的快照中,同時檢查模型狀態和資料管道狀態,提高訓練程序的確定性。
- 靈活的 API 可實現強大的資料轉換:靈活、純 Python 的轉換 API 可讓您在輸入處理管道中執行廣泛的資料轉換。
- 可擴充支援多種格式和後端:可擴充的資料來源 API 支援熱門儲存格式和後端,並可讓您新增對新格式和後端的支援。
- 強大的偵錯介面:資料管道視覺化工具和偵錯模式可讓您檢查、偵錯及最佳化資料管道的效能。
擴充 JAX AI Stack
除了核心堆疊外,還有豐富的專業程式庫生態系統,提供端對端機器學習開發所需的基礎架構、進階工具和應用程式層解決方案。
基礎架構:編譯器和執行階段
XLA:不限硬體、以編譯器為主的引擎
動機
XLA (Accelerated Linear Algebra) 是 Google 的特定領域編譯器,與 JAX 深度整合,並支援 TPU、CPU 和 GPU 硬體裝置。XLA 旨在成為獨立於硬體的程式碼產生器,適用於 TPU、GPU 和 CPU。
XLA 編譯器採用編譯器優先設計,這項基本架構選擇可在快速發展的研究領域中,創造持久優勢。相較之下,其他生態系統中盛行的核心中心方法,則仰賴手動最佳化的程式庫來提升效能。雖然這種做法對於穩定、成熟的模型架構非常有效,但會造成創新瓶頸。當新研究推出新架構時,生態系統必須等待新核心編寫及最佳化。不過,我們以編譯器為主的設計通常可以推廣至新模式,從一開始就為尖端研究提供高效能路徑。
設計
XLA 的運作方式是即時 (JIT) 編譯 JAX 在追蹤程序中產生的計算圖 (例如,當函式以 @jax.jit 裝飾時)。
編譯作業會依循多級式管道:
- JAX 運算圖
- 高階最佳化工具 (HLO)
- 低階最佳化工具 (LLO)
- 硬體代碼
- 從 JAX 圖到 HLO:JAX 運算圖會轉換為 XLA 的 HLO 表示法。在這個高階層級,系統會套用強大的硬體無關最佳化功能,例如運算子融合和高效記憶體管理。StableHLO 方言是這個階段的持久、版本化介面。
- 從 HLO 到 LLO:高階最佳化後,硬體專屬後端會接管,將 HLO 表示法降低為機器導向的 LLO。
- 從 LLO 到硬體程式碼:LLO 最終會編譯成高效率的機器碼。如果是 TPU,這組程式碼會組合成超長指令字 (VLIW) 封包,直接傳送至硬體。
在資源調度方面,XLA 的設計以平行處理為核心。它採用演算法,盡可能使用晶片上的矩陣乘法單元 (MXU)。在晶片之間,XLA 使用 SPMD (單一程式多重資料),這是一種以編譯器為基礎的平行處理技術,可在所有裝置上使用單一程式。這個強大的模型透過 JAX API 公開,可讓您使用高階 sharding 註解,管理資料、模型或管道平行處理。
如需更複雜的平行處理模式,也可以使用多程式多資料 (MPMD),而 PartIR:MPMD 等程式庫也允許 JAX 使用者提供 MPMD 註解。
主要優點
- 編譯:即時編譯運算圖,可最佳化記憶體配置、緩衝區分配和記憶體管理。其他替代方案 (例如以核心為基礎的方法) 則會將這項負擔轉嫁給開發人員。在多數情況下,XLA 都能達到優異效能,且不會影響開發速度。
- 平行處理:XLA 透過 SPMD 實作多種形式的平行處理,並在 JAX 層級公開。這可讓您表達 sharding 策略,在數千個晶片上實驗及擴充模型。
Pathways:大規模分散式運算的統一執行階段
Pathways 提供分散式訓練和推論的抽象化功能,並內建容錯和復原功能,讓機器學習研究人員能像使用單一強大機器一樣編寫程式碼。
動機
如要訓練及部署大型模型,必須使用數百到數千個晶片。這些晶片分布在多個機架和主機上。訓練工作是大型同步程式,需要所有這些晶片及其各自的主機,在已平行化 (分 shard) 的 XLA 運算上協同運作。如果是大型語言模型,可能需要超過數萬個晶片,因此這項服務除了在 Pod 內使用晶片間互連 (ICI) 和晶片內互連 (OCI) 結構外,還必須能跨資料中心結構橫跨多個 Pod。
設計
ML Pathways 是我們用來協調主機和 TPU 晶片之間分散式運算的系統。這項技術專為擴充性和效率而設計,可橫跨數十萬個加速器。針對大規模訓練,它提供單一 Python 用戶端,可處理多個 Pod 工作、Megascale XLA 整合、編譯服務和遠端 Python。此外,這項功能也支援跨切片平行處理和先占容許度,可在資源先占後自動復原。
Pathways 整合了最佳化的跨主機集合,可讓 XLA 運算圖延伸至單一 TPU Pod 之外。這項技術整合了分散式執行階段,可透過 XLA 通訊原始碼管理 DCN 通訊,進而擴充 XLA 對資料、模型和管道平行處理的支援,使用資料中心網路 (DCN) 跨越 TPU 切片邊界。
主要優點
單一控制器架構與 JAX 整合,是重要的抽象概念。研究人員可以探索各種 sharding 和平行處理策略,用於訓練和部署作業,同時輕鬆擴充至數萬個晶片。
進階開發:效能、資料和效率
Pallas:在 JAX 中編寫高效能自訂核心
雖然 JAX 是編譯器優先,但在某些情況下,您可能需要精細控管硬體,才能達到最高效能。Pallas 是 JAX 的擴充功能,可為 GPU 和 TPU 編寫自訂核心。這項工具旨在精確控管生成的程式碼,並結合 JAX 追蹤和 jax.numpy API 的高階人體工學設計。
Pallas 採用網格平行處理模型,使用者定義的核心函式會在多維度網格的平行工作群組中啟動。您可以定義張量的分塊方式,以及在較慢、較大的記憶體 (例如 HBM) 和較快、較小的晶片上記憶體 (例如 TPU 上的 VMEM、GPU 上的共用記憶體) 之間轉移的方式,並使用索引對應將網格位置與特定資料區塊建立關聯,明確管理記憶體階層。Pallas 可將相同的核心定義降低,以便在 Google 的 TPU 和各種 GPU 上有效率地執行,方法是將核心編譯成適合目標架構的中繼表示法,例如 TPU 的 Mosaic,或使用 Triton 等技術處理 GPU。有了 Pallas,您就能編寫高效能核心,專門處理注意力機制等區塊,在目標硬體上達到最佳模型效能,不必依賴特定供應商的工具包。
Tokamax:精選先進核心程式庫
如果 Pallas 是編寫核心的工具,Tokamax 就是最先進的自訂加速器核心程式庫,同時支援 TPU 和 GPU。Tokamax 是以 JAX 和 Pallas 為基礎建構而成,可讓您充分發揮硬體效能。此外,也提供建構及自動調整自訂核心的工具。
動機
JAX 源自 XLA,是編譯器優先的架構,但在少數情況下,您可能需要直接控制硬體,才能達到最高效能4。如要充分發揮 TPU 和 GPU 等昂貴機器學習加速器資源的效能,自訂核心至關重要。雖然這些核心廣泛用於執行 Attention 等重要運算子,但實作時需要深入瞭解模型和目標硬體架構。Tokamax 提供單一權威來源,內含精心挑選、經過充分測試的高效能核心,並搭配強大的共用基礎架構,用於開發、維護及管理生命週期。這類程式庫也可做為參考實作,供您視需要建構及自訂。這樣一來,您就能專注於建模工作,不必擔心基礎架構。
4這是一種成熟的模式,在 CPU 領域已有先例,其中編譯的程式碼構成程式的大部分,開發人員會降到內建函式或內嵌組合,以最佳化效能關鍵部分。
設計
Tokamax 為任何核心提供通用 API,可由多個實作項目支援。舉例來說,TPU 核心可透過標準 XLA 降級實作,或明確使用 Pallas/Mosaic-TPU 實作。GPU 核心可透過標準 XLA 降級、Mosaic-GPU 或 Triton 實作。根據預設,Tokamax API 會根據定期自動調整和基準測試執行的快取結果,為特定設定選擇最合適的實作方式,但您也可以視需要選擇特定實作方式。我們可能會陸續新增實作項目,以便充分運用新一代硬體的特定功能,進一步提升效能。
除了核心本身,Tokamax 程式庫的重要元件還包括支援基礎架構,可讓您編寫自訂核心。舉例來說,自動調整基礎架構可讓您定義一組可設定的參數 (例如圖塊大小),Tokamax 可對這些參數執行詳盡掃描,以判斷並快取最佳調整設定。夜間迴歸測試可避免因基礎編譯器基礎架構或其他依附元件變更,而導致非預期的效能和數值問題。
主要優點
- 流暢的開發人員體驗:統一、精選的程式庫提供已知良好、高效能的重要核心實作,並在程式和說明文件中清楚說明支援的硬體世代和預期效能。這可盡量減少分散和流失。
- 彈性和生命週期管理:您可以選擇不同的實作方式,甚至在適當情況下隨時間變更。舉例來說,如果 XLA 編譯器強化對特定作業的支援,不再需要自訂核心,則會提供淘汰和遷移路徑。
- 擴充性:您可以實作自己的核心,同時運用支援良好的共用基礎架構,專注於加值功能和最佳化。標準實作方式的編寫方式清楚明瞭,可做為使用者學習和擴充的起點。
Qwix:非侵入式、全方位的量化
Qwix 是 JAX AI Stack 的全方位量化程式庫,支援 LLM 和其他模型類型,涵蓋所有階段,包括訓練 (量化感知訓練 (QAT)、量化技術 (QT)、量化低秩適應 (QLoRA)) 和推論後訓練量化 (PTQ),適用於 XLA 和裝置端執行階段。
動機
現有的量化程式庫 (尤其是 PyTorch 生態系統中的程式庫) 通常用途有限,例如僅限 PTQ 或 QLoRA。這種零散的環境迫使您切換工具,阻礙程式碼的一致使用,以及訓練和推論之間的精確數值比對。此外,許多解決方案需要大幅修改模型,將模型邏輯與量化邏輯緊密結合。
設計
Qwix 的設計理念著重於提供全方位解決方案,以及非侵入式模型整合。其架構採用階層式、可擴充的設計,以可重複使用的功能 API 為基礎。
這項非侵入式整合功能是透過精心設計的攔截機制實現,可將 JAX 函式重新導向至對應的量化函式。這樣一來,您就能整合模型,而不必進行任何修改,完全將量化程式碼與模型定義分離。
以下範例示範如何對 LLM 的 MLP 層套用 w4a4 (4 位元權重、4 位元活化) 量化,並對嵌入器套用 w8 (8 位元權重) 量化。如要變更量化配方,只需更新規則清單即可。
fp_model = ModelWithoutQuantization(...)
rules = [
    qwix.QuantizationRule(
        module_path=r'embedder',
        weight_qtype='int8',
    ),
    qwix.QuantizationRule(
        module_path=r'layers_\d+/mlp',
        weight_qtype='int4',
        act_qtype='int4',
        tile_size=128,
        weight_calibration_method='rms,7',
    ),
]
quantized_model = qwix.quantize_model(fp_model, qwix.PtqProvider(rules))
主要優點
- 全方位解決方案:Qwix 廣泛適用於多種量化情境,可確保訓練和推論之間的程式碼使用方式一致。
- 非侵入式模型整合:如範例所示,您只要一行程式碼就能整合模型。這樣一來,您就能在多種量化配置中使用超參數,找出品質與效能之間的最佳平衡點。
- 與其他程式庫聯合:Qwix 與 JAX AI Stack 完美整合。舉例來說,使用 Qwix 量化模型時,Tokamax 會自動調整,使用量化版本的核心,使用者不需額外編寫程式碼。
- 研究友善:Qwix 的基礎 API 和可擴充架構,讓研究人員能探索新演算法,並透過整合式基準和評估工具,輕鬆進行比較。
應用程式層:訓練和調整
基礎模型訓練:MaxText 和 MaxDiffusion
MaxText 和 MaxDiffusion 分別是 Google 的旗艦 LLM 和擴散模型訓練框架。這些存放區包含多種熱門開放權重模型的高度最佳化實作。這些範本有雙重用途:既是現成的模型訓練程式碼集,也是基礎模型建構工具可參考的基礎。
動機
業界對訓練生成式 AI 模型的興趣迅速增長。開放式模型的普及加速了這項趨勢,提供經過驗證的架構。訓練及調整這些模型時,需要高效能、高效率、可擴充至大量晶片,以及清晰易懂的程式碼。MaxText 和 MaxDiffusion 是全方位的解決方案,可在 TPU 或 GPU 上使用,專為滿足這些需求而設計。
設計
MaxText 和 MaxDiffusion 是基礎模型程式碼集,設計時考量了可讀性和效能。這些範本採用經過充分測試、可重複使用的元件,包括使用自訂核心 (例如 Tokamax) 的模型定義,可發揮最大效能;用於自動化調度管理和監控的訓練工具,以及強大的設定系統,可讓您透過直覺式介面控制分區和量化 (使用 Qwix) 等細節。此外,這項服務也整合了多層級檢查點等進階可靠性功能,確保持續提供良好的處理量。
MaxText 和 MaxDiffusion 採用頂尖的 JAX 程式庫 Qwix、Tunix、Orbax 和 Optax,提供核心功能。這些程式庫提供強大且可擴充的基礎架構,能減少開發負擔,讓您專注於建模工作。推論時,模型程式碼會共用,以提供高效且可擴充的服務。
主要優點
- 效能導向設計:訓練基礎架構可提供高「goodput」(實用處理量),模型實作則可提供高 MFU (模型浮點運算使用率),因此 MaxText 和 MaxDiffusion 可立即提供高效能的水平擴展。
- 專為擴充而設計:這些框架運用 JAX AI Stack (尤其是 Pathways) 的強大功能,可讓您順暢地從數十個晶片擴充至數萬個晶片。
- 基礎模型建構工具的穩固基礎:高品質、可讀性高的實作方式,是開發人員的穩固起點,可做為端對端解決方案,或做為自訂作業的參考實作。
訓練後和對齊:Tunix 架構
Tunix 提供先進的開放原始碼強化學習 (RL) 演算法,以及強大的架構和基礎架構,讓開發人員能以簡便的方式,實驗 LLM 後訓練技術,包括使用 JAX 和 TPU 進行監督式微調 (SFT) 和對齊。
動機
後訓練是發揮 LLM 真正實力的關鍵步驟。增強學習 (RL) 階段對於培養對齊和推論能力尤其重要。這個領域的開放原始碼開發幾乎完全以 PyTorch 和 GPU 為基礎,因此 JAX 和 TPU 解決方案存在根本差距。Tunix (Tune-in-JAX) 是高效能的 JAX 原生程式庫,專為填補這項落差而設計。
設計
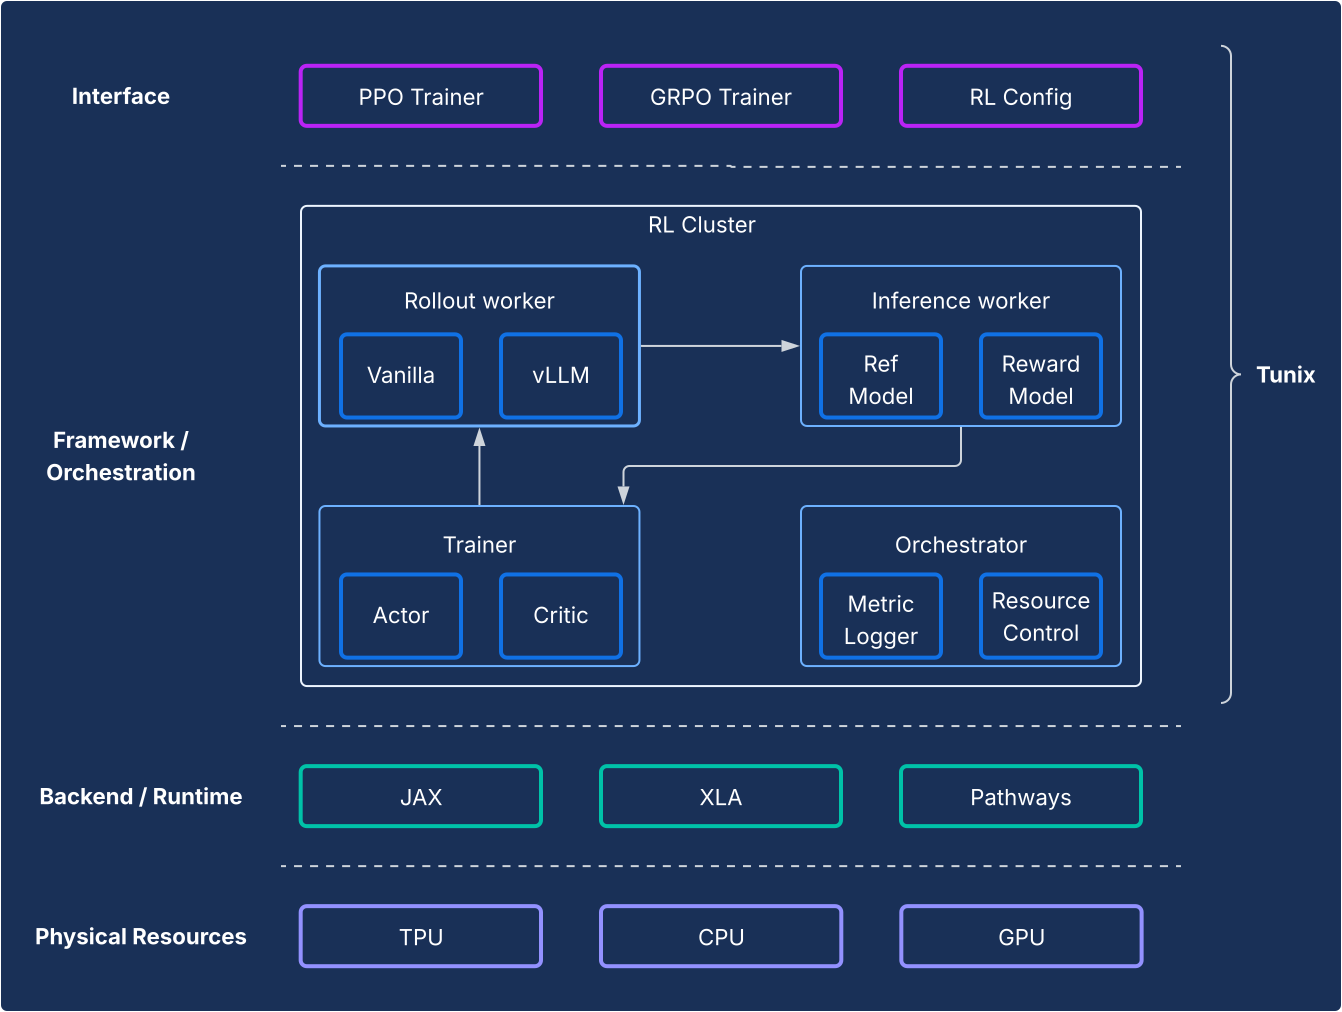
從框架的角度來看,Tunix 採用最先進的設定,明確區分強化學習演算法和基礎架構。它提供輕量、類似用戶端的 API,隱藏 RL 基礎架構的複雜性,讓您開發新演算法。Tunix 為熱門演算法提供立即可用的解決方案,包括近端策略最佳化 (PPO)、直接偏好最佳化 (DPO) 等。
在基礎架構方面,Tunix 與 Pathways 整合,可採用單一控制器架構,進行多節點強化學習訓練。在訓練方面,Tunix 原生支援參數效率訓練 (例如 LoRA),並運用 JAX 分區和 XLA (機器學習運算圖的一般和可擴充平行處理 (GSPMD)),產生高效能的運算圖。支援 Gemma 和 Llama 等熱門開放原始碼模型,開箱即用。
主要優點
- 簡單:提供高階、類似用戶端的 API,可簡化基礎分散式基礎架構的複雜性。
- 開發人員效率:Tunix 內建演算法和「配方」,可加快研發生命週期,提供可運作的模型,並讓您快速疊代。
- 效能和擴充性:Tunix 在後端採用 Pathways 做為單一控制器,可提供高效率且可水平擴充的訓練基礎架構。
應用程式層:生成與推論
過去採用 JAX 的難題在於從研究到實際應用的過程。JAX AI Stack 現在提供成熟的雙管齊下正式環境解決方案,兼顧生態系統相容性和 JAX 效能。
高效能 LLM 推論:vLLM-JAX 解決方案
vLLM-JAX 是 Google 的高效能推論後端,專為在 Cloud TPU 上有效率地執行 JAX 大型語言模型 (LLM) 而設計。這項解決方案整合了開放原始碼 vLLM 架構與 Google 的 JAX 和 TPU 生態系統,如要使用 vLLM 在 TPU 上提供 PyTorch 模型,請參閱「在 Cloud TPU 上執行 PyTorch」。
動機
這個產業正快速發展,對流暢、高效能且易於使用的推論解決方案需求日益增加。開發人員經常面臨重大挑戰,包括工具複雜且不一致、效能不佳,以及模型相容性有限。vLLM 堆疊提供整合、高效能且直覺的平台,可解決這些問題。
設計
這項解決方案擴充了 vLLM 框架,而非重新打造。vLLM-JAX 是經過高度最佳化的開放原始碼 LLM 服務引擎,以高處理量著稱,這得益於 PagedAttention (像虛擬記憶體一樣管理 KV 快取,盡可能減少片段) 和持續批次處理 (動態將要求新增至批次,提高使用率) 等關鍵功能。
vLLM-JAX 以此為基礎,開發處理要求、排程和記憶體管理的核心元件。這項功能導入以 JAX 為基礎的後端,做為橋梁將 vLLM 的運算圖和記憶體作業,轉譯為 TPU 可執行的程式碼。這個後端會處理裝置互動、JAX 模型執行,以及 TPU 硬體上 KV 快取管理的細節。這項架構整合了 TPU 專屬的最佳化功能,例如高效的注意力機制 (例如運用 JAX Pallas 核心進行 Ragged Paged Attention) 和量化,全都專為 TPU 架構量身打造。
主要優點
- 使用者無需支付導入/停用成本:使用者可以輕鬆採用這項解決方案。從使用者體驗的角度來看,在 TPU 上處理推論要求,應該與在 GPU 上處理相同。用於啟動伺服器、接受提示和傳回輸出的 CLI 都是共用的。
- 全面擁抱生態系統:這種做法會使用並貢獻 vLLM 介面和使用者體驗,確保相容性和易用性。
- TPU 和 GPU 互換性:這項解決方案在 TPU 和 GPU 上都能有效運作,提供彈性。
- 具成本效益 (最佳性價比):最佳化效能,為熱門模型提供最佳性價比。
JAX 服務:Orbax 序列化和 Neptune 服務引擎
如果是大型語言模型以外的模型,或使用者需要完全採用 JAX 原生管道,Orbax 序列化程式庫和 Neptune 服務引擎 (NSE) 系統可提供端對端的高效能服務解決方案。
動機
過去,JAX 模型通常需要透過迂迴的路徑才能進入正式環境,例如封裝在 TensorFlow 圖中,並使用 TensorFlow Serving 部署。這種做法會造成重大限制和效率不彰,迫使開發人員與獨立的生態系統互動,並減緩疊代速度。如要確保永續性、降低複雜度並最佳化效能,就必須使用專屬的 JAX 原生服務系統。
設計
這項解決方案包含兩個核心元件,如下圖所示。
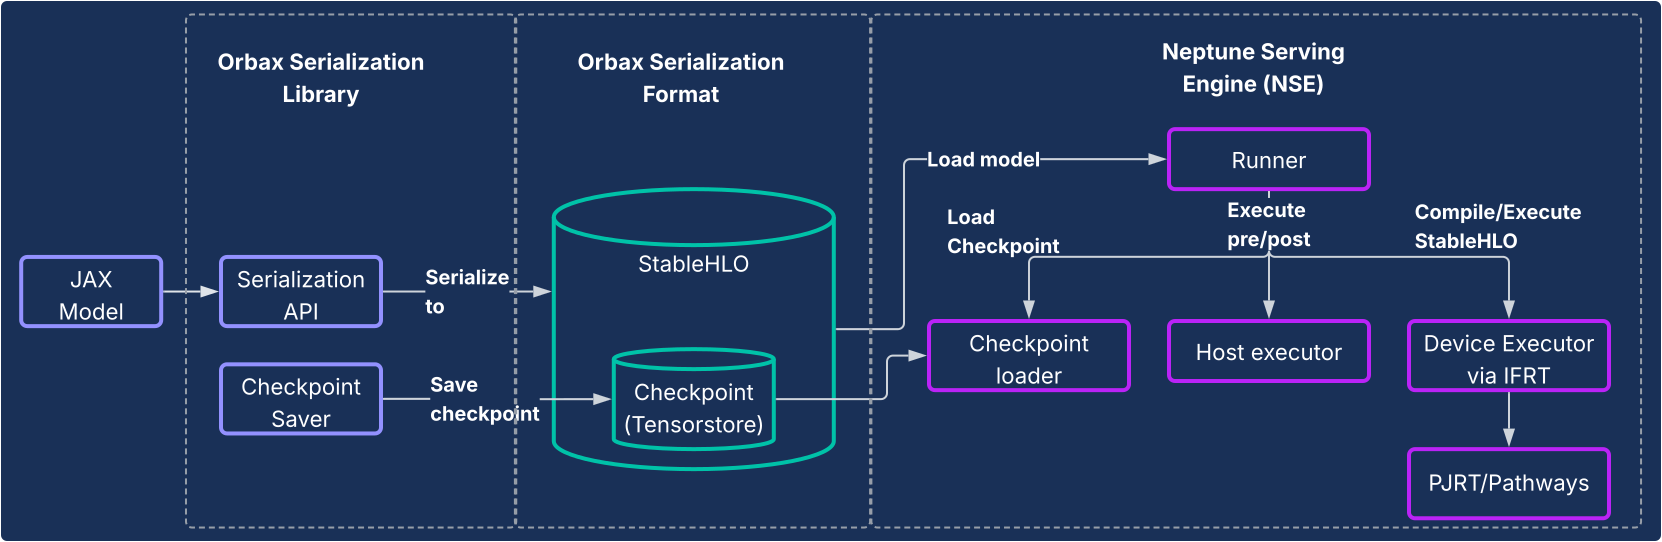
- Orbax 序列化程式庫:提供容易使用的 API,可將 JAX 模型序列化為全新、穩定的 Orbax 序列化格式。這個格式經過最佳化調整,適用於正式環境部署作業。它會使用 StableHLO 直接表示 JAX 模型運算,因此能以原生方式表示運算圖。此外,這項服務也運用 TensorStore 儲存權重,可快速載入查核點,以便提供服務。
- Neptune Serving Engine (NSE):這是隨附的高效能、彈性服務引擎 (通常部署為 C++ 二進位檔),專為以 Orbax 格式原生執行 JAX 模型而設計。NSE 提供正式環境必備的功能,例如快速載入模型、內建批次處理的高處理量並行服務、支援多個模型版本,以及單一和多主機服務 (運用 PJRT 和 Pathways)。Neptune Serving Engine 的用途:
- 非 LLM 模型:這是一般用途解決方案,適合推薦系統、擴散模型和其他 AI 模型等工作負載。
- 小型 LLM 和「一次性」服務:適用於非自迴歸模型或較小的模型,這些模型會以「一元」方式提供服務,整個輸出內容會在單一階段生成,不需要複雜的狀態管理 (例如 KV 快取)。
簡而言之,Neptune Serving Engine 填補了非大型自動迴歸語言模型的各種模型服務缺口,為更廣泛的機器學習生態系統提供高效能的 TPU 原生解決方案。
主要優點
- JAX 原生服務:這項解決方案專為 JAX 建構,可消除模型序列化和服務中的跨框架負擔。這可確保模型快速載入,並在 CPU、GPU 和 TPU 之間最佳化執行。
- 輕鬆部署至實際工作環境:序列化模型提供封閉式部署路徑,不受 Python 依附元件漂移影響,並可執行執行階段模型完整性檢查。這項功能可讓您順暢、直覺地將 JAX 模型投入實際工作環境。
- 提升開發人員體驗:這項解決方案可大幅減少依附元件和系統複雜度,JAX 開發人員不必再費心包裝架構,可加快疊代速度。
系統層級分析和剖析
XProf:深度整合硬體的效能剖析
XProf 是剖析和效能分析工具,可深入瞭解機器學習工作負載執行的各個層面,讓您偵錯及最佳化效能。與 JAX 和 TPU 生態系統深度整合。
動機
一方面,機器學習工作負載越來越複雜。另一方面,針對這些工作負載的專用硬體功能也大幅增加。機器學習基礎架構的成本高昂,因此必須有效搭配兩者,確保效能和效率達到最佳狀態。這需要深入瞭解工作負載和硬體,並以快速消耗的方式呈現。XProf 在這方面表現出色。
設計
XProf 包含兩個主要元件:收集和分析。
- 收集:XProf 會從各種來源擷取資訊,包括 JAX 程式碼中的註解、XLA 編譯器中作業的成本模型,以及 TPU 內建的專用硬體剖析功能。這項收集作業可透過程式輔助或隨選觸發,產生全面的事件構件。
- 分析:XProf 會後續處理收集到的資料,並建立一套強大的視覺化圖表,可透過瀏覽器存取。
主要優點
XProf 的真正優勢在於與完整堆疊深度整合,提供廣泛且深入的分析,這是共同設計的 JAX/TPU 生態系統帶來的實質效益。
- 與 TPU 共同設計:XProf 運用專為流暢收集設定檔而設計的硬體功能,將收集負擔降至 1%以下。這樣一來,剖析作業就能成為開發過程中輕量、反覆執行的部分。
- 分析廣度和深度:XProf 可從多個面向進行深入分析。其工具包括:
- 追蹤檢視器:在不同硬體單元 (例如 TensorCore) 上執行的作業時間軸檢視畫面。
- HLO Op Profile:將總耗時細分為不同類別的作業。
- 記憶體檢視器:詳細列出分析期間不同作業的記憶體配置。
- Roofline 分析:協助您判斷特定作業是否受限於運算或記憶體,以及與硬體效能上限的差距。
- 圖表檢視器:提供硬體執行的完整 HLO 圖表檢視畫面。
比較觀點:JAX/TPU 堆疊是極具吸引力的選擇
現代機器學習領域提供許多優秀、成熟的工具鍊。JAX AI Stack 採用模組化設計,並與硬體深度整合,因此能為專注於大規模、高效能機器學習的開發人員,提供獨特且具吸引力的優勢。
雖然許多架構都提供多種功能,但 JAX AI Stack 在開發生命週期的關鍵領域,提供具體且強大的差異化功能:
- 更簡單、更強大的開發人員體驗:Optax 的可鏈結梯度轉換範式可讓您宣告更強大、更靈活的最佳化策略,而不必在訓練迴圈中強制管理。在系統層級,Pathways 較簡單的單一控制器介面可簡化多配量訓練的複雜度,大幅減輕研究人員的負擔。
- 專為超大規模韌性設計:JAX 堆疊專為極大規模訓練設計。Orbax 提供「英雄級訓練彈性」功能,例如緊急和多層級檢查點。Grain 則提供完整支援,可透過確定性全域重組和可檢查點資料載入器,確保可重現性。以原子方式檢查資料管道狀態 (Grain) 和模型狀態 (Orbax) 的能力,是確保長時間執行工作可重現的關鍵功能。
- 完整的端對端生態系統:這個堆疊提供完善的端對端解決方案。開發人員可以使用 MaxText 做為訓練的最先進參考、使用 Tunix 進行對齊,並遵循明確的雙路徑,使用 vLLM-JAX (用於 vLLM 相容性) 和 NSE (用於 JAX 效能) 投入實際工作環境。
雖然從高階軟體的角度來看,許多堆疊都很相似,但決定性因素往往在於效能/TCO,而 JAX 和 TPU 的共同設計在這方面具有明顯優勢。這項效能/TCO 優勢是軟體和 TPU 硬體垂直整合的直接成果。XLA 編譯器能專為 TPU 架構融合運算,XProf 分析器則能使用硬體掛鉤,以低於 1% 的負擔進行分析,這些都是深度整合帶來的實質好處。
對採用這個堆疊的組織來說,JAX AI Stack 的全功能特性可大幅降低遷移成本。如果客戶採用熱門的開放原始碼模型架構,通常只要設定檔案,就能從其他架構轉換至 MaxText。此外,這個堆疊可擷取 safetensors 等熱門檢查點格式,因此現有檢查點可直接遷移,不必耗費高昂成本重新訓練。
下表列出 JAX AI Stack 提供的元件,以及其他架構或程式庫中的對應元件。
| 功能 | JAX | 其他架構中的替代方案/等效方案5 |
| 編譯器 / 執行階段 | XLA | Inductor,熱切 |
| MultiPod 訓練 | Pathways | Torch Lightning 策略、Ray Train、Monarch (新)。 |
| 核心架構 | JAX | PyTorch |
| 模型編寫 | Flax、Max* 模型 | torch.nn.*、NVidia TransformerEngine、HuggingFace Transformers |
| 最佳化工具和損失 | Optax | torch.optim.*、torch.nn.*Loss |
| 資料載入器 | 噴砂效果 | Ray Data、HuggingFace dataloaders |
| 查核點機制 | Orbax | PyTorch 分散式查核點、NeMo 查核點 |
| 量化 | Qwix | TorchAO、bitsandbytes |
| 核心編寫和知名實作 | Pallas / Tokamax | Triton/Helion、Liger-kernel、TransformerEngine |
| 訓練 / 調整後 | Tunix | VERL、NeMoRL |
| 分析 | XProf | PyTorch 分析器、NSight Systems、NSight Compute |
| 基礎模型訓練 | MaxText、MaxDiffusion | NeMo-Megatron、DeepSpeed、TorchTitan |
| LLM 推論 | vLLM | SGLang |
| 非 LLM 推論 | NSE | Triton Inference Server、RayServe |
5 這裡的部分對等項目不一定能完全對應,因為其他架構的 API 邊界與 JAX 不同。這份清單並未列出所有對等項目,而且經常會有新的程式庫出現。
結論:經久耐用、可用於正式環境的平台,迎接 AI 未來
上表提供的資料說明瞭一個不言而喻的結論:這些堆疊在少數領域各有優缺點,但從軟體角度來看,整體上非常相似。這兩個堆疊都提供統包解決方案,可用於預先訓練、訓練後調整及部署基礎模型。
JAX AI Stack 提供強大且具吸引力的解決方案,可訓練及部署任何規模的機器學習模型。這項服務充分運用軟體和 TPU 硬體的深度垂直整合,提供領先業界的效能和總持有成本。
這個堆疊以經過實證的內部系統為基礎,不斷演進,提供固有的可靠性和擴充性,讓使用者能安心開發及部署最大型的模型。其模組化和可組合的設計,根植於 JAX AI Stack 理念,賦予使用者無與倫比的自由度和控制權,讓他們能根據特定需求量身打造堆疊,不受單一框架的限制。
JAX AI Stack 具備 XLA 和 Pathways,可提供可擴充且容錯的基礎;JAX 則提供高效能且具表現力的數值程式庫;強大的核心開發程式庫,例如 Flax、Optax、Grain 和 Orbax;先進的效能工具,例如 Pallas、Tokamax 和 Qwix;以及 MaxText、vLLM 和 NSE 中強大的應用程式和正式環境層,為使用者提供穩固的基礎,可快速將最先進的研究成果投入正式環境。