


Créer une IA de production sur les Cloud TPU avec JAX
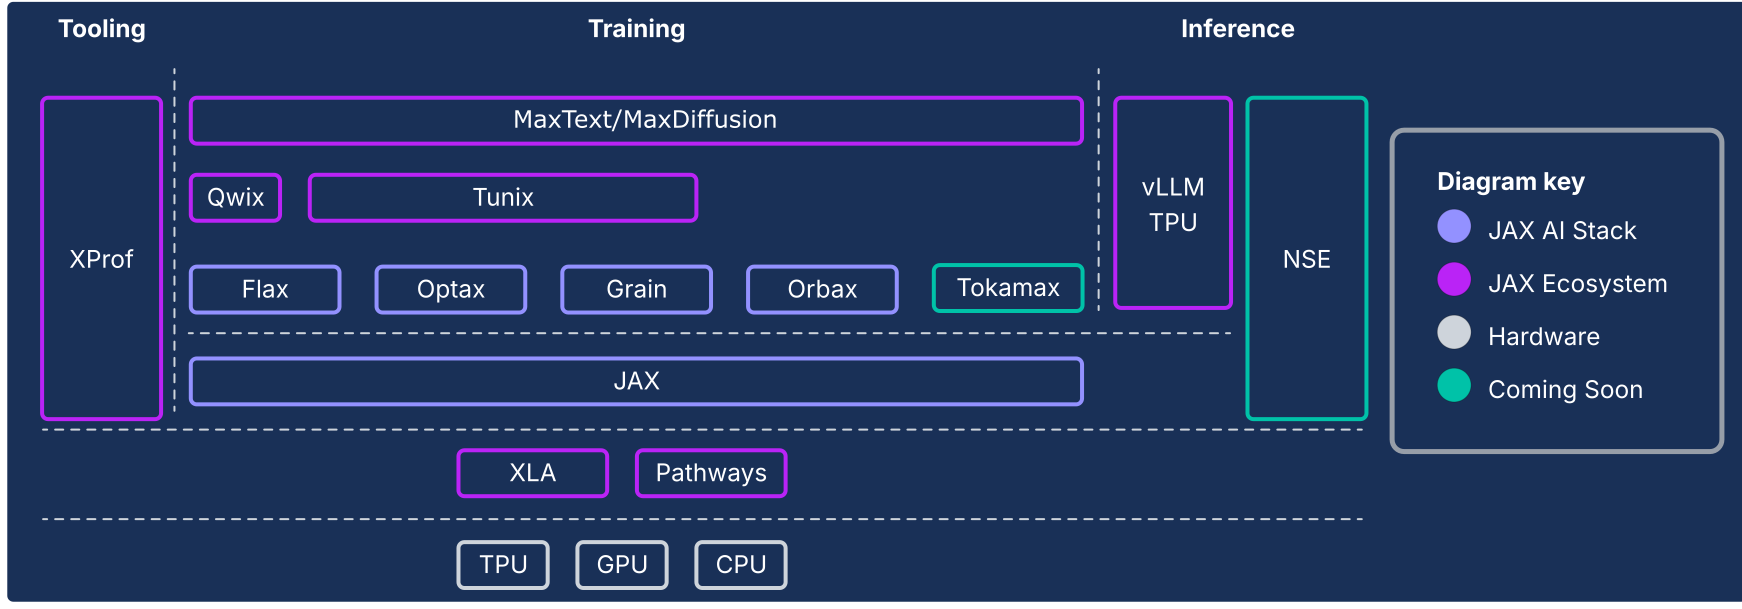
La pile d'IA JAX étend le cœur numérique JAX avec un ensemble de bibliothèques composables soutenues par Google, ce qui en fait une plate-forme Open Source robuste et de bout en bout pour le machine learning à très grande échelle. La pile d'IA JAX se compose donc d'un écosystème complet et robuste qui couvre l'ensemble du cycle de vie du ML :
Fondation à l'échelle industrielle : la pile d'IA JAX est conçue pour une évolutivité massive. Elle exploite ML Pathways pour orchestrer l'entraînement sur des dizaines de milliers de puces et Orbax pour un point de contrôle asynchrone résilient et à haut débit, ce qui permet un entraînement de niveau production de modèles de pointe.
Kit d'outils complet et prêt pour la production : la pile d'IA JAX fournit un ensemble complet de bibliothèques pour l'ensemble du processus de développement : Flax pour la création de modèles flexibles, Optax pour les stratégies d'optimisation composables et Grain pour les pipelines de données déterministes essentiels aux exécutions reproductibles à grande échelle.
Performances optimales et spécialisées : pour maximiser l'utilisation du matériel, la pile d'IA JAX propose des bibliothèques spécialisées, dont Tokamax pour des kernels personnalisés de pointe, Qwix pour une quantification non intrusive qui accélère l'entraînement et l'inférence, et XProf pour un profilage approfondi des performances intégré au matériel.
Chemin complet vers la production : la pile d'IA JAX permet une transition fluide de la recherche au déploiement. Cela inclut MaxText comme référence évolutive pour l'entraînement des modèles de fondation, Tunix pour l'apprentissage par renforcement (RL) et l'alignement de pointe, ainsi qu'une solution d'inférence unifiée avec vLLM-JAX et l'environnement d'exécution de diffusion JAX.
La philosophie de la pile d'IA JAX repose sur des composants faiblement couplés, chacun d'entre eux effectuant une tâche spécifique. Plutôt que d'être un framework de ML monolithique, JAX est lui-même limité et se concentre sur les opérations de tableau et les transformations de programmes efficaces. L'écosystème est basé sur ce framework de base pour fournir un large éventail de fonctionnalités, liées à la fois à l'entraînement de modèles de ML et à d'autres types de charges de travail, comme le calcul scientifique.
Ce système de composants faiblement couplés vous permet de sélectionner et de combiner les bibliothèques de la manière la plus adaptée à vos besoins. Du point de vue de l'ingénierie logicielle, cette architecture vous permet également de mettre à jour de manière itérative des fonctionnalités qui seraient traditionnellement considérées comme des composants de framework de base (par exemple, les pipelines de données et les points de contrôle) sans risquer de déstabiliser le framework de base ou d'être pris dans des cycles de publication. Étant donné que la plupart des fonctionnalités sont implémentées dans des bibliothèques plutôt que dans des modifications d'un framework monolithique, la bibliothèque de calculs de base est plus durable et s'adapte mieux aux évolutions futures du paysage technologique.
Les sections suivantes fournissent une présentation technique de la pile d'IA JAX, de ses principales fonctionnalités, des décisions de conception qui les sous-tendent et de la manière dont elles se combinent pour créer une plate-forme durable pour les charges de travail de ML modernes.
La pile d'IA JAX et d'autres composants de l'écosystème
| Composant | Fonction / Description |
|---|---|
| Cœur et composants de la pile d'IA JAX1 | |
| JAX | Calcul de tableaux et transformation de programmes orientés accélérateur (JIT, grad, vmap, pmap). |
| Flax | Bibliothèque de création de réseaux de neurones flexible pour la création et la modification intuitives de modèles. |
| Optax | Bibliothèque de transformations de traitement et d'optimisation de gradient composables. |
| Orbax | Bibliothèque de points de contrôle distribués "Any-scale" pour la résilience de l'entraînement à grande échelle. |
| Grain | Bibliothèque de pipelines de données d'entrée évolutive, déterministe et compatible avec les points de contrôle. |
| Pile d'IA JAX : infrastructure | |
| XLA | Compilateur de machine learning Open Source pour les TPU, les CPU et les GPU. |
| Pathways | Environnement d'exécution distribué pour orchestrer le calcul sur des dizaines de milliers de puces. |
| Pile d'IA JAX (avancé) Développement | |
| Pallas | Extension JAX permettant d'écrire des kernels personnalisés de bas niveau et hautes performances implémentés en Python. |
| Tokamax | Une bibliothèque de kernels personnalisés de pointe et hautes performances (par exemple, Attention). |
| Qwix | Une bibliothèque complète et non intrusive pour la quantification (PTQ, QAT, QLoRA). |
| Pile d'IA JAX : application | |
| MaxText / MaxDiffusion | Frameworks de référence phares et évolutifs pour l'entraînement des modèles de fondation (par exemple, LLM et Diffusion). |
| Tunix | Un framework pour l'entraînement et l'alignement de pointe (RLHF, DPO). |
| vLLM-JAX | Solution d'inférence LLM hautes performances utilisant l'intégration du framework vLLM. |
| XProf | Un profileur intégré au matériel pour une analyse approfondie des performances à l'échelle du système. |
1 Inclus dans le package Python jax-ai-stack.
Figure 1 : Composants de la pile et de l'écosystème d'IA JAX
L'impératif architectural : des performances au-delà des frameworks
À mesure que les architectures de modèles convergent (par exemple, sur les transformateurs MoE (Mixture-of-Experts) multimodaux), la recherche de performances optimales conduit à l'émergence de mégakernels. Un mégakernel est en fait l'intégralité de la passe avant (ou une grande partie) d'un modèle spécifique, codé manuellement à l'aide d'une API de niveau inférieur comme le SDK CUDA sur les GPU NVIDIA. Cette approche permet d'optimiser l'utilisation du matériel en chevauchant de manière agressive le calcul, la mémoire et la communication. Des travaux récents de la communauté de recherche ont démontré que cette approche peut générer des gains de débit significatifs, de plus de 22% dans certains cas, pour l'inférence sur les GPU. Cette tendance ne se limite pas à l'inférence. Des éléments suggèrent que certains efforts d'entraînement à grande échelle ont impliqué un contrôle matériel de bas niveau pour obtenir des gains d'efficacité substantiels.
Si cette tendance s'accélère, tous les frameworks de haut niveau tels qu'ils existent aujourd'hui risquent de devenir moins pertinents, car l'accès de bas niveau au matériel est ce qui compte en fin de compte pour les performances sur des architectures matures et stables. Cela représente un défi pour toutes les piles de ML modernes : comment fournir un contrôle matériel de niveau expert sans sacrifier la productivité et la flexibilité d'un framework de haut niveau ?
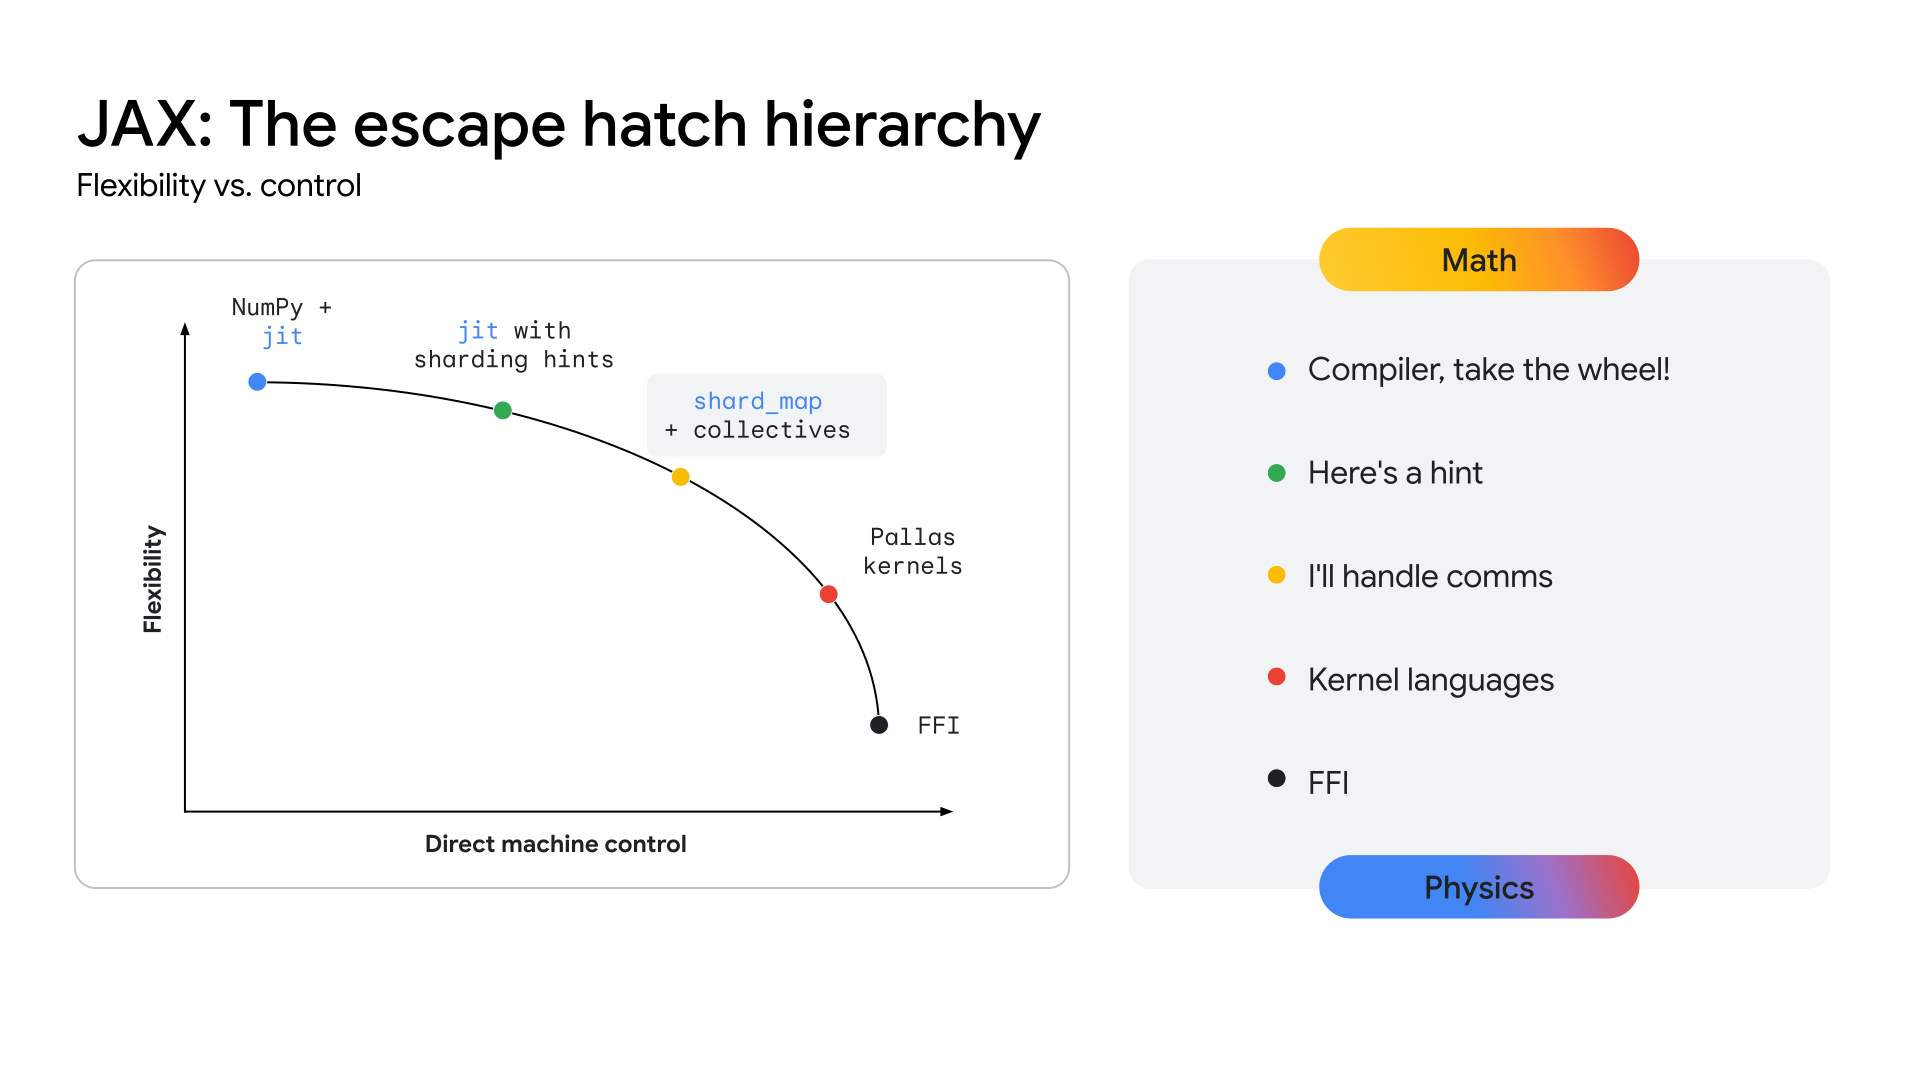
Pour que les TPU fournissent un chemin clair vers ce niveau de performances, l'écosystème doit exposer une couche d'API plus proche du matériel, ce qui permet de développer ces kernels hautement spécialisés. La pile JAX est conçue pour résoudre ce problème en offrant un continuum d'abstraction (voir la figure 2), des optimisations automatisées de haut niveau du compilateur XLA au contrôle manuel précis de la bibliothèque de création de noyaux Pallas.
Figure 2 : Continuum d'abstraction de JAX
La pile d'IA JAX de base
La pile d'IA JAX de base se compose de cinq bibliothèques clés qui constituent la base du développement de modèles :
JAX : une base pour la transformation de programmes composables et hautes performances
JAX est une bibliothèque Python pour le calcul de tableaux et la transformation de programmes orientés accélérateur, conçue pour le calcul numérique hautes performances et le machine learning à grande échelle. Avec son modèle de programmation fonctionnelle et son API de type NumPy, JAX fournit une base solide pour les bibliothèques de niveau supérieur.
Grâce à sa conception axée sur le compilateur, JAX favorise intrinsèquement l'évolutivité en exploitant XLA (voir la section XLA) pour l'analyse, l'optimisation et le ciblage matériel agressifs de l'ensemble du programme. L'accent mis par JAX sur la programmation fonctionnelle (par exemple, les fonctions pures) rend ses transformations de programme de base plus faciles à gérer et, surtout, composables.
Ces transformations de base peuvent être combinées pour obtenir des performances élevées et une mise à l'échelle des charges de travail en fonction de la taille du modèle, de la taille du cluster et des types de matériel :
- jit : compilation juste-à-temps des fonctions Python en exécutables XLA optimisés et fusionnés.
- grad : différenciation automatique, compatible avec les modes avant et arrière, ainsi que les dérivés d'ordre supérieur.
- vmap : vectorisation automatique, permettant un traitement par lot et un parallélisme des données fluides sans modifier la logique de la fonction.
- pmap / shard_map : parallélisation automatique sur plusieurs appareils (par exemple, des cœurs de TPU), qui constitue la base de l'entraînement distribué.
L'intégration parfaite avec le modèle GSPMD (General-purpose SPMD) de XLA permet à JAX de paralléliser automatiquement les calculs sur de grands pods TPU avec un minimum de modifications du code. Dans la plupart des cas, le scaling ne nécessite que des annotations de segmentation de haut niveau.
Flax : création flexible de réseaux de neurones
Flax simplifie la création, le débogage et l'analyse des réseaux de neurones dans JAX en fournissant une approche intuitive et orientée objet pour la création de modèles. Bien que l'API fonctionnelle de JAX soit puissante, elle offre une abstraction basée sur des couches plus familière aux développeurs habitués à des frameworks comme PyTorch, sans aucune pénalité de performances.
Cette conception simplifie la modification ou la combinaison des composants de modèles entraînés.
Les techniques telles que LoRA et la quantification nécessitent des définitions de modèle manipulables, que l'API NNX de Flax fournit via une interface Python. NNX encapsule l'état du modèle, ce qui réduit la charge cognitive de l'utilisateur, et permet de parcourir et de modifier la hiérarchie du modèle de manière programmatique.
Principaux points forts :
- API orientée objet intuitive : simplifie la construction de modèles et permet des cas d'utilisation avancés tels que le remplacement de sous-modules et l'initialisation partielle.
- Cohérence avec Core JAX : Flax fournit des transformations liftées entièrement compatibles avec le paradigme fonctionnel de JAX, offrant toutes les performances de JAX avec une plus grande convivialité pour les développeurs.
Optax : traitement de gradient composable et stratégies d'optimisation
Optax est une bibliothèque de traitement et d'optimisation des gradients pour JAX. Il est conçu pour fournir aux créateurs de modèles des composants pouvant être recombinés de manière personnalisée afin d'entraîner des modèles de deep learning, entre autres applications. Il s'appuie sur les fonctionnalités de la bibliothèque JAX de base pour fournir une bibliothèque hautes performances bien testée de fonctions de perte et d'optimisation, ainsi que des techniques associées pouvant être utilisées pour entraîner des modèles de ML.
Motivation
Le calcul et la minimisation des pertes sont au cœur de l'entraînement des modèles de ML. Grâce à sa compatibilité avec la différenciation automatique, la bibliothèque JAX de base fournit les fonctionnalités numériques permettant d'entraîner des modèles, mais elle ne fournit pas d'implémentations standards d'optimiseurs populaires (par exemple, RMSProp ou Adam) ni de pertes (par exemple, CrossEntropy ou MSE). Bien que vous puissiez implémenter ces fonctions (et certains développeurs avancés choisiront de le faire), un bug dans une implémentation d'optimiseur introduirait des problèmes de qualité de modèle difficiles à diagnostiquer. Plutôt que de laisser l'utilisateur implémenter ces éléments critiques, Optax fournit des implémentations de ces algorithmes qui sont testées pour vérifier leur exactitude et leurs performances.
Le domaine de la théorie de l'optimisation relève de la recherche, mais son rôle central dans l'entraînement en fait également un élément indispensable de l'entraînement des modèles de ML de production. Une bibliothèque qui remplit ce rôle doit être à la fois suffisamment flexible pour s'adapter aux itérations de recherche rapides, et suffisamment robuste et performante pour être fiable pour l'entraînement des modèles de production. Il doit également fournir des implémentations bien testées d'algorithmes de pointe qui correspondent aux équations standards. La bibliothèque Optax, grâce à son architecture composable modulaire et à l'accent mis sur un code correct et lisible, est conçue pour y parvenir.
Conception
Optax est conçu pour améliorer la vitesse de recherche et la transition de la recherche à la production en fournissant des implémentations lisibles, bien testées et efficaces des algorithmes de base. Optax peut être utilisé au-delà du contexte du deep learning. Toutefois, dans ce contexte, il peut être considéré comme un ensemble de fonctions de perte, d'algorithmes d'optimisation et de transformations de gradient bien connus, implémentés de manière purement fonctionnelle, conformément à la philosophie JAX. La collection de pertes et d'optimiseurs bien connus permet aux utilisateurs de se lancer facilement et en toute confiance.
L'approche modulaire adoptée par Optax vous permet d'enchaîner plusieurs optimiseurs, suivis d'autres transformations courantes (par exemple, le bornement de la norme du gradient), et de les encapsuler à l'aide de techniques courantes telles que MultiStep ou Lookahead pour obtenir des stratégies d'optimisation puissantes avec quelques lignes de code. L'interface flexible vous permet de rechercher de nouveaux algorithmes d'optimisation et d'utiliser des techniques d'optimisation de second ordre puissantes telles que Shampoo ou Muon.
# Optax implementation of a RMSProp optimizer with a custom learning rate
#  schedule, gradient clipping and gradient accumulation.
optimizer = optax.chain(
  optax.clip_by_global_norm(GRADIENT_CLIP_VALUE),
  optax.rmsprop(learning_rate=optax.cosine_decay_schedule(init_value=lr,decay_steps=decay)),
  optax.apply_every(k=ACCUMULATION_STEPS)
)

# The same thing, in PyTorch
optimizer = optim.RMSprop(model_params, lr=LEARNING_RATE)
scheduler = optim.lr_scheduler.CosineAnnealingLR(optimizer, T_max=TOTAL_STEPS)
for i, (inputs, targets) in enumerate(data_loader):
    # ... Training loop body ...
    if (i + 1) % ACCUMULATION_STEPS == 0:
        torch.nn.utils.clip_grad_norm_(model.parameters(), GRADIENT_CLIP_VALUE)
        optimizer.step()
        scheduler.step()
 optimizer.zero_grad()
L'extrait de code précédent montre comment configurer un optimiseur avec un taux d'apprentissage personnalisé, un bornement de la norme du gradient et une accumulation de gradient.
Principaux points forts
- Bibliothèque robuste : fournit une bibliothèque complète de pertes, d'optimiseurs et d'algorithmes, en mettant l'accent sur l'exactitude et la lisibilité.
- Transformations modulaires chaînables : cette API flexible vous permet de créer des stratégies d'optimisation puissantes et complexes de manière déclarative, sans modifier la boucle d'entraînement.
- Fonctionnel et évolutif : les implémentations purement fonctionnelles s'intègrent parfaitement aux mécanismes de parallélisation de JAX (par exemple, pmap), ce qui vous permet d'utiliser le même code pour passer d'un seul hôte à de grands clusters.
Orbax / TensorStore : point de contrôle distribué à grande échelle
Orbax est une bibliothèque de points de contrôle pour JAX conçue pour toutes les échelles, de l'entraînement sur un seul appareil à l'entraînement distribué à grande échelle. Il vise à unifier les implémentations de points de contrôle fragmentées et à proposer des fonctionnalités de performances critiques, telles que les points de contrôle asynchrones et multiniveaux, à un public plus large. Orbax offre la résilience requise pour les jobs d'entraînement volumineux et fournit un format flexible pour la publication des points de contrôle.
Contrairement aux systèmes de point de contrôle et de restauration généralisés qui créent un instantané de l'état complet du système, la création de points de contrôle de ML avec Orbax ne conserve de manière sélective que les informations essentielles pour reprendre l'entraînement : les pondérations du modèle, l'état de l'optimiseur et l'état du chargeur de données. Cette approche ciblée minimise le temps d'arrêt de l'accélérateur. Pour ce faire, Orbax chevauche les opérations d'E/S avec le calcul, une fonctionnalité essentielle pour les charges de travail volumineuses. Le temps d'inactivité des accélérateurs est réduit à la durée du transfert de données de l'appareil vers l'hôte, qui peut être chevauché par l'étape d'entraînement suivante, ce qui rend les points de contrôle presque sans frais du point de vue des performances.
À la base, Orbax utilise TensorStore pour lire et écrire efficacement des données de tableau en parallèle. L'API Orbax élimine cette complexité en offrant une interface conviviale pour gérer les PyTrees, qui sont la représentation standard des modèles dans JAX.
Principaux points forts :
- Adoption généralisée : avec des millions de téléchargements mensuels, Orbax sert de support commun pour le partage d'artefacts de ML.
- Simplifie les complexités : Orbax élimine les complexités des points de contrôle distribués, y compris l'enregistrement asynchrone, l'atomicité et les détails du système de fichiers.
- Flexibilité : tout en proposant des API pour les cas d'utilisation courants, Orbax vous permet de personnaliser votre workflow pour répondre à des exigences spécifiques.
- Performant et évolutif : des fonctionnalités telles que les points de contrôle asynchrones, un format de stockage efficace (OCDBT) et des stratégies de chargement de données intelligentes permettent à Orbax de s'adapter aux exécutions d'entraînement impliquant des dizaines de milliers de nœuds.
Grain : pipelines de données d'entrée déterministes et évolutifs
Grain est une bibliothèque Python permettant de lire et de traiter des données pour entraîner et évaluer des modèles JAX. Il est flexible, rapide et déterministe, et accepte des fonctionnalités avancées telles que la création de points de contrôle, qui sont essentielles pour entraîner de grandes charges de travail. Il est compatible avec les formats de données et les backends de stockage courants, et fournit également une API flexible pour étendre la compatibilité aux formats et backends spécifiques à l'utilisateur qui ne sont pas compatibles de manière native. Bien que Grain soit principalement conçu pour fonctionner avec JAX, il est indépendant du framework, ne nécessite pas JAX pour s'exécuter et peut également être utilisé avec d'autres frameworks.
Motivation
Les pipelines de données constituent un élément essentiel de l'infrastructure d'entraînement. Ils doivent être flexibles pour que les transformations courantes puissent être exprimées efficacement, et suffisamment performants pour que les accélérateurs soient occupés à tout moment. Ils doivent également pouvoir s'adapter à plusieurs formats et backends de stockage. En raison de leurs temps d'étape plus élevés, l'entraînement de grands modèles à grande échelle impose des exigences supplémentaires au pipeline de données, au-delà de celles requises par les charges de travail d'entraînement standards, principalement axées sur le déterminisme et la reproductibilité2. La bibliothèque Grain est conçue avec une architecture flexible qui répond à ces besoins.
2Dans la section 5.1 de l'article sur PaLM, les auteurs indiquent avoir observé des pics de perte très importants malgré l'activation du bornement de la norme du gradient. La solution consistait à supprimer les lots de données incriminés et à redémarrer l'entraînement à partir d'un point de contrôle antérieur au pic de perte. Cela n'est possible qu'avec une configuration d'entraînement entièrement déterministe et reproductible.
Conception
Au plus haut niveau, il existe deux façons de structurer un pipeline d'entrée : en tant que cluster distinct de nœuds de calcul de données ou en colocalisant les nœuds de calcul de données sur les hôtes qui pilotent les accélérateurs. Grain choisit la seconde option pour plusieurs raisons.
Les accélérateurs sont combinés à des hôtes puissants qui sont généralement inactifs pendant les étapes d'entraînement, ce qui en fait un choix naturel pour exécuter le pipeline de données d'entrée. Cette implémentation présente d'autres avantages : elle simplifie votre vue du partitionnement des données en fournissant une vue cohérente du partitionnement entre l'entrée et le calcul. On pourrait faire valoir que le fait de placer le nœud de calcul de données sur l'hôte de l'accélérateur risque de saturer le processeur de l'hôte. Toutefois, cela n'empêche pas de décharger les transformations gourmandes en ressources de calcul vers un autre cluster à l'aide de RPC3.
Sur le plan de l'API, avec une implémentation purement Python compatible avec plusieurs processus et une API flexible, Grain vous permet d'implémenter des transformations de données arbitrairement complexes en composant des étapes de pipeline basées sur des paradigmes de transformation bien compris.
Grain est directement compatible avec les formats de données à accès aléatoire efficaces tels que ArrayRecord et Bagz, ainsi qu'avec d'autres formats de données populaires tels que Parquet et TFDS. Grain permet de lire des données à partir de systèmes de fichiers locaux, ainsi qu'à partir de Cloud Storage par défaut. En plus de prendre en charge les formats de stockage et les backends populaires, une abstraction propre de la couche de stockage vous permet d'ajouter la compatibilité avec vos sources de données existantes ou de les encapsuler pour qu'elles soient compatibles avec la bibliothèque Grain.
3C'est ainsi que les pipelines de données multimodaux doivent fonctionner : les tokeniseurs d'images et d'audio, par exemple, sont eux-mêmes des modèles qui s'exécutent dans leurs propres clusters sur leurs propres accélérateurs, et les pipelines d'entrée effectuent des appels RPC pour convertir les exemples de données en flux de jetons.
Principaux points forts
- Alimentation déterministe des données : la colocalisation du nœud de calcul de données avec l'accélérateur et son couplage avec un brassage global stable et des itérateurs pouvant être soumis à des points de contrôle permettent de créer des points de contrôle pour l'état du modèle et l'état du pipeline de données ensemble dans un instantané cohérent à l'aide d'Orbax, ce qui améliore le déterminisme du processus d'entraînement.
- API flexibles pour permettre des transformations de données puissantes : une API de transformations Python flexible et pure vous permet d'effectuer des transformations de données étendues dans le pipeline de traitement des entrées.
- Compatibilité extensible avec plusieurs formats et backends : une API de sources de données extensible est compatible avec les formats de stockage et les backends courants, et vous permet d'ajouter la compatibilité avec de nouveaux formats et backends.
- Interface de débogage puissante : les outils de visualisation des pipelines de données et un mode de débogage vous permettent d'inspecter, de déboguer et d'optimiser les performances de vos pipelines de données.
La pile d'IA JAX étendue
Au-delà de la pile de base, un riche écosystème de bibliothèques spécialisées fournit l'infrastructure, les outils avancés et les solutions de couche d'application nécessaires au développement de ML de bout en bout.
Infrastructure de base : compilateurs et environnements d'exécution
XLA : le moteur indépendant du matériel et axé sur le compilateur
Motivation
XLA (Accelerated Linear Algebra) est le compilateur spécifique à un domaine de Google. Il est bien intégré à JAX et est compatible avec les appareils TPU, CPU et GPU. XLA a été conçu pour être un générateur de code indépendant du matériel, ciblant les TPU, les GPU et les CPU.
La conception du compilateur XLA, qui privilégie la compilation, est un choix architectural fondamental qui crée un avantage durable dans un paysage de recherche en évolution rapide. En revanche, l'approche dominante centrée sur le noyau dans d'autres écosystèmes repose sur des bibliothèques optimisées manuellement pour les performances. Bien que cette approche soit très efficace pour les architectures de modèles stables et bien établies, elle crée un goulot d'étranglement pour l'innovation. Lorsque de nouvelles recherches introduisent de nouvelles architectures, l'écosystème doit attendre que de nouveaux noyaux soient écrits et optimisés. Cependant, notre conception centrée sur le compilateur peut souvent se généraliser à de nouveaux modèles, offrant ainsi une voie performante pour la recherche de pointe dès le premier jour.
Conception
XLA fonctionne en compilant juste-à-temps (JIT) les graphes de calcul que JAX génère lors de son processus de traçage (par exemple, lorsqu'une fonction est décorée avec @jax.jit).
Cette compilation suit un pipeline en plusieurs étapes :
- Graphique de calcul JAX
- Optimiseur de haut niveau (HLO)
- Optimiseur de bas niveau (LLO)
- Code matériel
- Du graphe JAX à HLO : le graphe de calcul JAX est converti en représentation HLO de XLA. À ce niveau élevé, des optimisations puissantes et indépendantes du matériel, telles que la fusion d'opérateurs et la gestion efficace de la mémoire, sont appliquées. Le dialecte StableHLO sert d'interface durable et versionnée pour cette étape.
- De HLO à LLO : après les optimisations de haut niveau, les backends spécifiques au matériel prennent le relais, en abaissant la représentation HLO en un LLO orienté machine.
- De l'LLO au code matériel : l'LLO est enfin compilé en code machine hautement efficace. Pour les TPU, ce code est regroupé sous forme de paquets VLIW (Very Long Instruction Word) qui sont envoyés directement au matériel.
Pour le scaling, la conception de XLA est basée sur le parallélisme. Il utilise des algorithmes pour exploiter au maximum les unités de multiplication matricielle (MXU) d'une puce. Entre les puces, XLA utilise SPMD (Single Program Multiple Data), une technique de parallélisation basée sur un compilateur qui utilise un seul programme sur tous les appareils. Ce modèle puissant est exposé via les API JAX, ce qui vous permet de gérer le parallélisme des données, des modèles ou des pipelines avec des annotations de segmentation de haut niveau.
Pour les modèles de parallélisme plus complexes, le modèle MPMD (Multiple Program Multiple Data) est également possible, et des bibliothèques telles que PartIR:MPMD permettent aux utilisateurs de JAX de fournir également des annotations MPMD.
Principaux points forts
- Compilation : la compilation juste-à-temps du graphe de calcul permet d'optimiser la disposition de la mémoire, l'allocation de la mémoire tampon et la gestion de la mémoire. Les alternatives telles que les méthodologies basées sur le noyau font peser cette charge sur le développeur. Dans la plupart des cas, XLA peut atteindre d'excellentes performances sans compromettre la vitesse de développement.
- Parallélisme : XLA implémente plusieurs formes de parallélisme avec SPMD, qui sont exposées au niveau de JAX. Cela vous permet d'exprimer des stratégies de segmentation, ce qui permet d'expérimenter et de faire évoluer les modèles sur des milliers de puces.
Pathways : un environnement d'exécution unifié pour le calcul distribué à grande échelle
Pathways propose des abstractions pour l'entraînement et l'inférence distribués avec tolérance aux pannes et récupération intégrées, ce qui permet aux chercheurs en ML de coder comme s'ils utilisaient une seule machine puissante.
Motivation
Pour pouvoir entraîner et déployer des modèles volumineux, des centaines, voire des milliers de puces sont nécessaires. Ces puces sont réparties sur de nombreux racks et machines hôtes. Un job d'entraînement est un programme synchrone à grande échelle qui nécessite que toutes ces puces et leurs hôtes respectifs fonctionnent en tandem sur des calculs XLA qui ont été parallélisés (segmentés). Dans le cas des grands modèles de langage, qui peuvent nécessiter plus de dizaines de milliers de puces, ce service doit pouvoir s'étendre sur plusieurs pods d'une structure de centre de données, en plus d'utiliser des structures d'interconnexion entre puces (ICI) et d'interconnexion sur puce (OCI) au sein d'un pod.
Conception
ML Pathways est le système que nous utilisons pour coordonner les calculs distribués entre les hôtes et les puces TPU. Il est conçu pour offrir évolutivité et efficacité sur des centaines de milliers d'accélérateurs. Pour l'entraînement à grande échelle, il fournit un seul client Python pour plusieurs jobs de pod, l'intégration de Megascale XLA, un service de compilation et Python à distance. Il est également compatible avec le parallélisme entre les tranches et la tolérance à la préemption, ce qui permet une récupération automatique après une préemption de ressources.
Pathways intègre des collectifs d'hôtes croisés optimisés qui permettent aux graphiques de calcul XLA de s'étendre au-delà d'un seul pod TPU. Il étend la compatibilité de XLA avec le parallélisme des données, des modèles et des pipelines pour qu'il fonctionne au-delà des limites des tranches TPU à l'aide du réseau de centre de données (DCN) en intégrant un environnement d'exécution distribué qui gère la communication DCN avec les primitives de communication XLA.
Principaux points forts
L'architecture à contrôleur unique, intégrée à JAX, est une abstraction clé. Il permet aux chercheurs d'explorer différentes stratégies de segmentation et de parallélisme pour l'entraînement et le déploiement, tout en évoluant facilement vers des dizaines de milliers de puces.
Développement avancé : performances, données et efficacité
Pallas : écrire des kernels personnalisés hautes performances dans JAX
Bien que JAX soit un compilateur, il peut arriver que vous souhaitiez contrôler précisément le matériel pour obtenir des performances maximales. Pallas est une extension de JAX qui permet d'écrire des kernels personnalisés pour les GPU et les TPU. Il vise à fournir un contrôle précis sur le code généré, combiné à l'ergonomie de haut niveau du traçage JAX et de l'API jax.numpy.
Pallas expose un modèle de parallélisme basé sur une grille, dans lequel une fonction de kernel définie par l'utilisateur est lancée sur une grille multidimensionnelle de groupes de travail parallèles. Il permet une gestion explicite de la hiérarchie de la mémoire en vous permettant de définir la façon dont les tenseurs sont divisés et transférés entre une mémoire plus lente et plus grande (par exemple, HBM) et une mémoire sur puce plus rapide et plus petite (par exemple, VMEM sur TPU, mémoire partagée sur GPU), à l'aide de cartes d'index pour associer les emplacements de la grille à des blocs de données spécifiques. Pallas peut réduire la même définition de kernel pour l'exécuter efficacement sur les TPU de Google et sur différents GPU en compilant les kernels dans une représentation intermédiaire adaptée à l'architecture cible (Mosaic pour les TPU ou en utilisant des technologies comme Triton pour les GPU). Avec Pallas, vous pouvez écrire des noyaux hautes performances qui spécialisent des blocs comme l'attention pour obtenir les meilleures performances de modèle sur le matériel cible sans avoir à vous appuyer sur des kits d'outils spécifiques au fournisseur.
Tokamax : une bibliothèque de kernels de pointe
Si Pallas est un outil permettant de créer des kernels, Tokamax est une bibliothèque de kernels d'accélérateur personnalisés de pointe compatibles avec les TPU et les GPU. Tokamax est basé sur JAX et Pallas, et vous permet d'exploiter toute la puissance de votre matériel. Il fournit également des outils pour créer et régler automatiquement des kernels personnalisés.
Motivation
JAX, qui trouve ses racines dans XLA, est un framework axé sur le compilateur. Toutefois, il existe un ensemble restreint de cas où vous devrez peut-être prendre le contrôle direct du matériel pour obtenir des performances maximales4. Les kernels personnalisés sont essentiels pour obtenir les meilleures performances des ressources d'accélérateur de ML coûteuses, telles que les TPU et les GPU. Bien qu'ils soient largement utilisés pour permettre l'exécution performante d'opérateurs clés tels que l'attention, leur mise en œuvre nécessite une compréhension approfondie du modèle et de l'architecture matérielle cible. Tokamax fournit une source de référence de noyaux sélectionnés, bien testés et hautes performances, ainsi qu'une infrastructure partagée robuste pour leur développement, leur maintenance et la gestion de leur cycle de vie. Une telle bibliothèque peut également servir d'implémentation de référence que vous pouvez développer et personnaliser si nécessaire. Cela vous permet de vous concentrer sur vos efforts de modélisation sans avoir à vous soucier de l'infrastructure.
4Il s'agit d'un paradigme bien établi qui a un précédent dans le monde des processeurs, où le code compilé constitue l'essentiel du programme, les développeurs se tournant vers des fonctions intrinsèques ou l'assemblage intégré pour optimiser les sections critiques pour les performances.
Conception
Pour un noyau donné, Tokamax fournit une API commune qui peut être soutenue par plusieurs implémentations. Par exemple, les noyaux TPU peuvent être implémentés par une réduction XLA standard ou explicitement avec Pallas/Mosaic-TPU. Les noyaux GPU peuvent être implémentés par abaissement XLA standard, avec Mosaic-GPU ou Triton. Par défaut, l'API Tokamax choisit l'implémentation la plus connue pour une configuration donnée, déterminée par les résultats mis en cache des exécutions périodiques de réglage automatique et d'analyse comparative. Toutefois, vous pouvez choisir des implémentations spécifiques si nécessaire. De nouvelles implémentations peuvent être ajoutées au fil du temps pour mieux exploiter les fonctionnalités spécifiques des nouvelles générations de matériel et améliorer encore les performances.
Un composant clé de la bibliothèque Tokamax, au-delà des kernels eux-mêmes, est l'infrastructure compatible qui vous permet d'écrire des kernels personnalisés. Par exemple, l'infrastructure de réglage automatique vous permet de définir un ensemble de paramètres configurables (par exemple, les tailles de tuiles) sur lesquels Tokamax peut effectuer un balayage exhaustif afin de déterminer et de mettre en cache les meilleurs paramètres réglés possibles. Les régressions nocturnes vous protègent contre les problèmes de performances et de valeurs numériques inattendus causés par des modifications de l'infrastructure du compilateur sous-jacent ou d'autres dépendances.
Principaux points forts
- Expérience de développement fluide : une bibliothèque unifiée et sélectionnée fournit des implémentations connues et performantes de kernels clés, avec des expressions claires des générations de matériel compatibles et des performances attendues, à la fois de manière programmatique et dans la documentation. Cela réduit la fragmentation et le taux de désabonnement.
- Flexibilité et gestion du cycle de vie : vous pouvez choisir différentes implémentations, et même les modifier au fil du temps si nécessaire. Par exemple, si le compilateur XLA améliore la compatibilité avec certaines opérations qui ne nécessitent plus de noyaux personnalisés, il existe un chemin d'abandon et de migration.
- Extensibilité : vous pouvez implémenter vos propres noyaux tout en exploitant une infrastructure partagée bien compatible, ce qui vous permet de vous concentrer sur les fonctionnalités et les optimisations à valeur ajoutée. Les implémentations standards clairement rédigées servent de point de départ aux utilisateurs pour apprendre et étendre leurs connaissances.
Qwix : quantification complète et non intrusive
Qwix est une bibliothèque de quantification complète pour la pile d'IA JAX. Elle est compatible avec les LLM et d'autres types de modèles à toutes les étapes, y compris l'entraînement (entraînement tenant compte de la quantification (QAT), technique de quantification (QT), adaptation à faible rang quantifiée (QLoRA)) et l'inférence (quantification post-entraînement (PTQ)), ciblant à la fois les environnements d'exécution XLA et on-device.
Motivation
Les bibliothèques de quantification existantes, en particulier dans l'écosystème PyTorch, ont souvent des objectifs limités (par exemple, uniquement PTQ ou uniquement QLoRA). Ce paysage fragmenté vous oblige à changer d'outil, ce qui empêche une utilisation cohérente du code et une correspondance numérique précise entre l'entraînement et l'inférence. De plus, de nombreuses solutions nécessitent des modifications importantes du modèle, ce qui lie étroitement la logique du modèle à la logique de quantification.
Conception
La philosophie de conception de Qwix met l'accent sur une solution complète et, surtout, sur l'intégration non intrusive de modèles. Il est conçu avec une architecture hiérarchique et extensible basée sur des API fonctionnelles réutilisables.
Cette intégration non intrusive est réalisée grâce à un mécanisme d'interception méticuleusement conçu qui redirige les fonctions JAX vers leurs équivalents quantifiés. Cela vous permet d'intégrer vos modèles sans aucune modification, en dissociant complètement le code de quantification des définitions de modèle.
L'exemple suivant montre comment appliquer la quantification w4a4 (poids de 4 bits, activation de 4 bits) aux couches MLP d'un LLM et la quantification w8 (poids de 8 bits) à l'outil d'embedding. Pour modifier la recette de quantification, il vous suffit de mettre à jour la liste des règles.
fp_model = ModelWithoutQuantization(...)
rules = [
    qwix.QuantizationRule(
        module_path=r'embedder',
        weight_qtype='int8',
    ),
    qwix.QuantizationRule(
        module_path=r'layers_\d+/mlp',
        weight_qtype='int4',
        act_qtype='int4',
        tile_size=128,
        weight_calibration_method='rms,7',
    ),
]
quantized_model = qwix.quantize_model(fp_model, qwix.PtqProvider(rules))
Principaux points forts
- Solution complète : Qwix est largement applicable à de nombreux scénarios de quantification, ce qui garantit une utilisation cohérente du code entre l'entraînement et l'inférence.
- Intégration de modèle non intrusive : comme le montre l'exemple, vous pouvez intégrer des modèles avec une seule ligne de code. Vous pouvez ainsi utiliser des hyperparamètres sur de nombreux schémas de quantification pour trouver le meilleur compromis entre qualité et performances.
- Fédéré avec d'autres bibliothèques : Qwix s'intègre parfaitement à la pile d'IA JAX. Par exemple, Tokamax s'adapte automatiquement pour utiliser des versions quantifiées des noyaux, sans code utilisateur supplémentaire, lorsque le modèle est quantifié avec Qwix.
- Adapté à la recherche : les API de base et l'architecture extensible de Qwix permettent aux chercheurs d'explorer de nouveaux algorithmes et facilitent les comparaisons directes avec des outils d'évaluation et de benchmark intégrés.
Couche d'application : entraînement et alignement
Entraînement de modèles de fondation : MaxText et MaxDiffusion
MaxText et MaxDiffusion sont les frameworks d'entraînement de modèles LLM et de diffusion phares de Google. Ces dépôts contiennent une sélection d'implémentations hautement optimisées de modèles populaires à pondération ouverte. Ils ont un double objectif : ils servent à la fois de codebase d'entraînement de modèle prêt à l'emploi et de référence sur laquelle les créateurs de modèles de fondation peuvent s'appuyer.
Motivation
L'intérêt pour l'entraînement des modèles d'IA générative augmente rapidement dans l'ensemble du secteur. La popularité des modèles ouverts a accéléré cette tendance, en fournissant des architectures éprouvées. L'entraînement et l'adaptation de ces modèles nécessitent des performances élevées, une efficacité, une évolutivité vers un grand nombre de puces et un code clair et compréhensible. MaxText et MaxDiffusion sont des solutions complètes qui peuvent être utilisées sur des TPU ou des GPU, et sont conçues pour répondre à ces besoins.
Conception
MaxText et MaxDiffusion sont des codebases de modèles de fondation conçus pour être lisibles et performants. Ils sont structurés avec des composants réutilisables et bien testés : des définitions de modèles qui utilisent des kernels personnalisés (comme Tokamax) pour des performances maximales, un harnais d'entraînement pour l'orchestration et la surveillance, et un système de configuration puissant qui vous permet de contrôler des détails tels que le partitionnement et la quantification (à l'aide de Qwix) via une interface intuitive. Des fonctionnalités de fiabilité avancées, telles que les points de contrôle multiniveaux, sont intégrées pour garantir un débit utile durable.
MaxText et MaxDiffusion utilisent les meilleures bibliothèques JAX (Qwix, Tunix, Orbax et Optax) pour fournir des fonctionnalités de base. Ces bibliothèques fournissent une infrastructure robuste et évolutive, ce qui réduit les frais de développement et vous permet de vous concentrer sur la tâche de modélisation. Pour l'inférence, le code du modèle est partagé pour permettre une mise en service efficace et évolutive.
Principaux points forts
- Performant par conception : avec une infrastructure d'entraînement configurée pour un débit utile élevé et des implémentations de modèles optimisées pour une utilisation élevée des FLOPS du modèle (MFU), MaxText et MaxDiffusion offrent des performances élevées à grande échelle dès le départ.
- Conçus pour évoluer : en exploitant la puissance de la pile d'IA JAX (en particulier Pathways), ces frameworks vous permettent d'évoluer facilement de quelques dizaines de puces à des dizaines de milliers.
- Base solide pour les créateurs de modèles de fondation : les implémentations lisibles et de haute qualité constituent un point de départ solide pour les développeurs, qui peuvent les utiliser comme solution de bout en bout ou comme implémentation de référence pour leurs propres personnalisations.
Post-entraînement et alignement : le framework Tunix
Tunix propose des algorithmes d'apprentissage par renforcement (RL) Open Source de pointe, ainsi qu'un framework et une infrastructure robustes, offrant aux développeurs un moyen simplifié d'expérimenter des techniques de post-entraînement de LLM, y compris l'affinage supervisé (SFT) et l'alignement à l'aide de JAX et de TPU.
Motivation
Le post-entraînement est une étape essentielle pour exploiter tout le potentiel des LLM. L'étape d'apprentissage par renforcement (RL) est particulièrement cruciale pour développer les capacités d'alignement et de raisonnement. Le développement Open Source dans ce domaine s'est presque exclusivement basé sur PyTorch et les GPU, ce qui a laissé un vide fondamental pour les solutions JAX et TPU. Tunix (Tune-in-JAX) est une bibliothèque native JAX hautes performances conçue pour combler cette lacune.
Conception
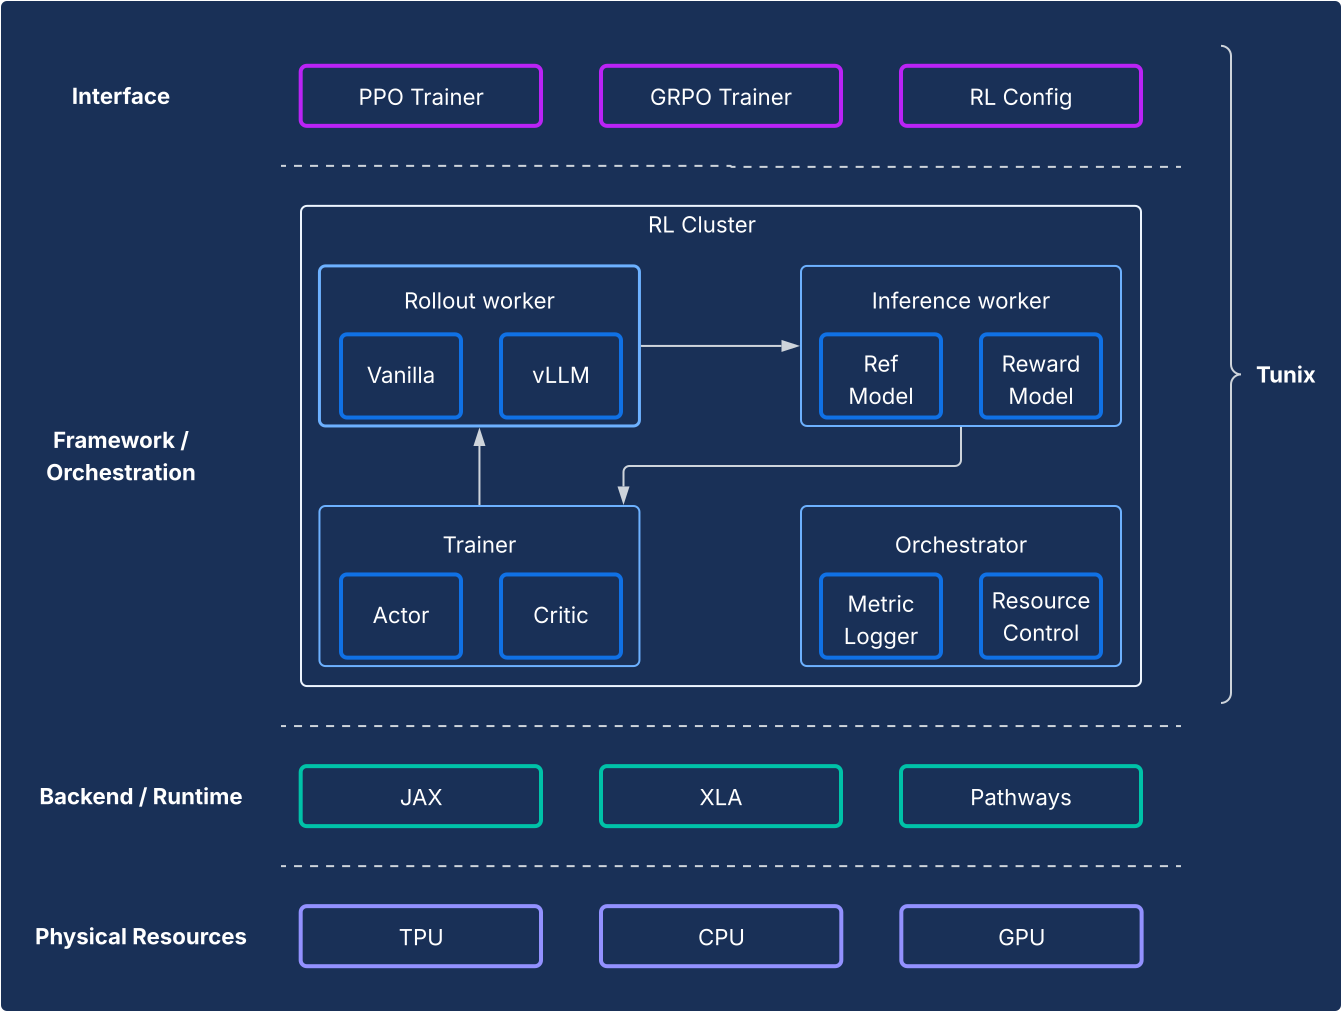
Du point de vue du framework, Tunix permet une configuration de pointe qui sépare clairement les algorithmes de RL de l'infrastructure. Il offre une API légère de type client qui masque la complexité de l'infrastructure RL, ce qui vous permet de développer de nouveaux algorithmes. Tunix fournit des solutions prêtes à l'emploi pour les algorithmes populaires, y compris l'optimisation de stratégie proximale (PPO), l'optimisation des préférences directes (DPO) et d'autres.
Côté infrastructure, Tunix est intégré à Pathways, ce qui permet une architecture à contrôleur unique qui rend l'entraînement par RL multinœud accessible. Côté entraînement, Tunix est compatible de manière native avec l'entraînement efficace des paramètres (par exemple, LoRA) et exploite le partitionnement JAX et XLA (General and Scalable Parallelization for ML Computation Graph, GSPMD) pour générer un graphe de calcul performant. Il est compatible d'emblée avec les modèles Open Source populaires tels que Gemma et Llama.
Principaux points forts
- Simplicité : il fournit une API de haut niveau de type client qui élimine la complexité de l'infrastructure distribuée sous-jacente.
- Efficacité des développeurs : Tunix accélère le cycle de vie de la recherche et du développement grâce à des algorithmes et des"recettes " intégrés, ce qui vous fournit un modèle de travail et vous permet d'itérer rapidement.
- Performances et évolutivité : Tunix permet de créer une infrastructure d'entraînement hautement efficace et évolutive horizontalement en exploitant Pathways comme un contrôleur unique sur le backend.
Couche d'application : production et inférence
L'adoption de JAX a toujours été freinée par le passage de la recherche à la production. La pile d'IA JAX propose désormais une approche de production mature en deux volets, qui offre à la fois la compatibilité avec l'écosystème et les performances de JAX.
Inférence LLM hautes performances : la solution vLLM-JAX
vLLM-JAX est le backend d'inférence hautes performances de Google conçu pour exécuter efficacement les grands modèles de langage (LLM) JAX sur les Cloud TPU. Il intègre le framework vLLM Open Source à l'écosystème JAX et TPU de Google. Pour diffuser des modèles PyTorch avec vLLM sur des TPU, consultez PyTorch sur Cloud TPU.
Motivation
Le secteur évolue rapidement, avec une demande croissante de solutions d'inférence fluides, performantes et faciles à utiliser. Les développeurs sont souvent confrontés à des défis importants liés à des outils complexes et incohérents, à des performances insuffisantes et à une compatibilité limitée des modèles. La pile vLLM résout ces problèmes en fournissant une plate-forme unifiée, performante et intuitive.
Conception
Cette solution étend le framework vLLM au lieu de le réinventer. vLLM-JAX est un moteur de diffusion LLM Open Source hautement optimisé, connu pour son débit élevé, obtenu grâce à des fonctionnalités clés telles que PagedAttention (qui gère les caches KV comme la mémoire virtuelle pour minimiser la fragmentation) et Continuous Batching (qui ajoute dynamiquement des requêtes au lot pour améliorer l'utilisation).
vLLM-JAX s'appuie sur cette base et développe des composants de base pour la gestion des requêtes, la planification et la gestion de la mémoire. Il introduit un backend basé sur JAX qui sert de pont, traduisant le graphe de calcul et les opérations de mémoire de vLLM en code exécutable par TPU. Ce backend gère les interactions avec l'appareil, l'exécution du modèle JAX et les spécificités de la gestion du cache KV sur le matériel TPU. Il intègre des optimisations spécifiques aux TPU, telles que des mécanismes d'attention efficaces (par exemple, en exploitant les kernels JAX Pallas pour Ragged Paged Attention) et la quantification, tous adaptés à l'architecture TPU.
Points forts
- Aucun coût d'intégration/de désinscription pour les utilisateurs : les utilisateurs peuvent adopter cette solution sans friction significative. Du point de vue de l'expérience utilisateur, le traitement des requêtes d'inférence sur les TPU doit être identique à celui sur les GPU. La CLI pour démarrer le serveur, accepter les requêtes et renvoyer les résultats est partagée.
- Adopter pleinement l'écosystème : cette approche utilise l'interface et l'expérience utilisateur de vLLM et y contribue, ce qui garantit la compatibilité et la facilité d'utilisation.
- Fongibilité entre les TPU et les GPU : la solution fonctionne efficacement sur les TPU et les GPU, ce qui vous offre une grande flexibilité.
- Rentable (meilleur rapport performances/prix) : optimise les performances pour offrir le meilleur rapport performances/prix pour les modèles populaires.
Mise en service JAX : sérialisation Orbax et moteur de mise en service Neptune
Pour les modèles autres que les LLM, ou pour les utilisateurs souhaitant un pipeline entièrement natif JAX, la bibliothèque de sérialisation Orbax et le système Neptune Serving Engine (NSE) fournissent une solution de diffusion de bout en bout hautes performances.
Motivation
Par le passé, les modèles JAX reposaient souvent sur un chemin détourné vers la production, par exemple en étant encapsulés dans des graphes TensorFlow et déployés à l'aide de TensorFlow Serving. Cette approche présentait des limites et des inefficacités importantes, obligeant les développeurs à interagir avec un écosystème distinct et ralentissant l'itération. Un système de diffusion natif JAX dédié est essentiel pour assurer la durabilité, réduire la complexité et optimiser les performances.
Conception
Cette solution se compose de deux composants principaux, comme illustré dans le diagramme suivant.
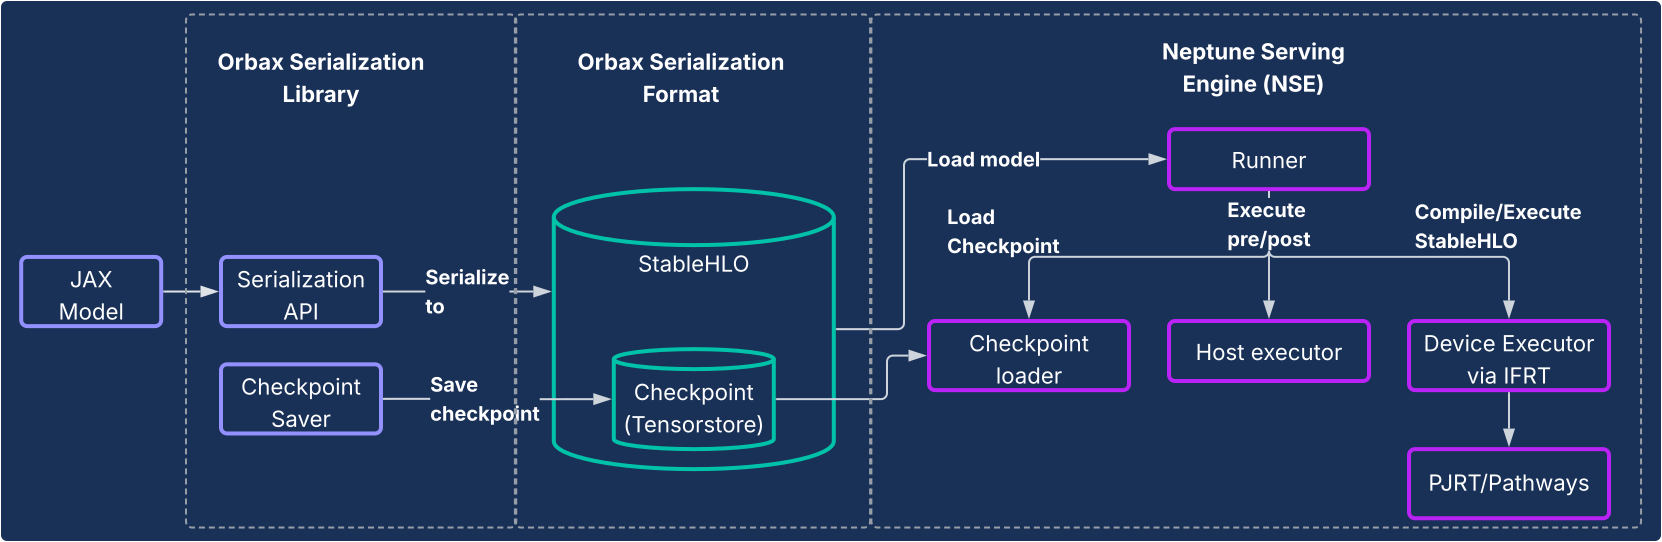
- Bibliothèque de sérialisation Orbax : fournit des API faciles à utiliser pour sérialiser des modèles JAX dans un nouveau format de sérialisation Orbax robuste. Ce format est optimisé pour le déploiement en production. Il représente directement les calculs du modèle JAX à l'aide de StableHLO, ce qui permet de représenter le graphe de calcul de manière native. Il exploite également TensorStore pour stocker les pondérations, ce qui permet un chargement rapide des points de contrôle pour la diffusion.
- Neptune Serving Engine (NSE) : il s'agit du moteur de diffusion flexible et hautes performances (généralement déployé en tant que binaire C++) conçu pour exécuter de manière native des modèles JAX au format Orbax. NSE offre des fonctionnalités essentielles pour la production, telles que le chargement rapide des modèles, la mise en service simultanée à haut débit avec traitement par lot intégré, la compatibilité avec plusieurs versions de modèles et la mise en service sur un ou plusieurs hôtes (en exploitant PJRT et Pathways). Utilisez Neptune Serving Engine pour :
- Modèles non LLM : il s'agit d'une solution polyvalente idéale pour les charges de travail telles que les systèmes de recommandation, les modèles de diffusion et d'autres modèles d'IA.
- Petits LLM et diffusion "one-shot" : il est conçu pour les modèles non autorégressifs ou les modèles plus petits qui sont diffusés de manière "unaire", où l'intégralité de la sortie est générée en une seule passe sans nécessiter de gestion d'état complexe comme un cache KV.
En résumé, Neptune Serving Engine comble le manque de solutions pour diffuser la grande variété de modèles qui ne sont pas de grands modèles de langage autorégressifs, en fournissant une solution native TPU hautes performances pour l'écosystème de ML plus large.
Principaux points forts
- Mise en service native JAX : la solution est conçue de manière native pour JAX, ce qui élimine les frais généraux inter-frameworks lors de la sérialisation et de la mise en service du modèle. Cela garantit un chargement rapide du modèle et une exécution optimisée sur les processeurs, les GPU et les TPU.
- Déploiement en production sans effort : les modèles sérialisés fournissent un chemin de déploiement hermétique qui n'est pas affecté par la dérive des dépendances Python et permet de vérifier l'intégrité du modèle d'exécution. Cela permet de mettre en production des modèles JAX de manière fluide et intuitive.
- Expérience de développement améliorée : en éliminant le besoin d'encapsuler des frameworks complexes, cette solution réduit considérablement les dépendances et la complexité du système, ce qui accélère l'itération pour les développeurs JAX.
Analyse et profilage à l'échelle du système
XProf : profilage des performances approfondi et intégré au matériel
XProf est un outil de profilage et d'analyse des performances qui offre une visibilité approfondie sur divers aspects de l'exécution des charges de travail de ML, ce qui vous permet de déboguer et d'optimiser les performances. Il est profondément intégré aux écosystèmes JAX et TPU.
Motivation
D'une part, les charges de travail de ML sont de plus en plus complexes. D'autre part, on assiste à une explosion des capacités matérielles spécialisées ciblant ces charges de travail. Il est essentiel de les faire correspondre efficacement pour garantir des performances et une efficacité optimales, compte tenu des coûts énormes de l'infrastructure de ML. Cela nécessite une visibilité approfondie sur la charge de travail et le matériel, présentée de manière à être rapidement exploitable. XProf excelle dans ce domaine.
Conception
XProf se compose de deux éléments principaux : la collecte et l'analyse.
- Collecte : XProf capture des informations provenant de différentes sources : annotations dans votre code JAX, modèles de coût pour les opérations dans le compilateur XLA et fonctionnalités de profilage matériel spécialement conçues dans le TPU. Cette collecte peut être déclenchée de manière programmatique ou à la demande, ce qui génère un artefact d'événement complet.
- Analyse : XProf post-traite les données collectées et crée une suite de visualisations puissantes, accessibles via un navigateur.
Principaux points forts
La véritable puissance de XProf réside dans son intégration profonde à la pile complète, qui offre une analyse étendue et approfondie, un avantage tangible de l'écosystème JAX/TPU co-conçu.
- Conçu conjointement avec le TPU : XProf exploite des fonctionnalités matérielles spécialement conçues pour une collecte de profils fluide, ce qui permet d'obtenir un coût de collecte inférieur à 1%. Cela permet au profilage d'être une partie légère et itérative du développement.
- Étendue et profondeur de l'analyse : XProf fournit une analyse approfondie sur plusieurs axes. Voici les outils disponibles :
- Trace Viewer : vue chronologique des opérations d'exécution sur différentes unités matérielles (par exemple, TensorCore).
- Profil d'opération HLO : décompose le temps total passé en différentes catégories d'opérations.
- Memory Viewer (Lecteur de mémoire) : détaille les allocations de mémoire par différentes opérations pendant la fenêtre profilée.
- Analyse Roofline : vous aide à déterminer si des opérations spécifiques sont liées au calcul ou à la mémoire, et à quelle distance elles se trouvent des capacités maximales du matériel.
- Lecteur de graphiques : fournit une vue du graphique HLO complet exécuté par le matériel.
Une perspective comparative : la pile JAX/TPU comme choix convaincant
Le paysage moderne du machine learning offre de nombreuses chaînes d'outils matures et d'excellente qualité. La pile d'IA JAX présente un ensemble d'avantages uniques et convaincants pour les développeurs qui se concentrent sur le ML hautes performances à grande échelle, découlant directement de sa conception modulaire et de sa co-conception matérielle approfondie.
Bien que de nombreux frameworks offrent un large éventail de fonctionnalités, la pile d'IA JAX fournit des différenciateurs spécifiques et puissants dans les domaines clés du cycle de vie du développement :
- Une expérience de développement plus simple et plus puissante : le paradigme de transformation de gradient chaînable d'Optax permet des stratégies d'optimisation plus puissantes et plus flexibles qui sont déclarées une fois, plutôt que gérées de manière impérative dans la boucle d'entraînement. Au niveau du système, l'interface de contrôleur unique plus simple de Pathways élimine la complexité de l'entraînement multitranche, ce qui simplifie considérablement la tâche des chercheurs.
- Conçue pour une résilience à grande échelle : la pile JAX est conçue pour l'entraînement à très grande échelle. Orbax fournit des fonctionnalités de "résilience de l'entraînement à grande échelle", telles que les points de contrôle d'urgence et à plusieurs niveaux. Il est complété par Grain, qui offre une compatibilité totale avec la reproductibilité grâce à des mélanges globaux déterministes et des chargeurs de données pouvant être soumis à des points de contrôle. La possibilité de créer un point de contrôle atomique de l'état du pipeline de données (Grain) avec l'état du modèle (Orbax) est une fonctionnalité essentielle pour garantir la reproductibilité des jobs de longue durée.
- Un écosystème complet de bout en bout : la pile fournit une solution cohérente de bout en bout. Les développeurs peuvent utiliser MaxText comme référence SOTA pour l'entraînement, Tunix pour l'alignement et suivre un double chemin clair vers la production avec vLLM-JAX (pour la compatibilité vLLM) et NSE (pour les performances JAX).
Bien que de nombreuses piles soient similaires d'un point de vue logiciel de haut niveau, le facteur décisif se résume souvent aux performances et au coût total de possession, ce qui donne un avantage certain à la conception conjointe de JAX et des TPU. Cet avantage en termes de performances/TCO est le résultat direct de l'intégration verticale entre les logiciels et le matériel TPU. La capacité du compilateur XLA à fusionner des opérations spécifiquement pour l'architecture TPU, ou pour le profileur XProf à utiliser des hooks matériels pour un profilage avec une surcharge inférieure à 1 %, sont des avantages tangibles de cette intégration étroite.
Pour les organisations qui adoptent cette pile, la nature complète de la pile d'IA JAX minimise le coût de la migration. Pour les clients qui utilisent des architectures de modèles ouverts populaires, le passage d'autres frameworks à MaxText se résume souvent à la configuration de fichiers de configuration. De plus, la capacité de la pile à ingérer des formats de points de contrôle populaires tels que safetensors permet de migrer les points de contrôle existants sans nécessiter de réentraînement coûteux.
Le tableau suivant fournit un mappage des composants fournis par la pile d'IA JAX et de leurs équivalents dans d'autres frameworks ou bibliothèques.
| Fonction | JAX | Alternatives/équivalents dans d'autres frameworks5 |
| Compilateur / environnement d'exécution | XLA | Inducteur, hâte |
| Entraînement MultiPod | Pathways | Stratégies Torch Lightning, Ray Train, Monarch (nouveau). |
| Framework de base | JAX | PyTorch |
| Création de modèles | Modèles Flax, Max* | torch.nn.*,
NVidia TransformerEngine, HuggingFace Transformers
|
| Optimiseurs et pertes | Optax | torch.optim.*, torch.nn.*Loss |
| Chargeurs de données | Grain | Ray Data, chargeurs de données HuggingFace |
| Points de contrôle | Orbax | Points de contrôle distribués PyTorch, points de contrôle NeMo |
| Quantification | Qwix | TorchAO, bitsandbytes |
| Création de kernels et implémentations connues | Pallas / Tokamax | Triton/Helion, Liger-kernel, TransformerEngine |
| Post-entraînement / réglage | Tunix | VERL, NeMoRL |
| Profilage | XProf | Profileur PyTorch, NSight Systems, NSight Compute |
| Entraînement de modèle de fondation | MaxText, MaxDiffusion | NeMo-Megatron, DeepSpeed, TorchTitan |
| Inférence de LLM | vLLM | SGLang |
| Inférence non LLM | NSE | Triton Inference Server, RayServe |
5 Certaines des équivalences présentées ici ne sont pas toujours de vraies comparaisons, car d'autres frameworks définissent les limites des API différemment de JAX. La liste des équivalents n'est pas exhaustive, et de nouvelles bibliothèques apparaissent fréquemment.
Conclusion : une plate-forme durable et prête pour la production pour l'avenir de l'IA
Les données fournies dans le tableau précédent illustrent une conclusion évidente : ces piles ont leurs propres forces et faiblesses dans un petit nombre de domaines, mais sont globalement très similaires du point de vue logiciel. Les deux piles fournissent des solutions clés en main pour le pré-entraînement, l'adaptation post-entraînement et le déploiement de modèles de fondation.
La pile d'IA JAX offre une solution robuste et intéressante pour entraîner et déployer des modèles de ML à n'importe quelle échelle. Il exploite une intégration verticale approfondie entre les logiciels et le matériel TPU pour offrir des performances et un coût total de possession de premier ordre.
En s'appuyant sur des systèmes internes éprouvés, la pile a évolué pour offrir une fiabilité et une évolutivité inhérentes, permettant aux utilisateurs de développer et de déployer en toute confiance même les modèles les plus volumineux. Sa conception modulaire et composable, ancrée dans la philosophie de la pile d'IA JAX, offre aux utilisateurs une liberté et un contrôle inégalés, leur permettant d'adapter la pile à leurs besoins spécifiques sans les contraintes d'un framework monolithique.
Avec XLA et Pathways qui fournissent une base évolutive et tolérante aux pannes, JAX qui fournit une bibliothèque numérique performante et expressive, des bibliothèques de développement de base puissantes comme Flax, Optax, Grain et Orbax, des outils de performances avancés comme Pallas, Tokamax et Qwix, et une couche d'application et de production robuste dans MaxText, vLLM et NSE, la pile d'IA JAX fournit une base durable sur laquelle les utilisateurs peuvent s'appuyer pour mettre rapidement en production des recherches de pointe.