


本文說明如何建立及最佳化脈絡資料集,協助資料代理應用程式提高 QueryData 查詢準確度。情境工程代理程式可自動建立及最佳化情境集,協助您建構、評估及改善情境集。
如要瞭解脈絡資料集和 QueryData,請參閱「脈絡資料集總覽」和「QueryData 總覽」。如要建構企業級資料應用程式,文字轉查詢模型的準確度通常需要接近 100% 的品質。生成的 SQL 不正確,會影響應用程式的整體可用性和使用者體驗。如要取得可解釋、與業務相關且準確度高的答案,就必須進行情境工程,也就是建立及反覆最佳化情境,以達到最佳準確度。
只要為 QueryData 提供與業務應用程式相關的背景資訊,就能提供精確的業務規則,讓系統解析細微的使用者意圖。
脈絡工程代理
脈絡工程代理會自動執行這項最佳化工作流程。您可以與代理對話,處理臨時工作,最佳化情境。以下列出一些自然語言提示範例,可用於指示代理,並說明代理的回應方式。請參考這些範例,建構及最佳化情境:
- 失敗分析的提示範例:「更新背景資訊,以便正確識別『迪士尼世界航班』等查詢的機場。」代理會分析失敗原因,並建議新增適當的情境項目,例如值搜尋查詢。
- 情境建議提示詞範例:「Read my app code and suggest some context to add.」(讀取我的應用程式程式碼,並建議要新增的情境。)代理會剖析程式碼、推論應用程式的領域,並建議相關的背景資訊項目。
- 大量處理的提示範例:「以下是 10 個問題和 SQL 查詢範例。將其轉換為範本。」代理會大量處理輸入內容,並更新脈絡集。
黃金資料集的重要性
如要最佳化脈絡,首先必須建立一個符合應用程式自然語言輸入情境的資料集。代理可協助您建立這個黃金資料集,其中包含使用者問題和預期的資料庫查詢。黃金資料集可讓您:
- 建立查詢效能基準。
- 根據基準真相資料庫查詢驗證更新內容。
- 評估各疊代的準確度提升幅度。
系統化的爬坡程序
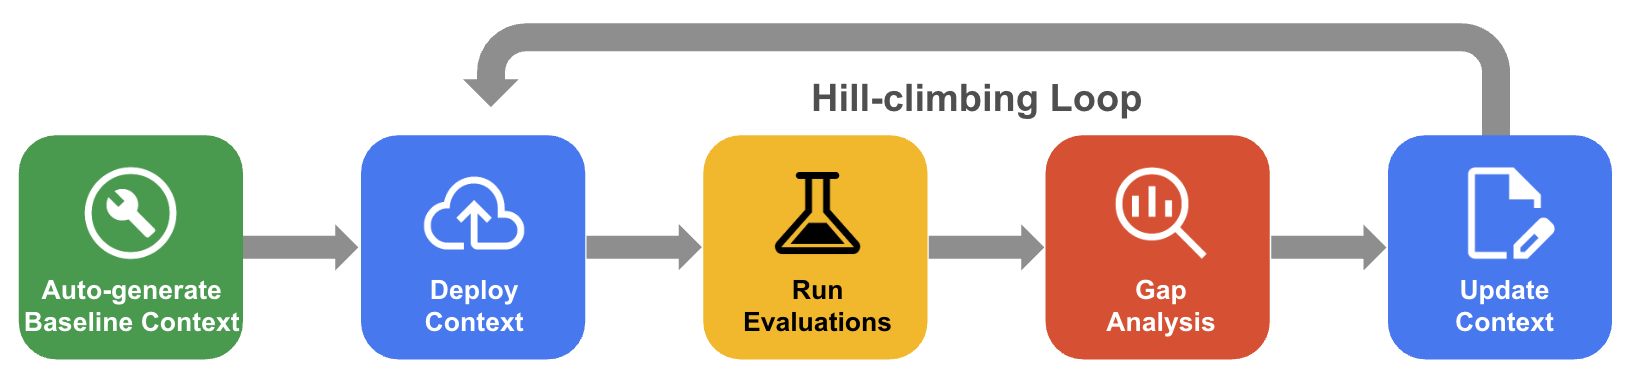
在系統化爬山演算法中,代理會透過評估黃金資料集、差距分析和更新,反覆改善情境集,將準確度提升至接近 100%。
- 自動生成基準內容:根據資料庫結構定義和應用程式構件,建立衍生起始內容集。
- 爬山演算法最佳化工作流程:讓代理程式評估 QueryData 的準確度、對失敗進行差距分析,並自動提出改善建議,以提高準確度。
下圖顯示系統性的爬山演算法工作流程:
事前準備
使用脈絡工程代理前,請先完成下列必要條件。
啟用必要服務
為專案啟用下列服務:準備 Cloud SQL 執行個體
請確認您可以存取現有的 Cloud SQL 執行個體,或建立新的執行個體。詳情請參閱「為 Cloud SQL 建立執行個體」。本教學課程需要您在 Cloud SQL 執行個體中建立資料庫。詳情請參閱「在 Cloud SQL 執行個體上建立資料庫」
所需角色和權限
- 將 IAM 使用者或服務帳戶新增至執行個體。詳情請參閱「使用 Cloud SQL 的 IAM 資料庫驗證機制管理使用者」。
- 在專案層級將
cloudsql.studioUser、cloudsql.instanceUser和geminidataanalytics.queryDataUser角色授予 IAM 使用者。詳情請參閱「新增專案的 IAM 政策繫結」。 - 如要建立、上傳及管理情境集,請在專案層級,將 Dataplex Catalog 編輯者 (
roles/dataplex.catalogEditor) 或 Dataplex Catalog 管理員 (roles/dataplex.catalogAdmin) 角色授予 IAM 使用者。詳情請參閱「情境集權限」。 - 您也必須以具備超級使用者權限的使用者 (例如
postgres使用者) 身分登入,將唯讀資料庫權限授予 IAM 使用者或服務帳戶。GRANT SELECT ON ALL TABLES IN SCHEMA public TO USER_NAME;
將 USER_NAME 替換為使用者的電子郵件地址。電子郵件地址含有特殊字元 (@ 和 .),因此必須加上引號。
詳情請參閱「將資料庫權限授予個別 IAM 使用者或服務帳戶」。
將 executesql 權限授予 Cloud SQL 執行個體
執行下列指令,將 executesql 權限授予 Cloud SQL 執行個體,並啟用 Cloud SQL Data API:
gcloud config set project PROJECT_ID
gcloud components update
gcloud beta sql instances patch INSTANCE_ID --data-api-access=ALLOW_DATA_API
PROJECT_ID: Google Cloud 專案的 ID。INSTANCE_ID:Cloud SQL 執行個體的 ID。
準備環境
您可以在任何本機開發環境或 IDE 中建構脈絡集檔案。如要準備環境,請完成下列步驟:
- 安裝內容比對引擎代理程式
- 設定資料庫連線
安裝內容比對引擎代理程式
情境工程代理會執行 Model Context Protocol (MCP) 伺服器,該伺服器需要 uv 才能管理基礎 Python 套件。
按照「安裝
uv」中的操作說明安裝uv。確認已安裝
uv,且可透過指令列存取:uv --version
如要準備環境,請在所選代理工具 (例如 Antigravity CLI、Claude Code 或 Gemini CLI) 中安裝脈絡工程代理。
根據所選的代理駕馭系統,按照對應的安裝步驟操作:
Antigravity CLI
如要在 Antigravity CLI 中安裝情境工程代理,請按照下列步驟操作:
- 安裝 Antigravity CLI。請參閱「開始使用 Antigravity CLI」。
- 安裝情境工程代理外掛程式,其中包含情境生成工作流程:
agy plugin install https://github.com/GoogleCloudPlatform/db-context-enrichment/tree/main/plugin
- 啟動 Antigravity CLI:
agy
如要將外掛程式更新至最新版本,請按照下列步驟操作:
agy plugin uninstall google-cloud-db-context-engineering
agy plugin install https://github.com/GoogleCloudPlatform/db-context-enrichment/tree/main/plugin
Claude Code
如要在 Claude Code 中安裝情境工程代理,請按照下列步驟操作:
- 新增外掛程式市集:
/plugin marketplace add https://github.com/GoogleCloudPlatform/db-context-enrichment.git
- 安裝外掛程式:
/plugin install db-context-engineering@db-context-enrichment-marketplace
- 重新載入外掛程式,讓變更生效:
/reload-plugins
- 更新外掛程式:
/plugin update db-context-engineering@db-context-enrichment-marketplace
Gemini CLI (已淘汰)
如要在 Gemini CLI 中安裝情境工程代理,請按照下列步驟操作:
- 安裝 Gemini CLI。請參閱「開始使用 Gemini CLI」。
- 安裝擴充功能:
gemini extensions install https://github.com/GoogleCloudPlatform/db-context-enrichment
- 更新擴充功能:
gemini extensions update mcp-db-context-enrichment
設定資料庫連線
代理程式需要資料庫連線才能擷取結構定義,並驗證產生的 SQL 內容語法。如要讓代理與資料庫互動,請設定驗證憑證,並定義資料庫連線設定。
設定應用程式預設憑證
設定應用程式預設憑證 (ADC),提供使用者憑證,以便從情境工程代理程式存取 Google Cloud 資源:
- Toolbox MCP 伺服器:使用憑證連線至資料庫、擷取結構定義,以及執行 SQL 進行驗證。
- Evalbench:使用憑證叫用 QueryData 進行評估。
在終端機中執行下列指令進行驗證:
gcloud auth application-default login設定資料庫連線檔案
代理需要資料庫連線才能生成背景資訊,MCP Toolbox 支援這項功能,並在設定檔中定義。
設定檔會指定資料庫來源,以及擷取結構定義或執行 SQL 時所需的工具。脈絡工程代理預先安裝了代理技能,可協助您生成設定。
啟動代理環境。
要求代理協助設定資料庫連線,例如輸入「help me set up the database connection」提示。按照代理程式的指示,在目前使用的目錄中建立設定檔,並命名為
autoctx/tools.yaml。如要套用新的
tools.yaml設定,請重新載入連線:- 在 Antigravity CLI 中執行
/mcp,然後選取toolbox重新啟動。 - 在 Gemini CLI 中執行
/mcp reload。 - 在 Cloud Code 中執行
/mcp,選取toolbox,然後選取Reconnect。
- 在 Antigravity CLI 中執行
如要進一步瞭解如何手動設定資料庫設定檔,請參閱「MCP Toolbox 設定」。
生成及最佳化背景資訊
情境工程代理提供一組代理技能和 MCP 工具,可強化程式設計代理的情境工程能力。您可以搭配使用這些工具,產生基準、評估成效,並反覆套用改善措施。不過,您可以在工作流程的任何階段開始:
- 如果已設定情境,可以直接進行評估。
- 如果您想修正失敗的查詢,可以直接進行差距分析。
每項功能都會說明代理的動作、用途和叫用指令。
範例提示說明如何以自然語言查詢代理程式。如果代理需要更多詳細資料才能完成要求,就會提示您提供說明。
建立及擴充評估資料集
如要提升成效,首先必須評估成效。如果沒有黃金資料集 (包含使用者問題和預期 SQL),就無法系統性地驗證情境工程。有了黃金資料集,每項變更都是可衡量的改善,您可以根據基準真相進行驗證。
手動建立具代表性的黃金資料集相當耗時,而且小型資料集可能無法涵蓋使用者用詞的變化。代理會採取下列行動解決這個問題:
- 根據資料庫結構定義,生成候選問題和 SQL 組合。
- 使用篩選器變化版本、同義詞和改寫方式,擴充小型種子資料集。
您也可以選擇讓代理對資料庫執行生成的 SQL。這項驗證可確保查詢順利執行,再將查詢新增至資料集。
資料集是 JSON 檔案,內含問題與 SQL 配對:
[
  {
    "id": "example_001",
    "nlq": "What is the total revenue for the top 5 products?",
    "golden_sql": "SELECT product_id, sum(net_revenue) FROM sales GROUP BY product_id ORDER BY sum(net_revenue) DESC LIMIT 5;"
  }
]
核准的配對會填入工作區中的 autoctx/golden.json 檔案,準備進行評估。您可以提供現有檔案,或在內嵌中編寫一些評估範例,供代理擴充。
您可以使用下列範例提示指示代理程式:
- 「Generate an evaluation dataset from my schema.」(根據我的結構定義生成評估資料集)。
- 「以下是種子問題和 SQL。將其擴展為更廣泛的資料集,並驗證執行的查詢。」
產生基準脈絡資料集
為避免從頭建立脈絡,您可以讓 AI 代理從資料庫結構定義和應用程式構件 (例如業務規則、範例查詢或 README 檔案) 衍生初始脈絡集。雖然這個基準情境並非最終版本,但可做為經過驗證的起點,以資料庫模型為基礎。
您可以使用下列範例提示詞,指示代理:
- 「Generate a context set from my schema.」(根據我的結構定義產生內容集。)
- 「使用這些結構定義和
requirements.md中的業務規則,產生初始脈絡。」
代理會提示您為實驗命名,以便整理生成的構件。如果資料庫結構定義較大,代理可能會要求您縮小範圍。如要使用 Cloud SQL Studio 上傳脈絡資料,請在代理生成 JSON 檔案後,按照操作說明進行。
評估情境成效
建立內容集和黃金資料集後,您可以透過每個黃金問題查詢資料代理程式的 QueryData API,讓代理程式評估內容成效。代理程式會使用 Evalbench 比較生成的 SQL 查詢及其執行結果與預期答案,以處理比較作業。
執行評估作業後,您會取得下列資訊:
- 量化指標,例如通過和失敗結果以及總分,可追蹤各情境疊代的進度。
- 內嵌對話摘要和詳細 CSV 報表,會寫入實驗資料夾中的
eval_reports/目錄。
如要開始評估,請提供黃金資料集路徑和內容集 ID。如要瞭解如何找出情境集 ID,請參閱「找出代理程式情境 ID」。
您可以使用下列範例提示詞,指示代理:
- 「根據
golden.json評估我的脈絡。」 - 「使用上次實驗的設定重新執行評估。」
如要重新執行先前產生的評估設定,不必再次設定,請詢問代理程式或直接叫用 CLI:
uvx google-evalbench --run_config=autoctx/experiments/my-experiment/eval_configs/run_config.json如要進一步瞭解評估設定結構定義,以及如何自訂評估執行作業,請參閱 Evalbench 說明文件。
進行差距分析並提出改善建議
如要解決查詢失敗的問題,您必須找出根本原因,例如資料欄不正確、缺少資料表彙整,或模糊字詞未解析。如要手動找出這些問題,必須深入分析評估報告。
代理會自動執行這項分析和修正循環:
- 差距分析:代理會讀取評估結果和您設定的情境,將類似的失敗案例分組,並建議新增特定情境,例如範本、面向或值搜尋。
- 建議修正方式:代理程式會建議具體的編輯內容,並視需要對資料庫測試 SQL,以驗證解決方案。
- 保留基準:代理會將改善項目寫入新的 JSON 檔案,並與基準結構定義一併儲存,保留原始檔案。
您可以使用下列範例提示指示代理程式:
- 「分析上次評估結果的落差,並提出修正建議。」
- 「根據
golden.json最佳化這組內容。」
為準備下一次疊代,請使用 Data Agents Studio 將改良後的內容上傳至目標內容集,請按照操作說明進行。
視需要建立特定情境項目
如果您已瞭解必要內容,例如特定問題的範本、重複篩選條件的層面,或特定資料欄的值搜尋,手動編寫內容 JSON 可能會在參數名稱、型別中繼資料或片段語法中,產生序列化錯誤。代理會處理 JSON 格式,讓您專注於業務意圖。
您也可以使用這項功能進行臨時更新,例如需要支援新的查詢模式,或解決缺少的結構定義詳細資料。如要取得 JSON,請向代理說明所需情境,不必執行評估或設定實驗。
當您接到一次性工作時,這項功能也相當實用:例如,利害關係人提供新的問題與 SQL 組合,希望您支援;或是在程式碼審查期間,您發現缺少某個面向。您不需要設定實驗或執行評估來修正問題,只要說明需求,代理程式就會產生 JSON。
您可以使用下列範例提示詞,指示代理:
- 「Create a template for: 'Which airports are in California?' with SQL:
SELECT name FROM airports WHERE country = 'United States' AND state = 'CA'." - 「為標示為『紅眼』的篩選器
departure_time BETWEEN '00:00:00' AND '06:00:00'建立構面。」 - 「建立
airports.iata的值搜尋。」
選擇脈絡類型的原因
無論是範本、構面或值搜尋,選取正確的內容類型都有助於避免內容膨脹和資料庫查詢迴歸。舉例來說,使用範本而非 facet 可能會導致規則重複,而在範本足以應付的情況下引入值搜尋,則可能增加查詢延遲時間。如要找出正確的結構定義格式,請在建立情境項目之前,提示代理根據查詢結構或資料庫資料欄推薦類型。代理會說明推論過程,協助您瞭解情境選項。
您可以使用下列範例提示指示代理程式:
- 「我一直在多個查詢中編寫篩選器
departure_time BETWEEN '00:00:00' AND '06:00:00'。如何才能拍出最棒的效果?」 - 「使用者以任意文字描述航班狀態,我想將這些文字與
flights.status進行比對。我該設定哪種值搜尋?" - 「範本和面向有何差異?兩者的使用時機為何?」
對脈絡資料集執行大量操作
代理支援大量更新,可一致管理大型脈絡集。如果需要同時更新多個內容項目,例如重新命名資料庫資料欄、變更程式碼值的格式,或範本參照已淘汰的資料表,代理程式可以對所有受影響的項目套用變更,而不更動不相關的項目。
您可以使用下列範例提示詞,指示代理:
- 「閱讀
golden.txt,並將所有配對轉換成範本。」 - 「在
context_set.json中,將參照『United』的任何項目中的airline = 'UA'替換為airline = 'United Airlines'。不要理會不相關的項目。
後續步驟
- 進一步瞭解情境組合。
- 瞭解如何在 Cloud SQL Studio 中建立或刪除情境集。
- 瞭解如何測試內容集。