


La replica è la capacità di creare copie di un'istanza Cloud SQL o di un database on-premise e di trasferire il lavoro alle copie.
Introduzione
Il motivo principale per utilizzare la replica è scalare l'utilizzo dei dati in un database senza compromettere le prestazioni.
Altri motivi sono:
- Migrazione dei dati tra regioni
- Migrazione dei dati tra piattaforme
- Migrazione dei dati da un database on-premise a Cloud SQL
Inoltre, una replica potrebbe essere promossa se l'istanza originale viene danneggiata.
Quando si fa riferimento a un'istanza Cloud SQL, l'istanza replicata è chiamata istanza principale e le copie sono chiamate repliche di lettura. L'istanza principale e le repliche di lettura si trovano in Cloud SQL.
Quando si fa riferimento a un database on-premise, lo scenario di replica è chiamato replica da un server esterno. In questo scenario, il database replicato è il server di database di origine. Le copie che si trovano in Cloud SQL sono chiamate repliche Cloud SQL. In Cloud SQL è presente anche un'istanza che rappresenta il server di database di origine, chiamata istanza di rappresentazione dell'origine.
In uno scenario di ripristino di emergenza, puoi promuovere una replica per convertirla in un'istanza principale. In questo modo, puoi utilizzarla al posto di un'istanza che si trova in una regione in cui si sta verificando un'interruzione. Puoi anche promuovere una replica per sostituire un'istanza danneggiata.
Cloud SQL supporta i seguenti tipi di repliche:
- Repliche di lettura
- Repliche di lettura tra regioni
- Repliche di lettura in cascata
- Repliche di lettura esterne
- Repliche Cloud SQL, quando eseguono la replica da un server esterno
Utilizzando l'applicazione forzata del connettore, puoi imporre l'utilizzo esclusivo del Cloud SQL Auth Proxy o dei connettori dei linguaggi di Cloud SQL per connetterti alle istanze Cloud SQL. Con l'applicazione del connettore, Cloud SQL rifiuta le connessioni dirette al database. Non puoi creare repliche di lettura per un'istanza in cui è abilitata l'applicazione del connettore. Analogamente, se un'istanza ha repliche di lettura, non puoi abilitare l'applicazione del connettore per l'istanza.
Puoi anche utilizzare Database Migration Service per la replica continua da un server di database di origine a Cloud SQL.Cloud SQL non supporta la replica tra due server esterni.
Tuttavia, Cloud SQL supporta la replica basata sull'ID transazione globale (GTID).
I GTID identificano in modo univoco ogni transazione sul server e all'interno di una configurazione di replica. Poiché ogni transazione ha un identificatore univoco, il server MySQL può tenere traccia delle transazioni eseguite. Un GTID utilizza coordinate assolute in modo che la replica di un'istanza Cloud SQL possa puntare alla sua istanza principale e non è necessario specificare un nome file per il log binario o una posizione nell'istruzione CHANGE MASTER. Si verificano meno errori con le repliche e con il recupero point-in-time. A causa di questi vantaggi, non puoi disabilitare la replica basata su GTID in Cloud SQL.
Repliche di lettura
Utilizza una replica di lettura per trasferire il lavoro da un'istanza Cloud SQL. La replica di lettura è una copia esatta dell'istanza principale. I dati e le altre modifiche nell'istanza principale vengono replicati e applicati in modo asincrono alla replica di lettura.
Le repliche di lettura sono di sola lettura; non puoi scrivere su di esse. La replica di lettura elabora le query, le richieste di lettura e il traffico di analisi, riducendo così il carico sull'istanza principale.
Puoi connetterti a una replica direttamente utilizzando il nome della connessione e l'indirizzo IP. Se ti connetti a una replica utilizzando un indirizzo IP privato, non devi creare una connessione privata VPC aggiuntiva per la replica perché la connessione viene ereditata dall'istanza principale.
Per informazioni su come creare una replica di lettura, consulta Creazione di repliche di lettura. Per informazioni sulla gestione di una replica di lettura, consulta Gestione delle repliche di lettura.
Come best practice, inserisci le repliche di lettura in una zona diversa rispetto all'istanza principale quando utilizzi l'alta affidabilità nell'istanza principale. In questo modo, le repliche di lettura continuano a funzionare quando la zona che contiene l'istanza principale subisce un'interruzione. Per saperne di più, consulta la panoramica dell'alta affidabilità.
Selezione di un tipo di macchina appropriato
Le repliche di lettura possono avere un numero di vCPU e una quantità di memoria diversi rispetto all'istanza principale. Devi monitorare le metriche dell'istanza, ad esempio l'utilizzo di CPU e memoria utilizzata, per assicurarti che l'istanza di replica sia dimensionata correttamente per il suo workload, soprattutto se è più piccola dell'istanza principale. Un'istanza di replica sottodimensionata è più soggetta a prestazioni scadenti, come frequenti eventi di memoria esaurita (OOM).
Capacità di archiviazione nelle repliche di lettura
Quando un'istanza principale viene ridimensionata, tutte le sue repliche di lettura vengono ridimensionate, se necessario, in modo che abbiano almeno la stessa capacità di archiviazione dell'istanza principale aggiornata.
Repliche di lettura tra regioni
La replica tra regioni consente di creare una replica di lettura in una regione diversa da quella dell'istanza principale. Puoi creare una replica di lettura tra regioni nello stesso modo in cui crei una replica all'interno della regione.
Repliche tra regioni:
- Migliora le prestazioni di lettura rendendo disponibili le repliche più vicine alla regione della tua applicazione.
- Fornire una funzionalità di ripristino di emergenza aggiuntiva per proteggersi da un errore a livello di regione.
- Eseguire la migrazione dei dati da una regione all'altra.
Per saperne di più sulle repliche tra regioni, consulta Promozione delle repliche per la migrazione regionale o il disaster recovery.
Repliche di lettura in cascata
La replica a cascata consente di creare una replica di lettura sotto un'altra replica di lettura nella stessa regione o in una regione diversa. I seguenti scenari sono casi d'uso per l'utilizzo di repliche a cascata:
- Disaster recovery: puoi utilizzare una gerarchia a cascata di repliche di lettura per simulare la topologia dell'istanza principale e delle relative repliche di lettura. Durante un'interruzione, quando promuovi una replica di lettura a principale, le repliche di lettura di questa nuova replica principale continuano a replicare e sono pronte per l'uso.
- Miglioramenti delle prestazioni: riduci il carico sull'istanza principale trasferendo il lavoro di replica a più repliche di lettura.
- Scalabilità delle letture: puoi avere più repliche per condividere il carico di lettura.
- Riduzione dei costi: puoi ridurre i costi di networking utilizzando una singola replica a cascata con replica tra regioni in altre regioni.
Terminologia
- Replica a cascata: una replica di lettura che può avere una propria replica.
- Livelli: puoi creare livelli di repliche in una gerarchia di repliche a cascata. Ad esempio, se aggiungi quattro repliche a un'istanza, queste quattro repliche si trovano allo stesso livello.
- Istanze di pari livello: più repliche che eseguono la replica dalla stessa istanza principale. Le repliche di pari livello si trovano allo stesso livello nella gerarchia delle repliche. Una replica può avere ufficialmente fino a otto repliche di pari livello.
- Replica foglia: una replica di lettura che non ha repliche proprie. In una gerarchia di replica multilivello, la replica foglia è l'ultimo livello.
- Promuovi Un'azione che converte una replica, a qualsiasi livello della gerarchia, in un'istanza principale. Quando viene promossa, la gerarchia delle repliche a cascata della replica viene mantenuta.
Configura le repliche a cascata
Le repliche a cascata ti consentono di aggiungere repliche di lettura a qualsiasi replica esistente. Puoi aggiungere fino a quattro livelli di repliche, inclusa l'istanza principale. Quando promuovi la replica in cima a una gerarchia di repliche a cascata, questa diventa un'istanza principale e le sue repliche a cascata continuano a replicare.
Per pianificare la configurazione, devi avere un obiettivo per ciò che le repliche di lettura devono fare. Le due sezioni successive descrivono le configurazioni per il ripristino di emergenza e la replica multiregionale.
Disaster recovery
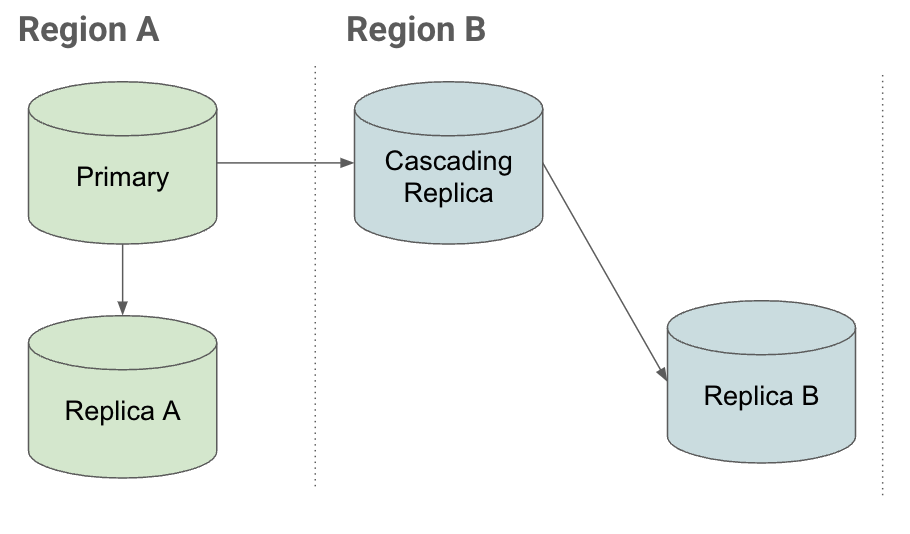
Per capire in che modo le repliche a cascata ti aiutano a eseguire rapidamente il recupero durante un'interruzione, considera il seguente scenario di replica:
Configurazione
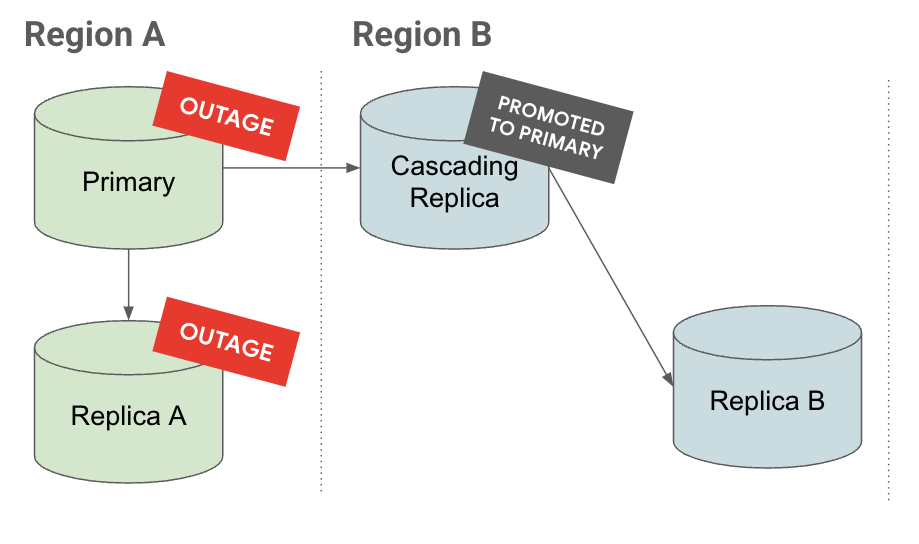
Interruzione
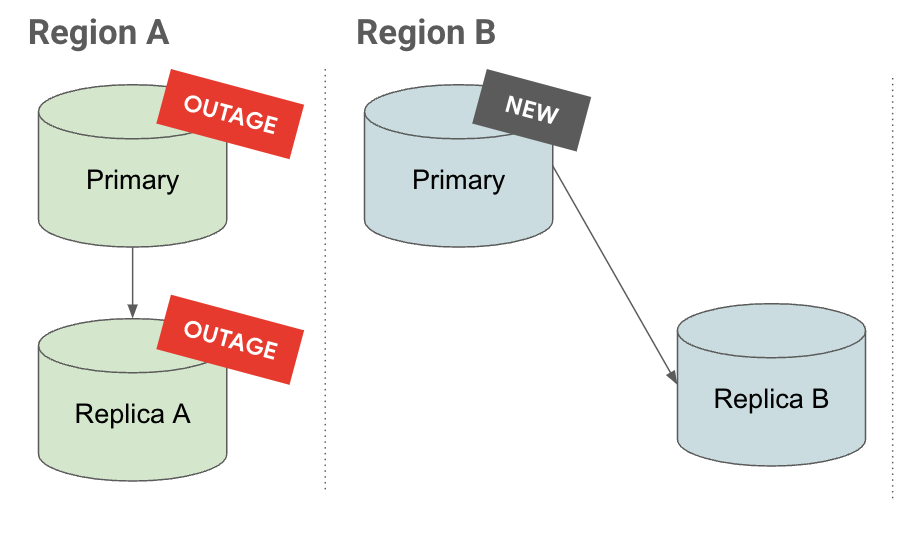
Promozione
Se vuoi utilizzare un'istanza nella Regione B in una configurazione di ripristino di emergenza e hai:
- Repliche nella stessa regione collegate all'istanza principale (Replica A)
- Repliche in altre regioni (replica a cascata) collegate alla replica principale.
Puoi creare repliche di lettura nella replica a cascata nella Regione B.
Nella scheda Interruzione, se si verifica un'interruzione nella Regione A, la replica a cascata viene promossa a istanza principale. Dispone già di repliche di lettura, riducendo il Recovery Time Objective (RTO).
Nella scheda Promuovi, puoi vedere che quando una replica a cascata viene promossa, anche le sue repliche vengono promosse e continuano a replicare sotto di essa.
Replica multiregionale
Un altro caso d'uso delle repliche a cascata è la distribuzione della capacità di lettura in una seconda regione in modo conveniente. È possibile creare repliche a cascata C e D che replicano dalla replica B. I client possono distribuire le query di lettura tra le repliche B, C e D per ridurre il carico su ciascuna replica. Il costo del traffico di rete tra regioni viene addebitato una sola volta, dall'istanza principale alla Replica B. La replica da B a C e D utilizza il trasferimento di rete all'interno della regione, che è senza costi.
Puoi creare una gerarchia di massimo quattro istanze utilizzando le repliche a cascata per la replica multiregionale:
Replica principale A → Replica B → Replica C e Replica D
Limitazioni
- Non puoi eliminare una replica che ha delle repliche al di sotto. Per eliminare la replica, devi iniziare dalle repliche foglia e procedere verso l'alto nella gerarchia.
- La dipendenza circolare tra regioni non è supportata. Non puoi eseguire la replica da una regione all'altra e poi di nuovo alla regione originale. Per avere la replica di una replica a cascata nella stessa regione dell'istanza principale, anche la replica a cascata deve trovarsi nella stessa regione.
Repliche di lettura esterne
Le repliche di lettura esterne sono istanze MySQL esterne che vengono replicate da un'istanza principale Cloud SQL. Ad esempio, un'istanza MySQL in esecuzione su Compute Engine è considerata un'istanza esterna.
Le repliche di lettura esterne presentano le seguenti limitazioni:
- L'istanza principale per la replica esterna non può essere una replica di lettura Cloud SQL.
- La replica in un'istanza MySQL ospitata da un'altra piattaforma cloud potrebbe non essere possibile. Consulta la documentazione dell'altro provider. Ad esempio,
è necessario impostare il campo di configurazione
replicate-ignore-dbe i provider cloud in cui ciò non è consentito non sono supportati. Consulta Configurazione delle repliche esterne per altri campi di configurazione obbligatori. - Se la replica viene interrotta per alcune ore, ad esempio a causa di un'interruzione della rete o del server, la replica rimane indietro rispetto alla replica principale. La replica si aggiorna una volta che si riconnette all'istanza principale e inizia di nuovo la replica. Tuttavia, se la replica viene interrotta per un periodo di tempo superiore a quello di conservazione dei log di replica di Cloud SQL (sette backup), devi eliminare la replica e crearne una nuova.
- I dati che passano dalla replica principale a quella esterna vengono addebitati come trasferimento di dati in uscita. Consulta la pagina dei prezzi per i prezzi del trasferimento di dati per il tuo tipo di istanza Cloud SQL.
Se crei una replica di lettura esterna per un'istanza e applichi l'utilizzo solo del Cloud SQL Auth Proxy o dei connettori dei linguaggi di Cloud SQL per connetterti a un'istanza per cui è configurato l'accesso privato ai servizi, devi aggiungere gli intervalli di subnet della replica alle reti autorizzate dell'istanza principale. Devi configurare tutti gli intervalli come reti autorizzate dell'istanza Cloud SQL.
gcloud
Per impostare l'autorizzazione IP per un'istanza in modo da consentire il traffico proveniente da intervalli di indirizzi IP di una replica di lettura esterna, utilizza il comando
gcloud sql instances patch:gcloud sql instances patch \ --authorized-networks=IP_ADDRESS_RANGE_1/24,IP_ADDRESS_RANGE_2/24
Sostituisci IP_ADDRESS_RANGE_1 e IP_ADDRESS_RANGE_2 con gli intervalli di indirizzi IP della replica di lettura esterna.
REST
Prima di utilizzare i dati della richiesta, apporta le sostituzioni seguenti:
- PROJECT_ID: l'ID o il numero di progetto del progetto Google Cloud che contiene l'istanza
- INSTANCE_NAME: il nome dell'istanza Cloud SQL
- IP_ADDRESS_RANGE_1: il primo intervallo di indirizzi IP della replica di lettura esterna
- IP_ADDRESS_RANGE_2: il secondo intervallo di indirizzi IP della replica di lettura esterna
Metodo HTTP e URL:
PATCH https://sqladmin.googleapis.com/v1/projects/PROJECT_ID/instances/INSTANCE_NAME
Corpo JSON della richiesta:
{
  "kind": "sql#instance",
  "name": INSTANCE_NAME,
  "project": PROJECT_ID,
  "settings": {
    "ipConfiguration": {
      "authorizedNetworks": [{"kind": "sql#aclEntry", "value": "IP_ADDRESS_RANGE_1/24"}, {"kind": "sql#aclEntry", "value": "IP_ADDRESS_RANGE_2/24"}]},
  "kind": "sql#settings"
  }
}
Per inviare la richiesta, espandi una di queste opzioni:
Dovresti ricevere una risposta JSON simile alla seguente:
{
  "kind": "sql#operation",
  "targetLink": "https://sqladmin.googleapis.com/v1/projects/PROJECT_ID/instances/INSTANCE_NAME",
  "status": "PENDING",
  "user": "user@example.com",
  "insertTime": "2020-01-16T02:32:12.281Z",
  "operationType": "UPDATE",
  "name": "OPERATION_ID",
  "targetId": "INSTANCE_NAME",
  "selfLink": "https://sqladmin.googleapis.com/v1/projects/PROJECT_ID/operations/OPERATION_ID",
  "targetProject": "PROJECT_ID"
}
Casi d'uso della replica
I seguenti casi d'uso si applicano a ciascun tipo di replica.
| Nome | Principale | Replica | Vantaggi e casi d'uso | Ulteriori informazioni |
|---|---|---|---|---|
| Replica in lettura | Istanza Cloud SQL | Istanza Cloud SQL |
|
|
| Replica di lettura tra regioni | Istanza Cloud SQL | Istanza Cloud SQL |
|
|
| Replica di lettura esterna | Istanza autonoma o principale di Cloud SQL | Istanza MySQL esterna a Cloud SQL |
|
|
| Replica da un server esterno | Istanza MySQL esterna a Cloud SQL | Istanza Cloud SQL per MySQL |
|
Prerequisiti per la creazione di una replica di lettura
Prima di poter creare una replica di lettura di un'istanza Cloud SQL principale, l'istanza deve soddisfare i seguenti requisiti:
- I backup automatici devono essere abilitati.
- Il logging binario deve essere abilitato, il che richiede l'abilitazione del recupero point-in-time. Scopri di più sull'impatto di questi log.
- Deve essere stato creato almeno un backup dopo l'attivazione del logging binario.
Requisiti aggiuntivi per la replica esterna:
- La versione MySQL della replica deve essere uguale o successiva alla versione MySQL dell'istanza principale. Scopri di più.
- Per motivi di sicurezza, devi configurare SSL/TLS nell'istanza principale. Scopri di più.
Impatto dell'abilitazione del logging binario
Devi abilitare il recupero point-in-time per abilitare il logging binario sull'istanza principale per supportare le repliche di lettura. Questo ha i seguenti impatti:
- Overhead delle prestazioni
Cloud SQL utilizza la replica basata su righe con i flag MySQL
sync_binlog=1einnodb_support_xa=true. Pertanto, per ogni operazione di scrittura è necessario un fsync del disco aggiuntivo, il che riduce le prestazioni. - Overhead di archiviazione
L'archiviazione dei log binari viene addebitata alla stessa tariffa dei dati normali. I log binari vengono troncati automaticamente all'età del backup automatico meno recente. Cloud SQL conserva i sette backup automatici più recenti e tutti i backup on demand. Le dimensioni dei log binari, e quindi l'importo addebitato, dipendono dal workload. Ad esempio, un workload con un numero elevato di operazioni di scrittura consuma più spazio per i log binari rispetto a un workload con un numero elevato di operazioni di lettura.
Puoi visualizzare le dimensioni dei log binari utilizzando il comando MySQL SHOW BINARY LOGS.
Quando vengono eseguiti i backup, i log vengono archiviati nel backup insieme ai dati.
Logging binario sulle repliche di lettura
- Il logging binario è supportato nelle istanze di replica di lettura (solo MySQL 5.7 e 8.0). Puoi abilitare il logging binario su una replica con gli stessi
comandi API utilizzati
per l'istanza principale, utilizzando il nome dell'istanza della replica anziché il nome
dell'istanza principale. Tieni presente che i termini
enable binary loggingeenable point-in-time recoverysono intercambiabili.La durabilità del logging binario nell'istanza di replica (ma non in quella principale) può essere impostata con il flag
sync_binlog, che controlla la frequenza con cui il server MySQL sincronizza il log binario sul disco.Il logging binario può essere abilitato su una replica anche se il backup è disabilitato sulla replica principale.
Se una replica con questo valore impostato viene promossa a server autonomo, l'impostazione viene reimpostata sul valore sicuro
1sul server autonomo.
Fatturazione
- Una replica di lettura viene addebitata alla stessa tariffa di un'istanza Cloud SQL standard. Non è previsto alcun costo per la replica dei dati.
- Per le repliche esterne, i dati che passano dalla replica principale a quella esterna vengono addebitati come trasferimento di dati. Consulta la pagina dei prezzi per i prezzi del trasferimento di dati per il tuo tipo di istanza Cloud SQL.
- I prezzi per una replica di lettura tra regioni sono gli stessi della creazione di una nuova istanza Cloud SQL nella regione. Consulta i prezzi delle istanze Cloud SQL e seleziona la regione appropriata. Oltre al costo normale associato all'istanza, una replica tra regioni comporta addebiti per il trasferimento di dati tra regioni per i log di replica inviati dall'istanza principale all'istanza di replica, come descritto in Prezzi del traffico di rete in uscita.
Riferimento rapido per le repliche di lettura di Cloud SQL
| Argomento | Discussione |
|---|---|
| Backup | Non puoi configurare i backup sulla replica. |
| Core e memoria | Le repliche di lettura possono utilizzare un numero di core e una quantità di memoria diversi da quelli dell'istanza principale. |
| Eliminazione dell'istanza principale | Prima di poter eliminare un'istanza principale, devi promuovere tutte le sue repliche di lettura a istanze autonome o eliminarle. |
| Eliminazione della replica | L'eliminazione di una replica non influisce sullo stato dell'istanza principale. |
| Disabilitazione del logging binario | Prima di poter disabilitare i log binari su un'istanza principale, devi promuovere o eliminare tutte le relative repliche di lettura. |
| Failover | Un'istanza principale può eseguire il failover su una replica solo se quest'ultima è una replica di RE. Le repliche di lettura non possono eseguire il failover in alcun modo durante un'interruzione. |
| Alta affidabilità | Le repliche di lettura consentono di attivare l'alta affidabilità sulle repliche. |
| Bilanciamento del carico | Cloud SQL non fornisce il bilanciamento del carico tra le repliche. Puoi scegliere di implementare il bilanciamento del carico per l'istanza Cloud SQL. Puoi anche utilizzare il pooling delle connessioni per distribuire le query tra le repliche con la configurazione del bilanciamento del carico per migliorare le prestazioni. |
| Periodi di manutenzione | Le repliche di lettura condividono i periodi di manutenzione con l'istanza principale. Le repliche seguono le impostazioni di manutenzione dell'istanza principale, tra cui il periodo di manutenzione, la riprogrammazione e il periodo in cui evitare la manutenzione. Durante la manutenzione, Cloud SQL aggiorna prima tutte le repliche di lettura e poi l'istanza principale. |
| Più repliche di lettura | Cloud SQL supporta le repliche a cascata. Di conseguenza, puoi creare fino a 10 repliche per una singola istanza principale e creare repliche di queste repliche, fino a quattro livelli, inclusa l'istanza principale. |
| Replica parallela | Per informazioni sull'utilizzo della replica parallela per migliorare le prestazioni, consulta Configurazione della replica parallela. |
| IP privato | Se ti connetti a una replica utilizzando un indirizzo IP privato, non devi creare una connessione privata VPC aggiuntiva per la replica, poiché viene ereditata dall'istanza principale. |
| Ripristino dell'istanza principale | Non puoi ripristinare l'istanza principale di una replica mentre la replica esiste. Prima di ripristinare un'istanza da un backup o di eseguire un recupero point-in-time, devi promuovere o eliminare tutte le sue repliche. |
| Impostazioni | Le impostazioni MySQL dell'istanza principale vengono propagate alla replica, incluse la password root e le modifiche alla tabella utenti. Le modifiche alla CPU e alla memoria non vengono propagate alla replica. |
| Arresto di una replica | Non puoi stop una replica. Puoi restart,
delete o disable replication, ma non puoi arrestarla come un'istanza principale. |
| Upgrade di una replica | Le repliche di lettura possono subire un upgrade invasivo in qualsiasi momento. |
| Tabelle degli utenti | Non puoi apportare modifiche alla replica. Tutte le modifiche degli utenti devono essere eseguite sull'istanza principale. |
Passaggi successivi
- Scopri come creare una replica di lettura.
- Scopri come configurare una replica esterna.
- Scopri come replicare i dati da un server esterno.
- Scopri come configurare un server esterno.
- Scopri di più sulla replica in MySQL.
- Scopri come configurare un'istanza per l'alta affidabilità.
- Scopri di più sul disaster ripristino di emergenza (RE) avanzato