


Questa pagina spiega come rilevare le variazioni della velocità di esecuzione delle query, esaminare i piani di esecuzione delle query e specificare un indice diverso per le query future, se necessario.
Ottieni il profilo dettagliato di una query in formato JSON utilizzando l'API REST
Per impostazione predefinita, quando esegui una query, l'API restituisce solo i risultati dell'istruzione.
Questo perché queryMode è impostato su NORMAL. Per includere statistiche di esecuzione dettagliate nei risultati della query, imposta queryMode su PROFILE.
Crea una sessione
Prima di aggiornare la modalità di query, crea una sessione, che rappresenta un canale di comunicazione con il servizio di database Spanner.
- Vai alla pagina
projects.instances.databases.sessions.create. Fornisci l'ID progetto, l'ID istanza e l'ID database nel seguente formato:
projects/PROJECT_ID/instances/INSTANCE_ID/databases/DATABASE_IDFai clic su Esegui. La risposta mostra la sessione che hai creato in questo formato:
projects/PROJECT_ID/instances/INSTANCE_ID/databases/DATABASE_ID/sessions/SESSION_IDUtilizza questa sessione per profilare la query nel passaggio successivo. Una sessione rimane attiva per un massimo di un'ora tra utilizzi consecutivi prima che Spanner la elimini.
Per ulteriori informazioni su come utilizzare le sessioni, consulta Sessioni.
Profila la query
Attiva la modalità PROFILE per la query.
- Vai alla pagina
projects.instances.databases.sessions.executeSql. In session, inserisci l'ID sessione che hai creato in Crea una sessione:
projects/PROJECT_ID/instances/INSTANCE_ID/databases/DATABASE_ID/sessions/SESSION_IDPer Corpo della richiesta, utilizza quanto segue:
{ "sql": "SQL_QUERY", "queryMode": "PROFILE" }Fai clic su Esegui. La risposta include i risultati della query, il piano di query e le statistiche di esecuzione della query.
Risolvi i problemi relativi all'utilizzo degli indici
Quando utilizzi query SQL per cercare i dati, Spanner utilizza automaticamente tutti gli indici secondari che probabilmente recupereranno i dati in modo più efficiente. Tuttavia, in alcuni casi, Spanner potrebbe scegliere un indice che rallenta le query. Di conseguenza, potresti notare che alcune query vengono eseguite più lentamente del previsto.
Rileva le variazioni nella velocità di esecuzione delle query
È molto probabile che tu veda una variazione della velocità di esecuzione delle query dopo aver apportato una di queste modifiche:
- Modifica significativa di una grande quantità di dati esistenti con un indice secondario.
- Aggiunta, modifica o eliminazione di un indice secondario.
Puoi utilizzare diversi strumenti per identificare una query specifica che Spanner sta eseguendo più lentamente del solito:
- Query Insights e Statistiche sulle query.
Metriche specifiche per l'applicazione che acquisisci e analizzi con Cloud Monitoring. Ad esempio, puoi monitorare la metrica Conteggio delle query per determinare il numero di query in un'istanza nel tempo e per scoprire quale versione dell'ottimizzatore delle query è stata utilizzata per eseguire una query.
Strumenti di monitoraggio lato client che misurano le prestazioni della tua applicazione.
Statistiche dello strumento di ottimizzazione per i database appena creati
Quando esegui query su database appena creati con dati appena inseriti o importati, Spanner potrebbe non selezionare gli indici più appropriati perché l'ottimizzatore delle query impiega fino a tre giorni per raccogliere automaticamente le statistiche. Per ottimizzare l'utilizzo dell'indice di un nuovo database Spanner prima di questo periodo, puoi creare manualmente un nuovo pacchetto di statistiche.
Esamina lo schema
Dopo aver trovato la query che ha rallentato, esamina l'istruzione SQL della query e identifica le tabelle utilizzate dall'istruzione e le colonne che recupera da queste tabelle.
Poi, individua gli indici secondari esistenti per queste tabelle. Determina se uno degli indici include le colonne su cui stai eseguendo la query, il che significa che Spanner potrebbe utilizzare uno degli indici per elaborare la query.
- Se sono presenti indici applicabili, il passaggio successivo consiste nel trovare l'indice utilizzato da Spanner per la query.
Se non sono presenti indici applicabili, utilizza il comando
gcloud spanner operations
list
per verificare se di recente hai eliminato un indice applicabile:gcloud spanner operations list \ --instance=INSTANCE \ --database=DATABASE \ --filter="@TYPE:UpdateDatabaseDdlMetadata"Se hai eliminato un indice applicabile, questa modifica potrebbe aver influito sulle prestazioni delle query. Aggiungi nuovamente l'indice secondario alla tabella. Dopo che Spanner ha aggiunto l'indice, esegui nuovamente la query e osserva le sue prestazioni. Se le prestazioni non migliorano, il passaggio successivo consiste nel trovare l'indice utilizzato da Spanner per la query.
Se non hai eliminato un indice applicabile, la selezione dell'indice non ha causato la regressione delle prestazioni delle query. Cerca altre modifiche ai dati o ai pattern di utilizzo che potrebbero aver influito sul rendimento.
Trova l'indice utilizzato per una query
Per scoprire quale indice utilizza Spanner per elaborare una query, visualizza il piano di esecuzione delle query nella console Google Cloud :
Vai alla pagina Istanze di Spanner nella consoleGoogle Cloud .
Fai clic sul nome dell'istanza su cui vuoi eseguire la query.
Nel menu di navigazione, seleziona il database su cui vuoi eseguire la query, quindi fai clic su Spanner Studio.
Inserisci la query da testare.
Nel menu Esegui query, seleziona Solo spiegazione. Spanner visualizza il piano di query.
Cerca almeno uno dei seguenti operatori nel piano di query:
- Scansione della tabella
- Scansione dell'indice
- Cross apply o distributed cross apply
Le sezioni seguenti spiegano il significato di ciascun operatore.
Operatore di scansione della tabella
L'operatore scansione tabella indica che Spanner non ha utilizzato un indice secondario:
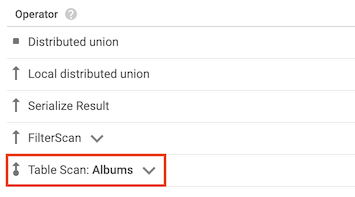
Ad esempio, supponiamo che la tabella Albums non abbia indici secondari e che tu esegua la seguente query:
SELECT AlbumTitle FROM Albums WHERE STARTS_WITH(AlbumTitle, "Now");
Poiché non sono presenti indici da utilizzare, il piano di query include un operatore di scansione della tabella.
Operatore di scansione dell'indice
L'operatore index scan indica che Spanner ha utilizzato un indice secondario durante l'elaborazione della query:
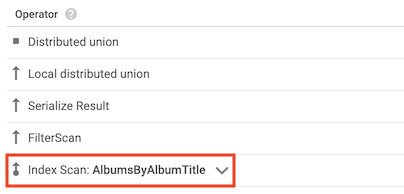
Ad esempio, supponiamo di aggiungere un indice alla tabella Albums:
CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);
Quindi esegui la seguente query:
SELECT AlbumTitle FROM Albums WHERE STARTS_WITH(AlbumTitle, "Now");
L'indice AlbumsByAlbumTitle contiene AlbumTitle, che è l'unica colonna selezionata dalla query. Di conseguenza, il piano di query include un operatore di scansione dell'indice.
Operatore CROSS APPLY
In alcuni casi, Spanner utilizza un indice che contiene solo alcune delle colonne selezionate dalla query. Di conseguenza, Spanner deve unire l'indice alla tabella di base.
Quando si verifica questo tipo di join, il piano di query include un operatore cross apply o distributed cross apply con i seguenti input:
- Un operatore di scansione dell'indice per l'indice di una tabella
- Un operatore di scansione della tabella per la tabella proprietaria dell'indice
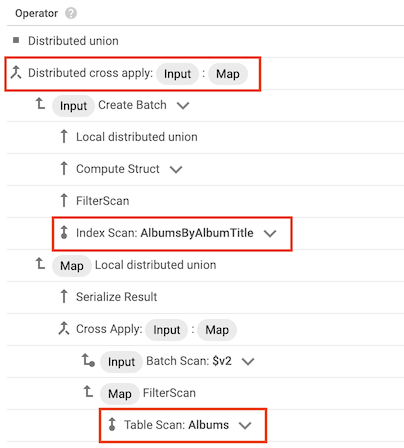
Ad esempio, supponiamo di aggiungere un indice alla tabella Albums:
CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);
Quindi esegui la seguente query:
SELECT * FROM Albums WHERE STARTS_WITH(AlbumTitle, "Now");
L'indice AlbumsByAlbumTitle contiene AlbumTitle, ma la query seleziona tutte le colonne della tabella, non solo AlbumTitle. Di conseguenza, il piano di query include un operatore di cross apply distribuito, con una scansione dell'indice di AlbumsByAlbumTitle e una scansione della tabella di Albums come input.
Scegli un altro indice
Dopo aver trovato l'indice utilizzato da Spanner per la query, prova a eseguire la query con un indice diverso o scansionando la tabella di base anziché utilizzare un indice. Per specificare l'indice, aggiungi una direttiva FORCE_INDEX alla query.
Se trovi una versione più veloce della query, aggiorna l'applicazione in modo che utilizzi la versione più veloce.
Linee guida per la scelta di un indice
Utilizza queste linee guida per decidere quale indice testare per la query:
Se la query soddisfa uno di questi criteri, prova a utilizzare la tabella di base anziché un indice secondario:
- La query verifica l'uguaglianza con un prefisso della chiave primaria della tabella di base (ad esempio
SELECT * FROM Albums WHERE SingerId =
1
). - Un numero elevato di righe soddisfa i predicati della query (ad esempio,
SELECT * FROM Albums WHERE AlbumTitle != "There Is No Album With This
Title"
). - La query utilizza una tabella di base che contiene solo poche centinaia di righe.
- La query verifica l'uguaglianza con un prefisso della chiave primaria della tabella di base (ad esempio
Se la query contiene un predicato molto selettivo (ad esempio,
REGEXP_CONTAINS,STARTS_WITH,<,<=,>,>=o!=), prova a utilizzare un indice che includa le stesse colonne che utilizzi nel predicato.
Testa la query aggiornata
Utilizza la console Google Cloud per testare la query aggiornata e scoprire quanto tempo è necessario per elaborarla.
Se la query include parametri di query e un parametro di query è associato ad alcuni valori molto più spesso di altri, associa il parametro di query a uno di questi valori nei test. Ad esempio, se la query include un predicato come WHERE country = @countryId e quasi tutte le query associano @countryId al valore US, associa @countryId a US per i test delle prestazioni. Questo approccio ti consente di ottimizzare le query che esegui più di frequente.
Per testare la query aggiornata nella console Google Cloud , segui questi passaggi:
Vai alla pagina Istanze di Spanner nella consoleGoogle Cloud .
Fai clic sul nome dell'istanza su cui vuoi eseguire la query.
Nel menu di navigazione, fai clic sul database su cui vuoi eseguire la query, quindi su Spanner Studio.
Inserisci la query da testare, inclusa l'istruzione
FORCE_INDEX, e fai clic su Esegui query.La console Google Cloud apre la scheda Tabella dei risultati, quindi mostra i risultati della query, incluso il tempo impiegato dal servizio Spanner per elaborare la query.
Questa metrica non include altre fonti di latenza, come il tempo impiegato dalla console Google Cloud per interpretare e visualizzare i risultati della query.
Limitazione delle query
Durante l'esecuzione delle query, Spanner può limitarle in diversi punti.
Tempo di attesa del client e Ritardo della coda del server sono le due metriche principali di limitazione.
Tempo di attesa del client
Tempo di attesa del client rappresenta la quantità di tempo che il client Spanner attende che l'applicazione consumi i risultati. Ciò indica che il client non può elaborare i risultati con la stessa velocità con cui Spanner li produce. Per risolvere il problema, aumenta le prestazioni dell'applicazione di consumo o memorizza nel buffer tutti i risultati nell'applicazione client ed elaborali al termine della query.
Ritardo coda server
Il ritardo della coda del server si verifica quando il server di elaborazione ritarda la pianificazione dell'esecuzione delle query. Nel riquadro Riepilogo query, controlla la metrica Ritardo coda server. Se la metrica non è presente, non si è verificato alcun ritardo del server.
Questo ritardo può indicare che i server che eseguono la query sono sovraccarichi. Per verificare se esiste un hotspot, consulta Trova gli hotspot nel tuo database. Per risolvere i problemi relativi agli hotspot, consulta Risolvi i problemi relativi agli hotspot utilizzando le statistiche di suddivisione a caldo.
Dati modificati di recente
Le modifiche ai dati della tabella possono influire sulle prestazioni delle query.
Pacchetto statistiche obsoleto
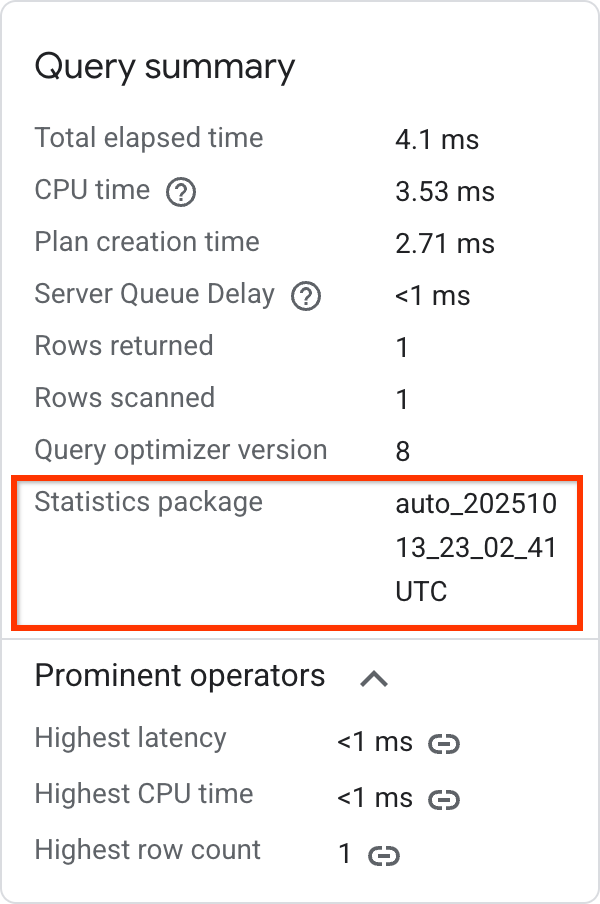
Se l'ottimizzatore utilizza un pacchetto di statistiche non aggiornato, potrebbe scegliere un piano non ottimale. Nella sezione Riepilogo query, puoi controllare il pacchetto di statistiche.
Se il pacchetto è obsoleto o mancante, esegui ANALYZE per assicurarti che le statistiche dell'ottimizzatore siano aggiornate.
Per saperne di più, consulta Pacchetti di statistiche.
Modifiche ai contenuti della tabella
Le prestazioni delle query dipendono dai dati che elaborano. Il modo migliore per risolvere un problema di prestazioni delle query dipende da come sono cambiati i dati:
- Asimmetria nella distribuzione dei valori: il pacchetto di statistiche acquisisce questa asimmetria, ma Query Optimizer può utilizzare queste informazioni solo quando utilizzi valori letterali nella query.
- Grande variazione del numero di righe: valuta se i predicati filtrano sufficientemente le righe man mano che le dimensioni della tabella aumentano.
- Asimmetria nella dimensione dei valori: l'asimmetria nella dimensione dei valori è problematica se combinata con predicati scalari costosi (ad esempio, l'esecuzione di un predicato
LIKEsu un valoreSTRINGche contiene stringhe di grandi dimensioni).
Per ottenere ulteriori insight sull'esecuzione delle query, utilizza l'API REST.