


Wie unter Abfrageausführungspläne beschrieben, wandelt der SQL-Compiler eine SQL-Anweisung in einen Abfrageausführungsplan um, mit dem die Ergebnisse der Abfrage abgerufen werden. Auf dieser Seite werden Best Practices für das Erstellen von SQL-Anweisungen beschrieben, damit Spanner effiziente Ausführungspläne finden kann. Weitere Informationen zur Verbesserung der Abfrageleistung finden Sie im [Leitfaden zur Abfrageoptimierung][query_tuning].
In den SQL-Beispielanweisungen auf dieser Seite wird das folgende Beispielschema verwendet:
GoogleSQL
CREATE TABLE Singers (
 SingerId   INT64 NOT NULL,
 FirstName  STRING(1024),
 LastName   STRING(1024),
 SingerInfo BYTES(MAX),
 BirthDate  DATE
) PRIMARY KEY (SingerId);

CREATE TABLE Albums (
 SingerId     INT64 NOT NULL,
 AlbumId      INT64 NOT NULL,
 AlbumTitle   STRING(MAX),
 ReleaseDate  DATE
) PRIMARY KEY (SingerId, AlbumId),
INTERLEAVE IN PARENT Singers ON DELETE CASCADE;
Die vollständige SQL-Referenz finden Sie unter Anweisungssyntax, Funktionen und Operatoren und Lexikalische Struktur und Syntax.
PostgreSQL
CREATE TABLE Singers (
 SingerId   BIGINT PRIMARY KEY,
 FirstName  VARCHAR(1024),
 LastName   VARCHAR(1024),
 SingerInfo BYTEA,
 BirthDate  TIMESTAMPTZ
);

CREATE TABLE Albums (
 SingerId        BIGINT NOT NULL,
 AlbumId         BIGINT NOT NULL,
 AlbumTitle      VARCHAR(1024),
 ReleaseDate     DATE,
 PRIMARY KEY(SingerId, AlbumId),
 FOREIGN KEY (SingerId) REFERENCES Singers(SingerId)
) INTERLEAVE IN PARENT Singers ON DELETE CASCADE;
Weitere Informationen finden Sie unter PostgreSQL-Dialekt in Spanner.
Suchparameter verwenden
Spanner unterstützt Abfrageparameter, um die Leistung zu steigern und SQL-Injection zu verhindern, wenn Abfragen über Nutzereingaben erstellt werden. Sie können Abfrageparameter als Ersatz für beliebige Ausdrücke verwenden, aber nicht als Ersatz für Kennzeichnungen, Spaltennamen, Tabellennamen oder andere Teile der Abfrage.
Parameter können überall dort vorkommen, wo ein Literalwert erwartet wird. Derselbe Parametername kann in einer SQL-Anweisung mehrmals verwendet werden.
Zusammenfassend lässt sich sagen, dass Abfrageparameter die Abfrageausführung auf folgende Weise unterstützen:
- Voroptimierte Pläne: Abfragen, die Parameter verwenden, können bei jedem Aufruf schneller ausgeführt werden, da die Parametrisierung es Spanner erleichtert, den Ausführungsplan im Cache zu speichern.
- Vereinfachte Abfrageerstellung: Sie müssen Stringwerte nicht maskieren, wenn Sie sie in Abfrageparametern angeben. Abfrageparameter verringern auch das Risiko von Syntaxfehlern.
- Sicherheit: Abfrageparameter machen Ihre Abfragen sicherer, da sie Sie vor verschiedenen SQL-Injection-Angriffen schützen. Dieser Schutz ist besonders wichtig für Abfragen, die Sie aus Nutzereingaben erstellen.
Zur Verbesserung der Leistung konvertiert Spanner in SQL hartcodierte Literalwerte in Parameter, wenn der optimale Abfrageausführungsplan nicht von den spezifischen Literalwerten abhängt. Dadurch kann Spanner die Latenz und CPU-Kosten reduzieren, indem der Abfrageplan im Cache gespeichert und wiederverwendet wird. Dies bietet jedoch nicht denselben Schutz vor SQL-Injection und die Vorteile einer einfacheren Abfrageerstellung. Die Verwendung von Abfrageparametern im Anwendungscode ist die Best Practice.
So werden Abfragen von Spanner ausgeführt
Mit Spanner können Sie Datenbanken mithilfe deklarativer SQL-Anweisungen abfragen, die angeben, welche Daten Sie abrufen möchten. Wenn Sie wissen möchten, wie Spanner die Ergebnisse erhält, sehen Sie sich den Ausführungsplan für die Abfrage an. In einem Abfrageausführungsplan werden die Rechenkosten für jeden Schritt der Abfrage angezeigt. Anhand dieser Kosten können Sie Probleme mit der Abfrageleistung beheben und Ihre Abfrage optimieren. Weitere Informationen finden Sie unter Abfrageausführungspläne.
Sie können Abfrageausführungspläne über die Google Cloud Console oder die Clientbibliotheken abrufen.
So rufen Sie einen Abfrageausführungsplan für eine bestimmte Abfrage mit derGoogle Cloud Console ab:
Öffnen Sie die Seite „Spanner-Instanzen“.
Wählen Sie die Namen der Spanner-Instanz und der Datenbank aus, die Sie abfragen möchten.
Klicken Sie im linken Navigationsbereich auf Spanner Studio.
Geben Sie die Abfrage in das Textfeld ein und klicken Sie auf Abfrage ausführen.
Klicken Sie auf Erklärung
. In der Google Cloud Console wird ein visueller Ausführungsplan für Ihre Abfrage angezeigt.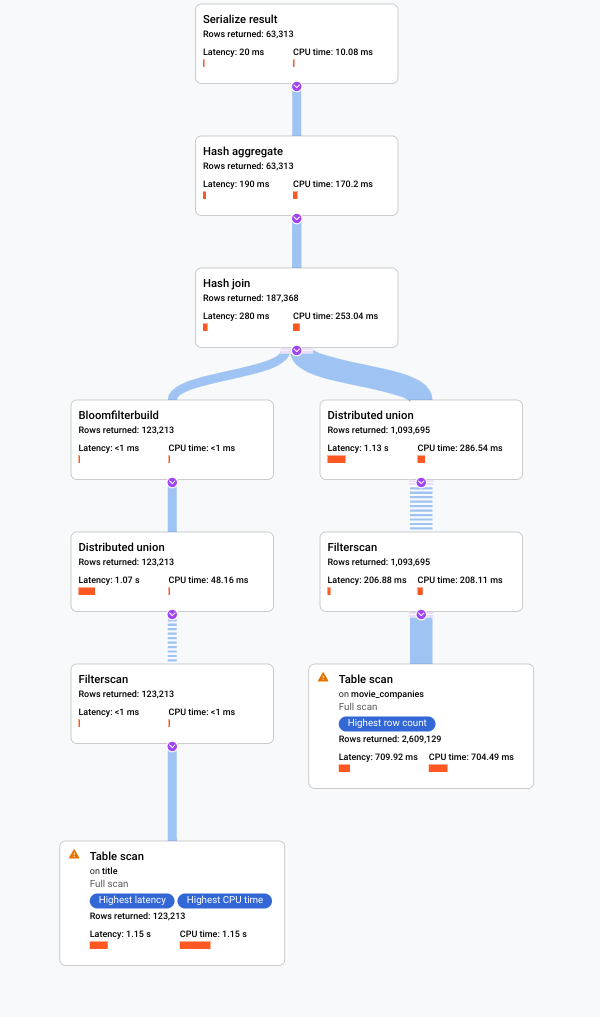
Weitere Informationen zum Verstehen visueller Pläne und zum Verwenden dieser Pläne zum Debuggen Ihrer Abfragen finden Sie unter Abfrage mit der Visualisierung für Abfragepläne optimieren.
Sie können sich auch Beispiele für historische Abfragepläne ansehen und die Leistung einer Abfrage im Zeitverlauf für bestimmte Abfragen vergleichen. Weitere Informationen finden Sie unter Abfragepläne mit Stichproben.
Sekundäre Indexe verwenden
Wie andere relationale Datenbanken bietet Spanner sekundäre Indexe, mit denen Sie Daten entweder über eine SQL-Anweisung oder die Leseschnittstelle von Spanner abrufen können. Wenn Sie einen sekundären Index in einer SQL-Abfrage verwenden, können Sie angeben, wie Spanner die Ergebnisse abrufen soll. Das Angeben eines sekundären Index kann die Ausführung von Abfragen beschleunigen.
Angenommen, Sie möchten die IDs aller Sänger mit einem bestimmten Nachnamen abrufen. Hier ist eine Möglichkeit, eine solche SQL-Abfrage zu schreiben:
SELECT s.SingerId
FROM Singers AS s
WHERE s.LastName = 'Smith';
Diese Abfrage würde die erwarteten Ergebnisse zurückgeben, aber es könnte lange dauern, bis die Ergebnisse zurückgegeben werden. Die Dauer hängt von der Anzahl der Zeilen in der Tabelle Singers und davon ab, wie viele Zeilen das Prädikat WHERE s.LastName = 'Smith' erfüllen.
Wenn es keinen sekundären Index gibt, der die zu lesende Spalte LastName enthält, würde der Abfrageplan die gesamte Tabelle Singers lesen, um Zeilen zu finden, die dem Prädikat entsprechen. Das Lesen der gesamten Tabelle wird als vollständiger Tabellenscan bezeichnet. Ein vollständiger Tabellenscan ist eine teure Methode, um die Ergebnisse zu erhalten, wenn die Tabelle nur einen kleinen Prozentsatz von Singers mit diesem Nachnamen enthält.
Sie können die Leistung dieser Abfrage verbessern, wenn Sie einen sekundären Index für die Nachname-Spalte definieren:
CREATE INDEX SingersByLastName ON Singers (LastName);
Da der sekundäre Index SingersByLastName die indexierte Tabellenspalte LastName und die Primärschlüsselspalte SingerId enthält, kann Spanner alle Daten aus der viel kleineren Indextabelle abrufen, anstatt die gesamte Tabelle Singers zu scannen.
In diesem Szenario verwendet Cloud Spanner beim Ausführen der Abfrage automatisch den sekundären Index SingersByLastName (sofern seit der Erstellung der Datenbank drei Tage vergangen sind; siehe Hinweis zu neuen Datenbanken).
Es ist jedoch am besten, Spanner explizit anzuweisen, diesen Index zu verwenden, indem Sie in der FROM-Klausel eine Indexanweisung angeben:
GoogleSQL
SELECT s.SingerId
FROM Singers@{FORCE_INDEX=SingersByLastName} AS s
WHERE s.LastName = 'Smith';
PostgreSQL
SELECT s.SingerId
FROM Singers /*@ FORCE_INDEX=SingersByLastName */ AS s
WHERE s.LastName = 'Smith';
Wenn Sie benannte Schemas verwenden, verwenden Sie die folgende Syntax für die FROM-Klausel:
GoogleSQL
FROM NAMED_SCHEMA_NAME.TABLE_NAME@{FORCE_INDEX="NAMED_SCHEMA_NAME.TABLE_INDEX_NAME"}
PostgreSQL
FROM NAMED_SCHEMA_NAME.TABLE_NAME /*@ FORCE_INDEX = TABLE_INDEX_NAME */
Beispiel: Sie wollten neben der ID auch den Vornamen des Sängers abrufen. Auch wenn die Spalte FirstName nicht im Index enthalten ist, sollten Sie die Indexanweisung wie zuvor angeben:
GoogleSQL
SELECT s.SingerId, s.FirstName
FROM Singers@{FORCE_INDEX=SingersByLastName} AS s
WHERE s.LastName = 'Smith';
PostgreSQL
SELECT s.SingerId, s.FirstName
FROM Singers /*@ FORCE_INDEX=SingersByLastName */ AS s
WHERE s.LastName = 'Smith';
Die Verwendung des Index bietet dennoch einen Leistungsvorteil, da Spanner bei der Ausführung des Abfrageplans keinen vollständigen Tabellenscan durchführen muss. Stattdessen wird die Teilmenge der Zeilen, die das Prädikat erfüllen, aus dem Index SingersByLastName ausgewählt. Anschließend wird in der Basistabelle Singers nach dem Vornamen für diese Teilmenge der Zeilen gesucht.
Wenn Sie möchten, dass Spanner überhaupt keine Zeilen aus der Basistabelle abrufen muss, können Sie eine Kopie der Spalte FirstName im Index selbst speichern:
GoogleSQL
CREATE INDEX SingersByLastName ON Singers (LastName) STORING (FirstName);
PostgreSQL
CREATE INDEX SingersByLastName ON Singers (LastName) INCLUDE (FirstName);
Die Verwendung einer STORING-Klausel (für den GoogleSQL-Dialekt) oder einer INCLUDE-Klausel (für den PostgreSQL-Dialekt) wie dieser verursacht zusätzliche Speicherkosten, bietet aber die folgenden Vorteile:
- SQL-Abfragen, die den Index verwenden und Spalten auswählen, die in der
STORING- oderINCLUDE-Klausel gespeichert sind, erfordern keinen zusätzlichen Join zur Basistabelle. - Bei Leseaufrufen, die den Index verwenden, können Spalten gelesen werden, die in der
STORING- oderINCLUDE-Klausel gespeichert sind.
Die vorherigen Beispiele veranschaulichen, wie Sekundärindexe Abfragen beschleunigen können, wenn die durch die WHERE-Klausel einer Abfrage ausgewählten Zeilen mithilfe des Sekundärindex schnell identifiziert werden können.
Ein weiteres Szenario, in dem sekundäre Indexe Leistungsvorteile bieten können, sind bestimmte Abfragen, die sortierte Ergebnisse zurückgeben. Angenommen, Sie möchten alle Albumtitel und ihre Veröffentlichungsdaten in aufsteigender Reihenfolge des Veröffentlichungsdatums und in absteigender Reihenfolge des Albumtitels abrufen. Sie könnten eine SQL-Abfrage wie folgt schreiben:
SELECT a.AlbumTitle, a.ReleaseDate
FROM Albums AS a
ORDER BY a.ReleaseDate, a.AlbumTitle DESC;
Ohne einen sekundären Index erfordert diese Abfrage möglicherweise einen teuren Sortierschritt im Ausführungsplan. Sie können die Abfrageausführung beschleunigen, wenn Sie diesen sekundären Index definieren:
CREATE INDEX AlbumsByReleaseDateTitleDesc on Albums (ReleaseDate, AlbumTitle DESC);
Schreiben Sie die Abfrage dann so um, dass der sekundäre Index verwendet wird:
GoogleSQL
SELECT a.AlbumTitle, a.ReleaseDate
FROM Albums@{FORCE_INDEX=AlbumsByReleaseDateTitleDesc} AS a
ORDER BY a.ReleaseDate, a.AlbumTitle DESC;
PostgreSQL
SELECT a.AlbumTitle, a.ReleaseDate
FROM Albums /*@ FORCE_INDEX=AlbumsByReleaseDateTitleDesc */ AS s
ORDER BY a.ReleaseDate, a.AlbumTitle DESC;
Diese Abfrage und Indexdefinition erfüllen die beiden folgenden Kriterien:
- Wenn Sie den Sortierschritt entfernen möchten, muss die Spaltenliste in der
ORDER BY-Klausel ein Präfix der Indexschlüsselliste sein. - Damit Sie nicht zur Basistabelle zurückkehren müssen, um fehlende Spalten abzurufen, muss der Index alle Spalten in der Tabelle abdecken, die von der Abfrage verwendet werden.
Sekundäre Indexe können zwar gängige Abfragen beschleunigen, aber auch die Latenz Ihrer Commit-Vorgänge erhöhen, da für jeden sekundären Index in der Regel ein zusätzlicher Knoten in jedem Commit erforderlich ist. Für die meisten Arbeitslasten sind einige sekundäre Indexe in Ordnung. Sie sollten jedoch überlegen, ob Ihnen die Lese- oder Schreiblatenz wichtiger ist und welche Vorgänge für Ihre Arbeitslast am wichtigsten sind. Führen Sie einen Benchmark für Ihre Arbeitslast durch, um sicherzustellen, dass sie die erwartete Leistung erbringt.
Die vollständige Referenz zu sekundären Indexen finden Sie unter Sekundäre Indexe.
Bereichsschlüsselsuchen optimieren
Eine gängige Verwendung einer SQL-Abfrage besteht darin, mehrere Zeilen aus Spanner basierend auf einer Liste bekannter Schlüssel zu lesen.
Die folgenden Best Practices helfen Ihnen, effiziente Abfragen zu schreiben, wenn Sie Daten nach einem Bereich von Schlüsseln abrufen:
Wenn die Liste der Schlüssel dünnbesetzt und nicht zusammenhängend ist, verwenden Sie Abfrageparameter und
UNNEST, um die Abfrage zu erstellen.Wenn die Schlüsselliste beispielsweise
{1, 5, 1000}lautet, schreiben Sie die Abfrage so:GoogleSQL
SELECT *
FROM Table AS t
WHERE t.Key IN UNNEST (@KeyList)
PostgreSQL
SELECT *
FROM Table AS t
WHERE t.Key IN UNNEST ($1)
Hinweise:
Der Array-Operator UNNEST vereinfacht ein Eingabearray in Zeilen mit Elementen.
Der Abfrageparameter, der für GoogleSQL
@KeyListund für PostgreSQL$1lautet, kann Ihre Abfrage beschleunigen, wie in der vorherigen Best Practice beschrieben.Es ist besser, UNNEST mit einem einzelnen Parameter zu verwenden, als OR mit mehreren Parametern.
Wenn die Liste der Schlüssel nebeneinander und innerhalb eines Bereichs liegt, geben Sie die Unter- und Obergrenze des Schlüsselbereichs in der
WHERE-Klausel an.Wenn Ihre Schlüsselliste beispielsweise
{1,2,3,4,5}ist, erstellen Sie die Abfrage so:GoogleSQL
SELECT *
FROM Table AS t
WHERE t.Key BETWEEN @min AND @max
PostgreSQL
SELECT *
FROM Table AS t
WHERE t.Key BETWEEN $1 AND $2
Diese Abfrage ist nur dann effizienter, wenn die Schlüssel im Schlüsselbereich nebeneinander liegen. Wenn Ihre Schlüsselliste also
{1, 5, 1000}ist, geben Sie nicht die Unter- und Obergrenzen wie in der vorherigen Abfrage an, da die resultierende Abfrage jeden Wert zwischen 1 und 1.000 durchsucht.
Joins optimieren
Join-Vorgänge können teuer sein, da sie die Anzahl der Zeilen, die Ihre Abfrage scannen muss, erheblich erhöhen können, was zu langsameren Abfragen führt. Zusätzlich zu den Techniken, die Sie aus anderen relationalen Datenbanken zur Optimierung von Join-Abfragen kennen, finden Sie hier einige Best Practices für einen effizienteren JOIN bei der Verwendung von Spanner SQL:
- Verbinden Sie nach Möglichkeit Daten in verschränkten Tabellen mit dem Primärschlüssel. Beispiel:
SELECT s.FirstName, a.ReleaseDate
FROM Singers AS s JOIN Albums AS a ON s.SingerId = a.SingerId;
The rows in the interleaved table `Albums` are physically
stored in the same splits as the parent row in `Singers`, as discussed in
[Schema and Data Model](/spanner/docs/schema-and-data-model). Therefore, joins can be
completed locally without sending lots of data across the network.
Verwenden Sie die Join-Anweisung, wenn Sie die Reihenfolge des Joins erzwingen möchten. Beispiel:
GoogleSQL
SELECT *
FROM Singers AS s JOIN@{FORCE_JOIN_ORDER=TRUE} Albums AS a
ON s.SingerId = a.Singerid
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
PostgreSQL
SELECT *
FROM Singers AS s JOIN/*@ FORCE_JOIN_ORDER=TRUE */ Albums AS a
ON s.SingerId = a.Singerid
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
Die Join-Anweisung
FORCE_JOIN_ORDERweist Spanner an, die in der Abfrage angegebene Join-Reihenfolge zu verwenden (alsoSingers JOIN Albums, nichtAlbums JOIN Singers). Die zurückgegebenen Ergebnisse sind unabhängig von der von Spanner gewählten Reihenfolge gleich. Sie können diese Join-Anweisung jedoch verwenden, wenn Sie im Abfrageplan feststellen, dass Spanner die Join-Reihenfolge geändert hat und dies unerwünschte Folgen hat, z. B. größere Zwischenergebnisse, oder wenn Zeilen nicht gefunden wurden.Wählen Sie mit einer Join-Anweisung eine Join-Implementierung aus. Wenn Sie mit SQL mehrere Tabellen abfragen, verwendet Spanner automatisch eine Join-Methode, die die Abfrage wahrscheinlich effizienter macht. Google empfiehlt jedoch, verschiedene Join-Algorithmen zu testen. Die Wahl des richtigen Join-Algorithmus kann die Latenz, den Arbeitsspeicherverbrauch oder beides verbessern. Diese Abfrage zeigt die Syntax für die Verwendung einer JOIN-Anweisung mit dem Hinweis
JOIN_METHOD, um einenHASH JOINauszuwählen:GoogleSQL
SELECT *
FROM Singers s JOIN@{JOIN_METHOD=HASH_JOIN} Albums AS a
ON a.SingerId = a.SingerId
PostgreSQL
SELECT *
FROM Singers s JOIN/*@ JOIN_METHOD=HASH_JOIN */ Albums AS a
ON a.SingerId = a.SingerId
Wenn Sie
HASH JOINoderAPPLY JOINverwenden und eineWHERE-Klausel haben, die auf einer Seite vonJOINsehr selektiv ist, fügen Sie die Tabelle, die die kleinste Anzahl von Zeilen erzeugt, als erste Tabelle in dieFROM-Klausel des Joins ein. Diese Struktur ist hilfreich, da Spanner inHASH JOINimmer die Tabelle auf der linken Seite als Build und die Tabelle auf der rechten Seite als Probe auswählt. Ebenso wählt Spanner fürAPPLY JOINdie Tabelle auf der linken Seite als äußere und die Tabelle auf der rechten Seite als innere Tabelle aus. Weitere Informationen zu diesen Join-Typen finden Sie unter [Hash-Join][hash_join] und [Apply-Join][apply_join].Geben Sie für Abfragen, die für Ihre Arbeitslast kritisch sind, die leistungsstärkste Join-Methode und Join-Reihenfolge in Ihren SQL-Anweisungen an, um eine konsistentere Leistung zu erzielen.
Abfragen mit Zeitstempel-Prädikat-Pushdown optimieren
Die Pushdown-Optimierung für Zeitstempel-Prädikate ist eine Technik zur Abfrageoptimierung, die in Spanner verwendet wird, um die Effizienz von Abfragen zu verbessern, die Zeitstempel und Daten mit einer altersbasierten Richtlinie für gestaffelten Speicher verwenden. Wenn Sie diese Optimierung aktivieren, werden die Filtervorgänge für Zeitstempelspalten so früh wie möglich im Abfrageausführungsplan ausgeführt. Dadurch kann die Menge der verarbeiteten Daten erheblich reduziert und die Abfrageleistung insgesamt verbessert werden.
Mit der Pushdown-Funktion für Zeitstempelprädikate analysiert die Datenbank-Engine die Abfrage und identifiziert den Zeitstempelfilter. Anschließend wird dieser Filter auf die Speicherebene „heruntergeschoben“, sodass nur die relevanten Daten basierend auf den Zeitstempelkriterien von der SSD gelesen werden. Dadurch wird die Menge der verarbeiteten und übertragenen Daten minimiert, was zu einer schnelleren Abfrageausführung führt.
Damit Abfragen so optimiert werden, dass nur auf Daten zugegriffen wird, die auf SSDs gespeichert sind, muss Folgendes gelten:
- Für die Abfrage muss die Pushdown-Funktion für Zeitstempelprädikate aktiviert sein. Weitere Informationen finden Sie unter GoogleSQL-Anweisungshinweise und PostgreSQL-Anweisungshinweise.
Die Abfrage muss eine altersbasierte Einschränkung verwenden, die kleiner oder gleich dem Alter ist, das in der Spill-Richtlinie der Daten angegeben ist (festgelegt mit der Option
ssd_to_hdd_spill_timespanin der DDL-AnweisungCREATE LOCALITY GROUPoderALTER LOCALITY GROUP). Weitere Informationen finden Sie unter GoogleSQL-LOCALITY GROUP-Anweisungen und PostgreSQL-LOCALITY GROUP-Anweisungen.Die in der Abfrage gefilterte Spalte muss eine Zeitstempelspalte sein, die den Commit-Zeitstempel enthält. Weitere Informationen zum Erstellen einer Commit-Zeitstempelspalte finden Sie unter Commit-Zeitstempel in GoogleSQL und Commit-Zeitstempel in PostgreSQL. Diese Spalten müssen zusammen mit der Zeitstempelspalte aktualisiert werden und sich in derselben Lokalisierungsgruppe befinden, für die eine altersbasierte Richtlinie für gestaffelten Speicher gilt.
Wenn sich für eine bestimmte Zeile einige der abgefragten Spalten auf SSD und einige auf HDD befinden (da Spalten zu unterschiedlichen Zeiten aktualisiert werden und zu unterschiedlichen Zeiten auf HDD verschoben werden), kann die Leistung der Abfrage bei Verwendung des Hinweises schlechter sein. Das liegt daran, dass die Abfrage Daten aus den verschiedenen Speicherebenen einfügen muss. Durch die Verwendung des Hinweises werden Daten in Spanner auf der Ebene der einzelnen Zellen (Zeilen- und Spaltengranularität) basierend auf dem Commit-Zeitstempel jeder Zelle gealtert, was die Abfrage verlangsamt. Um dieses Problem zu vermeiden, sollten Sie alle Spalten, die mit dieser Optimierungstechnik abgefragt werden, routinemäßig in derselben Transaktion aktualisieren, damit alle Spalten denselben Commit-Zeitstempel haben und von der Optimierung profitieren.
Wenn Sie die Pushdown-Funktion für Zeitstempelprädikate auf Anweisungsebene aktivieren möchten, verwenden Sie einen Anweisungshinweis in Ihrer Abfrage. Beispiel:
GoogleSQL
@{allow_timestamp_predicate_pushdown=TRUE}
SELECT s.SingerInfo
FROM Singers s
WHERE s.ModificationTime > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 12 HOUR);
PostgreSQL
/*@allow_timestamp_predicate_pushdown=TRUE*/
SELECT s.SingerInfo
FROM Singers s
WHERE s.ModificationTime > CURRENT_TIMESTAMP - INTERVAL '12 hours';
Große Lesevorgänge in Lese-Schreib-Transaktionen vermeiden
Lese-Schreib-Transaktionen ermöglichen eine Sequenz von null oder mehr Lesevorgängen oder SQL-Abfragen und können eine Reihe von Mutationen vor einem Aufruf zum Commit enthalten. Damit die Datenkonsistenz gewahrt bleibt, werden in Spanner Sperren eingerichtet, wenn Zeilen in Ihren Tabellen und Indexen gelesen und geschrieben werden. Weitere Informationen zum Sperren finden Sie unter Lebenszyklus von Lese- und Schreibvorgängen.
Aufgrund der Funktionsweise von Sperren in Spanner bedeutet das Ausführen eines Lesevorgangs oder einer SQL-Abfrage, die eine große Anzahl von Zeilen liest (z. B. SELECT * FROM
Singers), dass keine anderen Transaktionen in die gelesenen Zeilen schreiben können, bis Ihre Transaktion entweder festgeschrieben oder abgebrochen wird.
Da Ihre Transaktion eine große Anzahl von Zeilen verarbeitet, dauert sie wahrscheinlich länger als eine Transaktion, die einen viel kleineren Bereich von Zeilen liest (z. B. SELECT LastName FROM Singers WHERE SingerId = 7). Dies verschlimmert das Problem und reduziert den Systemdurchsatz.
Vermeiden Sie daher große Lesevorgänge (z. B. vollständige Tabellenscans oder umfangreiche Join-Vorgänge) in Ihren Transaktionen, es sei denn, Sie sind bereit, einen geringeren Schreibdurchsatz zu akzeptieren.
In einigen Fällen kann das folgende Muster bessere Ergebnisse liefern:
- Führen Sie umfangreiche Lesevorgänge innerhalb einer schreibgeschützten Transaktion aus. Schreibgeschützte Transaktionen ermöglichen einen höheren Gesamtdurchsatz, da sie keine Sperren verwenden.
- Optional: Verarbeiten Sie die gerade gelesenen Daten nach Bedarf.
- Starten Sie eine Lese-Schreib-Transaktion.
- Prüfen Sie, ob sich die Werte der kritischen Zeilen seit der schreibgeschützten Transaktion in Schritt 1 geändert haben.
- Wenn sich die Zeilen geändert haben, führen Sie einen Rollback der Transaktion durch und beginnen Sie noch einmal bei Schritt 1.
- Wenn alles in Ordnung ist, können Sie einen Commit Ihrer Mutationen durchführen.
Eine Möglichkeit, große Lesevorgänge in Lese-/Schreibtransaktionen zu vermeiden, besteht darin, sich die Ausführungspläne anzusehen, die von Ihren Abfragen generiert werden.
Verwenden Sie ORDER BY, um die Reihenfolge Ihrer SQL-Ergebnisse sicherzustellen
Wenn Sie eine bestimmte Reihenfolge für die Ergebnisse einer SELECT-Abfrage erwarten, fügen Sie die ORDER BY-Klausel explizit ein. Wenn Sie beispielsweise alle Sänger in der Reihenfolge des Primärschlüssels auflisten möchten, verwenden Sie diese Abfrage:
SELECT * FROM
Singers
ORDER BY SingerId;
Cloud Spanner garantiert die Sortierung der Ergebnisse nur, wenn die Abfrage die ORDER BY-Klausel enthält. Mit anderen Worten, betrachten Sie diese Abfrage ohne ORDER
BY:
SELECT * FROM Singers;
Cloud Spanner garantiert nicht, dass die Ergebnisse dieser Abfrage in der Reihenfolge des Primärschlüssels vorliegen. Außerdem kann sich die Reihenfolge der Ergebnisse jederzeit ändern und ist nicht garantiert von Aufruf zu Aufruf konsistent. Wenn eine Abfrage eine ORDER BY-Klausel enthält und Spanner einen Index verwendet, der die erforderliche Reihenfolge bereitstellt, sortiert Spanner die Daten nicht explizit. Machen Sie sich also keine Sorgen über die Auswirkungen dieser Klausel auf die Leistung. Sie können im Abfrageplan prüfen, ob ein expliziter Sortiervorgang in der Ausführung enthalten ist.
STARTS_WITH anstelle von LIKE verwenden
Da Spanner parametrisierte LIKE-Muster erst zur Ausführungszeit auswertet, muss Spanner alle Zeilen lesen und sie anhand des LIKE-Ausdrucks auswerten, um Zeilen herauszufiltern, die nicht übereinstimmen.
Wenn ein LIKE-Muster die Form foo% hat (z. B. mit einem festen String beginnt und mit einem einzelnen Platzhalter-Prozentzeichen endet) und die Spalte indexiert ist, verwenden Sie STARTS_WITH anstelle von LIKE. Mit dieser Option kann Spanner den Abfrageausführungsplan effektiver optimieren.
Nicht empfohlen:
GoogleSQL
SELECT a.AlbumTitle FROM Albums a
WHERE a.AlbumTitle LIKE @like_clause;
PostgreSQL
SELECT a.AlbumTitle FROM Albums a
WHERE a.AlbumTitle LIKE $1;
Empfohlen:
GoogleSQL
SELECT a.AlbumTitle FROM Albums a
WHERE STARTS_WITH(a.AlbumTitle, @prefix);
PostgreSQL
SELECT a.AlbumTitle FROM Albums a
WHERE STARTS_WITH(a.AlbumTitle, $2);
Commit-Zeitstempel verwenden
Wenn Ihre Anwendung Daten abfragen muss, die nach einem bestimmten Zeitpunkt geschrieben wurden, fügen Sie den relevanten Tabellen Commit-Zeitstempelspalten hinzu. Commit-Zeitstempel ermöglichen eine Spanner-Optimierung, die die E/A von Abfragen reduzieren kann, deren WHERE-Klauseln die Ergebnisse auf Zeilen beschränken, die nach einem bestimmten Zeitpunkt geschrieben wurden.
Weitere Informationen zu dieser Optimierung finden Sie unter Datenbanken im GoogleSQL-Dialekt oder Datenbanken im PostgreSQL-Dialekt.