


In einer Spanner-Datenbank erstellt Spanner automatisch einen Index für den Primärschlüssel jeder Tabelle. Sie müssen beispielsweise nichts tun, um den Primärschlüssel von Singers zu indexieren, da er automatisch für Sie indexiert wird.
Sie können auch sekundäre Indexe für andere Spalten erstellen. Wenn Sie einen sekundären Index für eine Spalte hinzufügen, können Sie Daten in dieser Spalte effizienter nachschlagen. Wenn Sie beispielsweise schnell ein Album nach Titel suchen müssen, sollten Sie einen sekundären Index für AlbumTitle erstellen, damit Spanner nicht die gesamte Tabelle scannen muss.
Wenn die Suche im vorherigen Beispiel innerhalb einer Lese-/Schreibtransaktion erfolgt, werden durch die effizientere Suche auch Sperren für die gesamte Tabelle vermieden. Dadurch sind gleichzeitige Einfügungen und Aktualisierungen in der Tabelle für Zeilen außerhalb des Suchbereichs AlbumTitle möglich.
Zusätzlich zu den Vorteilen, die sie für Suchvorgänge bieten, können sekundäre Indexe Spanner auch dabei helfen, Scans effizienter auszuführen, da sie Indexscans anstelle von vollständigen Tabellenscans ermöglichen.
Spanner speichert die folgenden Daten in jedem sekundären Index:
- Alle Schlüsselspalten aus der Basistabelle
- Alle Spalten, die im Index enthalten sind
- Alle Spalten, die in der optionalen
STORING-Klausel (Datenbanken im GoogleSQL-Dialekt) oderINCLUDE-Klausel (Datenbanken im PostgreSQL-Dialekt) der Indexdefinition angegeben sind.
Im Laufe der Zeit analysiert Spanner Ihre Tabellen, um sicherzustellen, dass Ihre sekundären Indexe für die entsprechenden Abfragen verwendet werden.
Sekundären Index hinzufügen
Am effizientesten ist die Erweiterung einer Tabelle um einen sekundären Index gleich bei deren Erstellung. Wenn Sie eine Tabelle und ihre Indexe gleichzeitig erstellen möchten, senden Sie die DDL-Anweisungen für die neue Tabelle und die neuen Indexe in einer einzigen Anfrage an Spanner.
In Spanner können Sie einer vorhandenen Tabelle auch einen neuen sekundären Index hinzufügen, während die Datenbank weiterhin Traffic verarbeitet. Wie bei allen anderen Schemaänderungen in Spanner muss die Datenbank nicht offline geschaltet werden, wenn Sie einen Index zu einer vorhandenen Datenbank hinzufügen. Außerdem werden keine ganzen Spalten oder Tabellen gesperrt.
Wenn einer vorhandenen Tabelle ein neuer Index hinzugefügt wird, wird der Index von Spanner automatisch mit Backfill gefüllt, um eine aktuelle Ansicht der indexierten Daten widerzuspiegeln. Spanner verwaltet diesen Backfill-Prozess für Sie. Der Prozess wird im Hintergrund mit Knotenressourcen mit niedriger Priorität ausgeführt. Die Geschwindigkeit des Index-Backfills passt sich während der Indexerstellung an sich ändernde Knotenressourcen an. Der Backfill hat keine nennenswerten Auswirkungen auf die Leistung der Datenbank.
Die Indexerstellung kann mehrere Minuten bis hin zu vielen Stunden in Anspruch nehmen. Da die Indexerstellung eine Schemaaktualisierung ist, unterliegt sie denselben Leistungsbeschränkungen wie jede andere Schemaaktualisierung. Wie viel Zeit zum Erstellen eines sekundären Index benötigt wird, hängt von mehreren Faktoren ab:
- Die Größe des Datasets
- Rechenkapazität der Instanz
- Auslastung der Instanz
Den Fortschritt eines Index-Backfill-Prozesses können Sie im Abschnitt „Fortschritt“ aufrufen.
Die Verwendung der Spalte Commit-Zeitstempel als erster Teil des sekundären Index kann Hotspots erstellen und die Schreibleistung verringern.
Verwenden Sie die Anweisung CREATE INDEX, um einen sekundären Index in Ihrem Schema zu definieren. Hier einige Beispiele:
So indexieren Sie alle Singers in der Datenbank nach ihrem Vor- und Nachnamen:
GoogleSQL
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
PostgreSQL
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
So erstellen Sie einen Index aller Songs in der Datenbank nach dem Wert von SongName:
GoogleSQL
CREATE INDEX SongsBySongName ON Songs(SongName);
PostgreSQL
CREATE INDEX SongsBySongName ON Songs(SongName);
Wenn Sie nur die Titel eines bestimmten Interpreten indexieren möchten, verwenden Sie die Klausel INTERLEAVE IN, um den Index in der Tabelle Singers zu verschachteln:
GoogleSQL
CREATE INDEX SongsBySingerSongName ON Songs(SingerId, SongName),
    INTERLEAVE IN Singers;
PostgreSQL
CREATE INDEX SongsBySingerSongName ON Songs(SingerId, SongName)
    INTERLEAVE IN Singers;
So indexieren Sie nur die Titel eines bestimmten Albums:
GoogleSQL
CREATE INDEX SongsBySingerAlbumSongName ON Songs(SingerId, AlbumId, SongName),
    INTERLEAVE IN Albums;
PostgreSQL
CREATE INDEX SongsBySingerAlbumSongName ON Songs(SingerId, AlbumId, SongName)
    INTERLEAVE IN Albums;
So indexieren Sie nach SongName in absteigender Reihenfolge:
GoogleSQL
CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC),
    INTERLEAVE IN Albums;
PostgreSQL
CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC)
    INTERLEAVE IN Albums;
Die vorherige Annotation DESC gilt nur für SongName. Wenn Sie nach anderen Indexschlüsseln in absteigender Reihenfolge indexieren möchten, versehen Sie sie ebenfalls mit DESC: SingerId DESC, AlbumId DESC.
Beachten Sie außerdem, dass PRIMARY_KEY ein reserviertes Wort ist und nicht als Name eines Index verwendet werden kann. Dies ist der Name des Pseudoindex, der erstellt wird, wenn eine Tabelle mit der Spezifikation Primärschlüssel erstellt wird.
Weitere Informationen und Best Practices zur Auswahl von nicht verschachtelten und verschachtelten Indizes finden Sie unter Zwischen verschachtelten und globalen Indizes wählen, Indexoptionen und Verschachtelten Index für eine Spalte verwenden, deren Wert monoton steigt oder fällt.
Indexe und Interleaving
Spanner-Indizes können mit anderen Tabellen verschachtelt werden, um Indexzeilen mit denen einer anderen Tabelle zu verknüpfen. Ähnlich wie bei der Spanner-Tabellenverschachtelung müssen die Primärschlüsselspalten des übergeordneten Index ein Präfix der indexierten Spalten sein und in Typ und Sortierreihenfolge übereinstimmen. Im Gegensatz zu verschachtelten Tabellen ist keine Übereinstimmung der Spaltennamen erforderlich. Jede Zeile eines verschachtelten Index wird physisch zusammen mit der zugehörigen übergeordneten Zeile gespeichert.
Betrachten Sie beispielsweise das folgende Schema:
CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo PROTO<Singer>(MAX)
) PRIMARY KEY (SingerId);

CREATE TABLE Albums (
  SingerId     INT64 NOT NULL,
  AlbumId      INT64 NOT NULL,
  AlbumTitle   STRING(MAX),
  PublisherId  INT64 NOT NULL
) PRIMARY KEY (SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE TABLE Songs (
  SingerId     INT64 NOT NULL,
  AlbumId      INT64 NOT NULL,
  TrackId      INT64 NOT NULL,
  PublisherId  INT64 NOT NULL,
  SongName     STRING(MAX)
) PRIMARY KEY (SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE TABLE Publishers (
  Id            INT64 NOT NULL,
  PublisherName STRING(MAX)
) PRIMARY KEY (Id);
Wenn Sie alle Singers in der Datenbank nach Vor- und Nachnamen indexieren möchten, müssen Sie einen Index erstellen. So definieren Sie den Index SingersByFirstLastName:
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
Wenn Sie einen Index von Songs für (SingerId, AlbumId, SongName) erstellen möchten, können Sie so vorgehen:
CREATE INDEX SongsBySingerAlbumSongName
    ON Songs(SingerId, AlbumId, SongName);
Sie können auch einen Index erstellen, der mit einem Ancestor von Songs verschachtelt ist, z. B.:
CREATE INDEX SongsBySingerAlbumSongName
    ON Songs(SingerId, AlbumId, SongName),
    INTERLEAVE IN Albums;
Außerdem können Sie einen Index von Songs für (PublisherId, SingerId, AlbumId, SongName) erstellen, der mit einer Tabelle verschachtelt ist, die kein Ancestor von Songs ist, z. B. Publishers. Beachten Sie, dass der Primärschlüssel für die Tabelle Publishers (id) im folgenden Beispiel kein Präfix der indexierten Spalten ist. Dies ist weiterhin zulässig, da Publishers.Id und Songs.PublisherId denselben Typ, dieselbe Sortierreihenfolge und dieselbe Null-Zulässigkeit haben.
CREATE INDEX SongsByPublisherSingerAlbumSongName
    ON Songs(PublisherId, SingerId, AlbumId, SongName),
    INTERLEAVE IN Publishers;
Zwischen verschachtelten und globalen Indizes wählen
Wenn Sie einen sekundären Index in Spanner erstellen, definieren Sie ihn entweder als globalen Index (den standardmäßigen, nicht verschachtelten Index) oder als verschachtelten Index. Die Auswahl des optimalen Indextyps ist entscheidend für die Lese- und Schreibleistung.
Indexvergleich
| Funktion | Verschachtelter Index | Globaler Index |
|---|---|---|
| Speicherort | Sie befinden sich zusammen mit der übergeordneten Zeile im selben Split (Zeilenbaum). | In einer separaten Stammtabelle gespeichert, die unabhängig von der Basistabelle aufgeteilt werden kann. |
| Voraussetzungen | Der Primärschlüssel der übergeordneten Tabelle muss ein Präfix der Indexschlüssel sein. | Keine Einschränkungen für die Indexschlüssel. |
| Schreib-Overhead | Niedrig Wenn sie in einem Ancestor der Basistabelle verschachtelt sind, sind Aktualisierungen in der Regel lokal für den Split, sodass zweiphasige Commits über Splits hinweg vermieden werden. Wenn die Tabelle in einer Tabelle verschachtelt ist, die kein Ancestor ist, ist der Schreibaufwand höher, da für Aktualisierungen möglicherweise verteilte Transaktionen erforderlich sind. | Höher. Aktualisierungen erstrecken sich oft über verschiedene Splits, was verteilte Transaktionen erfordert. |
| Optimal für | Abfragen, die auf eine einzelne übergeordnete Entität beschränkt sind, z. B. „Fotos für Nutzer USER_NAME suchen“. | Abfragen, die die gesamte Datenbank durchsuchen, z. B. „Nutzer nach E-Mail-Adresse suchen“. |
Warum verschachtelte Indexe in der Regel bevorzugt werden
In einer verteilten Datenbank wie Spanner ist die Datenlokalität entscheidend für die Leistung. Verschachtelte Indexe werden in der Regel bevorzugt, da sie die Datenlokalität beibehalten:
- Effiziente Lesevorgänge: Wenn Ihre Abfragen immer nach der ID einer übergeordneten Entität filtern, kann Spanner die Abfrage mit einem verschachtelten Index beantworten, indem nur der Split gescannt wird, der diese übergeordnete Entität enthält, anstatt mehrere Splits zu konsultieren.
- Effiziente Schreibvorgänge: Wenn Sie eine Zeile in einer Tabelle aktualisieren, muss Spanner auch die sekundären Indexe aktualisieren. Wenn Sie einen globalen Index verwenden, befindet sich der Indexeintrag wahrscheinlich in einem anderen Split als die Basiszeile. Dadurch wird Spanner gezwungen, eine verteilte Transaktion (Two-Phase-Commit) über Splits hinweg auszuführen, was die Latenz und die CPU-Auslastung erhöht. Wenn ein verschachtelter Index in einem Ancestor der Basistabelle verschachtelt ist, wird der Indexeintrag im selben Split wie die Basiszeile gespeichert, sodass der Schreibvorgang ein lokaler Vorgang ist.
Entscheidungshilfe
Beachten Sie die folgenden Richtlinien, um den optimalen Indextyp für Ihren Anwendungsfall auszuwählen:
Wann ein verschachtelter Index verwendet werden sollte
Verwenden Sie einen verschachtelten Index, wenn eine oder mehrere der folgenden Bedingungen zutreffen:
- Ihre Abfragen enthalten immer einen Filter für den Primärschlüssel der übergeordneten Tabelle, z. B.
WHERE UserId = @userId AND .... - Die Primärschlüsselspalten der übergeordneten Tabelle können natürlich als Präfix für Ihre Indexschlüssel verwendet werden.
- Sie möchten die Schreiblatenz und den CPU-Overhead der Indexwartung minimieren.
Beispiel:
-- Indexing albums by title for a specific singer
CREATE INDEX AlbumsBySingerTitle ON Albums(SingerId, AlbumTitle),
  INTERLEAVE IN Singers;
Wann ein globaler Index verwendet werden sollte
Verwenden Sie einen globalen Index, wenn eine oder mehrere der folgenden Bedingungen zutreffen:
- Sie müssen Daten in der gesamten Datenbank abfragen, ohne nach einer übergeordneten Entität zu filtern, z. B. bei einer globalen Suche.
- Die Spalten, die Sie indexieren möchten, haben kein gemeinsames Präfix mit einer übergeordneten Tabelle.
Beispiel:
-- Indexing all albums globally by title. For example, for a global search catalog.
CREATE INDEX AlbumsByTitle ON Albums(AlbumTitle);
Fortschritt des Index-Backfills prüfen
Console
Klicken Sie im Spanner-Navigationsmenü auf den Tab Vorgänge. Auf der Seite Vorgänge wird eine Liste der laufenden Vorgänge angezeigt.
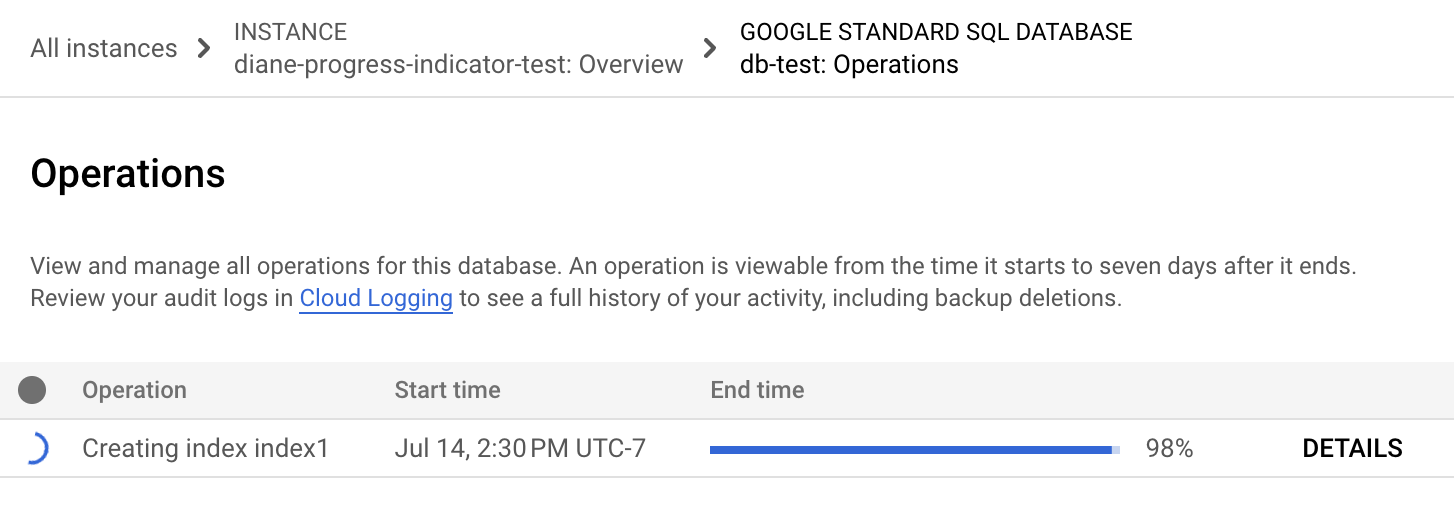
Suchen Sie in der Liste nach dem Backfill-Vorgang. Wenn der Vorgang noch läuft, wird in der Spalte Endzeit der Fortschritt in Prozent angezeigt, wie in der folgenden Abbildung zu sehen ist:
gcloud
Mit gcloud spanner operations describe können Sie den Fortschritt eines Vorgangs prüfen.
Rufen Sie die Vorgangs-ID ab:
gcloud spanner operations list --instance=INSTANCE-NAME \
--database=DATABASE-NAME --type=DATABASE_UPDATE_DDL
Ersetzen Sie Folgendes:
- INSTANCE-NAME durch den Namen der Cloud Spanner-Instanz.
- DATABASE-NAME durch den Namen der Datenbank.
Verwendungshinweise:
Wenn Sie die Liste einschränken möchten, geben Sie das Flag
--filteran. Beispiel:--filter="metadata.name:example-db"listet nur die Vorgänge in einer bestimmten Datenbank auf.--filter="error:*"listet nur die fehlgeschlagenen Sicherungsvorgänge auf.
Informationen zur Filtersyntax finden Sie unter gcloud topic filters. Informationen zum Filtern von Sicherungsvorgängen finden Sie im Feld
filterin ListBackupOperationsRequest.Beim Flag
--typewird nicht zwischen Groß- und Kleinschreibung unterschieden.
Die Ausgabe sieht dann ungefähr so aus:
OPERATION_ID     STATEMENTS                                                                                          DONE   @TYPE
_auto_op_123456  CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName)                                 False  UpdateDatabaseDdlMetadata
                CREATE INDEX SongsBySingerAlbumSongName ON Songs(SingerId, AlbumId, SongName), INTERLEAVE IN Albums
_auto_op_234567                                                                                                      True   CreateDatabaseMetadata
Führen Sie
gcloud spanner operations describeaus:gcloud spanner operations describe \ --instance=INSTANCE-NAME \ --database=DATABASE-NAME \ projects/PROJECT-NAME/instances/INSTANCE-NAME/databases/DATABASE-NAME/operations/OPERATION_ID
Ersetzen Sie Folgendes:
- INSTANCE-NAME: Der Name der Spanner-Instanz.
- DATABASE-NAME: Der Name der Spanner-Datenbank.
- PROJECT-NAME: Der Projektname.
- OPERATION-ID: Die Vorgangs-ID des zu prüfenden Vorgangs.
Im Abschnitt
progresswird in der Ausgabe der Prozentsatz des abgeschlossenen Vorgangs angezeigt. Die Ausgabe sieht dann ungefähr so aus:done: true ... progress: - endTime: '2021-01-22T21:58:42.912540Z' progressPercent: 100 startTime: '2021-01-22T21:58:11.053996Z' - progressPercent: 67 startTime: '2021-01-22T21:58:11.053996Z' ...
REST Version 1
Rufen Sie die Vorgangs-ID ab:
  gcloud spanner operations list --instance=INSTANCE-NAME

  --database=DATABASE-NAME --type=DATABASE_UPDATE_DDL
Ersetzen Sie Folgendes:
- INSTANCE-NAME durch den Namen der Cloud Spanner-Instanz.
- DATABASE-NAME durch den Namen der Datenbank.
Ersetzen Sie diese Werte in den folgenden Anfragedaten:
- PROJECT-ID: Projekt-ID.
- INSTANCE-ID: Instanz-ID.
- DATABASE-ID: die Datenbank-ID.
- OPERATION-ID: die Vorgangs-ID.
HTTP-Methode und URL:
GET https://spanner.googleapis.com/v1/projects/PROJECT-ID/instances/INSTANCE-ID/databases/DATABASE-ID/operations/OPERATION-ID
Wenn Sie die Anfrage senden möchten, maximieren Sie eine der folgenden Optionen:
Sie sollten eine JSON-Antwort ähnlich wie diese erhalten:
{
...
    "progress": [
      {
        "progressPercent": 100,
        "startTime": "2023-05-27T00:52:27.366688Z",
        "endTime": "2023-05-27T00:52:30.184845Z"
      },
      {
        "progressPercent": 100,
        "startTime": "2023-05-27T00:52:30.184845Z",
        "endTime": "2023-05-27T00:52:40.750959Z"
      }
    ],
...
  "done": true,
  "response": {
    "@type": "type.googleapis.com/google.protobuf.Empty"
  }
}
Bei gcloud und REST finden Sie den Fortschritt jeder Index-Backfill-Anweisung im Abschnitt progress. Für jede Anweisung im Anweisungsarray gibt es ein entsprechendes Feld im Fortschrittsarray. Die Reihenfolge dieses Fortschrittsarrays entspricht der Reihenfolge des Anweisungsarrays. Sobald sie verfügbar sind, werden die Felder startTime, progressPercent und endTime entsprechend ausgefüllt.
In der Ausgabe wird keine geschätzte Zeit für den Abschluss des Backfills angezeigt.
Wenn der Vorgang zu lange dauert, können Sie ihn abbrechen. Weitere Informationen finden Sie unter Indexerstellung abbrechen.
Szenarien beim Ansehen des Index-Backfill-Fortschritts
Es gibt verschiedene Szenarien, die auftreten können, wenn Sie den Fortschritt eines Index-Backfills prüfen möchten. Anweisungen zur Indexerstellung, die einen Index-Backfill erfordern, sind Teil von Schemaaktualisierungsvorgängen. Es können mehrere Anweisungen vorhanden sein, die Teil eines Schemaaktualisierungsvorgangs sind.
Das erste Szenario ist das einfachste, nämlich wenn die Anweisung zur Indexerstellung die erste Anweisung im Schemaaktualisierungsvorgang ist. Da die Anweisung zur Indexerstellung die erste Anweisung ist, wird sie aufgrund der Ausführungsreihenfolge als erste verarbeitet und ausgeführt.
Das Feld startTime der Anweisung zur Indexerstellung wird sofort mit der Startzeit des Schemaaktualisierungsvorgangs gefüllt. Als Nächstes wird das Feld progressPercent der Anweisung zur Indexerstellung ausgefüllt, wenn der Fortschritt des Index-Backfills über 0 % liegt. Schließlich wird das Feld endTime ausgefüllt, sobald die Anweisung festgeschrieben wurde.
Das zweite Szenario ist, wenn die Anweisung zur Indexerstellung nicht die erste Anweisung im Schemaaktualisierungsvorgang ist. Felder, die sich auf die Anweisung zur Indexerstellung beziehen, werden erst ausgefüllt, wenn die vorherigen Anweisungen aufgrund der Ausführungsreihenfolge festgeschrieben wurden.
Ähnlich wie im vorherigen Szenario wird nach dem Commit der vorherigen Anweisungen zuerst das Feld startTime der Anweisung zur Indexerstellung und dann das Feld progressPercent ausgefüllt. Zuletzt wird das Feld endTime ausgefüllt, sobald das Commit der Anweisung abgeschlossen ist.
Indexerstellung abbrechen
Sie können die Google Cloud CLI verwenden, um die Indexerstellung abzubrechen. Verwenden Sie den Befehl gcloud spanner operations list und die Option --filter, um eine Liste der Schemaaktualisierungsvorgänge für eine Spanner-Datenbank abzurufen:
gcloud spanner operations list \
    --instance=INSTANCE \
    --database=DATABASE \
    --filter="@TYPE:UpdateDatabaseDdlMetadata"
Suchen Sie nach der OPERATION_ID des Vorgangs, den Sie abbrechen möchten, und brechen Sie ihn mit dem Befehl gcloud spanner operations cancel ab:
gcloud spanner operations cancel OPERATION_ID \
    --instance=INSTANCE \
    --database=DATABASE
Vorhandene Indexe ansehen
Informationen zu vorhandenen Indexen in einer Datenbank können Sie über dieGoogle Cloud Console oder die Google Cloud CLI aufrufen:
Console
Rufen Sie in der Google Cloud Console die Spanner-Seite Instanzen auf.
Klicken Sie auf den Namen der Instanz, die Sie aufrufen möchten.
Klicken Sie im linken Bereich auf die Datenbank, die Sie sich ansehen möchten, und klicken Sie dann auf die Tabelle, die Sie aufrufen möchten.
Klicken Sie auf den Tab Indexe. In der Google Cloud Console wird eine Liste der Indexe angezeigt.
Optional: Klicken Sie auf den Namen eines Index, um Details zu diesem zu erhalten, z. B. die Spalten, die er enthält.
gcloud
Führen Sie den Befehl gcloud spanner databases ddl describe aus:
    gcloud spanner databases ddl describe DATABASE \
        --instance=INSTANCE
Die gcloud CLI gibt die DDL-Anweisungen (Data Definition Language) aus, um die Tabellen und Indexe der Datenbank zu erstellen. Die CREATE
INDEX-Anweisungen beschreiben die vorhandenen Indexe. Beispiel:
--- |-
CREATE TABLE Singers (
SingerId INT64 NOT NULL,
FirstName STRING(1024),
LastName STRING(1024),
SingerInfo BYTES(MAX),
) PRIMARY KEY(SingerId)
---
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName)
Abfrage mit einem bestimmten Index
In den folgenden Abschnitten wird erläutert, wie Sie einen Index in einer SQL-Anweisung und mit der Leseschnittstelle für Spanner angeben. In den Beispielen in diesen Abschnitten wird davon ausgegangen, dass Sie der Tabelle Albums eine Spalte MarketingBudget hinzugefügt und einen Index mit dem Namen AlbumsByAlbumTitle erstellt haben:
GoogleSQL
CREATE TABLE Albums (
  SingerId         INT64 NOT NULL,
  AlbumId          INT64 NOT NULL,
  AlbumTitle       STRING(MAX),
  MarketingBudget  INT64,
) PRIMARY KEY (SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);
PostgreSQL
CREATE TABLE Albums (
  SingerId         BIGINT NOT NULL,
  AlbumId          BIGINT NOT NULL,
  AlbumTitle       VARCHAR,
  MarketingBudget  BIGINT,
  PRIMARY KEY (SingerId, AlbumId)
) INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);
Index in einer SQL-Anweisung angeben
Wenn Sie eine Spanner-Tabelle mit SQL abfragen, verwendet Spanner automatisch alle Indexe, die die Abfrage wahrscheinlich effizienter machen. Daher müssen Sie für SQL-Abfragen keinen Index angeben. Bei Abfragen, die für Ihre Arbeitslast entscheidend sind, empfiehlt Google jedoch, FORCE_INDEX-Anweisungen in Ihren SQL-Anweisungen zu verwenden, um eine konsistentere Leistung zu erzielen.
In einigen Fällen wählt Spanner jedoch einen Index aus, der die Abfragelatenz erhöht. Wenn Sie die [Schritte zur Fehlerbehebung bei Leistungsabfällen][troubleshooting-query-performance-regressions] ausgeführt haben und einen anderen Index für die Abfrage verwenden möchten, können Sie den Index als Teil Ihrer Abfrage angeben.
Wenn Sie einen Index in einer SQL-Anweisung angeben möchten, verwenden Sie den Hinweis FORCE_INDEX, um eine Indexanweisung bereitzustellen. Indexanweisungen verwenden die folgende Syntax:
GoogleSQL
FROM MyTable@{FORCE_INDEX=MyTableIndex}
PostgreSQL
FROM MyTable /*@ FORCE_INDEX = MyTableIndex */
Sie können auch eine Indexanweisung verwenden, um Spanner anzuweisen, die Basistabelle zu scannen, anstatt einen Index zu verwenden:
GoogleSQL
FROM MyTable@{FORCE_INDEX=_BASE_TABLE}
PostgreSQL
FROM MyTable /*@ FORCE_INDEX = _BASE_TABLE */
Sie können eine Indexanweisung verwenden, um Spanner anzuweisen, einen Index in einer Tabelle mit benannten Schemas zu scannen:
GoogleSQL
FROM NAMED_SCHEMA_NAME.TABLE_NAME@{FORCE_INDEX="NAMED_SCHEMA_NAME.TABLE_INDEX_NAME"}
PostgreSQL
FROM NAMED_SCHEMA_NAME.TABLE_NAME /*@ FORCE_INDEX = TABLE_INDEX_NAME */
Das folgende Beispiel zeigt eine SQL-Abfrage, die einen Index angibt:
GoogleSQL
SELECT AlbumId, AlbumTitle, MarketingBudget
    FROM Albums@{FORCE_INDEX=AlbumsByAlbumTitle}
    WHERE AlbumTitle >= "Aardvark" AND AlbumTitle < "Goo";
PostgreSQL
SELECT AlbumId, AlbumTitle, MarketingBudget
    FROM Albums /*@ FORCE_INDEX = AlbumsByAlbumTitle */
    WHERE AlbumTitle >= 'Aardvark' AND AlbumTitle < 'Goo';
Eine Indexanweisung kann den Abfrageprozessor von Spanner dazu zwingen, zusätzliche Spalten zu lesen, die für die Abfrage erforderlich sind, aber nicht im Index gespeichert sind.
Der Abfrageprozessor ruft diese Spalten ab, indem er den Index und die Basistabelle zusammenfügt. Um diesen zusätzlichen Join zu vermeiden, verwenden Sie eine STORING-Klausel (Datenbanken im GoogleSQL-Dialekt) oder eine INCLUDE-Klausel (Datenbanken im PostgreSQL-Dialekt), um die zusätzlichen Spalten im Index zu speichern.
Im vorherigen Beispiel wird die Spalte MarketingBudget nicht im Index gespeichert, aber die SQL-Abfrage wählt diese Spalte aus. Daher muss Spanner die Spalte MarketingBudget in der Basistabelle suchen und dann mit Daten aus dem Index verknüpfen, um die Abfrageergebnisse zurückzugeben.
Cloud Spanner gibt einen Fehler aus, wenn die Indexanweisung eines der folgenden Probleme aufweist:
- Der Index existiert nicht.
- Der Index befindet sich in einer anderen Basistabelle.
- Der Abfrage fehlt ein erforderlicher
NULL-Filterausdruck für einenNULL_FILTERED-Index.
Die folgenden Beispiele zeigen, wie Abfragen geschrieben und ausgeführt werden, die die Werte von AlbumId, AlbumTitle und MarketingBudget mithilfe des Index AlbumsByAlbumTitle abrufen:
C++
C#
Go
Java
Node.js
PHP
Python
Ruby
Index in der Leseschnittstelle angeben
Wenn Sie die Leseschnittstelle für Spanner verwenden und möchten, dass Spanner einen Index verwendet, müssen Sie den Index angeben. Die Leseschnittstelle wählt den Index nicht automatisch aus.
Darüber hinaus muss Ihr Index alle Daten enthalten, die in den Abfrageergebnissen angezeigt werden, mit Ausnahme der Spalten, die Teil des Primärschlüssels sind. Diese Einschränkung besteht, weil die Leseschnittstelle keine Joins zwischen dem Index und der Basistabelle unterstützt. Wenn Sie weitere Spalten mit in die Abfrageergebnisse einbeziehen möchten, haben Sie mehrere Möglichkeiten:
- Verwenden Sie eine
STORING- oderINCLUDE-Klausel, um die zusätzlichen Spalten im Index zu speichern. - Machen Sie Ihre Abfrage, ohne die zusätzlichen Spalten einzubeziehen, und senden Sie dann mithilfe der Primärschlüssel eine weitere Abfrage, die die zusätzlichen Spalten liest.
Cloud Spanner gibt Werte aus dem Index in aufsteigender Sortierreihenfolge nach Indexschlüssel zurück. Führen Sie die folgenden Schritte aus, um Werte in absteigender Reihenfolge abzurufen:
Kommentieren Sie den Indexschlüssel mit
DESC. Beispiel:CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle DESC);Die Anmerkung
DESCgilt für einen einzelnen Indexschlüssel. Wenn der Index mehr als einen Schlüssel enthält und die Abfrageergebnisse auf Basis aller Schlüssel in absteigender Reihenfolge angezeigt werden sollen, fügen Sie für jeden Schlüssel eineDESC-Anmerkung ein.Wenn der Lesevorgang einen Schlüsselbereich angibt, muss der Schlüsselbereich ebenfalls in absteigender Reihenfolge angegeben werden. Mit anderen Worten: Der Wert des Startschlüssels muss größer sein als der Wert des Endschlüssels.
Das folgende Beispiel veranschaulicht, wie die Werte von AlbumId und AlbumTitle mit dem Index AlbumsByAlbumTitle abgerufen werden:
C++
C#
Go
Java
Node.js
PHP
Python
Ruby
Index für reine Indexscans erstellen
Optional können Sie die STORING-Klausel (für Datenbanken im GoogleSQL-Dialekt) oder die INCLUDE-Klausel (für Datenbanken im PostgreSQL-Dialekt) verwenden, um eine Kopie einer Spalte im Index zu speichern. Dieser Indextyp bietet Vorteile für Abfragen und Leseaufrufe unter Verwendung des Index, allerdings beansprucht das zusätzliche Speicherkapazität:
- SQL-Abfragen, die den Index verwenden und Spalten auswählen, die in der
STORING- oderINCLUDE-Klausel gespeichert sind, erfordern keinen zusätzlichen Join zur Basistabelle. read()-Aufrufe, die den Index verwenden, können Spalten lesen, die von derSTORING/INCLUDE-Anweisung gespeichert werden.
Angenommen, Sie haben eine alternative Version von AlbumsByAlbumTitle erstellt, in der eine Kopie der Spalte MarketingBudget im Index gespeichert wird (beachten Sie die fett formatierte STORING- oder INCLUDE-Klausel):
GoogleSQL
CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);
PostgreSQL
CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) INCLUDE (MarketingBudget);
Beim alten Index AlbumsByAlbumTitle muss Spanner den Index mit der Basistabelle verknüpfen und dann die Spalte aus der Basistabelle abrufen. Mit dem neuen Index AlbumsByAlbumTitle2 liest Spanner die Spalte direkt aus dem Index, was effizienter ist.
Wenn Sie statt SQL die Leseschnittstelle verwenden, können Sie mit dem neuen Index AlbumsByAlbumTitle2 auch direkt die Spalte MarketingBudget lesen:
C++
C#
Go
Java
Node.js
PHP
Python
Ruby
Index ändern
Mit der Anweisung ALTER INDEX können Sie einem vorhandenen Index zusätzliche Spalten hinzufügen oder Spalten löschen. Dadurch kann die Spaltenliste aktualisiert werden, die beim Erstellen des Index durch die STORING-Klausel (Datenbanken im GoogleSQL-Dialekt) oder die INCLUDE-Klausel (Datenbanken im PostgreSQL-Dialekt) definiert wird. Sie können diese Anweisung nicht verwenden, um dem Indexschlüssel Spalten hinzuzufügen oder daraus zu entfernen. Anstatt beispielsweise einen neuen Index AlbumsByAlbumTitle2 zu erstellen, können Sie mit ALTER INDEX eine Spalte in AlbumsByAlbumTitle einfügen, wie im folgenden Beispiel gezeigt:
GoogleSQL
ALTER INDEX AlbumsByAlbumTitle ADD STORED COLUMN MarketingBudget
PostgreSQL
ALTER INDEX AlbumsByAlbumTitle ADD INCLUDE COLUMN MarketingBudget
Wenn Sie einem vorhandenen Index eine neue Spalte hinzufügen, verwendet Spanner einen Backfill-Prozess im Hintergrund. Während der Backfill läuft, ist die Spalte im Index nicht lesbar. Daher erhalten Sie möglicherweise nicht die erwartete Leistungssteigerung. Mit dem Befehl gcloud spanner operations können Sie den Vorgang mit langer Ausführungszeit auflisten und seinen Status aufrufen.
Weitere Informationen finden Sie unter Vorgang beschreiben.
Sie können auch Vorgang abbrechen verwenden, um einen laufenden Vorgang abzubrechen.
Nachdem der Backfill abgeschlossen ist, fügt Spanner die Spalte dem Index hinzu. Wenn der Index größer wird, kann dies die Abfragen verlangsamen, die den Index verwenden.
Im folgenden Beispiel wird gezeigt, wie Sie eine Spalte aus einem Index löschen:
GoogleSQL
ALTER INDEX AlbumsByAlbumTitle DROP STORED COLUMN MarketingBudget
PostgreSQL
ALTER INDEX AlbumsByAlbumTitle DROP INCLUDE COLUMN MarketingBudget
Index von NULL-Werten
Standardmäßig indexiert Spanner NULL-Werte. Erinnern Sie sich beispielsweise an die Definition des Index SingersByFirstLastName in der Tabelle Singers:
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
Alle Zeilen von Singers werden auch dann indexiert, wenn FirstName oder LastName oder beide NULL sind.
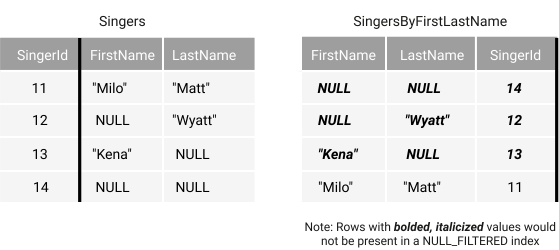
Wenn NULL-Werte indexiert werden, können Sie auf Daten, die NULL-Werte enthalten, effiziente SQL-Abfragen und Leseaufrufe durchführen. Verwenden Sie beispielsweise diese SQL-Abfrageanweisung, um alle Singers mit einem NULL FirstName zu finden:
GoogleSQL
SELECT s.SingerId, s.FirstName, s.LastName
    FROM Singers@{FORCE_INDEX=SingersByFirstLastName} AS s
    WHERE s.FirstName IS NULL;
PostgreSQL
SELECT s.SingerId, s.FirstName, s.LastName
    FROM Singers /* @ FORCE_INDEX = SingersByFirstLastName */ AS s
    WHERE s.FirstName IS NULL;
Sortierreihenfolge für NULL-Werte
Spanner sortiert NULL als kleinsten Wert für einen bestimmten Typ. Bei einer Spalte in aufsteigender (ASC) Reihenfolge werden NULL-Werte als Erstes einsortiert. Bei einer Spalte in absteigender (DESC) Reihenfolge werden NULL-Werte als Letztes einsortiert.
Indexierung von NULL-Werten deaktivieren
GoogleSQL
Um die Indexierung von Null-Werten zu deaktivieren, fügen Sie das Schlüsselwort NULL_FILTERED zur Indexdefinition hinzu. NULL_FILTERED-Indexe sind besonders nützlich, wenn es um die Indexierung von dünnbesetzten Spalten geht, bei denen die meisten Zeilen einen NULL-Wert enthalten. In diesen Fällen kann der NULL_FILTERED-Index erheblich kleiner und effizienter zu pflegen sein als ein normaler Index, der NULL-Werte enthält.
Hier eine alternative Definition von SingersByFirstLastName, die keine NULL-Werte indexiert:
CREATE NULL_FILTERED INDEX SingersByFirstLastNameNoNulls
    ON Singers(FirstName, LastName);
Das Keyword NULL_FILTERED gilt für alle Indexschlüsselspalten. Eine NULL-Filterung kann nicht pro Spalte angegeben werden.
PostgreSQL
Verwenden Sie das Prädikat WHERE COLUMN IS NOT NULL, um Zeilen mit Nullwerten in einer oder mehreren indexierten Spalten herauszufiltern.
Null-gefilterte Indexe sind besonders nützlich für die Indexierung von dünnbesetzten Spalten, in denen die meisten Zeilen einen NULL-Wert enthalten. In diesen Fällen kann der nullgefilterte Index erheblich kleiner und effizienter zu verwalten sein als ein normaler Index, der NULL-Werte enthält.
Hier eine alternative Definition von SingersByFirstLastName, die keine NULL-Werte indexiert:
CREATE INDEX SingersByFirstLastNameNoNulls
    ON Singers(FirstName, LastName)
    WHERE FirstName IS NOT NULL
    AND LastName IS NOT NULL;
Wenn Sie NULL-Werte herausfiltern, kann Spanner sie für einige Abfragen nicht verwenden. Spanner verwendet den Index beispielsweise nicht für diese Abfrage, da der Index alle Singers-Zeilen weglässt, für die LastName den Wert NULL hat. Wenn der Index verwendet würde, würde die Abfrage nicht die richtigen Zeilen zurückgeben:
GoogleSQL
FROM Singers@{FORCE_INDEX=SingersByFirstLastNameNoNulls}
    WHERE FirstName = "John";
PostgreSQL
FROM Singers /*@ FORCE_INDEX = SingersByFirstLastNameNoNulls */
    WHERE FirstName = 'John';
Damit Spanner den Index verwenden kann, müssen Sie die Abfrage so umschreiben, dass die Zeilen ausgeschlossen werden, die auch aus dem Index ausgeschlossen sind:
GoogleSQL
SELECT FirstName, LastName
    FROM Singers@{FORCE_INDEX=SingersByFirstLastNameNoNulls}
    WHERE FirstName = 'John' AND LastName IS NOT NULL;
PostgreSQL
SELECT FirstName, LastName
    FROM Singers /*@ FORCE_INDEX = SingersByFirstLastNameNoNulls */
    WHERE FirstName = 'John' AND LastName IS NOT NULL;
Proto-Felder indexieren
Verwenden Sie generierte Spalten, um Felder in Protokollzwischenspeichern zu indexieren, die in PROTO-Spalten gespeichert sind, sofern die zu indexierenden Felder die primitiven oder ENUM-Datentypen verwenden.
Wenn Sie einen Index für ein Protokollnachrichtenfeld definieren, können Sie dieses Feld nicht mehr im Proto-Schema ändern oder daraus entfernen. Weitere Informationen finden Sie unter Aktualisierungen von Schemas, die einen Index für Proto-Felder enthalten.
Im Folgenden finden Sie ein Beispiel für die Tabelle Singers mit einer Proto-Nachrichtenspalte vom Typ SingerInfo. Wenn Sie einen Index für das Feld nationality von PROTO definieren möchten, müssen Sie eine gespeicherte generierte Spalte erstellen:
GoogleSQL
CREATE PROTO BUNDLE (googlesql.example.SingerInfo, googlesql.example.SingerInfo.Residence);

CREATE TABLE Singers (
  SingerId INT64 NOT NULL,
  ...
  SingerInfo googlesql.example.SingerInfo,
  SingerNationality STRING(MAX) AS (SingerInfo.nationality) STORED
) PRIMARY KEY (SingerId);
Es hat die folgende Definition des Prototyps googlesql.example.SingerInfo:
GoogleSQL
package googlesql.example;

message SingerInfo {
optional string    nationality = 1;
repeated Residence residence   = 2;

  message Residence {
    required int64  start_year   = 1;
    optional int64  end_year     = 2;
    optional string city         = 3;
    optional string country      = 4;
  }
}
Definieren Sie dann einen Index für das Feld nationality des Protos:
GoogleSQL
CREATE INDEX SingersByNationality ON Singers(SingerNationality);
Mit der folgenden SQL-Abfrage werden Daten mithilfe des vorherigen Index gelesen:
GoogleSQL
SELECT s.SingerId, s.FirstName
FROM Singers AS s
WHERE s.SingerNationality = "English";
Hinweise:
- Verwenden Sie eine Indexanweisung, um auf Indexe in den Feldern von Protokollzwischenspeicher-Spalten zuzugreifen.
- Sie können keinen Index für wiederholte Protokollzwischenspeicherfelder erstellen.
Aktualisierungen von Schemas, die einen Index für Proto-Felder enthalten
Wenn Sie einen Index für ein Protokollnachrichtenfeld definieren, können Sie dieses Feld nicht mehr ändern oder aus dem Proto-Schema entfernen. Das liegt daran, dass nach der Definition des Index bei jeder Aktualisierung des Schemas eine Typprüfung durchgeführt wird. Cloud Spanner erfasst die Typinformationen für alle Felder im Pfad, die in der Indexdefinition verwendet werden.
Eindeutige Indexe
Indexe können als UNIQUE deklariert werden. UNIQUE-Indexe fügen den indexierten Daten eine Einschränkung hinzu, die doppelte Einträge für einen bestimmten Indexschlüssel verbietet.
Diese Einschränkung wird von Cloud Spanner beim Transaktions-Commit erzwungen.
Genauer gesagt kann eine Transaktion, die dazu führen würde, dass mehrere Indexeinträge für denselben Schlüssel existieren, nicht ausgeführt werden.
Wenn eine Tabelle anfänglich keine UNIQUE-Daten enthält, schlägt der Versuch fehl, einen UNIQUE-Index zu erstellen.
Ein Hinweis zu UNIQUE NULL_FILTERED-Indexen
Ein UNIQUE NULL_FILTERED-Index erzwingt keine Eindeutigkeit des Indexschlüssels, wenn mindestens eine der Schlüsselkomponenten des Index NULL ist.
Angenommen, Sie haben die folgende Tabelle und den folgenden Index erstellt:
GoogleSQL
CREATE TABLE ExampleTable (
  Key1 INT64 NOT NULL,
  Key2 INT64,
  Key3 INT64,
  Col1 INT64,
) PRIMARY KEY (Key1, Key2, Key3);

CREATE UNIQUE NULL_FILTERED INDEX ExampleIndex ON ExampleTable (Key1, Key2, Col1);
PostgreSQL
CREATE TABLE ExampleTable (
  Key1 BIGINT NOT NULL,
  Key2 BIGINT,
  Key3 BIGINT,
  Col1 BIGINT,
  PRIMARY KEY (Key1, Key2, Key3)
);

CREATE UNIQUE INDEX ExampleIndex ON ExampleTable (Key1, Key2, Col1)
    WHERE Key1 IS NOT NULL
    AND Key2 IS NOT NULL
    AND Col1 IS NOT NULL;
Die folgenden zwei Zeilen in ExampleTable weisen die gleichen Werte für die Sekundärindexschlüssel Key1, Key2 und Col1 auf:
1, NULL, 1, 1
1, NULL, 2, 1
Da Key2 den Wert NULL hat und der Index nullgefiltert ist, sind die Zeilen nicht im Index ExampleIndex vorhanden. Da sie nicht in den Index eingefügt werden, werden sie vom Index nicht wegen Verstoßes gegen die Eindeutigkeit von (Key1, Key2,
Col1) abgelehnt.
Wenn der Index die Eindeutigkeit der Werte des Tupels (Key1, Key2, Col1) erzwingen soll, müssen Sie Key2 in der Tabellendefinition mit NOT NULL annotieren oder den Index ohne Filterung von Nullwerten erstellen.
Index basierend auf einem skalaren Ausdruck erstellen
Mit einem Ausdrucksindex können Sie einen Index basierend auf einem skalaren Ausdruck erstellen, der auf eine oder mehrere Tabellenspalten angewendet wird. Das ist vorteilhaft, da Sie keine dedizierte generierte Spalte in Ihrer Tabelle nur für Indexierungszwecke erstellen und verwalten müssen.
Indexe für generierte Spalten und Ausdrucksindexe können nützlich sein, um bestimmte Felder in einer JSON-Spalte zu indexieren. Sie können einen Index für einen Wert erstellen, der aus einem JSON-Objekt extrahiert wurde. Dadurch kann der Abfrageoptimierer effizient Suchvorgänge basierend auf diesem Wert ausführen.
In diesem Beispiel wird eine generierte Spalte namens VenueCity, die auf dem Feld city im JSON-Code basiert, nur zu dem Zweck erstellt, sie in einen Index aufzunehmen:
GoogleSQL
CREATE TABLE Venues (
  Id INT64 NOT NULL,
  VenueData JSON,
  VenueCity STRING AS (JSON_VALUE(VenueData.address.city))
) PRIMARY KEY (Id);

CREATE INDEX VenuesByCity ON Venues(VenueCity);
PostgreSQL
CREATE TABLE Venues (
  Id BIGINT NOT NULL PRIMARY KEY,
  VenueData JSONB,
  VenueCity VARCHAR GENERATED ALWAYS AS (VenueData -> 'address' ->> 'city')
);

CREATE INDEX VenuesByCity ON Venues(VenueCity);
Um dies effizienter zu erreichen, können Sie den Index direkt definieren. Spanner übernimmt dann den zugrunde liegenden Mechanismus implizit:
GoogleSQL
CREATE TABLE Venues (
  Id INT64 NOT NULL,
  VenueData JSON
) PRIMARY KEY (Id);

CREATE INDEX VenuesByCity ON Venues((JSON_VALUE(VenueData.address.city)));
PostgreSQL
CREATE TABLE Venues (
  Id BIGINT NOT NULL PRIMARY KEY,
  VenueData JSONB
);

CREATE INDEX VenuesByCity ON Venues((VenueData -> 'address' ->> 'city'));
In beiden Fällen kann Ihre Abfrage den Index VenuesByCity für eine schnellere Ausführung verwenden:
GoogleSQL
SELECT Id
FROM Venues
WHERE JSON_VALUE(VenueData.address.city) = 'Seattle';
PostgreSQL
SELECT Id
FROM Venues
WHERE VenueData -> 'address' ->> 'city' = 'Seattle';
Ausdrucksindexe können Spalten enthalten, die eine Mischung aus Ausdrücken und direkten Spaltenverweisen sind. So können mehr Abfragen den Index für eine schnellere Ausführung verwenden.
GoogleSQL
CREATE TABLE Venues (
  Id INT64 NOT NULL,
  VenueName STRING(MAX),
  VenueData JSON
) PRIMARY KEY (Id);

CREATE INDEX VenuesByCity ON Venues(
  VenueName,
  (JSON_VALUE(VenueData.address.city)),
  (JSON_VALUE(VenueData.address.state))
);
PostgreSQL
CREATE TABLE Venues (
  Id BIGINT NOT NULL PRIMARY KEY,
  VenueName VARCHAR,
  VenueData JSONB
);

CREATE INDEX VenuesIdx ON Venues(
  VenueName,
  (VenueData -> 'address' ->> 'city'),
  (VenueData -> 'address' ->> 'state'),
);
Index löschen
Verwenden Sie die Anweisung DROP INDEX, um einen sekundären Index aus Ihrem Schema zu löschen.
So löschen Sie den Index mit dem Namen SingersByFirstLastName:
DROP INDEX SingersByFirstLastName;
Index für schnelleres Scannen
Wenn Spanner einen Tabellenscan (anstelle einer indexierten Suche) durchführen muss, um Werte aus einer oder mehreren Spalten abzurufen, können Sie schnellere Ergebnisse erhalten, wenn ein Index für diese Spalten vorhanden ist und die Reihenfolge der Abfrage entspricht. Wenn Sie häufig Abfragen ausführen, die Scans erfordern, sollten Sie sekundäre Indexe erstellen, damit diese Scans effizienter ausgeführt werden können.
Wenn Spanner den Primärschlüssel oder einen anderen Index einer Tabelle häufig in umgekehrter Reihenfolge scannen muss, können Sie die Effizienz durch einen sekundären Index steigern, der die ausgewählte Reihenfolge explizit macht.
Die folgende Abfrage gibt beispielsweise immer ein schnelles Ergebnis zurück, obwohl Spanner Songs scannen muss, um den niedrigsten Wert von SongId zu finden:
SELECT SongId FROM Songs LIMIT 1;
SongId ist der Primärschlüssel der Tabelle, der (wie alle Primärschlüssel) in aufsteigender Reihenfolge gespeichert wird. Spanner kann den Index dieses Schlüssels scannen und das erste Ergebnis schnell finden.
Ohne die Hilfe eines sekundären Index würde die folgende Abfrage jedoch nicht so schnell zurückgegeben, insbesondere wenn Songs viele Daten enthält:
SELECT SongId FROM Songs ORDER BY SongId DESC LIMIT 1;
Obwohl SongId der Primärschlüssel der Tabelle ist, kann Spanner den höchsten Wert der Spalte nicht abrufen, ohne einen vollständigen Tabellenscan durchzuführen.
Wenn Sie den folgenden Index hinzufügen, kann diese Abfrage schneller zurückgegeben werden:
CREATE INDEX SongIdDesc On Songs(SongId DESC);
Mit diesem Index würde Spanner ein Ergebnis für die zweite Abfrage viel schneller zurückgeben.
Nächste Schritte
- SQL-Best-Practices für Spanner
- Abfrageausführungspläne für Spanner verstehen
- Informationen zur Fehlerbehebung bei Leistungsregressionen in SQL-Abfragen