


Halaman ini menjelaskan teknik untuk menyesuaikan performa kueri Spanner. Sebelum mulai menyesuaikan kueri, tinjau halaman berikut, yang menjelaskan konsep dasar dan alat yang digunakan dalam penyesuaian kueri:
Kueri dan rencana eksekusi di halaman ini didasarkan pada skema database berikut:
CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo BYTES(MAX),
  BirthDate  DATE
) PRIMARY KEY(SingerId);

CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);

CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);

CREATE TABLE Songs (
  SingerId  INT64 NOT NULL,
  AlbumId   INT64 NOT NULL,
  TrackId   INT64 NOT NULL,
  SongName  STRING(MAX),
  Duration  INT64,
  SongGenre STRING(25)
) PRIMARY KEY(SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC), INTERLEAVE IN Albums;

CREATE INDEX SongsBySongName ON Songs(SongName);

CREATE TABLE Concerts (
  VenueId      INT64 NOT NULL,
  SingerId     INT64 NOT NULL,
  ConcertDate  DATE NOT NULL,
  BeginTime    TIMESTAMP,
  EndTime      TIMESTAMP,
  TicketPrices ARRAY<INT64>
) PRIMARY KEY(VenueId, SingerId, ConcertDate);
Anda dapat menggunakan pernyataan Bahasa Pengolahan Data (DML) berikut untuk menambahkan data ke tabel ini:
INSERT INTO Singers (SingerId, FirstName, LastName, BirthDate)
VALUES (1, "Marc", "Richards", "1970-09-03"),
       (2, "Catalina", "Smith", "1990-08-17"),
       (3, "Alice", "Trentor", "1991-10-02"),
       (4, "Lea", "Martin", "1991-11-09"),
       (5, "David", "Lomond", "1977-01-29");

INSERT INTO Albums (SingerId, AlbumId, AlbumTitle)
VALUES (1, 1, "Total Junk"),
       (1, 2, "Go, Go, Go"),
       (2, 1, "Green"),
       (2, 2, "Forever Hold Your Peace"),
       (2, 3, "Terrified"),
       (3, 1, "Nothing To Do With Me"),
       (4, 1, "Play");

INSERT INTO Songs (SingerId, AlbumId, TrackId, SongName, Duration, SongGenre)
VALUES (2, 1, 1, "Let's Get Back Together", 182, "COUNTRY"),
       (2, 1, 2, "Starting Again", 156, "ROCK"),
       (2, 1, 3, "I Knew You Were Magic", 294, "BLUES"),
       (2, 1, 4, "42", 185, "CLASSICAL"),
       (2, 1, 5, "Blue", 238, "BLUES"),
       (2, 1, 6, "Nothing Is The Same", 303, "BLUES"),
       (2, 1, 7, "The Second Time", 255, "ROCK"),
       (2, 3, 1, "Fight Story", 194, "ROCK"),
       (3, 1, 1, "Not About The Guitar", 278, "BLUES");
Rekomendasi tolok ukur
Statistik performa yang paling andal berasal dari menjalankan uji beban yang menggunakan nilai parameter kueri yang berbeda dan diacak dari instance virtual machine (VM) Google Cloud yang berada di region yang sama dengan instance target.
Hindari mengandalkan Spanner Studio atau mode QueryMode.PROFILE untuk
melakukan benchmark kueri, karena alat ini tidak mereplikasi jaringan produksi
dan lingkungan klien yang sebenarnya. Namun, setelah uji beban mengidentifikasi masalah performa, rencana kueri (baik yang diambil sampelnya di Query Insights maupun yang dijalankan sesuai permintaan di Spanner Studio) adalah alat yang berguna untuk menyelidiki masalah spesifik tersebut.
Memahami rencana eksekusi kueri
Dalam visualizer rencana kueri, rencana eksekusi kueri ditampilkan sebagai hierarki operator, dengan setiap operator membaca baris dari operator turunannya, memprosesnya, dan meneruskan hasilnya ke operator induknya.
Untuk sebagian besar operator dalam rencana visual, latensi yang dilaporkan bersifat aditif (hanya mencerminkan waktu yang dihabiskan dalam operator tersebut). Namun, untuk operator Distributed union dan Distributed apply, latensi yang dilaporkan bersifat kumulatif: mencakup waktu yang dihabiskan dalam operator terdistribusi itu sendiri dan waktu yang dihabiskan dalam operator turunannya. Untuk mengetahui informasi selengkapnya tentang operator ini, lihat Distributed union dan Distributed apply.
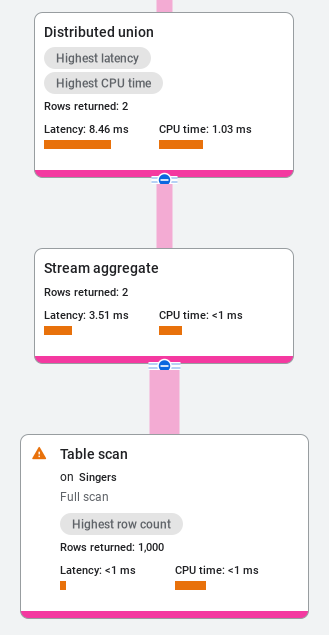
Misalnya, dalam rencana gabungan terdistribusi berikut, kartu Distributed union
melaporkan total latensi sebesar 8,46 md, sedangkan operator Stream aggregate
turunannya melaporkan 3,51 md dan Table scan melaporkan 1 md. Karena
latensi Distributed union bersifat kumulatif, operator Distributed union
sendiri hanya menambahkan latensi sekitar 5 md, bukan 8 md:
Dalam contoh berikutnya, kartu Distributed union melaporkan latensi 13,69 md, sedangkan operator turunannya (Stream aggregate pada <1 md, Cross apply pada 1,14 md, Table scan pada Albums pada <1 md, Filter scan pada 1 md, dan Table scan pada Singers pada 10,85 md) menyumbang sekitar 13 md. Akibatnya, operator Distributed union itu sendiri menambahkan latensi kurang dari 1 md, bukan 13 md:

Anda juga dapat melihat nilai latensi kumulatif di panel ringkasan operator.
Menggabungkan beberapa indeks
Saat kueri memfilter beberapa kolom yang diindeks menggunakan kondisi OR atau AND,
Spanner terkadang dapat menggabungkan beberapa indeks sekunder untuk menghindari
pemindaian tabel dasar lengkap. Contoh di bagian ini memperluas tabel Albums
dari skema contoh sebelumnya dengan menambahkan kolom ReleaseDate dan
indeks sekunder AlbumsByReleaseDate:
CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  ReleaseDate     DATE,
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByReleaseDate ON Albums(ReleaseDate);
Pertimbangkan kueri berikut, yang menggunakan kondisi OR untuk memfilter predikat dari dua indeks sekunder terpisah (AlbumsByAlbumTitle dan AlbumsByReleaseDate):
SELECT a.AlbumId, a.AlbumTitle, a.ReleaseDate
FROM Albums AS a
WHERE a.AlbumTitle = 'Play' OR a.ReleaseDate = '2023-09-07';
Jika kueri memiliki kondisi OR pada predikat dari dua indeks terpisah, Spanner dapat menggunakan pengoptimalan berbasis biaya untuk membaca kedua indeks dan menggabungkan hasilnya (gabungan indeks). Anda juga dapat menerapkan pengoptimalan ini
dengan menambahkan petunjuk tabel INDEX_STRATEGY=FORCE_INDEX_UNION ke kueri:
SELECT a.AlbumId, a.AlbumTitle, a.ReleaseDate
FROM Albums@{INDEX_STRATEGY=FORCE_INDEX_UNION} AS a
WHERE a.AlbumTitle = 'Play' OR a.ReleaseDate = '2023-09-07';
Untuk mengetahui informasi selengkapnya tentang petunjuk tabel, lihat Petunjuk tabel.
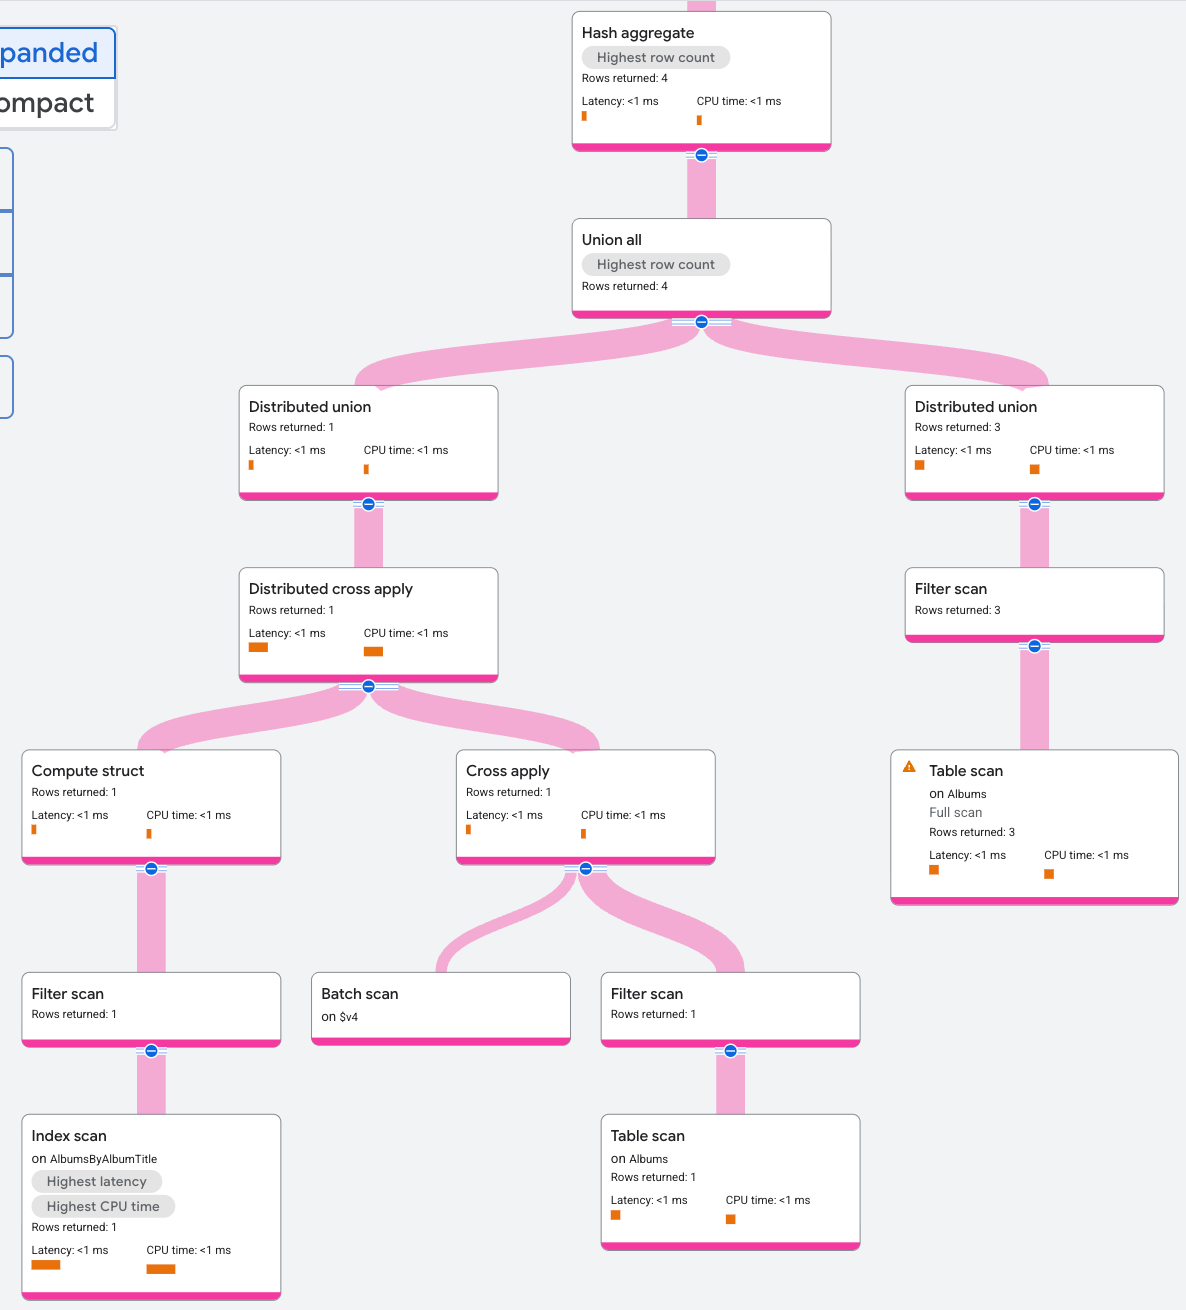
Diagram rencana eksekusi berikut menunjukkan cara Spanner mengevaluasi
kondisi OR (disjungsi) ini dengan memindai setiap cabang secara terpisah dan
menggabungkan hasilnya menggunakan operator Union all dan Hash aggregate:
Selanjutnya, pertimbangkan kueri yang menggunakan kondisi AND untuk memfilter kedua kolom yang diindeks:
SELECT a.AlbumId, a.ReleaseDate, a.AlbumTitle
FROM Albums AS a
WHERE a.AlbumTitle = 'Aardvark' AND a.ReleaseDate = '2023-09-07';
Dengan kondisi AND, Spanner memilih satu indeks secara default, lalu bergabung kembali ke tabel dasar, jika diperlukan, untuk mengevaluasi kondisi yang tersisa dalam klausa AND. Untuk menentukan apakah back-join tabel dasar ini
merupakan bottleneck performa, periksa rencana eksekusi kueri di visualizer: jika
operator Index scan menampilkan banyak baris yang kemudian difilter
setelah digabungkan dengan operator Table scan pada tabel dasar (yang menghasilkan
latensi atau waktu CPU yang tinggi pada cabang Table scan dibandingkan dengan jumlah akhir
baris yang ditampilkan), maka back-join adalah bottleneck.
Jika back-join tabel dasar adalah bottleneck untuk kueri, solusi yang direkomendasikan adalah menambahkan kolom tambahan dalam kondisi AND ke klausa STORING indeks sekunder sehingga Spanner dapat mengevaluasi kedua kondisi langsung dari indeks tanpa membaca tabel dasar:
CREATE INDEX AlbumsByAlbumTitleStoringReleaseDate
  ON Albums(AlbumTitle)
  STORING (ReleaseDate);
Jika mengubah indeks tidak memungkinkan, alternatifnya adalah menulis ulang kueri untuk
melakukan persimpangan kedua indeks menggunakan INTERSECT DISTINCT, lalu
menggabungkan kunci utama yang cocok kembali ke tabel dasar Albums:
SELECT union_a.AlbumId, a.ReleaseDate, a.AlbumTitle FROM
  (SELECT a1.SingerId, a1.AlbumId
  FROM Albums @{force_index=AlbumsByReleaseDate} AS a1
  WHERE a1.ReleaseDate = '2023-09-07'
  INTERSECT DISTINCT
  SELECT a2.SingerId, a2.AlbumId
  FROM Albums @{force_index=AlbumsByAlbumTitle} AS a2
  WHERE a2.AlbumTitle = 'Aardvark') AS union_a
JOIN Albums AS a
  ON a.SingerId = union_a.SingerId AND a.AlbumId = union_a.AlbumId;
Diagram rencana eksekusi berikut menunjukkan kueri yang ditulis ulang. Perhatikan bagaimana
rencana menggunakan dua operator Index scan (on AlbumsByAlbumTitle dan
on AlbumsByReleaseDate) untuk menemukan kunci yang berpotongan sebelum melakukan
Table scan pada tabel dasar Albums:

Jika pemfilteran di beberapa kolom adalah pola yang sering terjadi dalam workload Anda, pertimbangkan untuk menggunakan penelusuran teks lengkap multi-kolom, bukan indeks sekunder. Untuk mengetahui informasi selengkapnya, lihat Melakukan penelusuran multi-kolom.
Mengoptimalkan penggabungan
Saat Spanner menjalankan kueri yang menggabungkan beberapa tabel, pengoptimal kueri akan memilih urutan penggabungan (urutan penggabungan tabel) dan metode penggabungan (algoritma yang digunakan untuk menggabungkan baris dari dua input, seperti penggabungan penerapan, penggabungan hash, atau penggabungan gabungan). Jika kueri dengan join lebih lambat dari yang diharapkan, Anda dapat menggunakan petunjuk kueri untuk menginstruksikan Spanner agar menggunakan urutan join atau metode join yang berbeda. Tindakan ini mengubah rencana eksekusi, tetapi tidak mengubah hasil yang ditampilkan. Misalnya:
GoogleSQL
Urutan join paksa:
SELECT *
FROM Singers AS s JOIN@{FORCE_JOIN_ORDER=TRUE} Albums AS a
ON s.SingerId = a.SingerId
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
Ubah metode bergabung:
SELECT *
FROM Singers AS s JOIN@{JOIN_METHOD=HASH_JOIN} Albums AS a
ON s.SingerId = a.SingerId;
PostgreSQL
Urutan join paksa:
SELECT *
FROM Singers AS s JOIN/*@ FORCE_JOIN_ORDER=TRUE */ Albums AS a
ON s.SingerId = a.SingerId
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
Ubah metode bergabung:
SELECT *
FROM Singers AS s JOIN/*@ JOIN_METHOD=HASH_JOIN */ Albums AS a
ON s.SingerId = a.SingerId;
Bagian berikut memberikan latar belakang yang dapat membantu Anda menentukan urutan gabungan dan metode gabungan yang dapat membantu meningkatkan performa kueri.
Metode penggabungan dan pemindaian
Spanner mendukung beberapa metode join, dan pilihan metode join Anda secara langsung memengaruhi cara Spanner memindai tabel atau indeks yang mendasarinya:
- Apply join (dikenal di beberapa sistem sebagai lookup join atau nested loop join): mengeksekusi sisi kanan ("peta") satu kali untuk setiap baris dari sisi kiri ("input"). Karena setiap pencarian sisi kanan menggunakan nilai dari baris sisi kiri saat ini, kolom gabungan dari kiri dapat digunakan sebagai kunci pencarian di sebelah kanan. Distributed apply join berfungsi mirip dengan local apply join, tetapi mengelompokkan baris bersama-sama untuk komunikasi yang lebih efisien di seluruh pemisahan dalam distributed join.
- Hash join: membaca baris dari satu input untuk membuat tabel hash dalam memori pada kunci join, lalu memindai input lainnya untuk memeriksa kecocokan tabel hash.
- Merge join: membaca kedua input dalam urutan yang diurutkan pada kunci gabungan dan menggabungkan baris yang cocok dalam satu penerusan.
Misalnya, pertimbangkan kueri berikut yang menggabungkan Singers dan Albums:
SELECT s.*, a.AlbumTitle
FROM Singers AS s
JOIN Albums AS a ON s.SingerId = a.SingerId
WHERE s.SingerId = 2 AND a.AlbumId = 1;
Dengan apply join, s.SingerId = a.SingerId bertindak sebagai kondisi pencarian di sisi kanan join, sehingga kueri hanya perlu membaca satu baris dari tabel Albums.
Sebaliknya, dalam hash join atau merge join, input kiri dan kanan dibaca secara independen satu sama lain, sehingga kondisi join tidak memberikan kunci pencarian dari satu sisi ke sisi lainnya. Dalam kasus terburuk, hash atau merge join melakukan pemindaian tabel lengkap untuk setiap input.
Dalam kueri interaktif dan transaksional, sebagian besar join menggunakan indeks, sehingga penerapan terdistribusi adalah jenis join yang paling umum di Spanner. Namun, terkadang hash atau merge join adalah pilihan yang lebih baik karena membaca rentang baris yang berdekatan jauh lebih cepat daripada melakukan jumlah pencarian baris tunggal yang tersebar yang sama. Komprominya adalah apakah lebih cepat mencari lebih sedikit baris (menggunakan apply join) atau memindai rentang baris yang berdekatan yang lebih besar (menggunakan hash atau merge join). Untuk mengetahui informasi selengkapnya tentang konsekuensi ini, lihat Pembacaan berurutan versus pencarian tersebar.
Untuk kueri yang membaca ribuan baris, jika indeks tersedia pada kunci gabungan, biasanya lebih aman untuk menggunakan distributed apply join. Hal ini karena biaya join penerapan sebanding dengan jumlah baris yang digabungkan, sedangkan dengan join hash atau penggabungan, biayanya dapat sebanding dengan ukuran tabel total. Untuk kueri yang lebih besar (seperti kueri yang memproses jutaan baris), menggunakan hash atau merge join dapat memberikan peningkatan performa yang signifikan.
Untuk informasi selengkapnya tentang operator dan petunjuk join, lihat referensi berikut:
Gabung ke pemesanan
Seperti dalam sistem manajemen database relasional (RDBMS) lainnya, urutkan join untuk menjaga ukuran hasil perantara sekecil mungkin. Artinya, memfilter data sedini mungkin, dan menunda pencocokan besar selambat mungkin.
Jika Anda memberikan petunjuk FORCE_JOIN_ORDER=TRUE, Spanner akan mengeksekusi
gabungan dalam urutan yang sama persis dengan yang muncul dalam teks kueri. Pindahkan join dengan filter yang sangat selektif ke bagian awal kueri, dan pindahkan join dengan kecocokan besar ke bagian akhir kueri.
Mengoptimalkan agregasi
Teknik berikut dapat membantu Anda mengurangi jumlah baris yang dipindai dan diurutkan selama kueri agregasi.
Mengambil satu baris per awalan kunci
Pola agregasi yang umum adalah mengambil satu baris per awalan kunci (misalnya, baris dengan nomor versi atau stempel waktu tertinggi). Di
GoogleSQL, cara paling efisien untuk melakukannya adalah menggunakan ANY_VALUE
dengan HAVING MAX, yang menemukan baris dengan nilai maksimum dan menampilkan
kolom yang diminta dalam satu penerusan agregasi tanpa memerlukan self-join atau
pengurutan penuh. Misalnya, kueri berikut mengelompokkan tabel Concerts berdasarkan
ConcertDate dan menampilkan BeginTime konser dengan
EndTime terbaru untuk setiap tanggal:
SELECT ConcertDate, ANY_VALUE(BeginTime HAVING MAX(EndTime))
FROM Concerts
GROUP BY ConcertDate;
Memeriksa keberadaan baris
Untuk memeriksa apakah tabel memiliki baris, atau baris yang cocok dengan kondisi tertentu, gunakan LIMIT, bukan COUNT. Contoh:
SELECT 1 FROM Albums LIMIT 1;
Meningkatkan paralelisme
Spanner membagi tabel dan indeks menjadi rentang kunci utama yang berdekatan yang disebut pemisahan, yang dapat diproses secara paralel di beberapa server. Biasanya, Spanner memilih paralelisme kueri untuk menyeimbangkan latensi dan efisiensi. Misalnya, jika kueri memiliki klausa LIMIT, kueri tersebut mungkin menggunakan lebih sedikit paralelisme untuk menghindari pemborosan pekerjaan yang dibuang oleh batas. Jumlah pemisahan yang dipindai oleh kueri membatasi tingkat paralelisme maksimum.
Untuk kueri dengan batas atau pemindaian besar, Anda dapat menetapkan petunjuk pernyataan USE_ADDITIONAL_PARALLELISM=TRUE untuk menginstruksikan Spanner agar mengoptimalkan latensi:
GoogleSQL
@{USE_ADDITIONAL_PARALLELISM=TRUE}
SELECT *
FROM Singers
LIMIT 10;
PostgreSQL
/*@ USE_ADDITIONAL_PARALLELISM=TRUE */
SELECT *
FROM Singers
LIMIT 10;
Petunjuk ini mungkin akan memenuhi CPU pada pemisahan tertentu. Jika kueri berjalan lama, kirimkan dengan prioritas permintaan sedang untuk menghindari peningkatan latensi bagi kueri prioritas tinggi lainnya.
Batas Optimize
Jika kueri berisi klausa LIMIT, tetapi memindai lebih banyak baris daripada nilai batas, periksa kemungkinan penyebab berikut:
Indeks tidak ada
Jika kueri memiliki filter yang tidak dapat dipenuhi menggunakan indeks, rencana kueri akan memindai tabel dasar atau indeks yang tidak memberikan tata urutan yang diperlukan. Kemudian, kueri akan mengurutkan data yang cocok sepenuhnya sebelum mengevaluasi klausa LIMIT.
Untuk mengatasi masalah ini, pertimbangkan untuk menambahkan indeks sekunder yang mencakup kolom filter. Jika indeks ditentukan sebagai NULL_FILTERED (artinya, indeks mengecualikan baris yang kolom terindeksnya adalah NULL), pastikan predikat kueri menyertakan IS NOT NULL agar pengoptimal dapat menggunakan indeks. Untuk mengetahui informasi selengkapnya tentang cara membuat indeks sekunder, lihat Indeks sekunder.
Pengurutan penuh
Jika indeks ada di kolom yang difilter, tetapi indeks tidak memberikan
tata urutan yang diperlukan oleh klausa ORDER BY, Spanner harus membaca
semua baris yang cocok dan meneruskannya ke operator Sort dalam rencana eksekusi kueri
sebelum menerapkan LIMIT.
Untuk menghindari pengurutan penuh, tentukan kolom dalam pernyataan CREATE INDEX Anda dalam
urutan berikut:
- Pertama, kolom apa pun yang memiliki kondisi kesetaraan (
=) atauINdalam kueri - Kemudian, kolom yang sama dengan klausa
ORDER BYkueri, dalam urutan yang sama, dan dengan arah pengurutan yang sama (ASCatauDESC)
Misalnya, Anda memiliki tabel Users (tidak ditampilkan dalam contoh skema sebelumnya) dan ingin mengoptimalkan kueri berikut:
SELECT * FROM Users
WHERE Name='Alex'
ORDER BY LastLogin DESC
LIMIT 10;
Buat indeks di (Name, LastLogin DESC) agar Spanner dapat membaca
10 baris teratas secara langsung dalam urutan indeks tanpa pengurutan:
CREATE INDEX UsersByNameLastLogin ON Users(Name, LastLogin DESC);
Mengurutkan berdasarkan akhiran kunci
Meskipun indeks menyertakan kolom ORDER BY sebagai akhiran kunci indeks,
kueri mungkin masih memindai baris tambahan jika ada predikat IN, OR, atau rentang
pada salah satu kolom awalan indeks.
Misalnya, pertimbangkan kueri berikut yang menggunakan indeks (Name, LastLogin DESC)
dari contoh pengurutan lengkap sebelumnya, yang bukan bagian dari contoh
skema:
SELECT *
FROM Users
WHERE Name IN ('Alex','Amal')
ORDER BY LastLogin DESC
LIMIT 10;
Karena Name cocok dengan beberapa nilai, baris yang cocok tidak disimpan dalam satu rentang yang diurutkan secara global oleh LastLogin DESC. Anda dapat merestrukturisasi kueri
menggunakan UNNEST dan gabungan sehingga Spanner mengambil baris teratas untuk
setiap nilai Name secara terpisah, lalu menggabungkannya:
SELECT *
FROM UNNEST(['Alex','Amal']) AS Name
JOIN Users AS u ON u.Name = Name
ORDER BY LastLogin DESC
LIMIT 10;
Penulisan ulang ini menghasilkan pemindaian yang lebih efisien dengan membaca jumlah minimum baris dari setiap kunci awalan terikat ('Alex' dan 'Amal'), diikuti dengan pengurutan kecil pada hasil gabungan untuk menghasilkan LIMIT akhir.
Kasus khusus yang umum dari pola ini adalah awalan shard, di mana kolom ShardId
ditambahkan sebagai kolom kunci utama untuk mendistribusikan penulisan di seluruh pemisahan.
Misalnya, kueri berikut memindai 32 shard (0 hingga 31):
SELECT *
FROM Users
WHERE ShardId BETWEEN 0 AND 31
ORDER BY LastLogin DESC
LIMIT 10;
Untuk mengoptimalkan kueri ini, hitung ID shard secara eksplisit (0 hingga 31)
dan gabungkan dengan tabel Users menggunakan GENERATE_ARRAY di
GoogleSQL atau generate_series di PostgreSQL:
GoogleSQL
SELECT *
FROM GENERATE_ARRAY(0, 31) AS id
JOIN Users AS u ON u.ShardId = id
ORDER BY LastLogin DESC
LIMIT 10;
PostgreSQL
SELECT *
FROM generate_series(0, 31) AS id
JOIN Users AS u ON u.ShardId = id
ORDER BY LastLogin DESC
LIMIT 10;
Untuk mengetahui informasi selengkapnya tentang fungsi pembuatan array dan deret ini, lihat
GENERATE_ARRAY untuk GoogleSQL dan
generate_series untuk PostgreSQL.
Memahami performa pemindaian
Bagian berikut menjelaskan penyebab paling umum dari pemindaian tabel atau indeks yang lambat dan cara mengatasinya.
Baris yang dihapus
Secara default, Spanner mempertahankan baris yang dihapus atau ditimpa selama satu jam untuk mendukung pembacaan historis dan pemulihan point-in-time, dan Anda dapat meningkatkan periode retensi ini hingga tujuh hari. Setelah versi baris lama melewati periode retensi, versi tersebut akan memenuhi syarat untuk dihapus selama pemadatan penyimpanan latar belakang, yang dapat memerlukan waktu hingga tujuh hari lagi. Hingga versi baris lama dipadatkan, kueri yang memindai rentang kunci mungkin harus membaca versi baris yang dihapus atau ditimpa dan memfilternya. Untuk informasi selengkapnya tentang retensi data, lihat Pemulihan point-in-time (PITR).
Anda dapat memeriksa apakah kueri memindai baris yang dihapus dengan memeriksa metrik Deleted rows scanned di tampilan detail operator Scan di panel detail visualizer rencana kueri.
Untuk mengurangi pemindaian lambat yang disebabkan oleh sejumlah besar baris yang baru saja dihapus, Anda dapat memicu pemadatan data manual. Untuk mengetahui informasi selengkapnya, lihat Pemadatan data manual.
Baris besar
Untuk baris kecil (hingga beberapa ratus byte), biaya pemindaian terutama bergantung pada jumlah baris yang dipindai. Seiring bertambahnya ukuran baris, ukuran byte baris menjadi lebih signifikan. Dalam penyimpanan berorientasi baris, total ukuran baris memengaruhi performa pemindaian, bukan hanya ukuran kolom yang diproyeksikan oleh kueri.
Untuk kueri analisis yang memerlukan banyak pemindaian pada tabel besar, pertimbangkan untuk menggunakan columnar engine. Untuk mengetahui informasi selengkapnya, lihat Memantau columnar engine.
Untuk kueri pada set baris yang lebih sempit, jika tabel memiliki kolom besar dan kolom yang lebih kecil yang sering dikueri, pertimbangkan opsi berikut:
- Pisahkan kolom yang lebih besar ke dalam grup lokalitas non-default (yang menyimpan kolom yang ditentukan secara terpisah di disk dari bagian tabel lainnya) atau tabel turunan terpisah sehingga pemindaian kolom yang lebih kecil tidak membaca data kolom yang besar. Untuk mengetahui informasi selengkapnya, lihat Membuat dan mengelola grup lokalitas.
- Untuk pengoptimalan waktu baca tambahan, duplikasi kolom yang lebih kecil ke dalam indeks sekunder dengan kunci utama yang sama dengan tabel dasar, menggunakan klausa
STORINGuntuk menyertakan kolom yang lebih kecil.
Misalnya, tabel Documents (bukan bagian dari skema contoh sebelumnya) menyimpan string Metadata kecil bersama dengan objek JSON Content yang besar. Anda dapat membuat indeks sekunder yang hanya menyimpan Metadata sehingga kueri yang tidak memerlukan Content dapat memindai indeks yang lebih kecil, bukan tabel dasar:
CREATE TABLE Documents (
  Id INT64,
  Metadata STRING(MAX),
  Content JSON
) PRIMARY KEY (Id);

CREATE INDEX DocumentMetadata ON Documents(Id) STORING (Metadata);
Data berselang-seling yang besar
Saat tabel di-interleave, Spanner secara fisik menyimpan setiap baris induk bersama dengan baris turunan yang di-interleave dalam urutan kunci. Jika tabel induk memiliki banyak baris turunan yang disisipkan, atau tabel turunan memiliki baris yang jauh lebih sedikit daripada tabel induk atau saudaranya, pemindaian rentang pada tabel yang lebih kecil akan lebih jarang dan kurang efisien karena pemindaian harus melewati baris yang disisipkan dari tabel lain.
Misalnya, perhatikan skema berikut (bukan bagian dari contoh skema sebelumnya), dengan Transaction dan AuthorizedPerson disisipkan di Account:
CREATE TABLE Account (
  AccountId INT64,
  -- Additional columns omitted
) PRIMARY KEY (AccountId);

CREATE TABLE Transaction (
  AccountId INT64,
  TransactionId STRING(MAX),
  -- Additional columns omitted
) PRIMARY KEY (AccountId, TransactionId),
INTERLEAVE IN PARENT Account;

CREATE TABLE AuthorizedPerson (
  AccountId INT64,
  SignerId INT64,
  Name STRING(MAX),
  -- Additional columns omitted
) PRIMARY KEY (AccountId, SignerId),
INTERLEAVE IN PARENT Account;
Jika setiap baris Account memiliki ribuan baris Transaction dan hanya beberapa
baris AuthorizedPerson, pemindaian rentang pada Account atau AuthorizedPerson memiliki
biaya per baris yang lebih tinggi daripada pemindaian rentang pada Transaction (meskipun total
biayanya masih lebih rendah). Hal ini terjadi karena pemindaian Transaction membaca banyak baris Transaction yang berdekatan sekaligus, sedangkan pemindaian pada Account atau AuthorizedPerson memiliki lebih sedikit baris yang berdekatan dari tabel yang sama dan harus melewati baris Transaction yang disisipkan.
Untuk mengoptimalkan pemindaian rentang pada tabel yang lebih jarang (Account atau AuthorizedPerson), buat indeks sekunder yang tidak di-interleave yang menduplikasi kolom yang diperlukan oleh kueri Anda, mirip dengan pendekatan untuk baris besar:
CREATE INDEX AuthorizedPersonByAccount
  ON AuthorizedPerson(AccountId, SignerId)
  STORING (Name);
Menggunakan eksekusi berorientasi batch
Spanner dapat menjalankan pemindaian kueri dan operator kueri menggunakan metode berorientasi baris (memproses satu baris dalam satu waktu) atau metode berorientasi batch (memproses blok baris dalam satu waktu). Bagian berikut menjelaskan cara memeriksa dan mengonfigurasi pemindaian berorientasi batch dan eksekusi operator berorientasi batch.
Pemindaian berorientasi batch
Kueri Spanner tertentu mungkin akan lebih efektif jika menggunakan metode pemrosesan berorientasi batch saat memindai data, bukan metode pemrosesan berorientasi baris yang lebih umum. Memproses pemindaian dalam batch adalah cara yang lebih efisien untuk memproses data dalam jumlah besar sekaligus, dan memungkinkan kueri mencapai pemakaian CPU dan latensi yang lebih rendah.
Operasi pemindaian Spanner selalu memulai eksekusi dalam metode berorientasi baris. Selama waktu ini, Spanner mengumpulkan beberapa metrik runtime. Kemudian, Spanner menerapkan serangkaian heuristik berdasarkan hasil metrik ini untuk menentukan metode pemindaian yang optimal. Jika sesuai, Spanner akan beralih ke metode pemrosesan berorientasi batch untuk membantu meningkatkan throughput dan performa pemindaian.
Kasus penggunaan umum
Kueri dengan karakteristik berikut umumnya mendapatkan manfaat dari pemrosesan berorientasi batch:
- Pemindaian besar pada data yang jarang diperbarui
- Pemindaian dengan predikat pada kolom lebar tetap
- Pemindaian dengan jumlah pencarian yang besar (pencarian menggunakan indeks untuk mengambil kumpulan data)
Kasus penggunaan tanpa peningkatan performa
Tidak semua kueri mendapatkan manfaat dari pemrosesan berorientasi batch. Jenis kueri berikut berperforma lebih baik dengan pemrosesan pemindaian berorientasi baris:
- Kueri pencarian titik: kueri yang hanya mengambil satu baris.
- Kueri pemindaian kecil: pemindaian tabel yang hanya memindai beberapa baris, kecuali jika memiliki jumlah pencarian yang besar.
- Kueri dengan klausa
LIMIT: kueri yang berhenti memindai setelah menampilkan jumlah baris tetap. - Kueri yang membaca data churn tinggi: kueri yang lebih dari sekitar 10% data yang dibaca sering diperbarui.
- Kueri dengan baris yang berisi nilai besar: kueri pada baris yang berisi nilai lebih besar dari 32.000 byte (prakompresi) dalam satu kolom.
Memeriksa metode pemindaian yang digunakan oleh kueri
Untuk memeriksa apakah kueri Anda menggunakan pemrosesan berorientasi batch, pemrosesan berorientasi baris, atau beralih secara otomatis di antara kedua metode pemindaian, ikuti langkah-langkah berikut:
Di konsol Google Cloud , buka halaman Instances Spanner.
Klik nama instance dengan kueri yang ingin Anda selidiki.
Di tabel Databases, klik database dengan kueri yang ingin Anda selidiki.
Di menu navigasi Spanner, klik Spanner Studio.
Klik New SQL editor tab atau New tab.
Di editor kueri, masukkan kueri Anda.
Klik Run.
Spanner menjalankan kueri dan menampilkan hasilnya.
Di panel editor kueri, klik tab Explanation.
Spanner akan menampilkan visualizer rencana eksekusi kueri. Setiap kartu pada grafik mewakili iterator. Untuk mengetahui informasi selengkapnya tentang rencana eksekusi, lihat Rencana eksekusi kueri.
Klik kartu iterator Table scan untuk membuka panel informasi.
Panel informasi menampilkan informasi kontekstual tentang pemindaian yang dipilih, termasuk metode pemindaian (Method). Automatic menunjukkan bahwa Spanner menentukan metode pemindaian. Nilai lain yang mungkin mencakup Batch untuk pemrosesan berorientasi batch dan Row untuk pemrosesan berorientasi baris, seperti yang ditunjukkan pada gambar berikut:

Menerapkan metode pemindaian yang digunakan oleh kueri
Untuk mengoptimalkan performa kueri, Spanner memilih metode pemindaian yang optimal untuk kueri Anda. Google merekomendasikan agar Anda menggunakan metode pemindaian default ini. Namun, mungkin ada skenario saat Anda ingin menerapkan jenis metode pemindaian tertentu.
Menerapkan pemindaian berorientasi batch
Anda dapat menerapkan pemindaian berorientasi batch di tingkat tabel dan tingkat pernyataan.
Untuk menerapkan metode pemindaian berorientasi batch di tingkat tabel, gunakan petunjuk tabel dalam kueri Anda:
GoogleSQL
SELECT *
FROM (Singers@{SCAN_METHOD=BATCH} AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
PostgreSQL
SELECT *
FROM (Singers/*@ scan_method=batch */ AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
Untuk menerapkan metode pemindaian berorientasi batch di tingkat pernyataan, gunakan petunjuk pernyataan dalam kueri Anda:
GoogleSQL
@{SCAN_METHOD=BATCH}
SELECT *
FROM Singers;
PostgreSQL
/*@ scan_method=batch */
SELECT *
FROM Singers;
Saat Anda menggunakan petunjuk tingkat pernyataan, petunjuk tersebut akan berlaku untuk seluruh kueri. Menetapkan petunjuk di tingkat tabel lebih disarankan dan memberikan kontrol yang lebih terperinci.
Paksa pemindaian berorientasi baris
Meskipun Google tidak merekomendasikan untuk menonaktifkan metode pemindaian otomatis yang ditetapkan oleh Spanner, Anda dapat menonaktifkannya dan menggunakan metode pemindaian berorientasi baris untuk tujuan pemecahan masalah, seperti mendiagnosis latensi.
Untuk menonaktifkan pemilihan metode pemindaian otomatis dan menerapkan pemrosesan baris di tingkat tabel, gunakan petunjuk tabel dalam kueri Anda:
GoogleSQL
SELECT *
FROM (Singers@{SCAN_METHOD=ROW} AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
PostgreSQL
SELECT *
FROM (Singers/*@ scan_method=row */ AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
Untuk menonaktifkan metode pemindaian otomatis dan menerapkan pemrosesan baris di tingkat pernyataan, gunakan petunjuk pernyataan dalam kueri Anda:
GoogleSQL
@{SCAN_METHOD=ROW}
SELECT *
FROM Singers;
PostgreSQL
/*@ scan_method=row */
SELECT *
FROM Singers;
Metode eksekusi
Selain pemindaian berorientasi batch, Anda juga dapat mengoptimalkan eksekusi kueri dengan menerapkan metode eksekusi di tingkat pernyataan. Hal ini hanya berfungsi untuk beberapa operator, dan tidak bergantung pada metode pemindaian, yang hanya digunakan oleh operator pemindaian. Untuk mengetahui informasi selengkapnya tentang pemindaian berorientasi batch, lihat bagian Pemindaian berorientasi batch dalam dokumen ini.
Secara default, sebagian besar operator dijalankan dalam metode berorientasi baris, yang memproses data satu baris dalam satu waktu. Operator vektor dieksekusi dalam metode berorientasi batch untuk membantu meningkatkan throughput dan performa eksekusi. Operator ini memproses data satu blok per satu waktu. Saat operator perlu memproses banyak baris, metode eksekusi berorientasi batch biasanya lebih efisien.
Metode eksekusi versus metode pemindaian
Metode eksekusi kueri tidak bergantung pada metode pemindaian kueri. Anda dapat menetapkan salah satu, keduanya, atau tidak satu pun dari metode ini dalam petunjuk kueri.
Metode eksekusi kueri mengacu pada cara operator kueri memproses hasil perantara dan cara operator berinteraksi satu sama lain, sedangkan metode pemindaian mengacu pada cara operator pemindaian berinteraksi dengan lapisan penyimpanan Spanner.
Menerapkan metode eksekusi yang digunakan oleh kueri
Untuk mengoptimalkan performa kueri, Spanner memilih metode eksekusi yang optimal untuk kueri Anda berdasarkan berbagai heuristik. Google merekomendasikan agar Anda menggunakan metode eksekusi default ini. Namun, mungkin ada skenario saat Anda ingin menerapkan jenis metode eksekusi tertentu.
Anda dapat menerapkan metode eksekusi di tingkat pernyataan. Petunjuk kueri EXECUTION_METHOD bersifat saran, bukan perintah. Pada akhirnya, pengoptimal kueri akan memutuskan metode yang akan digunakan untuk setiap operator.
Untuk menerapkan metode eksekusi berorientasi batch di tingkat pernyataan, gunakan petunjuk pernyataan dalam kueri Anda:
GoogleSQL
@{EXECUTION_METHOD=BATCH}
SELECT *
FROM Singers;
PostgreSQL
/*@ EXECUTION_METHOD=BATCH */
SELECT *
FROM Singers;
Meskipun Google tidak merekomendasikan untuk menonaktifkan metode eksekusi otomatis yang ditetapkan oleh Spanner, Anda dapat menonaktifkannya dan menggunakan metode eksekusi berorientasi baris untuk tujuan pemecahan masalah, seperti mendiagnosis latensi.
Untuk menonaktifkan metode eksekusi otomatis dan menerapkan metode eksekusi berorientasi baris di tingkat pernyataan, gunakan petunjuk pernyataan dalam kueri Anda:
GoogleSQL
@{EXECUTION_METHOD=ROW}
SELECT *
FROM Singers;
PostgreSQL
/*@ EXECUTION_METHOD=ROW */
SELECT *
FROM Singers;
Memeriksa metode eksekusi yang diaktifkan
Tidak semua operator Spanner mendukung metode eksekusi berorientasi batch dan berorientasi baris. Untuk setiap operator, visualizer rencana eksekusi kueri menampilkan metode eksekusi di kartu iterator. Jika metode eksekusi berorientasi batch, metode ini akan menampilkan Batch. Jika berorientasi baris, tabel akan menampilkan Row. Untuk mengetahui informasi selengkapnya tentang visualizer, lihat Paket eksekusi kueri.
Jika operator dalam kueri Anda dieksekusi menggunakan metode eksekusi yang berbeda, adaptor metode eksekusi DataBlockToRowAdapter dan RowToDataBlockAdapter akan muncul di antara operator untuk menunjukkan perubahan dalam metode eksekusi. Untuk mengetahui informasi
selengkapnya tentang operator ini, lihat
DataBlockToRowAdapter dan
RowToDataBlockAdapter.