


Questa pagina descrive le tecniche per ottimizzare le prestazioni delle query Spanner. Prima di iniziare l'ottimizzazione delle query, consulta le seguenti pagine, che spiegano i concetti e gli strumenti fondamentali utilizzati nell'ottimizzazione delle query:
- Best practice di SQL
- Panoramica del visualizzatore del piano di query
- Statistiche sulle query
- Operatori di esecuzione delle query
Le query e i piani di esecuzione in questa pagina si basano sul seguente schema di database:
CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo BYTES(MAX),
  BirthDate  DATE
) PRIMARY KEY(SingerId);

CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);

CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);

CREATE TABLE Songs (
  SingerId  INT64 NOT NULL,
  AlbumId   INT64 NOT NULL,
  TrackId   INT64 NOT NULL,
  SongName  STRING(MAX),
  Duration  INT64,
  SongGenre STRING(25)
) PRIMARY KEY(SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC), INTERLEAVE IN Albums;

CREATE INDEX SongsBySongName ON Songs(SongName);

CREATE TABLE Concerts (
  VenueId      INT64 NOT NULL,
  SingerId     INT64 NOT NULL,
  ConcertDate  DATE NOT NULL,
  BeginTime    TIMESTAMP,
  EndTime      TIMESTAMP,
  TicketPrices ARRAY<INT64>
) PRIMARY KEY(VenueId, SingerId, ConcertDate);
Puoi utilizzare le seguenti istruzioni DML (Data Manipulation Language) per aggiungere dati a queste tabelle:
INSERT INTO Singers (SingerId, FirstName, LastName, BirthDate)
VALUES (1, "Marc", "Richards", "1970-09-03"),
       (2, "Catalina", "Smith", "1990-08-17"),
       (3, "Alice", "Trentor", "1991-10-02"),
       (4, "Lea", "Martin", "1991-11-09"),
       (5, "David", "Lomond", "1977-01-29");

INSERT INTO Albums (SingerId, AlbumId, AlbumTitle)
VALUES (1, 1, "Total Junk"),
       (1, 2, "Go, Go, Go"),
       (2, 1, "Green"),
       (2, 2, "Forever Hold Your Peace"),
       (2, 3, "Terrified"),
       (3, 1, "Nothing To Do With Me"),
       (4, 1, "Play");

INSERT INTO Songs (SingerId, AlbumId, TrackId, SongName, Duration, SongGenre)
VALUES (2, 1, 1, "Let's Get Back Together", 182, "COUNTRY"),
       (2, 1, 2, "Starting Again", 156, "ROCK"),
       (2, 1, 3, "I Knew You Were Magic", 294, "BLUES"),
       (2, 1, 4, "42", 185, "CLASSICAL"),
       (2, 1, 5, "Blue", 238, "BLUES"),
       (2, 1, 6, "Nothing Is The Same", 303, "BLUES"),
       (2, 1, 7, "The Second Time", 255, "ROCK"),
       (2, 3, 1, "Fight Story", 194, "ROCK"),
       (3, 1, 1, "Not About The Guitar", 278, "BLUES");
Suggerimenti per i benchmark
Le statistiche sulle prestazioni più affidabili provengono dall'esecuzione di un test di carico che utilizza valori dei parametri di query diversi e randomizzati da un'istanza di macchina virtuale (VM) Google Cloud che si trova nella stessa regione dell'istanza di destinazione.
Evita di fare affidamento su Spanner Studio o sulla modalità QueryMode.PROFILE per eseguire il benchmark delle query, perché questi strumenti non replicano gli ambienti di rete e client di produzione effettivi. Tuttavia, dopo che un test di carico ha identificato un problema di prestazioni, i piani di query (campionati in Query Insights o eseguiti on demand in Spanner Studio) sono strumenti utili per analizzare il problema specifico.
Informazioni sui piani di esecuzione delle query
Nel visualizzatore del piano di query, un piano di esecuzione delle query viene visualizzato come un albero di operatori, in cui ogni operatore legge le righe dai propri operatori figlio, le elabora e passa i risultati all'operatore padre.
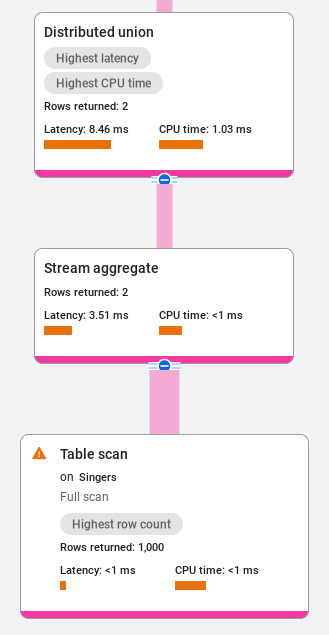
Per la maggior parte degli operatori nel piano visivo, la latenza registrata è additiva (riflette solo il tempo trascorso in quell'operatore). Tuttavia, per gli operatori Distributed union e Distributed apply, la latenza indicata è cumulativa: include sia il tempo trascorso nell'operatore distribuito stesso sia il tempo trascorso nei suoi operatori secondari. Per saperne di più su questi operatori, consulta Distributed union e Distributed apply.
Ad esempio, nel seguente piano di unione distribuita, la scheda Distributed union
riporta una latenza totale di 8,46 ms, mentre l'operatore figlio Stream aggregate
riporta 3,51 ms e Table scan riporta 1 ms. Poiché la
latenza di Distributed union è cumulativa, l'operatore Distributed union
stesso aggiunge solo circa 5 ms di latenza, anziché 8 ms:
Nell'esempio successivo, la scheda Distributed union segnala 13,69 ms di latenza, mentre i suoi operatori secondari (Stream aggregate a <1 ms, Cross apply a 1,14 ms, Table scan su Albums a <1 ms, Filter scan a 1 ms e Table scan su Singers a 10,85 ms) rappresentano circa 13 ms. Di conseguenza, l'operatore Distributed union stesso aggiunge meno di 1 ms di latenza, anziché 13 ms:

Puoi anche visualizzare i valori di latenza cumulativa nel riquadro di riepilogo dell'operatore.
Combina più indici
Quando una query filtra su più colonne indicizzate utilizzando condizioni OR o AND,
Spanner a volte può combinare più indici secondari per evitare
di scansionare l'intera tabella di base. Gli esempi in questa sezione estendono la tabella Albums dello schema di esempio precedente aggiungendo una colonna ReleaseDate e un indice secondario AlbumsByReleaseDate:
CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  ReleaseDate     DATE,
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByReleaseDate ON Albums(ReleaseDate);
Considera la seguente query, che utilizza una condizione OR per filtrare in base ai predicati di due indici secondari separati (AlbumsByAlbumTitle e AlbumsByReleaseDate):
SELECT a.AlbumId, a.AlbumTitle, a.ReleaseDate
FROM Albums AS a
WHERE a.AlbumTitle = 'Play' OR a.ReleaseDate = '2023-09-07';
Quando una query ha una condizione OR sui predicati di due indici separati,
Spanner potrebbe utilizzare l'ottimizzazione basata sui costi per leggere entrambi gli indici
e combinare i risultati (un'unione di indici). Puoi anche forzare questa ottimizzazione aggiungendo il suggerimento per la tabella INDEX_STRATEGY=FORCE_INDEX_UNION alla query:
SELECT a.AlbumId, a.AlbumTitle, a.ReleaseDate
FROM Albums@{INDEX_STRATEGY=FORCE_INDEX_UNION} AS a
WHERE a.AlbumTitle = 'Play' OR a.ReleaseDate = '2023-09-07';
Per saperne di più sui suggerimenti per le tabelle, consulta Suggerimenti per le tabelle.
Il seguente diagramma del piano di esecuzione mostra come Spanner valuta questa condizione OR (disgiunzione) scansionando ogni ramo separatamente e combinando i risultati utilizzando gli operatori Union all e Hash aggregate:

Ora, prendi in considerazione una query che utilizza una condizione AND per filtrare in base a entrambe le colonne indicizzate:
SELECT a.AlbumId, a.ReleaseDate, a.AlbumTitle
FROM Albums AS a
WHERE a.AlbumTitle = 'Aardvark' AND a.ReleaseDate = '2023-09-07';
Con una condizione AND, Spanner sceglie un singolo indice per impostazione predefinita e poi si unisce alla tabella di base, se necessario, per valutare la condizione rimanente nella clausola AND. Per determinare se questo back-join della tabella di base è un collo di bottiglia per le prestazioni, esamina il piano di esecuzione della query nel visualizzatore: se l'operatore Index scan restituisce molte righe che vengono successivamente filtrate dopo l'unione con l'operatore Table scan sulla tabella di base (con conseguente latenza o tempo di CPU elevati sul ramo Table scan rispetto al numero finale di righe restituite), il back-join è un collo di bottiglia.
Se il back-join della tabella di base è il collo di bottiglia della query, la soluzione consigliata è aggiungere la colonna aggiuntiva nella condizione AND alla clausola STORING dell'indice secondario in modo che Spanner possa valutare entrambe le condizioni direttamente dall'indice senza leggere la tabella di base:
CREATE INDEX AlbumsByAlbumTitleStoringReleaseDate
  ON Albums(AlbumTitle)
  STORING (ReleaseDate);
Se la modifica dell'indice non è fattibile, un'alternativa è riscrivere la query per eseguire un'intersezione di entrambi gli indici utilizzando INTERSECT DISTINCT, quindi unire le chiavi primarie corrispondenti alla tabella di base Albums:
SELECT union_a.AlbumId, a.ReleaseDate, a.AlbumTitle FROM
  (SELECT a1.SingerId, a1.AlbumId
  FROM Albums @{force_index=AlbumsByReleaseDate} AS a1
  WHERE a1.ReleaseDate = '2023-09-07'
  INTERSECT DISTINCT
  SELECT a2.SingerId, a2.AlbumId
  FROM Albums @{force_index=AlbumsByAlbumTitle} AS a2
  WHERE a2.AlbumTitle = 'Aardvark') AS union_a
JOIN Albums AS a
  ON a.SingerId = union_a.SingerId AND a.AlbumId = union_a.AlbumId;
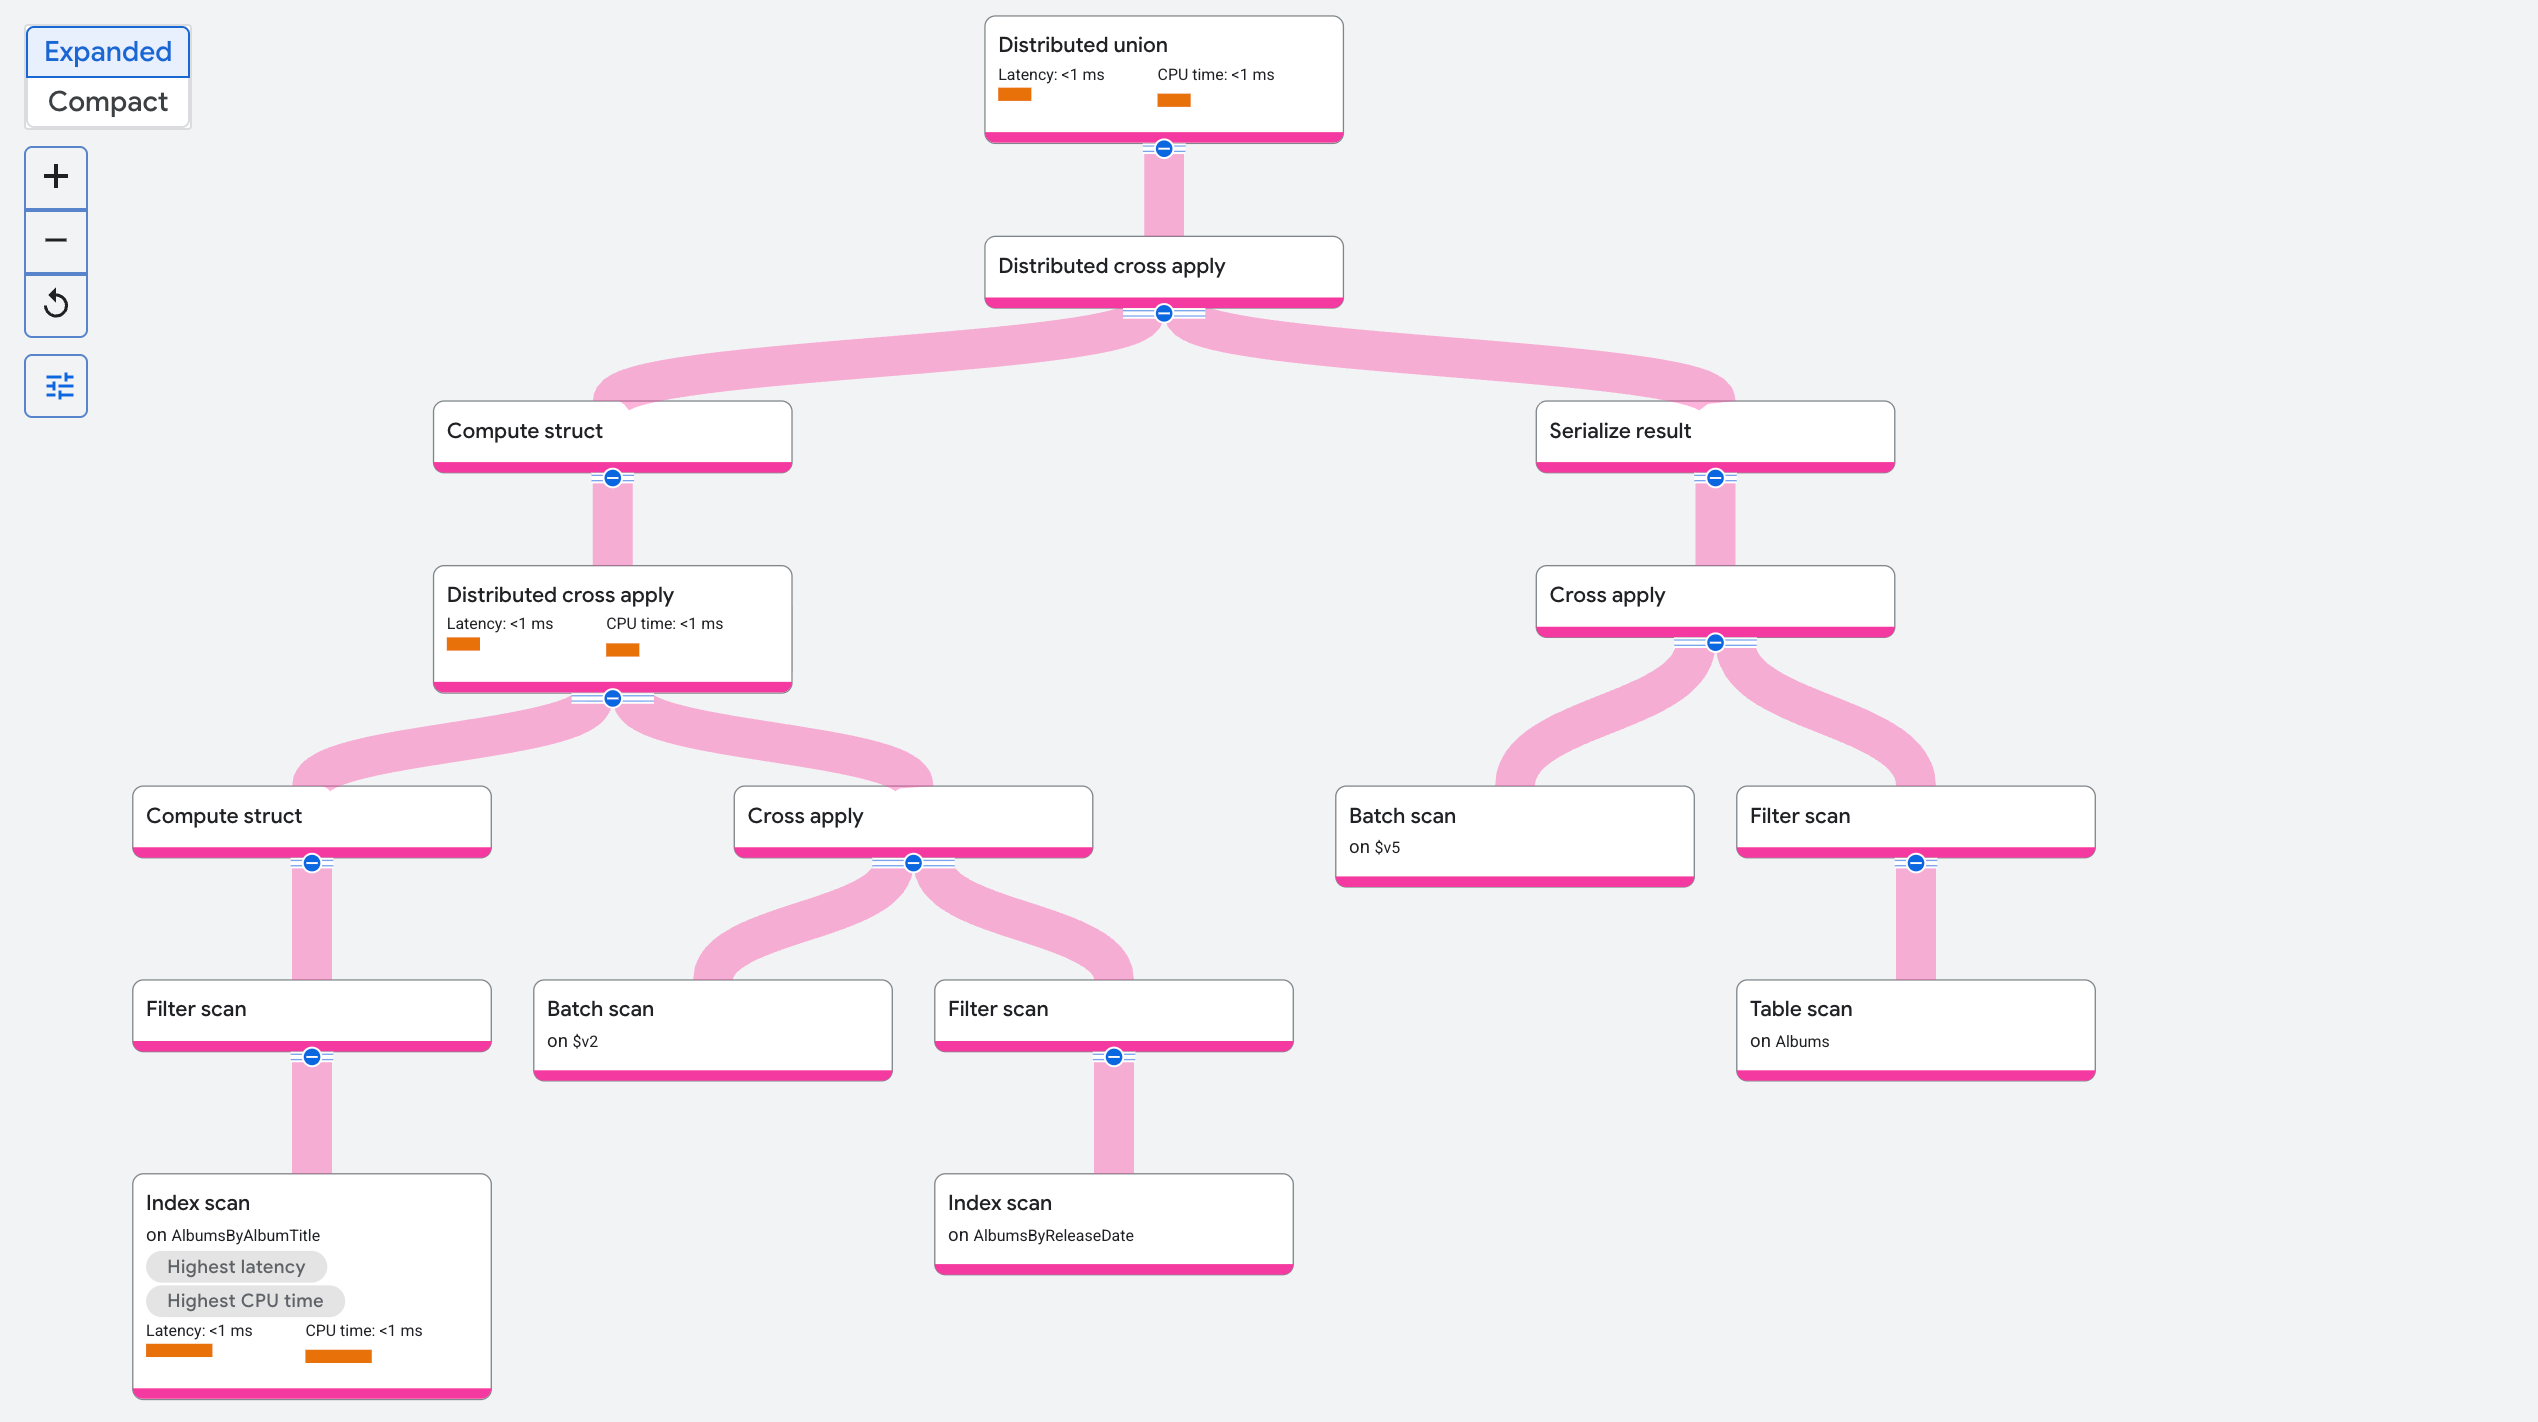
Il seguente diagramma del piano di esecuzione mostra la query riscritta. Nota come il piano utilizza due operatori Index scan (on AlbumsByAlbumTitle e on AlbumsByReleaseDate) per trovare le chiavi di intersezione prima di eseguire Table scan sulla tabella di base Albums:
Se il filtro su più colonne è un pattern frequente nel tuo workload, valuta la possibilità di utilizzare la ricerca a testo intero su più colonne anziché gli indici secondari. Per saperne di più, consulta Esegui una ricerca su più colonne.
Ottimizza i join
Quando Spanner esegue una query che unisce più tabelle, Query Optimizer sceglie sia l'ordine di join (la sequenza in cui vengono unite le tabelle) sia il metodo di join (l'algoritmo utilizzato per combinare le righe di due input, ad esempio un join di applicazione, un join hash o un join di unione). Se una query con un join è più lenta del previsto, puoi utilizzare un suggerimento per la query per indicare a Spanner di utilizzare un ordine o un metodo di join diverso. In questo modo, il piano di esecuzione cambia, ma i risultati restituiti rimangono invariati. Ad esempio:
GoogleSQL
Forza l'ordine di join:
SELECT *
FROM Singers AS s JOIN@{FORCE_JOIN_ORDER=TRUE} Albums AS a
ON s.SingerId = a.SingerId
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
Modifica il metodo di partecipazione:
SELECT *
FROM Singers AS s JOIN@{JOIN_METHOD=HASH_JOIN} Albums AS a
ON s.SingerId = a.SingerId;
PostgreSQL
Forza l'ordine di join:
SELECT *
FROM Singers AS s JOIN/*@ FORCE_JOIN_ORDER=TRUE */ Albums AS a
ON s.SingerId = a.SingerId
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
Modifica il metodo di partecipazione:
SELECT *
FROM Singers AS s JOIN/*@ JOIN_METHOD=HASH_JOIN */ Albums AS a
ON s.SingerId = a.SingerId;
Le sezioni seguenti forniscono informazioni di base che possono aiutarti a determinare quali ordini e metodi di join possono contribuire a migliorare le prestazioni delle query.
Metodo di iscrizione e scansioni
Spanner supporta diversi metodi di join e la scelta del metodo di join influisce direttamente sul modo in cui Spanner analizza le tabelle o gli indici sottostanti:
- Apply join (noto in alcuni sistemi come lookup join o nested loop join): esegue il lato destro ("mappa") una volta per ogni riga del lato sinistro ("input"). Poiché ogni ricerca a destra utilizza i valori della riga a sinistra corrente, le colonne di join a sinistra possono essere utilizzate come chiave di ricerca a destra. Un join di applicazione distribuito funziona in modo simile a un join di applicazione locale, ma raggruppa le righe per una comunicazione più efficiente tra le suddivisioni in un join distribuito.
- Hash join: legge le righe da un input per creare una tabella hash in memoria sulle chiavi di join, quindi esegue la scansione dell'altro input per verificare la presenza di corrispondenze nella tabella hash.
- Merge join: legge entrambi gli input in ordine di ordinamento in base alle chiavi di join e unisce le righe corrispondenti in un unico passaggio.
Ad esempio, considera la seguente query che unisce Singers e Albums:
SELECT s.*, a.AlbumTitle
FROM Singers AS s
JOIN Albums AS a ON s.SingerId = a.SingerId
WHERE s.SingerId = 2 AND a.AlbumId = 1;
Con un apply join, s.SingerId = a.SingerId agisce come condizione di ricerca sul lato destro del join, quindi la query deve leggere solo una riga dalla tabella Albums.
Al contrario, in un hash join o in un merge join, gli input sinistro e destro vengono letti indipendentemente l'uno dall'altro, quindi la condizione di join non fornisce una chiave di ricerca da un lato all'altro. Nel peggiore dei casi, un hash join o un merge join esegue una scansione completa della tabella di ogni input.
Nelle query interattive e transazionali, la maggior parte dei join utilizza gli indici, quindi l'applicazione distribuita è il tipo di join più comune in Spanner. Tuttavia, a volte un join hash o di unione è una scelta migliore perché la lettura di un intervallo contiguo di righe è significativamente più veloce rispetto all'esecuzione dello stesso numero di ricerche sparse su una singola riga. Il compromesso è se è più veloce cercare meno righe (utilizzando un join di applicazione) o scansionare un intervallo contiguo più ampio di righe (utilizzando un join hash o di unione). Per ulteriori informazioni su questo compromesso, consulta Letture sequenziali e ricerche sparse.
Per le query che leggono migliaia di righe, se è disponibile un indice sulla chiave di join, di solito è più sicuro utilizzare un join di applicazione distribuito. Questo perché il costo di un join di applicazione è proporzionale al numero di righe unite, mentre con un join hash o di unione, il costo può essere proporzionale alla dimensione totale della tabella. Per query più grandi (ad esempio query che elaborano milioni di righe), l'utilizzo di un hash o di un merge join potrebbe offrire un miglioramento significativo delle prestazioni.
Per saperne di più sugli operatori e sui suggerimenti di join, consulta le seguenti risorse:
Ordinamento dei join
Come in altri sistemi di gestione di database relazionali (RDBMS), ordina i join per mantenere le dimensioni dei risultati intermedi il più ridotte possibile. Ciò significa filtrare i dati il prima possibile e rimandare il più possibile le corrispondenze di grandi dimensioni.
Se fornisci il suggerimento FORCE_JOIN_ORDER=TRUE, Spanner esegue i join nell'ordine esatto in cui vengono visualizzati nel testo della query. Sposta i join con filtri molto selettivi all'inizio della query e i join con corrispondenze di grandi dimensioni alla fine della query.
Ottimizza le aggregazioni
Le seguenti tecniche possono aiutarti a ridurre il numero di righe scansionate e ordinate durante le query di aggregazione.
Recupera una riga per prefisso della chiave
Un pattern di aggregazione comune consiste nel recuperare una riga per prefisso di chiave (ad esempio, la riga con il numero di versione o il timestamp più alto). In GoogleSQL, il modo più efficiente per farlo è utilizzare ANY_VALUE con HAVING MAX, che trova la riga con il valore massimo e restituisce la colonna richiesta in un unico passaggio di aggregazione senza richiedere un self-join o un ordinamento completo. Ad esempio, la seguente query raggruppa la tabella Concerts in base a ConcertDate e restituisce il BeginTime del concerto con l'ultima EndTime per ogni data:
SELECT ConcertDate, ANY_VALUE(BeginTime HAVING MAX(EndTime))
FROM Concerts
GROUP BY ConcertDate;
Controlla l'esistenza della riga
Per verificare se una tabella contiene righe o righe che corrispondono a una condizione specifica, utilizza LIMIT anziché COUNT. Ad esempio:
SELECT 1 FROM Albums LIMIT 1;
Aumenta il parallelismo
Spanner divide le tabelle e gli indici in intervalli di chiavi primarie contigui chiamati suddivisioni, che possono essere elaborati in parallelo su più server. In genere, Spanner sceglie il parallelismo delle query per bilanciare latenza ed efficienza. Ad esempio, se una query ha una clausola LIMIT, potrebbe utilizzare un parallelismo inferiore per evitare di sprecare lavoro che il limite elimina. Il numero di suddivisioni analizzate dalla query limita il grado massimo di parallelismo.
Per le query con limiti o scansioni di grandi dimensioni, puoi impostare l'hint dell'istruzione USE_ADDITIONAL_PARALLELISM=TRUE per indicare a Spanner di ottimizzare principalmente per la latenza:
GoogleSQL
@{USE_ADDITIONAL_PARALLELISM=TRUE}
SELECT *
FROM Singers
LIMIT 10;
PostgreSQL
/*@ USE_ADDITIONAL_PARALLELISM=TRUE */
SELECT *
FROM Singers
LIMIT 10;
Questo suggerimento potrebbe saturare la CPU su una determinata suddivisione. Se la query è di lunga durata, inviala con priorità di richiesta media per evitare di aumentare la latenza per altre query con priorità alta.
Limiti di Optimize
Se una query contiene una clausola LIMIT, ma analizza molte più righe rispetto al valore limite, controlla le seguenti potenziali cause:
Indice mancante
Se una query ha un filtro che non può essere soddisfatto utilizzando un indice, il piano di query analizza la tabella di base o un indice che non fornisce l'ordinamento richiesto. La query ordina quindi completamente i dati corrispondenti prima di valutare la clausola LIMIT.
Per risolvere il problema, valuta la possibilità di aggiungere un indice secondario che copra le colonne di filtro. Se l'indice è definito come NULL_FILTERED (ovvero esclude le righe in cui una colonna indicizzata è NULL), assicurati che il predicato della query includa IS NOT NULL in modo che l'ottimizzatore possa utilizzare l'indice. Per saperne di più sulla creazione di indici secondari, consulta Indici secondari.
Ordinamento completo
Se esiste un indice nella colonna filtrata, ma l'indice non fornisce l'ordinamento richiesto dalla clausola ORDER BY, Spanner deve leggere tutte le righe corrispondenti e passarle a un operatore Sort nel piano di esecuzione della query prima di applicare LIMIT.
Per evitare un ordinamento completo, specifica le colonne nell'istruzione CREATE INDEX nel seguente ordine:
- Innanzitutto, tutte le colonne che hanno una condizione di uguaglianza (
=) oINnella query - Poi, le stesse colonne della clausola
ORDER BYdella query, nello stesso ordine e con la stessa direzione di ordinamento (ASCoDESC)
Ad esempio, supponiamo di avere una tabella Users (non mostrata nello schema di esempio precedente) e di voler ottimizzare la seguente query:
SELECT * FROM Users
WHERE Name='Alex'
ORDER BY LastLogin DESC
LIMIT 10;
Crea un indice su (Name, LastLogin DESC) in modo che Spanner possa leggere le prime 10 righe direttamente nell'ordine dell'indice senza ordinamento:
CREATE INDEX UsersByNameLastLogin ON Users(Name, LastLogin DESC);
Suffisso della chiave di ordinamento
Anche se un indice include la colonna ORDER BY come suffisso della chiave di indice,
una query potrebbe comunque analizzare righe aggiuntive se è presente un predicato IN, OR o di intervallo
su una delle colonne di prefisso dell'indice.
Ad esempio, considera la seguente query che utilizza l'indice (Name, LastLogin DESC) dell'esempio di ordinamento completo precedente, che non fa parte dello schema di esempio:
SELECT *
FROM Users
WHERE Name IN ('Alex','Amal')
ORDER BY LastLogin DESC
LIMIT 10;
Poiché Name corrisponde a più valori, le righe corrispondenti non vengono archiviate in un unico intervallo ordinato a livello globale da LastLogin DESC. Puoi ristrutturare la query utilizzando UNNEST e un join in modo che Spanner recuperi le righe principali per ogni valore Name separatamente e poi le combini:
SELECT *
FROM UNNEST(['Alex','Amal']) AS Name
JOIN Users AS u ON u.Name = Name
ORDER BY LastLogin DESC
LIMIT 10;
Questa riscrittura consente di eseguire scansioni più efficienti leggendo il numero minimo di righe da ogni chiave di prefisso associata ('Alex' e 'Amal'), seguita da un piccolo ordinamento dei risultati combinati per produrre il LIMIT finale.
Un caso speciale comune di questo pattern è un prefisso di shard, in cui viene aggiunta una colonna ShardId come colonna chiave principale per distribuire le scritture tra le suddivisioni.
Ad esempio, la seguente query esegue la scansione di 32 shard (da 0 a 31):
SELECT *
FROM Users
WHERE ShardId BETWEEN 0 AND 31
ORDER BY LastLogin DESC
LIMIT 10;
Per ottimizzare questa query, enumera esplicitamente gli ID shard (da 0 a 31)
e uniscili alla tabella Users utilizzando GENERATE_ARRAY in
GoogleSQL o generate_series in PostgreSQL:
GoogleSQL
SELECT *
FROM GENERATE_ARRAY(0, 31) AS id
JOIN Users AS u ON u.ShardId = id
ORDER BY LastLogin DESC
LIMIT 10;
PostgreSQL
SELECT *
FROM generate_series(0, 31) AS id
JOIN Users AS u ON u.ShardId = id
ORDER BY LastLogin DESC
LIMIT 10;
Per saperne di più su queste funzioni di generazione di array e serie, consulta
GENERATE_ARRAY per GoogleSQL e
generate_series per PostgreSQL.
Informazioni sulle prestazioni di scansione
Le sezioni seguenti descrivono le cause più comuni di scansioni lente di tabelle o indici e come mitigarle.
Righe eliminate
Per impostazione predefinita, Spanner conserva le righe eliminate o sovrascritte per un'ora per supportare le letture storiche e il recupero point-in-time. Puoi aumentare questo periodo di conservazione fino a sette giorni. Una volta trascorso il periodo di conservazione, una versione precedente della riga diventa idonea per la rimozione durante la compattazione dello spazio di archiviazione in background, che può richiedere fino a sette giorni aggiuntivi. Finché una versione precedente della riga non viene compattata, le query che analizzano l'intervallo di chiavi potrebbero dover leggere le versioni delle righe eliminate o sovrascritte e filtrarle. Per saperne di più sulla conservazione dei dati, consulta Recupero point-in-time (PITR).
Puoi verificare se una query ha scansionato righe eliminate esaminando la metrica Righe eliminate scansionate nella visualizzazione dei dettagli dell'operatore Scansione nel riquadro dei dettagli del visualizzatore del piano di query.
Per mitigare le scansioni lente causate da un numero elevato di righe eliminate di recente, puoi attivare una compattazione manuale dei dati. Per saperne di più, consulta Compattazione manuale dei dati.
Righe grandi
Per le righe di piccole dimensioni (fino a poche centinaia di byte), il costo di una scansione dipende principalmente dal numero di righe analizzate. Man mano che le dimensioni delle righe aumentano, le dimensioni in byte delle righe diventano più significative. Nell'archiviazione orientata alle righe, la dimensione totale della riga influisce sulle prestazioni di scansione, non solo sulla dimensione delle colonne proiettate dalla query.
Per query analitiche con scansioni intensive su tabelle di grandi dimensioni, valuta l'utilizzo del motore colonnare. Per saperne di più, consulta Monitora il motore colonnare.
Per le query su insiemi di righe più ristretti, se una tabella contiene sia colonne di grandi dimensioni sia colonne più piccole su cui vengono eseguite query di frequente, prendi in considerazione le seguenti opzioni:
- Separa le colonne più grandi in un gruppo di località non predefinito (che archivia le colonne specificate separatamente su disco dal resto della tabella) o in una tabella secondaria separata in modo che le scansioni delle colonne più piccole non leggano i dati delle colonne grandi. Per saperne di più, consulta Crea e gestisci gruppi di località.
- Per un'ulteriore ottimizzazione del tempo di lettura, duplica le colonne più piccole in un indice secondario con la stessa chiave primaria della tabella di base, utilizzando la clausola
STORINGper includere le colonne più piccole.
Ad esempio, supponiamo che una tabella Documents (non inclusa nello schema dell'esempio precedente) memorizzi una piccola stringa Metadata insieme a un oggetto JSON Content di grandi dimensioni. Puoi creare un indice secondario che memorizza solo Metadata in modo che le query che non richiedono Content possano eseguire la scansione dell'indice più piccolo anziché della tabella di base:
CREATE TABLE Documents (
  Id INT64,
  Metadata STRING(MAX),
  Content JSON
) PRIMARY KEY (Id);

CREATE INDEX DocumentMetadata ON Documents(Id) STORING (Metadata);
Dati intercalati di grandi dimensioni
Quando le tabelle sono con interleaving, Spanner archivia fisicamente ogni riga padre insieme alle righe figlio con interleaving in ordine di chiave. Se una tabella padre ha molte righe figlio con interleaving o se una tabella figlio ha un numero di righe significativamente inferiore rispetto alle tabelle padre o di pari livello, le scansioni degli intervalli sulla tabella più piccola sono più sparse e meno efficienti perché la scansione deve saltare le righe con interleaving delle altre tabelle.
Ad esempio, considera il seguente schema (non parte dello schema di esempio precedente), in cui sia Transaction che AuthorizedPerson sono intercalati in Account:
CREATE TABLE Account (
  AccountId INT64,
  -- Additional columns omitted
) PRIMARY KEY (AccountId);

CREATE TABLE Transaction (
  AccountId INT64,
  TransactionId STRING(MAX),
  -- Additional columns omitted
) PRIMARY KEY (AccountId, TransactionId),
INTERLEAVE IN PARENT Account;

CREATE TABLE AuthorizedPerson (
  AccountId INT64,
  SignerId INT64,
  Name STRING(MAX),
  -- Additional columns omitted
) PRIMARY KEY (AccountId, SignerId),
INTERLEAVE IN PARENT Account;
Se ogni riga Account ha migliaia di righe Transaction e solo poche righe AuthorizedPerson, una scansione dell'intervallo su Account o AuthorizedPerson ha un costo per riga più elevato rispetto a una scansione dell'intervallo su Transaction (anche se il costo totale è comunque inferiore). Questo accade perché una scansione di Transaction legge molte righe Transaction contigue contemporaneamente, mentre una scansione di Account o AuthorizedPerson ha meno righe adiacenti della stessa tabella e deve saltare le righe Transaction con interleaving.
Per ottimizzare le scansioni degli intervalli nella tabella più sparsa (Account o AuthorizedPerson), crea un indice secondario senza interleaving che duplica le colonne necessarie per la query, in modo simile all'approccio per le righe di grandi dimensioni:
CREATE INDEX AuthorizedPersonByAccount
  ON AuthorizedPerson(AccountId, SignerId)
  STORING (Name);
Utilizza l'esecuzione orientata ai batch
Spanner può eseguire scansioni e operatori di query utilizzando un metodo orientato alle righe (elaborando una riga alla volta) o un metodo orientato ai batch (elaborando blocchi di righe alla volta). Le sezioni seguenti spiegano come ispezionare e configurare le scansioni orientate ai batch e l'esecuzione degli operatori orientati ai batch.
Scansioni orientate ai batch
Alcune query Spanner potrebbero trarre vantaggio dall'utilizzo di un metodo di elaborazione orientato ai batch durante l'analisi dei dati, anziché del metodo di elaborazione orientato alle righe più comune. L'elaborazione delle scansioni in batch è un modo più efficiente per elaborare grandi volumi di dati contemporaneamente e consente alle query di ottenere un utilizzo della CPU e una latenza inferiori.
L'operazione di scansione di Spanner avvia sempre l'esecuzione nel metodo orientato alle righe. Durante questo periodo, Spanner raccoglie diverse metriche di runtime. Spanner applica quindi un insieme di euristiche basate sul risultato di queste metriche per determinare il metodo di scansione ottimale. Se appropriato, Spanner passa a un metodo di elaborazione orientato ai batch per contribuire a migliorare la velocità effettiva e le prestazioni della scansione.
Casi d'uso comuni
Le query con le seguenti caratteristiche generalmente traggono vantaggio dall'elaborazione orientata ai batch:
- Scansioni di grandi dimensioni su dati aggiornati di rado
- Scansioni con predicati su colonne a larghezza fissa
- Scansioni con un numero elevato di ricerche (una ricerca utilizza un indice per recuperare i record)
Casi d'uso senza miglioramenti delle prestazioni
Non tutte le query traggono vantaggio dall'elaborazione orientata ai batch. I seguenti tipi di query hanno un rendimento migliore con l'elaborazione della scansione orientata alle righe:
- Query di ricerca puntuale: query che recuperano una sola riga.
- Query di scansione di piccole dimensioni: scansioni di tabelle che analizzano solo poche righe, a meno che non abbiano un numero elevato di ricerche.
- Query con una clausola
LIMIT: query che interrompono l'analisi dopo aver restituito un numero fisso di righe. - Query che leggono dati con un tasso di abbandono elevato: query in cui più del 10% circa dei dati letti viene aggiornato di frequente.
- Query con righe contenenti valori di grandi dimensioni: query su righe che contengono valori superiori a 32.000 byte (pre-compressione) in una singola colonna.
Controlla il metodo di scansione utilizzato da una query
Per verificare se la query utilizza l'elaborazione orientata ai batch, l'elaborazione orientata alle righe o se passa automaticamente da un metodo di scansione all'altro, segui questi passaggi:
Nella console Google Cloud , vai alla pagina Istanze di Spanner.
Fai clic sul nome dell'istanza con la query che vuoi esaminare.
Nella tabella Database, fai clic sul database con la query che vuoi esaminare.
Nel menu di navigazione di Spanner, fai clic su Spanner Studio.
Fai clic su Nuova scheda dell'editor SQL o Nuova scheda.
Nell'editor di query, inserisci la query.
Fai clic su Esegui.
Spanner esegue la query e mostra i risultati.
Nel riquadro dell'editor di query, fai clic sulla scheda Spiegazione.
Spanner mostra il visualizzatore del piano di esecuzione delle query. Ogni scheda sul grafico rappresenta un iteratore. Per saperne di più sui piani di esecuzione, consulta Piani di esecuzione delle query.
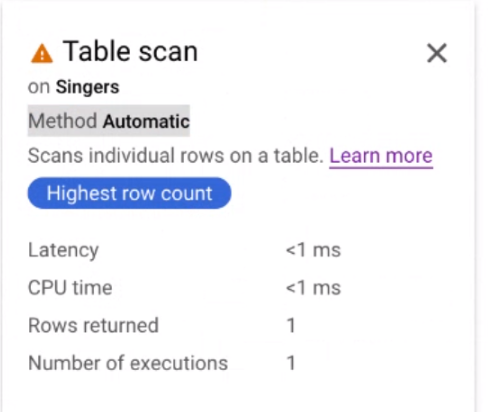
Fai clic sulla scheda dell'iteratore Scansione tabella per aprire un riquadro informativo.
Il riquadro delle informazioni mostra informazioni contestuali sull'analisi selezionata, incluso il metodo di analisi (Metodo). Automatico indica che Spanner determina il metodo di scansione. Altri valori possibili includono Batch per l'elaborazione orientata ai batch e Row per l'elaborazione orientata alle righe, come mostrato nell'immagine seguente:
Forza il metodo di scansione utilizzato da una query
Per ottimizzare le prestazioni delle query, Spanner sceglie il metodo di scansione ottimale per la query. Google consiglia di utilizzare questo metodo di scansione predefinito. Tuttavia, potrebbero esserci scenari in cui vuoi applicare un tipo specifico di metodo di scansione.
Applica la scansione orientata ai batch
Puoi applicare l'analisi orientata ai batch a livello di tabella e di istruzione.
Per applicare il metodo di scansione orientato ai batch a livello di tabella, utilizza un suggerimento per la tabella nella query:
GoogleSQL
SELECT *
FROM (Singers@{SCAN_METHOD=BATCH} AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
PostgreSQL
SELECT *
FROM (Singers/*@ scan_method=batch */ AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
Per applicare il metodo di scansione orientato ai batch a livello di istruzione, utilizza un suggerimento per l'istruzione nella query:
GoogleSQL
@{SCAN_METHOD=BATCH}
SELECT *
FROM Singers;
PostgreSQL
/*@ scan_method=batch */
SELECT *
FROM Singers;
Quando utilizzi un suggerimento a livello di istruzione, questo viene applicato all'intera query. L'impostazione del suggerimento a livello di tabella è preferibile e fornisce un controllo più granulare.
Forza la scansione orientata alle righe
Sebbene Google sconsigli di disattivare il metodo di scansione automatica impostato da Spanner, puoi disattivarlo e utilizzare il metodo di scansione orientato alle righe per la risoluzione dei problemi, ad esempio per diagnosticare la latenza.
Per disattivare la selezione automatica del metodo di scansione e applicare l'elaborazione delle righe a livello di tabella, utilizza un suggerimento per la tabella nella query:
GoogleSQL
SELECT *
FROM (Singers@{SCAN_METHOD=ROW} AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
PostgreSQL
SELECT *
FROM (Singers/*@ scan_method=row */ AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
Per disattivare il metodo di scansione automatica e applicare l'elaborazione delle righe a livello di istruzione, utilizza un suggerimento per l'istruzione nella query:
GoogleSQL
@{SCAN_METHOD=ROW}
SELECT *
FROM Singers;
PostgreSQL
/*@ scan_method=row */
SELECT *
FROM Singers;
Metodo di esecuzione
Oltre alle scansioni orientate ai batch, puoi anche ottimizzare l'esecuzione delle query applicando il metodo di esecuzione a livello di istruzione. Questo funziona solo per alcuni operatori ed è indipendente dal metodo di scansione, che viene utilizzato solo dall'operatore di scansione. Per saperne di più sulle scansioni orientate ai batch, consulta la sezione Scansioni orientate ai batch di questo documento.
Per impostazione predefinita, la maggior parte degli operatori viene eseguita con il metodo orientato alle righe, che elabora i dati una riga alla volta. Gli operatori vettorizzati vengono eseguiti con il metodo orientato ai batch per contribuire a migliorare la velocità effettiva e le prestazioni di esecuzione. Questi operatori elaborano i dati un blocco alla volta. Quando un operatore deve elaborare molte righe, il metodo di esecuzione orientato ai batch è solitamente più efficiente.
Metodo di esecuzione e metodo di scansione
Il metodo di esecuzione della query è indipendente dal metodo di scansione della query. Puoi impostare uno, entrambi o nessuno di questi metodi nel suggerimento per la query.
Il metodo di esecuzione delle query si riferisce al modo in cui gli operatori di query elaborano i risultati intermedi e al modo in cui gli operatori interagiscono tra loro, mentre il metodo di scansione si riferisce al modo in cui l'operatore di scansione interagisce con il livello di archiviazione di Spanner.
Forza il metodo di esecuzione utilizzato dalla query
Per ottimizzare le prestazioni delle query, Spanner sceglie il metodo di esecuzione ottimale per la query in base a varie euristiche. Google consiglia di utilizzare questo metodo di esecuzione predefinito. Tuttavia, potrebbero esserci scenari in cui vuoi applicare un tipo specifico di metodo di esecuzione.
Puoi applicare il metodo di esecuzione a livello di istruzione. Il suggerimento di query EXECUTION_METHOD è un consiglio, non un'istruzione. In ultima analisi, l'ottimizzatore delle query decide quale metodo utilizzare per ogni singolo operatore.
Per applicare il metodo di esecuzione orientato ai batch a livello di istruzione, utilizza un suggerimento per l'istruzione nella query:
GoogleSQL
@{EXECUTION_METHOD=BATCH}
SELECT *
FROM Singers;
PostgreSQL
/*@ EXECUTION_METHOD=BATCH */
SELECT *
FROM Singers;
Sebbene Google sconsigli di disattivare il metodo di esecuzione automatico impostato da Spanner, puoi disattivarlo e utilizzare il metodo di esecuzione orientato alle righe per la risoluzione dei problemi, ad esempio per diagnosticare la latenza.
Per disattivare il metodo di esecuzione automatico e applicare il metodo di esecuzione orientato alle righe a livello di istruzione, utilizza un suggerimento per l'istruzione nella query:
GoogleSQL
@{EXECUTION_METHOD=ROW}
SELECT *
FROM Singers;
PostgreSQL
/*@ EXECUTION_METHOD=ROW */
SELECT *
FROM Singers;
Controlla quale metodo di esecuzione è abilitato
Non tutti gli operatori Spanner supportano i metodi di esecuzione orientati ai batch e alle righe. Per ogni operatore, il visualizzatore del piano di esecuzione delle query mostra il metodo di esecuzione nella scheda dell'iteratore. Se il metodo di esecuzione è orientato ai batch, viene visualizzato Batch. Se è orientata alle righe, viene visualizzato Riga. Per ulteriori informazioni sul visualizzatore, consulta Piani di esecuzione delle query.
Se gli operatori della query vengono eseguiti utilizzando metodi di esecuzione diversi, gli adattatori del metodo di esecuzione DataBlockToRowAdapter e RowToDataBlockAdapter vengono visualizzati tra gli operatori per mostrare la modifica del metodo di esecuzione. Per ulteriori
informazioni su questi operatori, consulta
DataBlockToRowAdapter e
RowToDataBlockAdapter.