


Mit Spanner Graph können Sie verbundene Daten als Eigenschaftsgraph modellieren, der Informationen als Netzwerk von Knoten und Kanten darstellt. Knoten symbolisieren Entitäten und Kanten zeigen Verbindungen zwischen ihnen. Knoten und Kanten enthalten Labels, die die Arten von Knoten und Kanten klassifizieren. Knoten und Kanten enthalten auch Attribute, die sie beschreiben.
In diesem Dokument wird beschrieben, wie Sie ein Spanner Graph-Schema definieren, indem Sie Zeilen von Tabellen Knoten und Kanten des Graphen zuordnen. Außerdem erfahren Sie wie Sie Labels und Attribute für Knoten und Kanten anpassen und wie Sie mit Abhängigkeiten zwischen Graphen und Schemaobjekten arbeiten.
Wenn Sie flexiblere Graphdefinitionen wünschen, siehe Schemalose Daten verwalten. Informationen zur Verwendung von SQL-Ansichten anstelle von Tabellen zum Definieren von Knoten und Kanten finden Sie unter Übersicht über Graphen, die aus SQL-Ansichten erstellt wurden. Weitere Informationen zu Spanner Graph finden Sie in der Übersicht zu Spanner Graph.
Eigenschaftsgraph-Datenmodell
Mit einem Eigenschaftsgraph können Sie verbundene Daten modellieren. Er stellt Informationen als Netzwerk von Knoten und Kanten dar. Knoten symbolisieren Entitäten in Ihrer Datenlandschaft, z. B. Kunden, Produkte oder Standorte. Kanten zeigen die Verbindungen zwischen diesen Knoten und erfassen Beziehungen wie „gekauft“, „folgt“ oder „befindet sich in“.
Sowohl Knoten als auch Kanten können die folgenden Informationen enthalten:
Labels: Klassifizieren Knoten- und Kantentypen. Wenn Sie kein Label für einen Knoten oder eine Kante explizit definieren, verwendet Spanner Graph den Namen der Eingabetabelle als Standardlabel.
Accountkönnte beispielsweise ein Label sein.Attribute: Werden verwendet, um Knoten und Kanten zu beschreiben. Ein
Person-Knoten kann beispielsweise einname-Attribut mit dem WertAlexund einid-Attribut mit dem Wert1haben.
Das Beispiel in Abbildung 1 zeigt, wie Sie einen Graphen entwerfen können, um Finanzaktivitäten zu modellieren. Dieser Graph enthält die folgenden Arten von Entitäten, die als Knoten modelliert werden:
- Person:Stellt eine Person dar, die an Finanztransaktionen beteiligt ist.
- Account:Stellt ein Bankkonto dar, das für Transaktionen verwendet wird.
Diese Entitäten sind durch verschiedene Arten von Beziehungen verbunden, die durch die folgenden gerichteten Kanten dargestellt werden:
- Owns:Eine Person besitzt ein oder mehrere Konten.
- Transfers:Geld wird von einem Konto auf ein anderes überwiesen.
Jede gerichtete Kante gibt eine unidirektionale Beziehung an, die von einem Quellknoten zu einem Zielknoten verläuft. Eine Transfers-Kante verbindet beispielsweise ein Quellkonto (Account) mit einem Zielkonto (Account) und gibt den Geldfluss an.
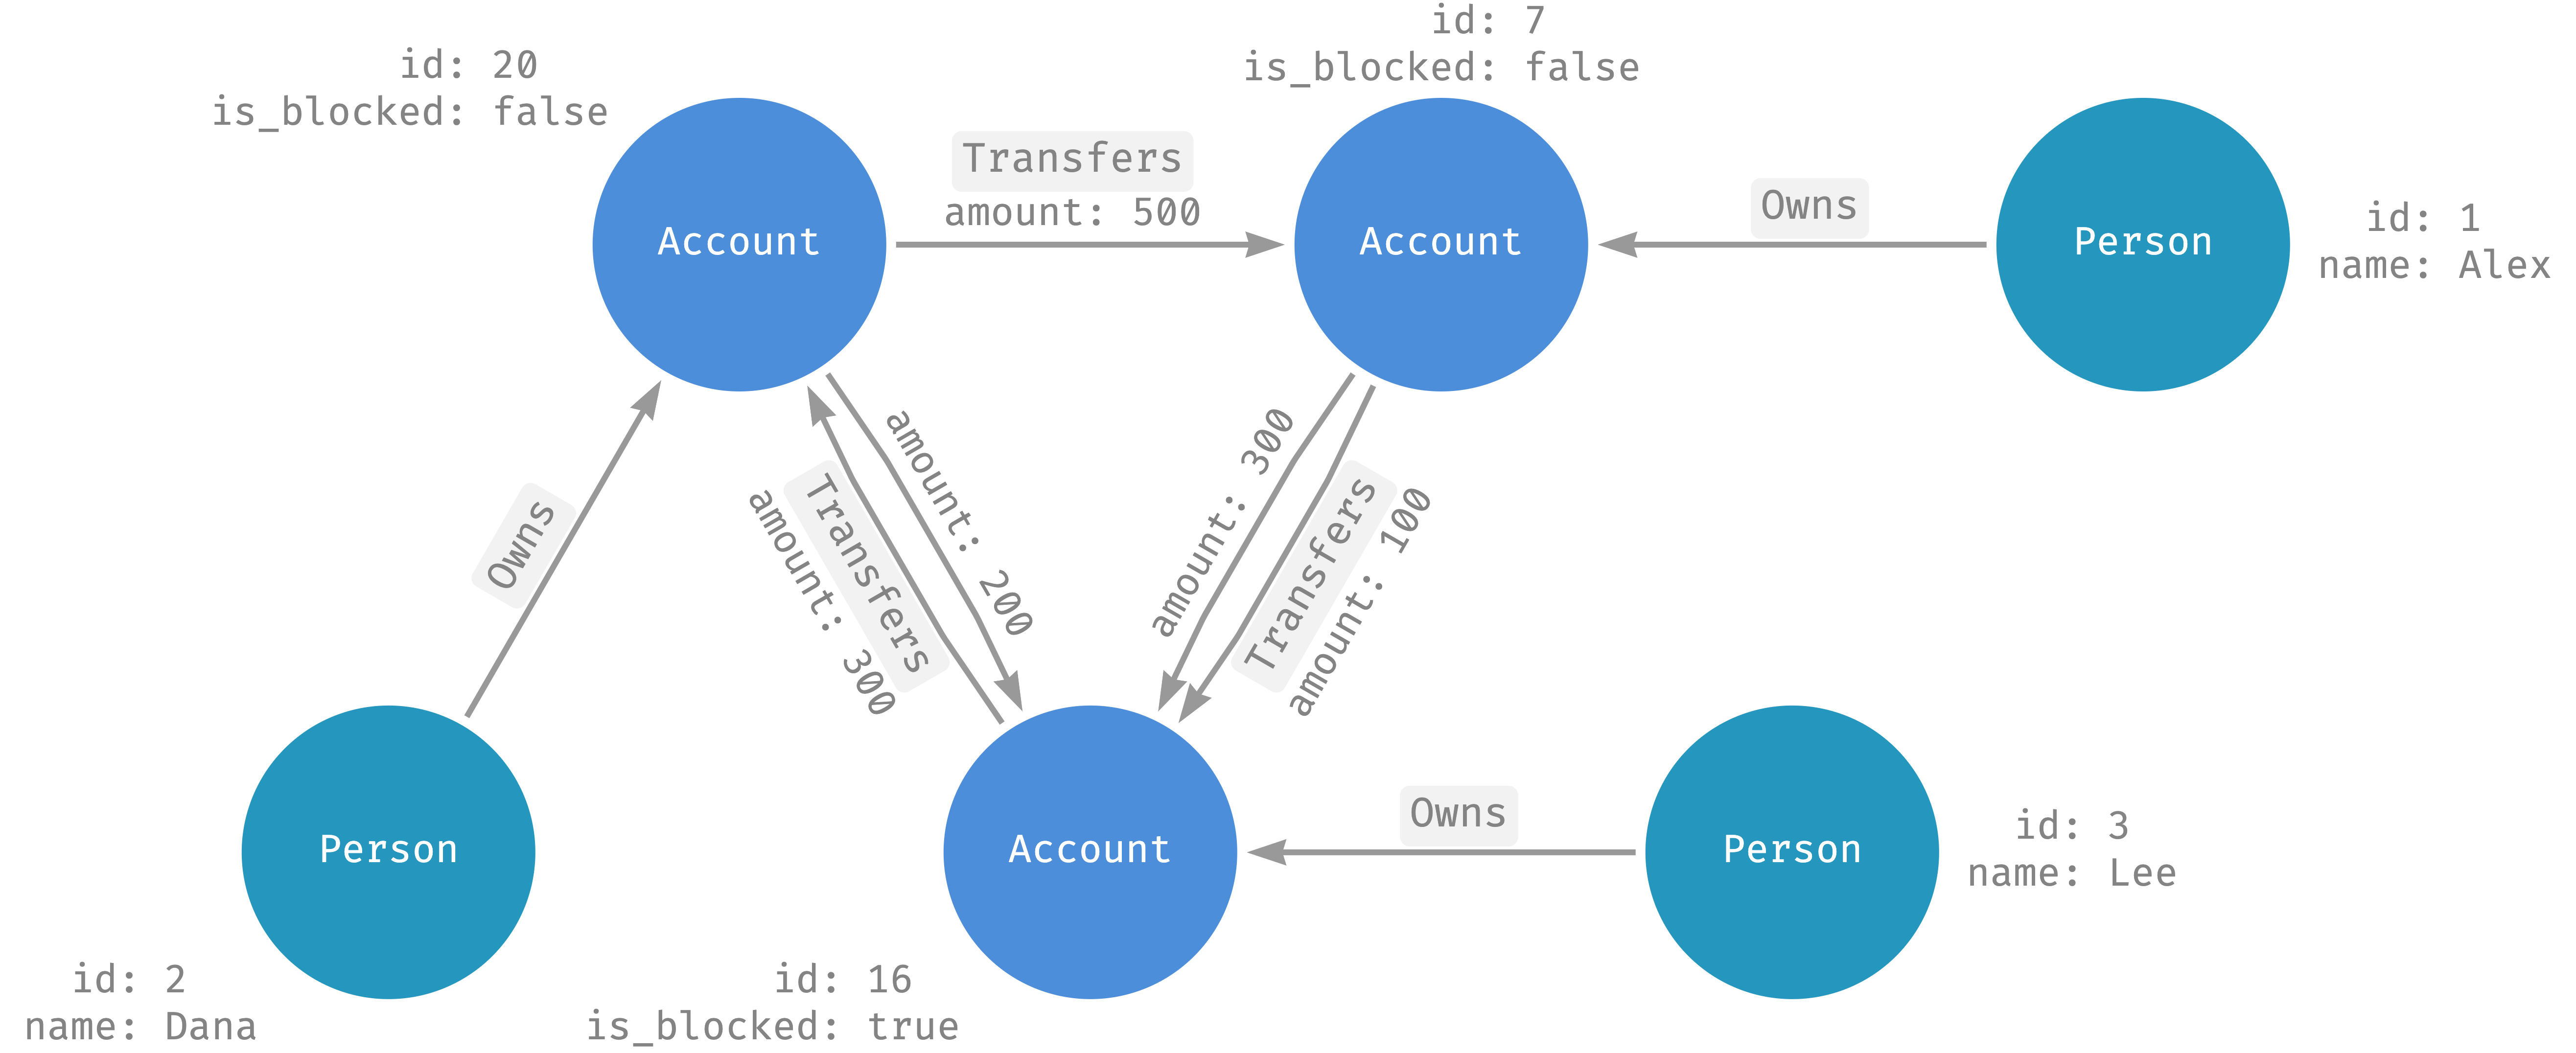
Abbildung 1. Beispielgraph mit mehreren Knoten und gerichteten Kanten.
Knoten und Kanten enthalten zusätzliche Informationen in Attributen.
- Person -Knoten enthalten die folgenden Attribute:
name(STRING)id(INT64)
- Transfers -Kanten enthalten dieses Attribut:
amount(FLOAT64)
Gerichtete und ungerichtete Kanten
Im Beispielgraphen werden gerichtete Kanten verwendet, die eine bestimmte Richtung in der Beziehung zwischen Entitäten angeben. Einige Beziehungen, wie die Freundschaftsbeziehung in einem sozialen Netzwerk, sind jedoch ungerichtet und stellen eine wechselseitige Verbindung ohne eindeutigen Ursprung oder Endpunkt dar. In diesem Fall können Sie ungerichtete Kanten als zwei gerichtete Kanten modellieren, eine in jeder Richtung.
Spanner Graph-Schemadesign
In Spanner Graph verwenden Sie die Anweisung CREATE PROPERTY GRAPH , um einen Graphen aus Tabellen oder SQL-Ansichten zu erstellen. Die Tabellen, die zum Erstellen von Graphen verwendet werden, werden als Eingabetabellen bezeichnet. In diesem Dokument wird gezeigt, wie Sie Tabellen verwenden, um einen Graphen zu erstellen. Informationen zur Verwendung von SQL-Ansichten finden Sie unter Spanner Graph aus einer SQL-Ansicht erstellen.
Knoten aus einer Tabelle definieren
Fügen Sie eine Knotendefinition in die NODE TABLES -Klausel ein, um einen Knoten zu definieren. Die einfachste Form einer Knotendefinition enthält den Namen einer Eingabetabelle mit definierten Quell- und Zielknotenreferenzen. Spanner Graph ordnet Zeilen aus der Eingabetabelle Graphenknoten zu.
Im folgenden Beispiel definieren Sie den Account Knoten im FinGraph Eigenschaftsgraphen mit der
NODE TABLES
-Klausel. Die Knotendefinition enthält die Eingabetabelle Account.
-- First, create an Account table.
CREATE TABLE Account (
  id           INT64 NOT NULL,
  create_time  TIMESTAMP,
) PRIMARY KEY (id);

-- Next, use the Account table as input table of Account node definition.
CREATE PROPERTY GRAPH FinGraph
  NODE TABLES (
    Account
  );
Standardlabels und -attribute
Neben der Verwendung des Namens der Eingabetabelle als Standardlabel macht Spanner Graph alle Spalten aus der Eingabetabelle als Knotenattribute verfügbar.
Im vorherigen Beispiel
- verwendet jeder Kontoknoten das Label
Account. - Jeder Kontoknoten enthält die Attribute
[id, create_time]aus den Spalten der TabelleAccount.
Elementschlüssel
Eine Knotendefinition definiert auch den Elementschlüssel, der einen Graphenknoten eindeutig identifiziert.
- Standardmäßig ist der Elementschlüssel der Primärschlüssel der Eingabetabelle.
- Sie können die Klausel
KEYverwenden, um Elementschlüssel explizit zu definieren. - Sie können Spalten mit einer eindeutigen Index Einschränkung als Elementschlüssel verwenden.
Im folgenden Beispiel werden die Knoten Account und Person definiert.
- Der Knoten
Accountverwendet standardmäßig den Primärschlüssel der TabelleAccountals Elementschlüssel. - Der Knoten
Persongibt dagegen mit der KlauselKEYexplizitidals Elementschlüssel an.
CREATE TABLE Person (
  id           INT64 NOT NULL,
  name         STRING(MAX),
) PRIMARY KEY (id);

CREATE TABLE Account (
  id           INT64 NOT NULL,
  create_time  TIMESTAMP,
) PRIMARY KEY (id);

CREATE PROPERTY GRAPH FinGraph
  NODE TABLES (
    Person KEY (id),
    Account
  );
Zeile in der Eingabetabelle einem Knoten im Graphen zuordnen
- Jede Zeile mit einem Elementschlüssel, der nicht null ist, wird einem eindeutigen Knoten im Graphen zugeordnet, der durch den Elementschlüssel identifiziert wird.
- Zeilen mit einem Elementschlüssel, der null ist, werden ignoriert.
Kante aus einer Tabelle definieren
Fügen Sie eine Kantendefinition in die EDGE TABLES -Klausel ein, um eine Kante zu definieren. Die einfachste Form der Kantendefinition enthält nur einen Namen der Eingabetabelle. Spanner Graph ordnet Zeilen aus der Eingabetabelle Graphenkanten zu.
Das Standardlabel und die Standardattribute der Kanten werden auf dieselbe Weise wie bei Knoten definiert.
Der Elementschlüssel jeder Kante wird auf dieselbe Weise wie bei Knoten definiert.
Quell- und Zielknotenreferenzen
Im folgenden Beispiel erstellen Sie einen Eigenschaftsgraphen FinGraph mit Folgendem:
Person- undAccount-KnotenPersonOwnAccount-Kante
CREATE TABLE Person (
  id            INT64 NOT NULL,
  name          STRING(MAX),
) PRIMARY KEY (id);

CREATE TABLE Account (
  id            INT64 NOT NULL,
  create_time   TIMESTAMP,
) PRIMARY KEY (id);

CREATE TABLE PersonOwnAccount (
  id            INT64 NOT NULL,
  account_id    INT64 NOT NULL,
  create_time   TIMESTAMP,
  FOREIGN KEY (account_id) REFERENCES Account (id)
) PRIMARY KEY (id, account_id),
  INTERLEAVE IN PARENT Person;

CREATE PROPERTY GRAPH FinGraph
  NODE TABLES (
    Person,
    Account
  )
  EDGE TABLES (
    PersonOwnAccount
      SOURCE KEY (id) REFERENCES Person (id)
      DESTINATION KEY (account_id) REFERENCES Account (id)
  );
Eine Kantendefinition definiert die Quell- und Zielknotenreferenz mit den Klauseln SOURCE KEY, DESTINATION KEY und REFERENCES. Im folgenden Beispiel wird die Kantendefinition von PersonOwnAccount verwendet, um dieses Konzept zu veranschaulichen:
EDGE TABLES (
  PersonOwnAccount
    SOURCE KEY (id) REFERENCES Person (id)
    DESTINATION KEY (account_id) REFERENCES Account (id)
)
Jede PersonOwnAccount-Kante verbindet ein Person (Quelle) mit einem Account
(Ziel)-Knoten.
- Der Quellknoten einer Kante ist ein
Person-Knoten, bei dem dieidmit deridder Kante übereinstimmt. - Der Zielknoten einer Kante ist ein
Account-Knoten, bei dem dieidmit deraccount_idder Kante übereinstimmt.
Außerdem gilt Folgendes für die Kante PersonOwnAccount:
- Der Elementschlüssel ist der Primärschlüssel der Tabelle
PersonOwnAccount, nämlich(id, account_id). - Jede Kante hat dieselben Attribute wie die Spalten aus der Tabelle
PersonOwnAccount. - Jede Kante hat das Standardlabel
PersonOwnAccount.
Zeile in einer Kanten-Eingabetabelle Kanten im Graphen zuordnen
- Jede Zeile in der Kanten-Eingabetabelle, bei der der Elementschlüssel nicht null ist, wird in der Regel einer eindeutigen Kante in Ihrem Graphen zugeordnet.
- Eine Zeile kann null oder mehr als einer Kante im Graphen entsprechen. Beispielsweise tritt dies auf, wenn die Quellknotenreferenz mit null oder mehr Knoten in der Quellknotentabelle übereinstimmt.
Knoten und Kanten in einer einzelnen Tabelle definieren
Sie können einen Knoten und seine eingehenden oder ausgehenden Kanten in einer einzelnen Tabelle definieren, wenn die Spalten der Tabelle eine Beziehung zu einer anderen Tabelle definieren. Dieser Ansatz reduziert die Anzahl der Tabellen, vereinfacht die Datenverwaltung und kann die Abfrageleistung verbessern, da keine Verknüpfung mit einer separaten Kantentabelle erforderlich ist.
Wenn die folgende Tabelle Account beispielsweise einen zusammengesetzten Primärschlüssel
(owner_id, account_id) hat, kann der Teil owner_id ein Fremdschlüssel sein, der
auf eine Tabelle Person verweist. Mit dieser Struktur kann die Tabelle Account sowohl den Knoten Account als auch die eingehende Kante vom Knoten Person darstellen.
  CREATE TABLE Person (
    id INT64 NOT NULL,
  ) PRIMARY KEY (id);

  -- Assume each account has exactly one owner.
  CREATE TABLE Account (
    owner_id INT64 NOT NULL,
    account_id INT64 NOT NULL,
    FOREIGN KEY (owner_id) REFERENCES Person(id)
  ) PRIMARY KEY (owner_id, account_id);
Sie können die Tabelle Account verwenden, um sowohl den Knoten Account als auch seine eingehende Kante Owns zu definieren. Dies wird in der folgenden Anweisung CREATE PROPERTY GRAPH gezeigt. In der Klausel EDGE TABLES geben Sie der Tabelle Account den Alias Owns. Das liegt daran, dass jedes Element im Graphschema einen eindeutigen Namen haben muss.
  CREATE PROPERTY GRAPH FinGraph
    NODE TABLES (
      Person,
      Account
    )
    EDGE TABLES (
      Account AS Owns
        SOURCE KEY (owner_id) REFERENCES Person
        DESTINATION KEY (owner_id, account_id) REFERENCES Account
    );
Labels und Attribute anpassen
Sie können die LABEL und PROPERTIES verwenden, um Labels und Attribute anzupassen.
Im folgenden Beispiel werden zwei Knoten definiert: Person und Account.
- Die
Person-Knoten verwenden das LabelCustomer, um das Attributaddressverfügbar zu machen. Das Attributaddresswird durch den AusdruckCONCAT(city, ", ", country),definiert, der auf die Spaltencityundcountryaus der EingabetabellePersonverweist. - Für
Accountverwendet der KnotenAccountdas LabelAccount, um die Attributeidundcreate_timeverfügbar zu machen. PersonundAccounthaben das LabelEntitymit den Attributen [id, name].- Für
Personstammen die Attributeidundnameaus den Spalten der Eingabetabelle. - Für
Accountverweist das Attributnameauf die Spaltenick_nameder Eingabetabelle.
- Für
CREATE TABLE Person (
  id               INT64 NOT NULL,
  name             STRING(MAX),
  birthday         TIMESTAMP,
  country          STRING(MAX),
  city             STRING(MAX),
) PRIMARY KEY (id);

CREATE TABLE Account (
  id               INT64 NOT NULL,
  create_time      TIMESTAMP,
  is_blocked       BOOL,
  nick_name        STRING(MAX),
) PRIMARY KEY (id);

CREATE PROPERTY GRAPH FinGraph
  NODE TABLES (
    Person KEY (id)
      LABEL Customer
        PROPERTIES (CONCAT(city, ", ", country) AS address)
      LABEL Entity PROPERTIES (id, name),
    Account KEY (id)
      LABEL Account PROPERTIES (id, create_time)
      LABEL Entity PROPERTIES (id, nick_name AS name)
  );
Label- und Attributkonsistenz
In einem Graphen werden Labels und Attribute eindeutig durch ihre Namen identifiziert. Sie können Labels und Attribute mit demselben Namen in mehreren Knoten- oder Kantendefinitionen verwenden. Labels und Attribute mit demselben Namen müssen jedoch die folgenden Regeln einhalten:
- Attribute mit demselben Namen verwenden denselben Werttyp.
- Labels mit demselben Namen machen dieselbe Liste von Attributen verfügbar.
Im vorherigen Beispiel ist das Label Entity sowohl in den Knoten Person als auch Account definiert. Beide Definitionen enthalten dieselbe Gruppe von Attributnamen [id, name] mit identischen Werttypen.
Abhängigkeiten zwischen Graphen und anderen Schemaobjekten
Der mit CREATE PROPERTY GRAPH erstellte Graph hängt von anderen Schemaobjekten ab, z. B. von den Eingabetabellen der Knoten- und Kantendefinitionen und den Tabellenspalten, auf die von den Attributen verwiesen wird. Spanner Graph lässt keine Schemaänderung zu, die eine dieser Abhängigkeiten unterbricht.
Mit der folgenden Anweisung wird FinGraph von der Tabelle Account und den Spalten id und create_time abhängig gemacht.
CREATE OR REPLACE PROPERTY GRAPH FinGraph
  NODE TABLES (
    Account PROPERTIES (id, create_time)
  );
In diesem Beispiel lässt Spanner Graph die folgenden Schemaänderungen nicht zu:
- Sie können die Tabelle
Accountnicht löschen. Dazu müssen Sie die KnotendefinitionAccountentfernen. Weitere Informationen finden Sie unter Vorhandene Knoten- oder Kantendefinitionen entfernen. - Sie können die Spalten
create_timenicht aus der TabelleAccountlöschen. Dazu müssen Sie das Attributcreate_timeaus der KnotendefinitionAccountentfernen. Weitere Informationen finden Sie unter Vorhandene Knoten- oder Kantendefinitionen aktualisieren.
Sie können jedoch die folgenden Schemaänderungen vornehmen:
- Ändern Sie das Schema der Tabelle
Accountund der Spaltenidundcreate_time, wenn andere Schemaanforderungen dies zulassen. Weitere Informationen finden Sie unter Schemaaktualisierungen vornehmen.
Schemavisualisierung ansehen
Sie können eine Schemavisualisierung in Spanner Studio ansehen, nachdem Sie eine Spanner Graph-Abfrage ausgeführt haben. Weitere Informationen finden Sie unter Spanner Graph-Visualisierungen verwenden.
Schemalose Daten verwalten
Spanner Graph unterstützt auch die schemalose Datenverwaltung, die hilfreich ist, wenn Sie eine flexiblere Graphdefinition benötigen. Weitere Informationen finden Sie unter Schemalose Daten in Spanner Graph verwalten.
Nächste Schritte
- Spanner Graph-Schema erstellen.
- Spanner Graph-Schema aktualisieren oder löschen
- Schemalose Daten mit Spanner Graph verwalten.
- Best Practices für das Spanner Graph-Schemadesign
- Best Practices für die Optimierung von Spanner Graph-Abfragen