


Auf dieser Seite wird erläutert, wie Sie Spanner Data Boost verwenden, wenn Sie föderierte Abfragen von BigQuery an eine Spanner-Datenbank senden. Mit Data Boost werden föderierte Abfragen mit minimalen Auswirkungen auf vorhandene Arbeitslasten auf der bereitgestellten Spanner-Instanz ausgeführt. Bei Data Boost-Abfragen von BigQuery an eine Spanner-Datenbank können BigQuery-Daten mit Spanner-Daten zusammengeführt werden.
Sie können föderierte Abfragen von BigQuery an Spanner mit Data Boost auf eine der folgenden Arten ausführen:
- Föderierte Data Boost-Abfrage ausführen, die die föderierte Abfragefunktion
EXTERNAL_QUERYverwendet. - Data Boost mit externen Datasets verwenden
Mit der Spanner-Föderation kann BigQuery Daten in Spanner in Echtzeit abfragen, ohne Daten kopieren oder verschieben zu müssen. Weitere Informationen zu föderierten Spanner-Abfragen finden Sie unter Föderierte Spanner-Abfragen. Weitere Informationen zu Data Boost finden Sie unter Data Boost-Übersicht.
Hinweis
Bevor Sie föderierte Abfragen mit Data Boost ausführen können, müssen Sie die folgenden Aufgaben ausführen:
Spanner-Instanz und -Datenbank erstellen
Wenn Sie keine Cloud Spanner-Instanz und -Datenbank haben, folgen Sie der Anleitung unter Datenbank mit der Google Cloud Console erstellen und abfragen, um sie zu erstellen.
BigQuery Connection API aktivieren
Mit der BigQuery Connection API können Sie BigQuery-Verbindungen zu externen Datenquellen wie einer Spanner-Datenbank verwalten.
Aktivieren Sie die BigQuery Connection API, falls sie noch nicht aktiviert ist.
Erforderliche Rollen zum Aktivieren von APIs
Zum Aktivieren von APIs benötigen Sie die Berechtigung
serviceusage.services.enable. Wenn Sie das Projekt erstellt haben, haben Sie diese Berechtigung wahrscheinlich bereits über die Inhaberrolle (roles/owner). Andernfalls können Sie diese Berechtigung über die Rolle „Service Usage-Administrator“ (roles/serviceusage.serviceUsageAdmin) erhalten. Informationen zum Zuweisen von Rollen
Weitere Informationen finden Sie in der BigQuery-Dokumentation unter BigQuery Connection API.
Hauptkonten IAM-Berechtigungen für Data Boost gewähren
Einem Hauptkonto müssen die folgenden Berechtigungen gewährt werden, um föderierte Abfragen mit Data Boost auszuführen:
spanner.instances.get: Damit können Sie die Konfiguration einer Instanz abrufen.spanner.databases.useDataBoost: Ermöglicht die Verwendung der Rechenressourcen von Spanner Data Boost, um partitionierte Abfragen zu verarbeiten.
Weitere Informationen zu Spanner-Berechtigungen finden Sie unter IAM-Berechtigungen (Identity and Access Management).
Wir empfehlen, die IAM-Rolle Cloud
Spanner Database Reader With DataBoost (roles/spanner.databaseReaderWithDataBoost) zu verwenden, um diese erforderlichen Berechtigungen zu gewähren. Sie können diese Rolle jedem Hauptkonto hinzufügen, das föderierte Abfragen mit Data Boost ausführen muss. Weitere Informationen zu vordefinierten Rollen in Spanner finden Sie unter Vordefinierte Rollen. Informationen zum Erstellen einer benutzerdefinierten IAM-Rolle finden Sie unter Benutzerdefinierte Rolle erstellen.
Föderierte Data Boost-Abfrage ausführen
Wenn Sie eine Data Boost-Abfrage von BigQuery an eine externe Quelle senden möchten, benötigen Sie eine BigQuery-Verbindung zur externen Quelle und die ID der Verbindung. Wenn Sie eine föderierte Spanner-Abfrage mit Data Boost ausführen, ist die externe Quelle eine Spanner-Datenbank. Nachdem Sie Ihre Verbindungs-ID erstellt haben, wird sie von BigQuery verwendet, um eine Data Boost-Abfrage einer Spanner-Datenbank auszuführen.
Verwenden Sie eine der folgenden Optionen, um eine BigQuery-Verbindungs-ID zu erstellen, und verwenden Sie dann die Verbindungs-ID, um eine Data Boost-Abfrage über BigQuery auszuführen:
In Spanner beginnen: Erstellen Sie die ID der externen BigQuery-Verbindung in der Spanner-Konsole. Nachdem Ihre Verbindungs-ID in der Spanner-Konsole erstellt wurde, werden Sie zur BigQuery-Konsole weitergeleitet, um eine föderierte Data Boost-Abfrage an eine Spanner-Datenbank zu senden.
In BigQuery beginnen: Erstellen Sie die externe Verbindungs-ID für Data Boost in der BigQuery-Konsole oder mit dem
bq-Befehlszeilentool. Nachdem Sie die Verbindungs-ID erstellt haben, bleiben Sie in der BigQuery-Konsole, um eine föderierte Data Boost-Abfrage an eine Spanner-Datenbank zu senden.
Data Boost-Abfrage in Spanner starten
So führen Sie eine föderierte Data Boost-Abfrage in Spanner Studio aus:
Rufen Sie in derGoogle Cloud Console die Spanner-Seite Instanzen auf.
In der Console wird eine Liste Ihrer Spanner-Instanzen angezeigt.
Wählen Sie eine Spanner-Instanz und dann eine Datenbank aus.
Klicken Sie auf der Seite Datenbankübersicht im Navigationsmenü auf Spanner Studio.
Klicken Sie auf In BigQuery ansehen.
Geben Sie im Dialogfeld In BigQuery ansehen eine Verbindungs-ID ein.
Die Verbindungs-ID wird verwendet, um eine neue externe BigQuery-Verbindung zu Ihrer Spanner-Datenbank zu erstellen. Sie verweisen auf Ihre externe Verbindung mit dem folgenden Muster:
PROJECT-ID.LOCATION.CONNECTION-IDWenn die ID bereits vorhanden ist, tritt ein Fehler auf.
Füllen Sie den Rest des Dialogfelds aus und gehen Sie so vor:
- Wählen Sie Daten parallel lesen aus.
- Wählen Sie Spanner Data Boost verwenden aus.
Klicken Sie auf In BigQuery ansehen.
BigQuery Studio wird mit der folgenden Abfrage geöffnet:
SELECT * FROM EXTERNAL_QUERY("PROJECT-ID.LOCATION.CONNECTION-ID", "SELECT * FROM INFORMATION_SCHEMA.TABLES;");Sie können dies durch Ihre föderierte Abfrage ersetzen. Sie könnten beispielsweise eine Abfrage wie die folgende erstellen. In diesem Beispiel wird eine föderierte Abfrage aus einer Tabelle namens
ordersin einer Spanner-Datenbank erstellt und die Ergebnisse werden mit einer BigQuery-Tabelle namensmydataset.customersverknüpft.SELECT c.customer_id, c.name, rq.first_order_date FROM mydataset.customers AS c LEFT OUTER JOIN EXTERNAL_QUERY( 'my-project.us.example-db', '''SELECT customer_id, MIN(order_date) AS first_order_date FROM orders GROUP BY customer_id''') AS rq ON rq.customer_id = c.customer_id GROUP BY c.customer_id, c.name, rq.first_order_date;
Data Boost-Abfrage in BigQuery starten
Wählen Sie eine der folgenden Optionen aus, um eine externe Datenverbindung von BigQuery zu einer Spanner-Datenbank zu erstellen und diese Verbindung zu verwenden, um eine föderierte Data Boost-Abfrage von BigQuery auszuführen:
Console
Rufen Sie in der BigQuery-Dokumentation Spanner-Verbindungen erstellen auf und folgen Sie der Anleitung auf dem Tab Console.
Führen Sie im Bereich Externe Datenquelle die folgenden Schritte aus:
- Wählen Sie Daten parallel lesen aus.
- Wählen Sie Spanner Data Boost verwenden aus.
bq
Rufen Sie in der BigQuery-Dokumentation Spanner-Verbindungen erstellen auf und folgen Sie der Anleitung auf dem Tab bq*.
Legen Sie die folgenden Verbindungseigenschaften auf
truefest:useParallelismuseDataBoost
Im folgenden Beispiel wird der Befehl bq
mk verwendet, um eine neue Verbindung mit dem Namen my_connection mit den beiden erforderlichen Attributen für Data Boost zu erstellen:
bq mk --connection --connection_type='CLOUD_SPANNER' --location='us' \
--properties='{"database":"projects/my-project/instances/my-instance/databases/my-database", "useParallelism":true, "useDataBoost": true}' my_connection
Data Boost mit externen Datasets verwenden
Wenn Sie eine Data Boost-Abfrage von BigQuery an Spanner als externe Quelle senden möchten, können Sie in BigQuery ein externes Dataset (auch als föderiertes Dataset bezeichnet) erstellen, das mit einer vorhandenen GoogleSQL- oder PostgreSQL-Datenbank in Spanner verknüpft ist.
CLOUD_RESOURCE-Verbindung verwenden
Standardmäßig werden für externe Spanner-Datasets Endnutzer-Anmeldedaten (EUC) verwendet. Dazu müssen die Nutzer direkten Zugriff auf ihre Spanner-Datenbanken haben. Nutzer können diese Datasets abfragen, wenn ihnen in Spanner Zugriff gewährt wurde.
Optional können externe Spanner-Datasets eine CLOUD_RESOURCE-Verbindung verwenden, um mit Ihrer Spanner-Datenbank zu interagieren. So können Sie einem Nutzer über BigQuery Zugriff auf Spanner-Daten gewähren, ohne ihm direkten Zugriff auf die Spanner-Datenbank zu geben.
Da das Dienstkonto der Verbindung CLOUD_RESOURCE das Abrufen von Daten aus Cloud Spanner übernimmt, müssen Sie Nutzern nur Zugriff auf das externe Cloud Spanner-Dataset gewähren.
Durch diese Zugriffsdelegation wird der Zugriff auf die Spanner-Tabellen von externen Datasets und der direkte Zugriff auf die zugrunde liegenden Spanner-Tabellen entkoppelt.
Für die Verbindung mit Cloud Spanner wird eine Cloud-Ressourcenverbindung verwendet, die mit einem Dienstkonto verknüpft ist.
Nutzer können diese Spanner-Tabellen aus externen Datasets abfragen, auch wenn sie in Spanner keinen Zugriff haben.
Bevor Sie externe Spanner-Datasets mit einer CLOUD_RESOURCE-Verbindung erstellen, müssen Sie Folgendes tun:
Verbindung herstellen
Sie können eine CLOUD_RESOURCE-Verbindung erstellen oder eine vorhandene verwenden, um eine Verbindung zu Spanner herzustellen. Erstellen Sie die Verbindung am selben Standort, an dem Sie Ihr externes Cloud Spanner-Dataset erstellen möchten.
Console
Rufen Sie die Seite BigQuery auf.
Klicken Sie im linken Bereich auf Explorer:
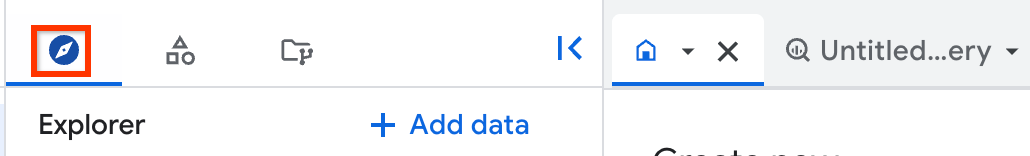
Wenn der linke Bereich nicht angezeigt wird, klicken Sie auf Linken Bereich maximieren, um ihn zu öffnen.
Maximieren Sie im Bereich Explorer den Namen Ihres Projekts und klicken Sie dann auf Verbindungen.
Klicken Sie auf der Seite Verbindungen auf Verbindung erstellen.
Wählen Sie als Verbindungstyp die Option Vertex AI-Remote-Modelle, Remote-Funktionen, BigLake und Cloud Spanner (Cloud-Ressource) aus.
Geben Sie im Feld Verbindungs-ID einen Namen für die Verbindung ein.
Wählen Sie unter Standorttyp einen Standort für die Verbindung aus. Die Verbindung sollte sich am selben Ort wie Ihre anderen Ressourcen, z. B. Datasets, befinden.
Klicken Sie auf Verbindung erstellen.
Klicken Sie auf Zur Verbindung.
Kopieren Sie im Bereich Verbindungsinformationen die Dienstkonto-ID zur Verwendung in einem späteren Schritt.
SQL
Verwenden Sie die Anweisung CREATE CONNECTION:
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Geben Sie im Abfrageeditor die folgende Anweisung ein:
CREATE CONNECTION [IF NOT EXISTS] `CONNECTION_NAME`
OPTIONS (
  connection_type = "CLOUD_RESOURCE",
  friendly_name = "FRIENDLY_NAME",
  description = "DESCRIPTION"
  );
Ersetzen Sie Folgendes:
-
CONNECTION_NAME: der Name der Verbindung im FormatPROJECT_ID.LOCATION.CONNECTION_ID,LOCATION.CONNECTION_IDoderCONNECTION_ID. Wenn das Projekt oder der Standort weggelassen wird, werden sie aus dem Projekt und dem Standort abgeleitet, an dem die Anweisung ausgeführt wird. -
FRIENDLY_NAME(optional): Ein beschreibender Name für die Verbindung. -
DESCRIPTION(optional): Eine Beschreibung der Verbindung.
-
Klicken Sie auf Ausführen.
Informationen zum Ausführen von Abfragen finden Sie unter Interaktive Abfrage ausführen.
bq
Erstellen Sie in einer Befehlszeilenumgebung eine Verbindung:
bq mk --connection --location=REGION --project_id=PROJECT_ID \
    --connection_type=CLOUD_RESOURCE CONNECTION_ID
Der Parameter
--project_idüberschreibt das Standardprojekt.Ersetzen Sie dabei Folgendes:
REGION: Ihre VerbindungsregionPROJECT_ID: Ihre Projekt-ID in Google CloudCONNECTION_ID: eine ID für Ihre Verbindung
Wenn Sie eine Verbindungsressource herstellen, erstellt BigQuery ein eindeutiges Systemdienstkonto und ordnet es der Verbindung zu.
Fehlerbehebung:Wird der folgende Verbindungsfehler angezeigt, aktualisieren Sie das Google Cloud SDK:
Flags parsing error: flag --connection_type=CLOUD_RESOURCE: value should be one of...
Rufen Sie die Dienstkonto-ID ab und kopieren Sie sie zur Verwendung in einem späteren Schritt:
bq show --connection PROJECT_ID.REGION.CONNECTION_ID
Die Ausgabe sieht etwa so aus:
name                          properties
1234.REGION.CONNECTION_ID     {"serviceAccountId": "connection-1234-9u56h9@gcp-sa-bigquery-condel.iam.gserviceaccount.com"}
Python
Informationen zum Installieren und Verwenden der Clientbibliothek für Cloud Spanner finden Sie unter Cloud Spanner-Clientbibliotheken.
Richten Sie zur Authentifizierung bei Cloud Spanner die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Node.js
Informationen zum Installieren und Verwenden der Clientbibliothek für Cloud Spanner finden Sie unter Cloud Spanner-Clientbibliotheken.
Richten Sie zur Authentifizierung bei Cloud Spanner die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Java
Informationen zum Installieren und Verwenden der Clientbibliothek für Cloud Spanner finden Sie unter Cloud Spanner-Clientbibliotheken.
Richten Sie zur Authentifizierung bei Cloud Spanner die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Terraform
Verwenden Sie die Ressource google_bigquery_connection:
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für Clientbibliotheken einrichten.
Im folgenden Beispiel wird eine Cloud-Ressourcenverbindung mit dem Namen my_cloud_resource_connection in der Region US erstellt:
Führen Sie die Schritte in den folgenden Abschnitten aus, um Ihre Terraform-Konfiguration auf ein Google Cloud -Projekt anzuwenden.
Cloud Shell vorbereiten
- Rufen Sie Cloud Shell auf.
-
Legen Sie das Google Cloud -Standardprojekt fest, auf das Sie Ihre Terraform-Konfigurationen anwenden möchten.
Sie müssen diesen Befehl nur einmal pro Projekt und in jedem beliebigen Verzeichnis ausführen.
export GOOGLE_CLOUD_PROJECT=PROJECT_ID
Umgebungsvariablen werden überschrieben, wenn Sie in der Terraform-Konfigurationsdatei explizite Werte festlegen.
Verzeichnis vorbereiten
Jede Terraform-Konfigurationsdatei muss ein eigenes Verzeichnis haben (auch als Stammmodul bezeichnet).
-
Erstellen Sie in Cloud Shell ein Verzeichnis und eine neue Datei in diesem Verzeichnis. Der Dateiname muss die Erweiterung
.tfhaben, z. B.main.tf. In dieser Anleitung wird die Datei alsmain.tfbezeichnet.mkdir DIRECTORY && cd DIRECTORY && touch main.tf
-
Wenn Sie einer Anleitung folgen, können Sie den Beispielcode in jedem Abschnitt oder Schritt kopieren.
Kopieren Sie den Beispielcode in das neu erstellte
main.tf.Kopieren Sie optional den Code aus GitHub. Dies wird empfohlen, wenn das Terraform-Snippet Teil einer End-to-End-Lösung ist.
- Prüfen und ändern Sie die Beispielparameter, die auf Ihre Umgebung angewendet werden sollen.
- Speichern Sie die Änderungen.
-
Initialisieren Sie Terraform. Dies ist nur einmal für jedes Verzeichnis erforderlich.
terraform init
Fügen Sie optional die Option
-upgradeein, um die neueste Google-Anbieterversion zu verwenden:terraform init -upgrade
Änderungen anwenden
-
Prüfen Sie die Konfiguration und prüfen Sie, ob die Ressourcen, die Terraform erstellen oder aktualisieren wird, Ihren Erwartungen entsprechen:
terraform plan
Korrigieren Sie die Konfiguration nach Bedarf.
-
Wenden Sie die Terraform-Konfiguration an. Führen Sie dazu den folgenden Befehl aus und geben Sie
yesan der Eingabeaufforderung ein:terraform apply
Warten Sie, bis Terraform die Meldung „Apply complete“ anzeigt.
- Öffnen Sie Ihr Google Cloud -Projekt, um die Ergebnisse aufzurufen. Rufen Sie in der Google Cloud Console Ihre Ressourcen in der Benutzeroberfläche auf, um sicherzustellen, dass Terraform sie erstellt oder aktualisiert hat.
Öffnen Sie die Verbindung, nachdem Sie sie erstellt haben, und kopieren Sie im Bereich Verbindungsinformationen die Dienstkonto-ID. Sie benötigen diese ID, wenn Sie Berechtigungen für die Verbindung konfigurieren. Wenn Sie eine Verbindungsressource herstellen, erstellt BigQuery ein eindeutiges Systemdienstkonto und ordnet es der Verbindung zu.
Zugriff einrichten
Sie müssen dem Dienstkonto, das mit der neuen Verbindung verknüpft ist, Lesezugriff auf Ihre Spanner-Instanz oder -Datenbank gewähren. Es wird empfohlen, die vordefinierte IAM-Rolle „Cloud Spanner Database Reader with Data Boost“ (roles/spanner.databaseReaderWithDataBoost) zu verwenden.
So gewähren Sie dem Dienstkonto, das Sie zuvor aus der Verbindung kopiert haben, Zugriff auf Rollen auf Datenbankebene:
Rufen Sie die Spanner-Seite Instanzen auf.
Klicken Sie auf den Namen der Instanz, die Ihre Datenbank enthält, um die Seite Instanzdetails aufzurufen.
Klicken Sie auf dem Tab Übersicht das Kästchen der Datenbank an.
Das Infofeld wird angezeigt.Klicken Sie auf Hauptkonto hinzufügen.
Geben Sie im Bereich Hauptkonten hinzufügen unter Neue Hauptkonten die Dienstkonto-ID ein, die Sie zuvor kopiert haben.
Wählen Sie im Feld Rolle auswählen die Option Cloud Spanner Database Reader with DataBoost role aus.
Klicken Sie auf Speichern.
Externes Dataset erstellen
So erstellen Sie ein externes Dataset:
Console
Öffnen Sie in der Google Cloud Console die Seite „BigQuery“.
Klicken Sie im linken Bereich auf Explorer:
Wenn der linke Bereich nicht angezeigt wird, klicken Sie auf Linken Bereich maximieren, um ihn zu öffnen.
Wählen Sie im Bereich Explorer das Projekt aus, in dem Sie das Dataset erstellen möchten.
Klicken Sie auf Aktionen ansehen und dann auf Dataset erstellen.
Führen Sie auf der Seite Dataset erstellen die folgenden Schritte aus:
- Geben Sie für Dataset-ID einen eindeutigen Dataset-Namen ein.
- Wählen Sie unter Standorttyp einen Standort für das Dataset aus, z. B.
us-central1oder die Multiregionus. Nachdem ein Dataset erstellt wurde, kann der Standort nicht mehr geändert werden. Führen Sie für Externes Dataset die folgenden Schritte aus:
- Klicken Sie auf das Kästchen neben Link zu einem externen Dataset.
- Wählen Sie für Typ des externen Datasets die Option
Spanneraus. - Geben Sie unter Externe Quelle die vollständige Kennung Ihrer Spanner-Datenbank im folgenden Format ein:
projects/PROJECT_ID/instances/INSTANCE/databases/DATABASE. Beispiel:projects/my_project/instances/my_instance/databases/my_database. - Geben Sie optional unter Datenbankrolle den Namen einer Spanner-Datenbankrolle ein. Weitere Informationen finden Sie unter Spanner-Verbindungen erstellen.
- Optional können Sie das Kästchen neben Cloud-Ressourcenverbindung verwenden anklicken, um das externe Dataset mit einer Verbindung zu erstellen.
Übernehmen Sie die anderen Einstellungen.
Klicken Sie auf Dataset erstellen.
SQL
Verwenden Sie die Datendefinitionssprachen-Anweisung (DDL) CREATE EXTERNAL SCHEMA.
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Geben Sie im Abfrageeditor die folgende Anweisung ein:
CREATE EXTERNAL SCHEMA DATASET_NAME OPTIONS ( external_source = 'SPANNER_EXTERNAL_SOURCE', location = 'LOCATION'); /* Alternatively, create with a connection: */ CREATE EXTERNAL SCHEMA DATASET_NAME WITH CONNECTION
PROJECT_ID.LOCATION.CONNECTION_NAMEOPTIONS ( external_source = 'SPANNER_EXTERNAL_SOURCE', location = 'LOCATION');Ersetzen Sie Folgendes:
DATASET_NAME: der Name Ihres neuen Datasets in BigQuery.SPANNER_EXTERNAL_SOURCE: der vollständige, qualifizierte Spanner-Datenbankname mit einem Präfix, das die Quelle identifiziert, im folgenden Format:google-cloudspanner://[DATABASE_ROLE@]/projects/PROJECT_ID/instances/INSTANCE/databases/DATABASE. Beispiel:google-cloudspanner://admin@/projects/my_project/instances/my_instance/databases/my_databaseodergoogle-cloudspanner:/projects/my_project/instances/my_instance/databases/my_database.LOCATION: der Standort Ihres neuen Datasets in BigQuery, z. B.us-central1. Nachdem Sie ein Dataset erstellt haben, können Sie seinen Standort nicht mehr ändern.- (Optional)
CONNECTION_NAME: der Name Ihrer Cloud-Ressourcenverbindung.
Klicken Sie auf Ausführen.
Informationen zum Ausführen von Abfragen finden Sie unter Interaktive Abfrage ausführen.
bq
Erstellen Sie in einer Befehlszeilenumgebung mit dem Befehl bq mk ein externes Dataset:
bq --location=LOCATION mk --dataset \
    --external_source SPANNER_EXTERNAL_SOURCE \
    DATASET_NAME
Alternativ können Sie die Tabelle mit einer Verbindung erstellen:
bq --location=LOCATION mk --dataset \
    --external_source SPANNER_EXTERNAL_SOURCE \
    --connection_id PROJECT_ID.LOCATION.CONNECTION_NAME \
    DATASET_NAME
Ersetzen Sie Folgendes:
LOCATION: der Standort Ihres neuen Datasets in BigQuery, z. B.us-central1. Nachdem Sie ein Dataset erstellt haben, können Sie seinen Standort nicht mehr ändern. Mit der Datei.bigqueryrckönnen Sie einen Standardwert für den Standort festlegen.SPANNER_EXTERNAL_SOURCE: der vollständige, qualifizierte Spanner-Datenbankname mit einem Präfix, das die Quelle identifiziert, im folgenden Format:google-cloudspanner://[DATABASE_ROLE@]/projects/PROJECT_ID/instances/INSTANCE/databases/DATABASE. Beispiel:google-cloudspanner://admin@/projects/my_project/instances/my_instance/databases/my_databaseodergoogle-cloudspanner:/projects/my_project/instances/my_instance/databases/my_database.DATASET_NAME: der Name Ihres neuen Datasets in BigQuery. Wenn Sie ein Dataset in einem anderen Projekt als dem Standardprojekt erstellen möchten, fügen Sie die Projekt-ID im FormatPROJECT_ID:DATASET_NAMEdem Dataset-Namen hinzu.- (Optional)
CONNECTION_NAME: der Name Ihrer Cloud-Ressourcenverbindung.
Terraform
Verwenden Sie die Ressource google_bigquery_dataset:
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für Clientbibliotheken einrichten.
Im folgenden Beispiel wird ein externes Spanner-Dataset erstellt:
Führen Sie die Schritte in den folgenden Abschnitten aus, um Ihre Terraform-Konfiguration auf ein Google Cloud -Projekt anzuwenden.
Cloud Shell vorbereiten
- Rufen Sie Cloud Shell auf.
-
Legen Sie das Google Cloud -Standardprojekt fest, auf das Sie Ihre Terraform-Konfigurationen anwenden möchten.
Sie müssen diesen Befehl nur einmal pro Projekt und in jedem beliebigen Verzeichnis ausführen.
export GOOGLE_CLOUD_PROJECT=PROJECT_ID
Umgebungsvariablen werden überschrieben, wenn Sie in der Terraform-Konfigurationsdatei explizite Werte festlegen.
Verzeichnis vorbereiten
Jede Terraform-Konfigurationsdatei muss ein eigenes Verzeichnis haben (auch als Stammmodul bezeichnet).
-
Erstellen Sie in Cloud Shell ein Verzeichnis und eine neue Datei in diesem Verzeichnis. Der Dateiname muss die Erweiterung
.tfhaben, z. B.main.tf. In dieser Anleitung wird die Datei alsmain.tfbezeichnet.mkdir DIRECTORY && cd DIRECTORY && touch main.tf
-
Wenn Sie einer Anleitung folgen, können Sie den Beispielcode in jedem Abschnitt oder Schritt kopieren.
Kopieren Sie den Beispielcode in das neu erstellte
main.tf.Kopieren Sie optional den Code aus GitHub. Dies wird empfohlen, wenn das Terraform-Snippet Teil einer End-to-End-Lösung ist.
- Prüfen und ändern Sie die Beispielparameter, die auf Ihre Umgebung angewendet werden sollen.
- Speichern Sie die Änderungen.
-
Initialisieren Sie Terraform. Dies ist nur einmal für jedes Verzeichnis erforderlich.
terraform init
Fügen Sie optional die Option
-upgradeein, um die neueste Google-Anbieterversion zu verwenden:terraform init -upgrade
Änderungen anwenden
-
Prüfen Sie die Konfiguration und prüfen Sie, ob die Ressourcen, die Terraform erstellen oder aktualisieren wird, Ihren Erwartungen entsprechen:
terraform plan
Korrigieren Sie die Konfiguration nach Bedarf.
-
Wenden Sie die Terraform-Konfiguration an. Führen Sie dazu den folgenden Befehl aus und geben Sie
yesan der Eingabeaufforderung ein:terraform apply
Warten Sie, bis Terraform die Meldung „Apply complete“ anzeigt.
- Öffnen Sie Ihr Google Cloud -Projekt, um die Ergebnisse aufzurufen. Rufen Sie in der Google Cloud Console Ihre Ressourcen in der Benutzeroberfläche auf, um sicherzustellen, dass Terraform sie erstellt oder aktualisiert hat.
API
Rufen Sie die Methode datasets.insert mit einer definierten Dataset-Ressource und dem Feld externalDatasetReference für Ihre Cloud Spanner-Datenbank auf.
Bei den Namen der Tabellen in den externen Datasets wird die Groß-/Kleinschreibung nicht berücksichtigt.
Wenn Sie die externen Datasets mit einer CLOUD_RESOURCE-Verbindung erstellen, benötigen Sie die Berechtigung bigquery.connections.delegate (über die Rolle „BigQuery Connection Admin“ verfügbar) für die Verbindung, die von den externen Datasets verwendet wird.
Nicht inkrementelle materialisierte Ansicht basierend auf Tabellen aus einem externen Dataset erstellen
Bevor Sie fortfahren, müssen Sie das zugrunde liegende externe Spanner-Dataset mit einer CLOUD_RESOURCE-Verbindung erstellen.
Mit der Option allow_non_incremental_definition können Sie nicht inkrementelle materialisierte Ansichten erstellen, die auf externe Spanner-Dataset-Tabellen verweisen.
Im folgenden Beispiel wird eine externe Spanner-Basistabelle verwendet:
/*
  You must create the spanner_external_dataset with a CLOUD_RESOURCE connection.
*/
CREATE MATERIALIZED VIEW sample_dataset.sample_spanner_mv
  OPTIONS (
      enable_refresh = true, refresh_interval_minutes = 60,
      max_staleness = INTERVAL "24" HOUR,
        allow_non_incremental_definition = true)
AS
  SELECT COUNT(*) cnt FROM spanner_external_dataset.spanner_table;
Nur nicht inkrementelle materialisierte BigQuery-Ansichten können Tabellen mit externen Spanner-Datasets als Basistabellen haben.
Wenn die letzte Aktualisierung einer nicht inkrementellen materialisierten Ansicht außerhalb des Intervalls max_staleness erfolgt ist, liest die Abfrage die externen Spanner-Dataset-Basistabellen. Weitere Informationen zu nicht inkrementellen materialisierten Ansichten in BigQuery
Nächste Schritte
- Weitere Informationen zu Data Boost finden Sie in der Data Boost-Übersicht.
- Data Boost in Ihren Anwendungen verwenden
- Data Boost-Nutzung überwachen
- Data Boost-Kontingentnutzung überwachen und verwalten
- Weitere Informationen zu externen Spanner-Datasets
- Weitere Informationen zum Erstellen materialisierter Ansichten für externe Spanner-Datasets