


Questa pagina spiega come utilizzare Spanner Data Boost quando esegui query federate da BigQuery a un database Spanner. Con Data Boost, le query federate vengono eseguite con un impatto minimo sui workload esistenti nell'istanza Spanner di cui è stato eseguito il provisioning. Le query di Data Boost da BigQuery a un database Spanner possono unire i dati di BigQuery ai dati di Spanner.
Puoi eseguire query federate da BigQuery a Spanner utilizzando Data Boost con uno dei seguenti metodi:
- Esegui una query Data Boost federata, che utilizza la funzione di query federata
EXTERNAL_QUERY. - Utilizza Data Boost con set di dati esterni.
La federazione di Spanner consente a BigQuery di eseguire query sui dati archiviati in Spanner in tempo reale, senza copiare o spostare i dati. Per scoprire di più sulle query federate di Spanner, consulta Query federate di Spanner. Per scoprire di più su Data Boost, consulta la panoramica di Data Boost.
Prima di iniziare
Prima di poter eseguire query federate con Data Boost, devi completare le seguenti attività:
Crea un'istanza e un database Spanner
Se non hai un'istanza e un database Spanner, segui i passaggi descritti in Crea ed esegui query su un database utilizzando la console Google Cloud per crearli.
Abilita l'API BigQuery Connection
L'API BigQuery Connection consente di gestire le connessioni BigQuery a origini dati esterne, ad esempio un database Spanner.
Abilita l'API BigQuery Connection, se non è già abilitata.
Ruoli richiesti per abilitare le API
Per abilitare le API, devi disporre dell'autorizzazione
serviceusage.services.enable. Se hai creato il progetto, probabilmente hai già questa autorizzazione tramite il ruolo Proprietario (roles/owner). In caso contrario, puoi ottenere questa autorizzazione tramite il ruolo Amministratore Service Usage (roles/serviceusage.serviceUsageAdmin). Scopri come concedere i ruoli.
Per saperne di più, consulta l'API BigQuery Connection nella documentazione di BigQuery.
Concedi le autorizzazioni IAM per Data Boost alle entità
A un'entità devono essere concesse le seguenti autorizzazioni per eseguire query federate con Data Boost:
spanner.instances.get: consente di ottenere la configurazione di un'istanza.spanner.databases.useDataBoost: consente di utilizzare le risorse di computing di Spanner Data Boost per elaborare le query partizionate.
Per saperne di più sulle autorizzazioni di Spanner, consulta Autorizzazioni di Identity and Access Management (IAM).
Per concedere queste autorizzazioni richieste, ti consigliamo di utilizzare il ruolo IAM Cloud
Spanner Database Reader With DataBoost (roles/spanner.databaseReaderWithDataBoost). Puoi aggiungere questo ruolo a qualsiasi entità che deve eseguire query federate con Data Boost. Per scoprire di più sui ruoli predefiniti in Spanner, consulta Ruoli predefiniti. Per scoprire come creare un ruolo IAM personalizzato, consulta Crea un ruolo personalizzato.
Esegui una query Data Boost federata
Per eseguire una query Data Boost da BigQuery a un'origine esterna, devi disporre di una connessione BigQuery all'origine esterna e dell'ID della connessione. Quando esegui una query Spanner federata con Data Boost, l'origine esterna è un database Spanner. Dopo aver creato l'ID connessione, BigQuery lo utilizza per eseguire una query Data Boost su un database Spanner.
Utilizza una delle seguenti opzioni per creare un ID connessione BigQuery, quindi utilizza l'ID connessione per eseguire una query Data Boost da BigQuery:
Inizia in Spanner: crea l'ID connessione esterna BigQuery nella console Spanner. Dopo aver creato l'ID connessione nella console Spanner, viene eseguito il reindirizzamento alla console BigQuery per eseguire una query federata di Data Boost su un database Spanner.
Inizia in BigQuery: crea l'ID connessione esterna di Data Boost nella console BigQuery o utilizzando lo strumento a riga di comando
bq. Dopo aver creato l'ID connessione, rimani nella console BigQuery per eseguire una query federata di Data Boost su un database Spanner.
Inizia in Spanner per eseguire una query Data Boost
Per eseguire una query federata di Data Boost a partire da Spanner Studio, segui questi passaggi:
Vai alla pagina Istanze di Spanner nella consoleGoogle Cloud .
La console mostra un elenco delle tue istanze Spanner.
Seleziona un'istanza Spanner, quindi un database.
Nella pagina Panoramica del database, nel menu di navigazione, fai clic su Spanner Studio.
Fai clic su Visualizza in BigQuery.
Nella finestra di dialogo Visualizza in BigQuery, inserisci un ID connessione.
L'ID connessione viene utilizzato per creare una nuova connessione esterna BigQuery al tuo database Spanner. Fai riferimento alla connessione esterna utilizzando il seguente pattern:
PROJECT-ID.LOCATION.CONNECTION-IDSe l'ID esiste già, si verifica un errore.
Compila il resto della finestra di dialogo e procedi nel seguente modo:
- Seleziona Leggi i dati in parallelo.
- Seleziona Utilizza Spanner Data Boost.
Fai clic su Visualizza in BigQuery.
BigQuery Studio si apre con la seguente query:
SELECT * FROM EXTERNAL_QUERY("PROJECT-ID.LOCATION.CONNECTION-ID", "SELECT * FROM INFORMATION_SCHEMA.TABLES;");Puoi sostituirlo con la tua query federata. Ad esempio, potresti eseguire una query simile a quella riportata di seguito. Questo esempio esegue una query federata da una tabella denominata
ordersin un database Spanner e unisce i risultati a una tabella BigQuery denominatamydataset.customers.SELECT c.customer_id, c.name, rq.first_order_date FROM mydataset.customers AS c LEFT OUTER JOIN EXTERNAL_QUERY( 'my-project.us.example-db', '''SELECT customer_id, MIN(order_date) AS first_order_date FROM orders GROUP BY customer_id''') AS rq ON rq.customer_id = c.customer_id GROUP BY c.customer_id, c.name, rq.first_order_date;
Inizia in BigQuery per eseguire una query Data Boost
Per creare una connessione dati esterna da BigQuery a un database Spanner e utilizzarla per eseguire una query Data Boost federata da BigQuery, seleziona una delle seguenti opzioni:
Console
Vai a Crea connessioni Spanner nella documentazione di BigQuery e segui le istruzioni nella scheda Console.
Nel riquadro Origine dati esterna, segui questi passaggi:
- Seleziona Leggi i dati in parallelo.
- Seleziona Utilizza Spanner Data Boost.
bq
Vai a Crea connessioni Spanner nella documentazione di BigQuery e segui le istruzioni nella scheda bq*.
Imposta le seguenti proprietà di connessione su
true:useParallelismuseDataBoost
L'esempio seguente utilizza il comando bq
mk per creare una nuova connessione denominata my_connection con le due proprietà richieste per Data Boost:
bq mk --connection --connection_type='CLOUD_SPANNER' --location='us' \
--properties='{"database":"projects/my-project/instances/my-instance/databases/my-database", "useParallelism":true, "useDataBoost": true}' my_connection
Utilizza Data Boost con set di dati esterni
Per eseguire una query Data Boost da BigQuery a Spanner come origine esterna, puoi creare un set di dati esterno (noto anche come set di dati federato) in BigQuery collegato a un database GoogleSQL o PostgreSQL esistente in Spanner.
Utilizza una connessione CLOUD_RESOURCE
Per impostazione predefinita, i set di dati esterni di Spanner utilizzano le credenziali dell'utente finale (EUC), che richiedono agli utenti di avere accesso diretto ai propri database Spanner. Gli utenti possono eseguire query su questi set di dati se dispongono dell'accesso concesso in Spanner.
Facoltativamente, i set di dati esterni di Spanner possono utilizzare una connessione CLOUD_RESOURCE per interagire con il tuo database Spanner, in modo da fornire a un utente l'accesso ai dati di Spanner tramite BigQuery, senza concedergli l'accesso diretto al database Spanner.
Poiché il account di servizio della connessione CLOUD_RESOURCE gestisce il recupero dei dati da Spanner, devi solo concedere agli utenti l'accesso al set di dati esterno Spanner.
Questa delega di accesso separa l'accesso alle tabelle Spanner dai set di dati esterni e l'accesso diretto alle tabelle Spanner sottostanti.
Per connettersi a Spanner viene utilizzata una connessione alle risorse Cloud associata a un account di servizio.
Gli utenti possono eseguire query su queste tabelle Spanner da set di dati esterni anche se non dispongono dell'accesso concesso in Spanner.
Prima di creare set di dati esterni Spanner con una connessione CLOUD_RESOURCE, segui questi passaggi:
Crea una connessione
Puoi creare o utilizzare una connessione CLOUD_RESOURCE esistente per connetterti a Spanner. Assicurati di creare la connessione nella stessa località in cui prevedi di creare il set di dati esterno Spanner.
Console
Vai alla pagina BigQuery.
Nel riquadro a sinistra, fai clic su Explorer:
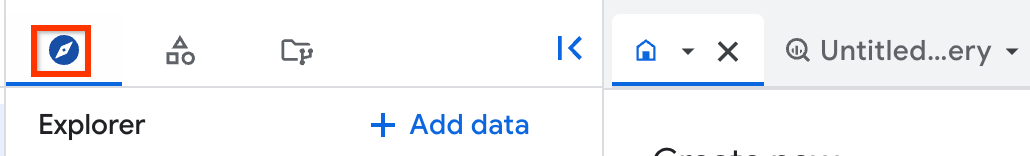
Se non vedi il riquadro a sinistra, fai clic su Espandi riquadro sinistro per aprirlo.
Nel riquadro Explorer, espandi il nome del progetto, quindi fai clic su Connessioni.
Nella pagina Connessioni, fai clic su Crea connessione.
In Tipo di connessione, scegli Modelli remoti di Vertex AI, funzioni remote, BigLake e Spanner (risorsa Cloud).
Nel campo ID connessione, inserisci un nome per la connessione.
In Tipo di località, seleziona una località per la connessione. La connessione deve essere collocata insieme alle altre risorse, ad esempio i set di dati.
Fai clic su Crea connessione.
Fai clic su Vai alla connessione.
Nel riquadro Informazioni sulla connessione, copia l'ID account di servizio da utilizzare in un passaggio successivo.
SQL
Utilizza l'istruzione CREATE CONNECTION:
Nella console Google Cloud , vai alla pagina BigQuery.
Nell'editor di query, inserisci la seguente istruzione:
CREATE CONNECTION [IF NOT EXISTS] `CONNECTION_NAME`
OPTIONS (
  connection_type = "CLOUD_RESOURCE",
  friendly_name = "FRIENDLY_NAME",
  description = "DESCRIPTION"
  );
Sostituisci quanto segue:
-
CONNECTION_NAME: il nome della connessione nel formatoPROJECT_ID.LOCATION.CONNECTION_ID,LOCATION.CONNECTION_IDoCONNECTION_ID. Se il progetto o la località vengono omessi, vengono dedotti dal progetto e dalla località in cui viene eseguita l'istruzione. -
FRIENDLY_NAME(facoltativo): un nome descrittivo per la connessione. -
DESCRIPTION(facoltativo): una descrizione della connessione.
-
Fai clic su Esegui.
Per saperne di più su come eseguire le query, consulta Esegui una query interattiva.
bq
In un ambiente a riga di comando, crea una connessione:
bq mk --connection --location=REGION --project_id=PROJECT_ID \
    --connection_type=CLOUD_RESOURCE CONNECTION_ID
Il parametro
--project_idsostituisce il progetto predefinito.Sostituisci quanto segue:
REGION: la tua regione di connessionePROJECT_ID: il tuo ID progetto Google CloudCONNECTION_ID: un ID per la tua connessione
Quando crei una risorsa di connessione, BigQuery crea un account di servizio di sistema univoco e lo associa alla connessione.
Risoluzione dei problemi: se ricevi il seguente errore di connessione, aggiorna Google Cloud SDK:
Flags parsing error: flag --connection_type=CLOUD_RESOURCE: value should be one of...
Recupera e copia l'ID del account di servizio da utilizzare in un passaggio successivo:
bq show --connection PROJECT_ID.REGION.CONNECTION_ID
L'output è simile al seguente:
name                          properties
1234.REGION.CONNECTION_ID     {"serviceAccountId": "connection-1234-9u56h9@gcp-sa-bigquery-condel.iam.gserviceaccount.com"}
Python
Per scoprire come installare e utilizzare la libreria client per Spanner, consulta Librerie client di Spanner.
Per eseguire l'autenticazione in Spanner, configura le Credenziali predefinite dell'applicazione. Per saperne di più, consulta Configura l'autenticazione per un ambiente di sviluppo locale.
Node.js
Per scoprire come installare e utilizzare la libreria client per Spanner, consulta Librerie client di Spanner.
Per eseguire l'autenticazione in Spanner, configura le Credenziali predefinite dell'applicazione. Per saperne di più, consulta Configura l'autenticazione per un ambiente di sviluppo locale.
Java
Per scoprire come installare e utilizzare la libreria client per Spanner, consulta Librerie client di Spanner.
Per eseguire l'autenticazione in Spanner, configura le Credenziali predefinite dell'applicazione. Per saperne di più, consulta Configura l'autenticazione per un ambiente di sviluppo locale.
Terraform
Utilizza la risorsa google_bigquery_connection.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
L'esempio seguente crea una connessione alle risorse Cloud denominata
my_cloud_resource_connection nella regione US:
Per applicare la configurazione Terraform in un progetto Google Cloud , completa i passaggi descritti nelle sezioni seguenti.
Prepara Cloud Shell
- Avvia Cloud Shell.
-
Imposta il progetto Google Cloud predefinito in cui vuoi applicare le configurazioni Terraform.
Devi eseguire questo comando una sola volta per progetto e puoi eseguirlo in qualsiasi directory.
export GOOGLE_CLOUD_PROJECT=PROJECT_ID
Le variabili di ambiente vengono sostituite se imposti valori espliciti nel file di configurazione Terraform.
Prepara la directory
Ogni file di configurazione Terraform deve avere la propria directory (chiamata anche modulo principale).
-
In Cloud Shell, crea una directory e un nuovo file al suo interno. Il nome file deve avere l'estensione
.tf, ad esempiomain.tf. In questo tutorial, il file è denominatomain.tf.mkdir DIRECTORY && cd DIRECTORY && touch main.tf
-
Se stai seguendo un tutorial, puoi copiare il codice campione in ogni sezione o passaggio.
Copia il codice campione nel file
main.tfappena creato.Facoltativamente, copia il codice da GitHub. Questa opzione è consigliata quando lo snippet Terraform fa parte di una soluzione end-to-end.
- Esamina e modifica i parametri di esempio da applicare al tuo ambiente.
- Salva le modifiche.
-
Inizializza Terraform. Devi eseguire questa operazione una sola volta per directory.
terraform init
Facoltativamente, per utilizzare l'ultima versione del provider Google, includi l'opzione
-upgrade:terraform init -upgrade
Applica le modifiche
-
Esamina la configurazione e verifica che le risorse che Terraform creerà o aggiornerà corrispondano alle tue aspettative:
terraform plan
Apporta le correzioni necessarie alla configurazione.
-
Applica la configurazione Terraform eseguendo il comando seguente e inserendo
yesal prompt:terraform apply
Attendi che Terraform visualizzi il messaggio "Apply complete!".
- Apri il tuo progetto Google Cloud per visualizzare i risultati. Nella console Google Cloud , vai alle risorse nell'interfaccia utente per assicurarti che Terraform le abbia create o aggiornate.
Dopo aver creato la connessione, aprila e, nel riquadro Informazioni sulla connessione, copia l'ID del account di servizio. Questo ID è necessario per configurare le autorizzazioni per la connessione. Quando crei una risorsa di connessione, BigQuery crea un account di servizio di sistema univoco e lo associa alla connessione.
Configura l'accesso
Devi concedere al account di servizio associato alla nuova connessione l'accesso in lettura alla tua istanza o al tuo database Spanner. Ti consigliamo di utilizzare il ruolo IAM predefinito Cloud Spanner Database Reader with Data Boost (roles/spanner.databaseReaderWithDataBoost).
Segui questi passaggi per concedere l'accesso ai ruoli a livello di database per il account di servizio che hai copiato in precedenza dalla connessione:
Vai alla pagina Istanze di Spanner.
Fai clic sul nome dell'istanza che contiene il database per andare alla pagina Dettagli istanza.
Nella scheda Panoramica, seleziona la casella di controllo del tuo database.
Viene visualizzato il riquadro Informazioni.Fai clic su Aggiungi entità.
Nel riquadro Aggiungi entità, in Nuove entità, inserisci l'ID account di servizio che hai copiato in precedenza.
Nel campo Seleziona un ruolo, seleziona Cloud Spanner Database Reader with DataBoost role.
Fai clic su Salva.
Crea un set di dati esterno
Per creare un set di dati esterno:
Console
Apri la pagina BigQuery nella console Google Cloud .
Nel riquadro a sinistra, fai clic su Spazio di esplorazione:
Se non vedi il riquadro a sinistra, fai clic su Espandi riquadro sinistro per aprirlo.
Nel riquadro Explorer, seleziona il progetto in cui vuoi creare il set di dati.
Fai clic su Visualizza azioni, quindi su Crea set di dati.
Nella pagina Crea set di dati, segui questi passaggi:
- In ID set di dati, inserisci un nome univoco per il set di dati.
- In Tipo di località, scegli una località per il set di dati, ad esempio
us-central1o la multi-regioneus. Dopo aver creato un set di dati, la località non può essere modificata. Per Set di dati esterno, segui questi passaggi:
- Seleziona la casella accanto a Link a un set di dati esterno.
- In Tipo di set di dati esterno, seleziona
Spanner. - In Origine esterna, inserisci l'identificatore completo del tuo database Spanner nel seguente formato:
projects/PROJECT_ID/instances/INSTANCE/databases/DATABASE. Ad esempioprojects/my_project/instances/my_instance/databases/my_database. - Facoltativamente, in Ruolo database, inserisci il nome di un ruolo database di Spanner. Per saperne di più, consulta i ruoli del database utilizzati per la creazione di connessioni Spanner
- Facoltativamente, seleziona la casella accanto a Utilizza una connessione alle risorse Cloud per creare il set di dati esterno con una connessione.
Lascia invariate le altre impostazioni predefinite.
Fai clic su Crea set di dati.
SQL
Utilizza l'istruzione DDL (Data Definition Language) CREATE EXTERNAL SCHEMA.
Nella console Google Cloud , vai alla pagina BigQuery.
Nell'editor di query, inserisci la seguente istruzione:
CREATE EXTERNAL SCHEMA DATASET_NAME OPTIONS ( external_source = 'SPANNER_EXTERNAL_SOURCE', location = 'LOCATION'); /* Alternatively, create with a connection: */ CREATE EXTERNAL SCHEMA DATASET_NAME WITH CONNECTION
PROJECT_ID.LOCATION.CONNECTION_NAMEOPTIONS ( external_source = 'SPANNER_EXTERNAL_SOURCE', location = 'LOCATION');Sostituisci quanto segue:
DATASET_NAME: il nome del nuovo set di dati in BigQuery.SPANNER_EXTERNAL_SOURCE: il nome completo del database Spanner, con un prefisso che identifica l'origine, nel seguente formato:google-cloudspanner://[DATABASE_ROLE@]/projects/PROJECT_ID/instances/INSTANCE/databases/DATABASE. Ad esempio:google-cloudspanner://admin@/projects/my_project/instances/my_instance/databases/my_databaseogoogle-cloudspanner:/projects/my_project/instances/my_instance/databases/my_database.LOCATION: la località del nuovo set di dati in BigQuery, ad esempious-central1. Dopo aver creato un set di dati, non puoi modificarne la località.- (Facoltativo)
CONNECTION_NAME: il nome della connessione alle risorse Cloud.
Fai clic su Esegui.
Per saperne di più su come eseguire le query, consulta Esegui una query interattiva.
bq
In un ambiente a riga di comando, crea un set di dati esterno utilizzando il comando bq mk:
bq --location=LOCATION mk --dataset \
    --external_source SPANNER_EXTERNAL_SOURCE \
    DATASET_NAME
In alternativa, crea con una connessione:
bq --location=LOCATION mk --dataset \
    --external_source SPANNER_EXTERNAL_SOURCE \
    --connection_id PROJECT_ID.LOCATION.CONNECTION_NAME \
    DATASET_NAME
Sostituisci quanto segue:
LOCATION: la località del nuovo set di dati in BigQuery, ad esempious-central1. Dopo aver creato un set di dati, non puoi modificarne la località. Puoi impostare un valore predefinito per la località utilizzando il file.bigqueryrc.SPANNER_EXTERNAL_SOURCE: il nome completo del database Spanner, con un prefisso che identifica l'origine, nel seguente formato:google-cloudspanner://[DATABASE_ROLE@]/projects/PROJECT_ID/instances/INSTANCE/databases/DATABASE. Ad esempio:google-cloudspanner://admin@/projects/my_project/instances/my_instance/databases/my_databaseogoogle-cloudspanner:/projects/my_project/instances/my_instance/databases/my_database.DATASET_NAME: il nome del nuovo set di dati in BigQuery. Per creare un set di dati in un progetto diverso da quello predefinito, aggiungi l'ID progetto al nome del set di dati nel seguente formato:PROJECT_ID:DATASET_NAME.- (Facoltativo)
CONNECTION_NAME: il nome della connessione alle risorse Cloud.
Terraform
Utilizza la risorsa google_bigquery_dataset.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
L'esempio seguente crea un set di dati esterno Spanner:
Per applicare la configurazione Terraform in un progetto Google Cloud , completa i passaggi descritti nelle sezioni seguenti.
Prepara Cloud Shell
- Avvia Cloud Shell.
-
Imposta il progetto Google Cloud predefinito in cui vuoi applicare le configurazioni Terraform.
Devi eseguire questo comando una sola volta per progetto e puoi eseguirlo in qualsiasi directory.
export GOOGLE_CLOUD_PROJECT=PROJECT_ID
Le variabili di ambiente vengono sostituite se imposti valori espliciti nel file di configurazione Terraform.
Prepara la directory
Ogni file di configurazione Terraform deve avere la propria directory (chiamata anche modulo principale).
-
In Cloud Shell, crea una directory e un nuovo file al suo interno. Il nome file deve avere l'estensione
.tf, ad esempiomain.tf. In questo tutorial, il file è denominatomain.tf.mkdir DIRECTORY && cd DIRECTORY && touch main.tf
-
Se stai seguendo un tutorial, puoi copiare il codice campione in ogni sezione o passaggio.
Copia il codice campione nel file
main.tfappena creato.Facoltativamente, copia il codice da GitHub. Questa opzione è consigliata quando lo snippet Terraform fa parte di una soluzione end-to-end.
- Esamina e modifica i parametri di esempio da applicare al tuo ambiente.
- Salva le modifiche.
-
Inizializza Terraform. Devi eseguire questa operazione una sola volta per directory.
terraform init
Facoltativamente, per utilizzare l'ultima versione del provider Google, includi l'opzione
-upgrade:terraform init -upgrade
Applica le modifiche
-
Esamina la configurazione e verifica che le risorse che Terraform creerà o aggiornerà corrispondano alle tue aspettative:
terraform plan
Apporta le correzioni necessarie alla configurazione.
-
Applica la configurazione Terraform eseguendo il comando seguente e inserendo
yesal prompt:terraform apply
Attendi che Terraform visualizzi il messaggio "Apply complete!".
- Apri il tuo progetto Google Cloud per visualizzare i risultati. Nella console Google Cloud , vai alle risorse nell'interfaccia utente per assicurarti che Terraform le abbia create o aggiornate.
API
Chiama il metodo datasets.insert con una risorsa del set di dati definita e il campo externalDatasetReference per il tuo database Spanner.
Tieni presente che i nomi delle tabelle nei set di dati esterni non fanno distinzione tra maiuscole e minuscole.
Quando crei i set di dati esterni con una connessione CLOUD_RESOURCE,
devi disporre dell'autorizzazione bigquery.connections.delegate (disponibile nel ruolo Amministratore connessione BigQuery) sulla connessione
utilizzata dai set di dati esterni.
Crea una vista materializzata non incrementale basata su tabelle di un set di dati esterno
Prima di procedere, devi creare il set di dati esterno Spanner sottostante utilizzando una connessione CLOUD_RESOURCE.
Puoi creare viste materializzate non incrementali che fanno riferimento alle tabelle dei set di dati esterni di Spanner utilizzando l'opzione allow_non_incremental_definition.
L'esempio seguente utilizza una tabella di set di dati esterni Spanner di base:
/*
  You must create the spanner_external_dataset with a CLOUD_RESOURCE connection.
*/
CREATE MATERIALIZED VIEW sample_dataset.sample_spanner_mv
  OPTIONS (
      enable_refresh = true, refresh_interval_minutes = 60,
      max_staleness = INTERVAL "24" HOUR,
        allow_non_incremental_definition = true)
AS
  SELECT COUNT(*) cnt FROM spanner_external_dataset.spanner_table;
Solo le viste materializzate non incrementali di BigQuery possono avere tabelle di set di dati esterni di Spanner come tabelle di base.
Se l'ultimo aggiornamento di una vista materializzata non incrementale è avvenuto al di fuori dell'intervallo max_staleness, la query legge le tabelle del set di dati esterno Spanner di base. Scopri di più sulle viste materializzate non incrementali di BigQuery.
Passaggi successivi
- Scopri di più su Data Boost nella panoramica di Data Boost
- Utilizza Data Boost nelle tue applicazioni
- Monitora l'utilizzo di Data Boost
- Monitora e gestisci l'utilizzo della quota di Data Boost
- Scopri di più sul set di dati esterno Spanner.
- Scopri di più sulla creazione di viste materializzate su set di dati esterni di Spanner.