


Cette page décrit et compare deux services Sensitive Data Protection qui vous aident à comprendre vos données et à activer les workflows de gouvernance des données : le service de découverte et le service d'inspection.
Découverte des données sensibles
Le service de découverte surveille les données dans l'ensemble de votre organisation. Ce service s'exécute en continu, et découvre, classe et profile automatiquement les données. La découverte peut vous aider à comprendre l'emplacement et la nature des données que vous stockez, y compris les ressources de données dont vous n'avez peut-être pas connaissance. Les données inconnues (parfois appelées données fantômes) ne sont généralement pas soumises au même niveau de gouvernance des données et de gestion des risques que les données connues.
Vous configurez la découverte à différents niveaux. Vous pouvez définir différentes planifications de profilage pour différents sous-ensembles de vos données. Vous pouvez également exclure les sous-ensembles de données que vous n'avez pas besoin de profiler.
Résultat de l'analyse de découverte : profils de données
Le résultat d'une analyse de découverte est un ensemble de profils de données pour chaque ressource de données du champ d'application. Par exemple, une analyse de découverte des données BigQuery ou Cloud SQL génère des profils de données au niveau du projet, de la table et de la colonne.
Un profil de données contient des métriques et des insights sur la ressource profilée. Il inclut les classifications de données (ou infoTypes), les niveaux de sensibilité, les niveaux de risque des données, la taille des données, la forme des données et d'autres éléments décrivant la nature des données et leur niveau de sécurité (niveau de sécurité des données). Vous pouvez utiliser les profils de données pour prendre des décisions éclairées sur la protection de vos données, par exemple en définissant des règles d'accès sur la table.
Prenons l'exemple d'une colonne BigQuery appelée ccn, où chaque ligne contient un numéro de carte de crédit unique et où il n'y a pas de valeurs nulles. Le profil de données au niveau de la colonne généré contiendra les informations suivantes :
| Nom à afficher | Valeur |
|---|---|
Field ID |
ccn |
Data risk |
High |
Sensitivity |
High |
Data type |
TYPE_STRING |
Policy tags |
No |
Free text score |
0 |
Estimated uniqueness |
High |
Estimated null proportion |
Very low |
Last profile generated |
DATE_TIME |
Predicted infoType |
CREDIT_CARD_NUMBER |
De plus, ce profil au niveau des colonnes fait partie d'un profil au niveau de la table, qui fournit des insights tels que l'emplacement des données, l'état du chiffrement et si la table est partagée publiquement. Dans la console Google Cloud , vous pouvez également afficher les entrées de journal Cloud Logging de la table et les comptes principaux IAM disposant de rôles pour la table.
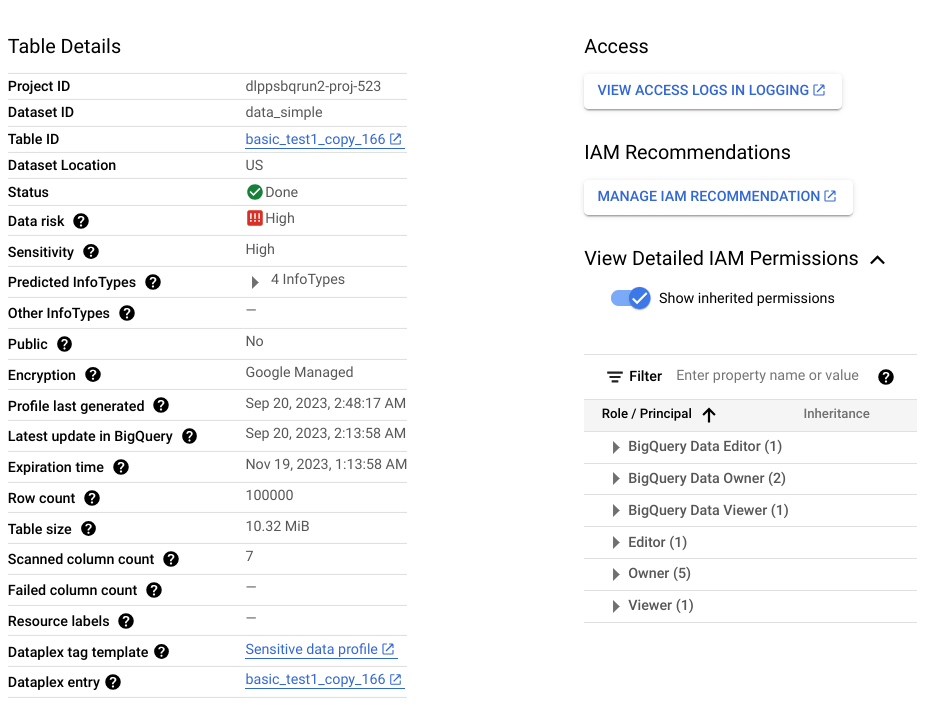
Pour obtenir la liste complète des métriques et des insights disponibles dans les profils de données, consultez la documentation de référence sur les métriques.
Quand utiliser la découverte
Lorsque vous planifiez votre approche de gestion des risques liés aux données, nous vous recommandons de commencer par la découverte. Le service de découverte vous aide à obtenir une vue d'ensemble de vos données et à activer les alertes, les rapports et la correction des problèmes.
Voici quelques cas d'utilisation courants :
- Bénéficiez d'une visibilité étendue sur les environnements cloud : analysez et profilez en continu tous les éléments de données d'une organisation, d'un dossier ou d'un projet sans créer de jobs d'analyse individuels.
- Découvrez les données fantômes et les dépôts non gérés : détectez les tables et les buckets nouvellement créés ou non classés qui ne disposent pas d'une gouvernance ou de contrôles d'accès appropriés.
- Hiérarchisez les initiatives de sécurité grâce au scoring de risque : concentrez les ressources de correction et de protection sur les dépôts de données identifiés comme présentant une sensibilité élevée et des scores de risque de données élevés.
- Identifier les candidats à une inspection approfondie : identifiez les tables et les buckets de stockage présentant des scores de texte libre élevés contenant des commentaires ou des avis non structurés qui nécessitent une analyse précise.
Inspection des données sensibles
Le service d'inspection effectue une analyse exhaustive d'une seule ressource pour localiser chaque instance de données sensibles. Une inspection produit un résultat pour chaque instance détectée.
Les jobs d'inspection fournissent un ensemble complet d'options de configuration pour vous aider à identifier les données que vous souhaitez inspecter. Par exemple, vous pouvez activer l'échantillonnage pour limiter les données à inspecter à un certain nombre de lignes (pour les données BigQuery) ou à certains types de fichiers (pour les données Cloud Storage). Vous pouvez également cibler une période spécifique au cours de laquelle les données ont été créées ou modifiées.
Contrairement à la découverte, qui surveille vos données en continu, l'inspection est une opération à la demande. Toutefois, vous pouvez planifier des jobs d'inspection récurrents appelés déclencheurs de jobs.
Résultat de l'analyse d'inspection : résultats
Chaque résultat inclut des détails tels que l'emplacement de l'instance détectée, son infoType potentiel et la certitude (également appelée probabilité) que le résultat correspond à l'infoType. Selon vos paramètres, vous pouvez également obtenir la chaîne réelle à laquelle se rapporte le résultat. Cette chaîne est appelée citation dans Sensitive Data Protection.
Pour obtenir la liste complète des détails inclus dans un résultat d'inspection, consultez Finding.
Quand utiliser l'inspection
Voici quelques cas d'utilisation courants :
- Analyser du texte non structuré et des champs de texte libre : localisez chaque instance spécifique d'informations permettant d'identifier personnellement l'utilisateur dans les commentaires des clients, les formulaires de commentaires, les demandes d'assistance et les dépôts de documents.
- Effectuer des audits de conformité à un moment précis sur une seule ressource : générez un rapport de résultats détaillé enregistrant les emplacements exacts des octets et des lignes de tous les éléments sensibles dans une table ou un bucket ciblé.
- Inspecter les flux de données hybrides et multicloud : diffusez des charges utiles directement à partir de serveurs sur site, de pipelines ETL ou de clouds externes pour générer des rapports de résultats centralisés dans Google Cloud.
- Déclenchez des workflows automatisés de mise en quarantaine et d'alerte : publiez les résultats détectés dans Pub/Sub ou enregistrez-les directement dans des tables BigQuery pour effectuer une correction basée sur les événements.
Quand ne pas utiliser l'inspection
L'inspection d'une ressource n'est pas utile si les deux conditions suivantes s'appliquent. Une analyse de découverte peut vous aider à décider si une analyse d'inspection est nécessaire.
- La ressource ne contient que des données structurées. Autrement dit, il n'y a pas de colonnes de données de forme libre, comme des commentaires ou des avis d'utilisateurs.
- Vous connaissez déjà les infoTypes stockés dans cette ressource.
Par exemple, supposons que les profils de données d'une analyse de découverte indiquent qu'une table BigQuery ne comporte pas de colonnes contenant des données non structurées, mais qu'elle comporte une colonne de numéros de carte de crédit uniques. Dans ce cas, il n'est pas utile d'inspecter la table pour rechercher des numéros de carte de crédit. Une inspection génère un résultat pour chaque élément de la colonne. Si vous avez un million de lignes et que chaque ligne contient un numéro de carte de crédit, un job d'inspection produira un million de résultats pour l'infoType CREDIT_CARD_NUMBER. Dans cet exemple, l'inspection n'est pas nécessaire, car l'analyse de découverte indique déjà que la colonne contient des numéros de carte de crédit uniques.
Résidence, traitement et stockage des données
La découverte et l'inspection sont toutes deux compatibles avec les exigences de résidence des données :
- Le service de découverte traite vos données là où elles se trouvent et stocke les profils de données générés dans la même région ou zone multirégionale que les données profilées. Pour en savoir plus, consultez Considérations relatives à la résidence des données.
- Lors de l'inspection des données dans un système de stockage Google Cloud , le service d'inspection traite vos données dans la région où elles se trouvent et stocke le job d'inspection dans cette région. Lorsque vous inspectez des données via un job hybride ou une méthode
content, le service d'inspection vous permet de spécifier l'emplacement où il doit traiter vos données. Pour en savoir plus, consultez Comment les données sont stockées.
Résumé de la comparaison : services de découverte et d'inspection
| Discovery | Inspection | |
|---|---|---|
| Avantages |
|
|
| Coût |
10 To coûtent environ 300 USD par mois en mode Consommation. |
10 To coûtent environ 10 000 USD par analyse. |
| Sources de données prises en charge | BigLake BigQuery Variables d'environnement des fonctions Cloud Run Variables d'environnement de révision du service Cloud Run Cloud SQL Cloud Storage Vertex AI Amazon S3 Azure Blob Storage |
BigQuery Cloud Storage Datastore Hybride (toutes sources)1 |
| Champs d'application compatibles |
|
Une seule table BigQuery, un seul bucket Cloud Storage ou un seul genre Datastore. |
| Modèles d'inspection intégrés | Oui | Oui |
| InfoTypes intégrés et personnalisés | Oui | Oui |
| Résultat de l'analyse | Aperçu général (profils de données) de toutes les données compatibles. | Identification concrète de données sensibles dans la ressource inspectée. |
| Enregistrer les résultats dans BigQuery | Oui | Oui |
| Envoyer à Knowledge Catalog sous forme d'aspects | Oui | Non |
| Publier les résultats dans Security Command Center | Oui | Oui |
| Publier les résultats dans Google Security Operations | Oui pour la découverte au niveau de l'organisation et du dossier | Non |
| Publier dans Pub/Sub | Oui | Oui |
| Compatibilité avec la résidence des données | Oui | Oui |
1 L'inspection hybride utilise un modèle de tarification différent. Pour en savoir plus, consultez Inspection des données provenant de n'importe quelle source .
Étapes suivantes
- Découvrez les stratégies recommandées pour limiter les risques liés aux données (document suivant de cette série).