


本页面介绍并比较了两种 Sensitive Data Protection 服务,它们可帮助您了解数据并启用数据治理工作流:发现服务和检查服务。
敏感数据发现
发现服务会监控整个组织的数据。 此服务会持续运行,并自动发现、分类和分析数据。发现功能可帮助您了解所存储数据的位置和性质,包括您可能不知道的数据资源。未知数据(有时称为影子数据)通常不会像已知数据那样接受相同级别的数据治理和风险管理。
您可以在各种范围内配置发现。您可以为不同的数据子集设置不同的分析时间表。您还可以排除不需要分析的数据子集。
发现服务扫描输出:数据分析
发现扫描的输出是范围内每个数据资源的一组数据分析。例如,对 BigQuery 或 Cloud SQL 数据进行发现扫描会在项目、表和列级别生成数据分析。
数据分析文件包含有关所分析资源的指标和数据分析。它包括数据分类(或 infoType)、敏感度级别、数据风险级别、数据大小、数据形状以及描述数据性质及其数据安全状况(数据的安全性)的其他元素。您可以使用数据分析来做出有关如何保护数据的明智决策,例如在表上设置访问权限政策。
假设有一个名为 ccn 的 BigQuery 列,其中每行都包含一个唯一的信用卡号,并且没有 null 值。生成的列级数据剖析文件将包含以下详细信息:
| 显示名称 | 值 |
|---|---|
Field ID |
ccn |
Data risk |
High |
Sensitivity |
High |
Data type |
TYPE_STRING |
Policy tags |
No |
Free text score |
0 |
Estimated uniqueness |
High |
Estimated null proportion |
Very low |
Last profile generated |
DATE_TIME |
Predicted infoType |
CREDIT_CARD_NUMBER |
此外,此列级分析是表级分析的一部分,可提供数据位置、加密状态以及表是否公开共享等数据洞见。在 Google Cloud 控制台中,您还可以查看表的 Cloud Logging 日志条目以及具有表角色的 IAM 主账号。
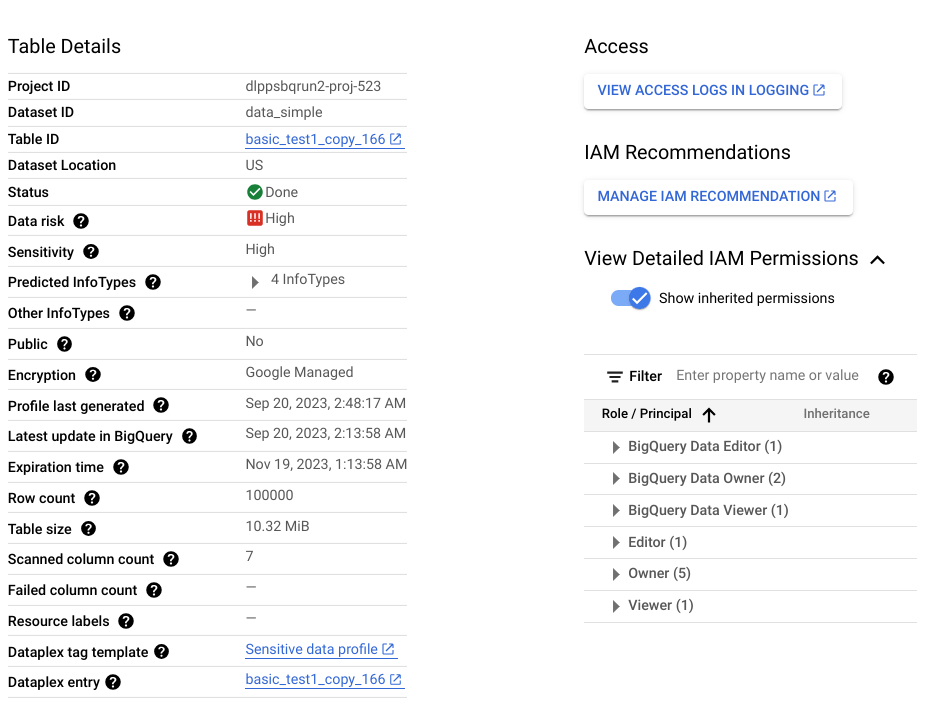
如需查看数据分析中提供的指标和数据分析的完整列表,请参阅指标参考。
何时使用发现
在规划数据风险管理方法时,我们建议您从发现开始。发现服务可帮助您全面了解数据,并启用提醒、报告和问题修复。
以下是一些常见使用场景:
- 在云环境中获得广泛的可见性:持续扫描和分析组织、文件夹或项目中的所有数据资产,而无需创建单独的扫描作业。
- 发现影子数据和非托管代码库:检测新创建或未分类的表和存储桶,这些表和存储桶缺乏适当的治理或访问权限控制。
- 通过风险评分确定安全措施的优先级:将修复和保护资源集中在已识别为高敏感度和高数据风险评分的数据存储库上。
- 确定深度检查对象:确定自由文本得分较高、包含需要精细扫描的非结构化评论或评价的表和存储桶。
敏感数据检查
检查服务会对单个资源进行全面扫描,以找到敏感数据的每个实例。检查会为每个检测到的实例生成一个发现结果。
检查作业提供了一组丰富的配置选项,可帮助您精确定位要检查的数据。例如,您可以开启抽样,将要检查的数据限制为特定行数(对于 BigQuery 数据)或特定文件类型(对于 Cloud Storage 数据)。您还可以针对创建或修改数据的特定时间段。
与持续监控数据的发现功能不同,检查是一项按需操作。不过,您可以安排周期性检查作业(称为作业触发器)。
检查扫描输出:发现结果
每个发现结果都包含一些详细信息,例如检测到的实例的位置、其潜在 infoType,以及发现结果与 infoType 匹配的确定性(也称为可能性)。根据您的设置,您还可以获取发现结果所涉及的实际字符串;此字符串在 Sensitive Data Protection 中称为引用。
如需查看检查发现结果中包含的详细信息的完整列表,请参阅 Finding。
何时使用检查
以下是一些常见使用场景:
- 扫描非结构化文本和自由格式字段:在客户评论、反馈表单、支持服务工单和文档库中查找每个特定的个人身份信息 (PII) 实例。
- 对单个资源执行时间点合规性审核:生成详细的发现结果报告,记录目标表或存储桶中所有敏感项的确切字节和行位置。
- 检查混合云和多云数据流:直接从本地服务器、ETL 流水线或外部云流式传输载荷,以在 Google Cloud中生成集中式发现结果报告。
- 触发自动隔离和提醒工作流:将检测到的发现结果发布到 Pub/Sub,或直接保存到 BigQuery 表中,以推动事件驱动型修复。
何时不应使用检查
如果同时满足以下两个条件,则检查资源没有用。 发现扫描可帮助您确定是否需要进行检查扫描。
- 资源中只有结构化数据。也就是说,没有自由格式数据的列,例如用户评论或评价。
- 您已经知道该资源中存储的 infoType。
例如,假设发现扫描的数据分析结果表明,某个 BigQuery 表没有包含非结构化数据的列,但有一列包含唯一的信用卡号。在这种情况下,检查表中的信用卡号没有用。检查将为列中的每个项生成一个发现结果。如果您有 100 万行,并且每行包含 1 个信用卡号,则检查作业将为 CREDIT_CARD_NUMBER infoType 生成 100 万个发现结果。在此示例中,不需要进行检查,因为发现扫描已表明该列包含唯一的信用卡号。
数据驻留、处理和存储
发现和检查都支持数据驻留要求:
- 发现服务会在数据所在的位置处理数据,并将生成的数据分析文件存储在与所分析数据相同的区域或多区域中。如需了解详情,请参阅数据驻留注意事项。
- 在检查 Google Cloud 存储系统中的数据时,检查服务会在数据驻留所在的同一区域处理数据,并将检查作业存储在该区域。通过混合作业或
content方法检查数据时,检查服务可让您指定应在何处处理数据。如需了解详情,请参阅数据的存储方式。
比较摘要:发现和检查服务
| 发现 | 检查 | |
|---|---|---|
| 优势 |
|
|
| 费用 |
用量模式下,10 TB 的费用约为每月 300 美元。 |
如果是 10 TB,费用大约为每次扫描 10,000 美元。 |
| 支持的数据源 | BigLake BigQuery Cloud Run functions 环境变量 Cloud Run 服务修订版本环境变量 Cloud SQL Cloud Storage Vertex AI Amazon S3 Azure Blob Storage |
BigQuery Cloud Storage Datastore 混合(任何来源)1 |
| 支持的作用域 |
|
单个 BigQuery 表、Cloud Storage 存储桶或 Datastore 种类。 |
| 内置检查模板 | 是 | 是 |
| 内置和自定义 infoType | 是 | 是 |
| 扫描输出 | 所有受支持数据的简要概览(数据分析)。 | 所检查资源中敏感数据的具体发现结果。 |
| 将结果保存到 BigQuery | 是 | 是 |
| 以切面形式发送到 Knowledge Catalog | 是 | 否 |
| 将结果发布到 Security Command Center | 是 | 是 |
| 将发现结果发布到 Google Security Operations | 是,适用于组织级和文件夹级发现 | 否 |
| 发布到 Pub/Sub | 是 | 是 |
| 数据驻留支持 | 是 | 是 |
1 混合检查采用不同的价格模式。如需了解详情,请参阅检查来自任意来源的数据 。
后续步骤
- 探索降低数据风险的建议策略(本系列的下一个文档)