


Auf dieser Seite werden zwei Sensitive Data Protection-Dienste beschrieben und verglichen, mit denen Sie Ihre Daten analysieren und Workflows zur Datenverwaltung aktivieren können: der Erkennungsdienst und der Prüfdienst.
Auffinden sensibler Daten
Der Erkennungsdienst überwacht Daten in Ihrer gesamten Organisation. Dieser Dienst wird kontinuierlich ausgeführt und erkennt, klassifiziert und profiliert Daten automatisch. Mit Discovery können Sie den Speicherort und die Art der Daten, die Sie speichern, nachvollziehen. Das gilt auch für Datenressourcen, die Ihnen möglicherweise nicht bekannt sind. Unbekannte Daten (manchmal auch als Schatten-Daten bezeichnet) unterliegen in der Regel nicht dem gleichen Grad an Data Governance und Risikomanagement wie bekannte Daten.
Die Erkennung wird auf verschiedenen Ebenen konfiguriert. Sie können für verschiedene Teilmengen Ihrer Daten unterschiedliche Profilerstellungszeitpläne festlegen. Sie können auch Teilmengen von Daten ausschließen, die Sie nicht analysieren müssen.
Ausgabe des Erkennungsscans: Datenprofile
Die Ausgabe eines Discovery-Scans ist eine Reihe von Datenprofilen für jede Datenressource im Geltungsbereich. Bei einem Erkennungsscan von BigQuery- oder Cloud SQL-Daten werden beispielsweise Datenprofile auf Projekt-, Tabellen- und Spaltenebene generiert.
Ein Datenprofil enthält Messwerte und Statistiken zur Ressource, für die ein Profil erstellt wurde. Dazu gehören die Datenklassifizierungen (oder infoTypes), Vertraulichkeitsstufen, Datenrisikostufen, Datengröße, Datenform und andere Elemente, die die Art der Daten und ihre Datensicherheit (wie sicher die Daten sind) beschreiben. Mithilfe von Datenprofilen können Sie fundierte Entscheidungen darüber treffen, wie Sie Ihre Daten schützen, z. B. durch Festlegen von Zugriffsrichtlinien für die Tabelle.
Angenommen, es gibt eine BigQuery-Spalte mit dem Namen ccn, in der jede Zeile eine eindeutige Kartennummer enthält und es keine Nullwerte gibt. Das generierte Datenprofil auf Spaltenebene enthält die folgenden Details:
| Anzeigename | Wert |
|---|---|
Field ID |
ccn |
Data risk |
High |
Sensitivity |
High |
Data type |
TYPE_STRING |
Policy tags |
No |
Free text score |
0 |
Estimated uniqueness |
High |
Estimated null proportion |
Very low |
Last profile generated |
DATE_TIME |
Predicted infoType |
CREDIT_CARD_NUMBER |
Außerdem ist dieses Profil auf Spaltenebene Teil eines Profils auf Tabellenebene, das Informationen wie den Datenspeicherort, den Verschlüsselungsstatus und die Frage enthält, ob die Tabelle öffentlich freigegeben ist. In der Google Cloud -Console können Sie auch die Cloud Logging-Einträge für die Tabelle und die IAM-Hauptkonten mit Rollen für die Tabelle ansehen.
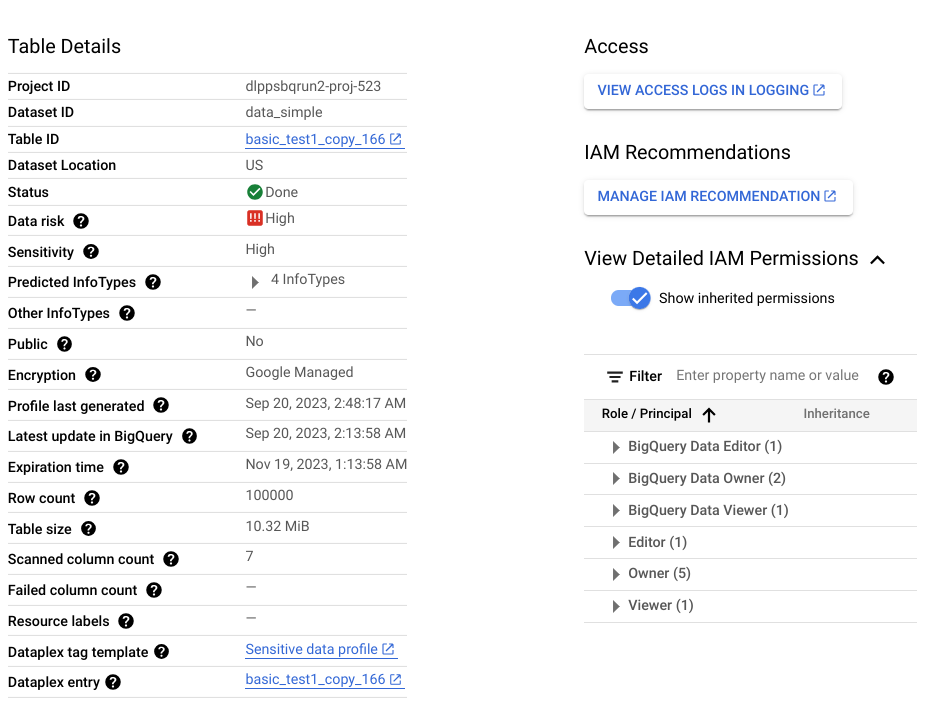
Eine vollständige Liste der in Datenprofilen verfügbaren Messwerte und Statistiken finden Sie in der Messwertreferenz.
Wann sollte Discovery verwendet werden?
Wenn Sie Ihren Ansatz für das Datenrisikomanagement planen, empfehlen wir, mit der Ermittlung zu beginnen. Der Ermittlungsdienst bietet Ihnen einen umfassenden Überblick über Ihre Daten und ermöglicht Benachrichtigungen, Berichte und die Behebung von Problemen.
Im Folgenden sind einige gängige Anwendungsfälle aufgeführt:
- Umfassende Sichtbarkeit über Cloud-Umgebungen: Scannen und profilieren Sie alle Daten-Assets in einer Organisation, einem Ordner oder einem Projekt kontinuierlich, ohne einzelne Scanjobs erstellen zu müssen.
- Schatten- und nicht verwaltete Datenquellen aufdecken: Erkennen Sie neu erstellte oder nicht klassifizierte Tabellen und Buckets, die nicht ordnungsgemäß verwaltet werden oder keine Zugriffssteuerung haben.
- Sicherheitsinitiativen mit Risikobewertung priorisieren: Konzentrieren Sie die Ressourcen für die Behebung und den Schutz auf Datenrepositories mit hoher Vertraulichkeit und hohen Datenrisikobewertungen.
- Kandidaten für die detaillierte Prüfung identifizieren: Suchen Sie nach Tabellen und Speicher-Buckets mit hohen Freitext-Werten, die unstrukturierte Kommentare oder Rezensionen enthalten, die eine detaillierte Prüfung erfordern.
Prüfung sensibler Daten
Der Inspektionsdienst führt einen umfassenden Scan einer einzelnen Ressource durch, um jedes einzelne Vorkommen sensibler Daten zu finden. Bei einer Prüfung wird für jede erkannte Instanz ein Ergebnis generiert.
Inspektionsjobs bieten eine Vielzahl von Konfigurationsoptionen, mit denen Sie die zu prüfenden Daten genau festlegen können. Sie können beispielsweise Stichproben aktivieren, um die zu untersuchenden Daten auf eine bestimmte Anzahl von Zeilen (für BigQuery-Daten) oder bestimmte Dateitypen (für Cloud Storage-Daten) zu beschränken. Sie können auch einen bestimmten Zeitraum festlegen, in dem die Daten erstellt oder geändert wurden.
Im Gegensatz zur Ermittlung, bei der Ihre Daten kontinuierlich überwacht werden, ist die Überprüfung ein On-Demand-Vorgang. Sie können jedoch wiederkehrende Inspektionsjobs planen, die als Job-Trigger bezeichnet werden.
Ausgabe des Prüfscans: Ergebnisse
Jedes Ergebnis enthält Details wie den Speicherort der erkannten Instanz, den potenziellen infoType und die Wahrscheinlichkeit (auch Wahrscheinlichkeit genannt), dass das Ergebnis mit dem infoType übereinstimmt. Je nach Ihren Einstellungen können Sie auch den tatsächlichen String abrufen, auf den sich das Ergebnis bezieht. Dieser String wird in Sensitive Data Protection als Zitat bezeichnet.
Eine vollständige Liste der Details, die in einem Inspektionsergebnis enthalten sind, finden Sie unter Finding.
Wann sollte die Überprüfung verwendet werden?
Im Folgenden sind einige gängige Anwendungsfälle aufgeführt:
- Unstrukturierten Text und Freiformfelder scannen: Finden Sie jede spezifische Instanz von personenidentifizierbaren Informationen in Kundenkommentaren, Feedbackformularen, Supporttickets und Dokumentarchiven.
- Compliance-Audits zu einem bestimmten Zeitpunkt für eine einzelne Ressource durchführen: Generieren Sie einen detaillierten Ergebnisbericht, in dem die genauen Byte- und Zeilenpositionen aller vertraulichen Elemente in einer Zieltabellen oder einem Ziel-Bucket aufgezeichnet werden.
- Hybride und Multi-Cloud-Datenstreams prüfen: Stream-Nutzlasten direkt von lokalen Servern, ETL-Pipelines oder externen Clouds streamen, um zentralisierte Ergebnisberichte in Google Cloudzu erstellen.
- Automatisierte Quarantäne- und Benachrichtigungsworkflows auslösen: Veröffentlichen Sie erkannte Ergebnisse in Pub/Sub oder speichern Sie sie direkt in BigQuery-Tabellen, um ereignisgesteuerte Korrekturen zu ermöglichen.
Wann sollte die Überprüfung nicht verwendet werden?
Die Untersuchung einer Ressource ist nicht sinnvoll, wenn die beiden folgenden Bedingungen zutreffen. Ein Erkennungsscan kann Ihnen helfen, zu entscheiden, ob ein Prüfscan erforderlich ist.
- Die Ressource enthält nur strukturierte Daten. Es gibt also keine Spalten mit Freiformdaten wie Nutzerkommentare oder Rezensionen.
- Sie kennen die in dieser Ressource gespeicherten infoTypes bereits.
Angenommen, Datenprofile aus einem Erkennungsscan weisen darauf hin, dass eine bestimmte BigQuery-Tabelle keine Spalten mit unstrukturierten Daten, aber eine Spalte mit eindeutigen Kreditkartennummern enthält. In diesem Fall ist es nicht sinnvoll, die Tabelle nach Kreditkartennummern zu durchsuchen. Bei einer Überprüfung wird für jedes Element in der Spalte ein Ergebnis generiert. Wenn Sie 1 Million Zeilen haben und jede Zeile eine Kreditkartennummer enthält, werden bei einem Inspektionsjob 1 Million Ergebnisse für den infoType CREDIT_CARD_NUMBER generiert. In diesem Beispiel ist die Prüfung nicht erforderlich, da der Discovery-Scan bereits darauf hinweist, dass die Spalte eindeutige Kreditkartennummern enthält.
Datenstandort, ‑verarbeitung und ‑speicherung
Sowohl die Erkennung als auch die Überprüfung unterstützen die Anforderungen an den Datenstandort:
- Der Dienst zur Erkennung sensibler Daten verarbeitet Ihre Daten dort, wo sie sich befinden, und speichert die generierten Datenprofile in derselben Region oder Multi-Region wie die profilierten Daten. Weitere Informationen finden Sie unter Überlegungen zum Datenstandort.
- Wenn Daten in einem Google Cloud -Speichersystem geprüft werden, verarbeitet der Prüfdienst Ihre Daten in derselben Region, in der sich die Daten befinden, und speichert den Prüfjob in dieser Region. Wenn Sie Daten mit einem Hybridjob oder einer
content-Methode prüfen, können Sie mit dem Prüfdienst angeben, wo Ihre Daten verarbeitet werden sollen. Weitere Informationen finden Sie unter So werden Daten gespeichert.
Zusammenfassung des Vergleichs: Ermittlungs- und Prüfdienste
| Discovery | Prüfung | |
|---|---|---|
| Vorteile |
|
|
| Kosten |
10 TB kosten im Verbrauchsmodus etwa 300 $ pro Monat. |
10 TB kosten ca. 10.000 $ pro Scan. |
| Unterstützte Datenquellen | BigLake BigQuery Umgebungsvariablen für Cloud Run-Funktionen Umgebungsvariablen für Cloud Run-Dienstrevisionen Cloud SQL Cloud Storage Vertex AI Amazon S3 Azure Blob Storage |
BigQuery Cloud Storage Datastore Hybrid (beliebige Quelle)1 |
| Unterstützte Bereiche |
|
Eine einzelne BigQuery-Tabelle, ein Cloud Storage-Bucket oder eine Datastore-Art. |
| Integrierte Inspektionsvorlagen | Ja | Ja |
| Integrierte und benutzerdefinierte infoTypes | Ja | Ja |
| Scanausgabe | Gesamtübersicht (Datenprofile) über alle unterstützten Daten. | Konkret ermittelte sensible Daten in der geprüften Ressource. |
| Ergebnisse in BigQuery speichern | Ja | Ja |
| Als Tags an Knowledge Catalog senden (eingestellt) | Ja | Ja |
| Als Aspekte an Knowledge Catalog senden | Ja | Nein |
| Ergebnisse in Security Command Center veröffentlichen | Ja | Ja |
| Ergebnisse in Google Security Operations veröffentlichen | Ja für die Suche auf Organisations- und Ordnerebene | Nein |
| In Pub/Sub veröffentlichen | Ja | Ja |
| Unterstützung für den Datenstandort | Ja | Ja |
1 Für die Hybrid-Inspektion gilt ein anderes Preismodell. Weitere Informationen finden Sie unter Prüfung von Daten aus beliebigen Quellen .
Nächste Schritte
- Empfohlene Strategien zur Minimierung des Datenrisikos (nächstes Dokument in dieser Reihe)