


このページでは、データの理解とデータ ガバナンス ワークフローの実現に役立つ 2 つの Sensitive Data Protection サービス(検出サービスと検査サービス)について説明し、比較します。
機密データの検出
検出サービスは、組織全体のデータをモニタリングします。このサービスは継続的に実行され、データの検出、分類、プロファイリングが自動的に行われます。検出は、保存しているデータの場所と性質(認識していないデータリソースなど)を把握するのに役立ちます。未知のデータ(シャドウデータとも呼ばれる)には、通常、既知のデータと同じレベルのデータ ガバナンスやリスク管理は適用されません。
検出はさまざまなスコープで構成します。データのサブセットごとに異なるプロファイリング スケジュールを設定できます。プロファイリングが不要なデータのサブセットを除外することもできます。
検出スキャンの出力: データ プロファイル
検出スキャンの出力は、スコープ内の各データリソースに対するデータ プロファイルのセットです。たとえば、BigQuery または Cloud SQL データの検出スキャンにより、プロジェクト レベル、テーブルレベル、列レベルでデータ プロファイルが生成されます。
データ プロファイルには、プロファイリングされたリソースに関する指標と分析情報が含まれます。データ プロファイルには、データ分類(または infoTypes)、機密性レベル、データリスク レベル、データサイズ、データ形状、およびデータの性質とそのデータ セキュリティ ポスチャー(データの安全性)を記述するその他の要素が含まれます。データ プロファイルを使用すると、データの保護方法(テーブルへのアクセス ポリシーの設定など)に関して情報に基づいた意思決定が可能となります。
ccn という BigQuery 列について考えてみましょう。各行には一意のクレジット カード番号が含まれており、null 値はありません。生成された列レベルのデータ プロファイルの詳細は、次のようになります。
| 表示名 | 値 |
|---|---|
Field ID |
ccn |
Data risk |
High |
Sensitivity |
High |
Data type |
TYPE_STRING |
Policy tags |
No |
Free text score |
0 |
Estimated uniqueness |
High |
Estimated null proportion |
Very low |
Last profile generated |
DATE_TIME |
Predicted infoType |
CREDIT_CARD_NUMBER |
また、この列レベルのプロファイルはテーブルレベルのプロファイルの一部であり、データの場所、暗号化ステータス、テーブルが一般公開されているかどうかなどの分析情報を提供します。 Google Cloud コンソールでは、テーブルの Cloud Logging ログエントリと、テーブルに対するロールがある IAM プリンシパルを表示することもできます。
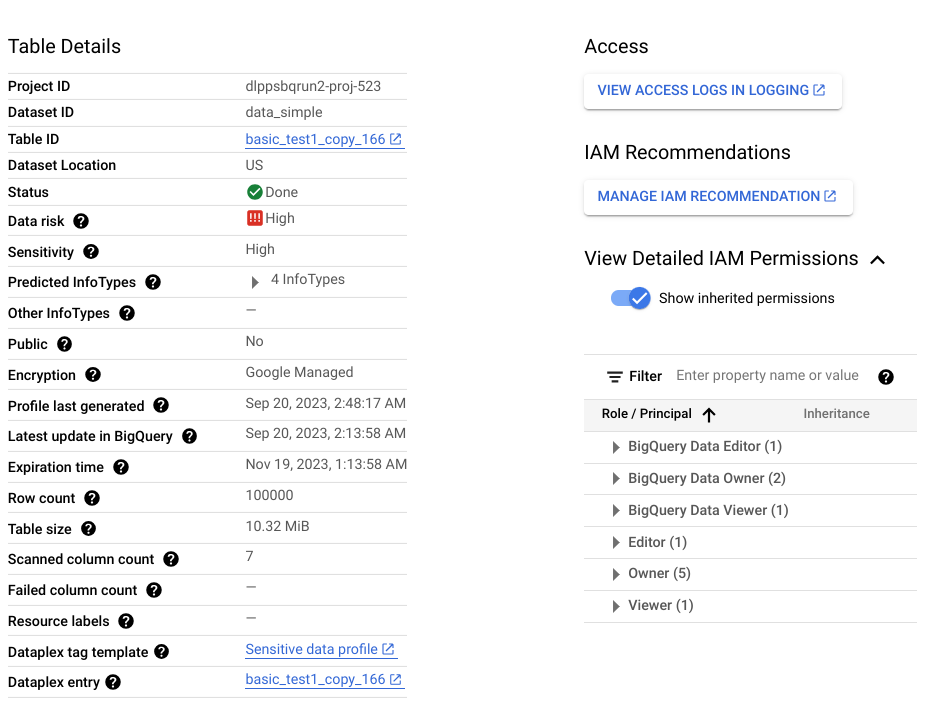
データ プロファイルで使用できる指標と分析情報の詳細なリストについては、指標リファレンスをご覧ください。
検出を使用する場合
データリスク管理のアプローチを計画する場合は、まず検出から始めることをおすすめします。検出サービスを使用すると、データの全体像を把握し、問題のアラート、レポート、修復を可能にするのに役立ちます。
一般的なユースケースは次のとおりです。
- クラウド環境全体を幅広く可視化する: 個別のスキャンジョブを作成することなく、組織、フォルダ、プロジェクト全体のすべてのデータアセットを継続的にスキャンしてプロファイリングします。
- シャドウデータと管理対象外のリポジトリを検出する: 適切なガバナンスやアクセス制御が適用されていない、新しく作成されたテーブルやバケット、分類されていないテーブルやバケットを検出します。
- リスク スコアリングでセキュリティ イニシアチブを優先する: 機密性が高く、データリスク スコアが高いと特定されたデータ リポジトリに、修復リソースと保護リソースを集中させます。
- 詳細な検査の候補を特定する: 詳細なスキャンが必要な非構造化コメントやレビューを含む、フリーテキスト スコアが高いテーブルとストレージ バケットを特定します。
機密データの検査
検査サービスは、1 つのリソースを徹底的にスキャンして、機密データの個々のインスタンスを特定します。検査では、検出されたインスタンスごとに検出結果が生成されます。
検査ジョブには、検査する必要があるデータをピンポイントで特定できる豊富な構成オプションが用意されています。たとえば、サンプリングをオンにして、検査するデータを特定の行数(BigQuery データの場合)または特定のファイル形式(Cloud Storage データの場合)に制限できます。データが作成または変更された特定のタイムスパンをターゲットにすることもできます。
データを継続的にモニタリングする検出とは異なり、検査はオンデマンド オペレーションです。ただし、ジョブトリガーと呼ばれる定期的な検査ジョブをスケジュールできます。
検査スキャンの出力: 検出結果
各検出結果には、検出されたインスタンスの場所、検出結果の潜在的な infoType、検出結果が infoType に一致する確実性(尤度とも呼ばれる)などの詳細情報が含まれます。設定によっては、検出結果に関連する実際の文字列を取得することもできます。この文字列は、Sensitive Data Protection では引用と呼ばれます。
検査結果に含まれる詳細情報の一覧については、Finding をご覧ください。
検査を使用する場合
一般的なユースケースは次のとおりです。
- 非構造化テキストと自由形式フィールドをスキャンする: 顧客のコメント、フィードバック フォーム、サポート チケット、ドキュメント リポジトリ内の個人情報(PII)の特定のインスタンスをすべて特定します。
- 単一のリソースに対してポイントインタイム コンプライアンス監査を実行する: ターゲット テーブルまたはバケット内のすべての機密アイテムの正確なバイト位置と行位置を記録する詳細な検出結果レポートを生成します。
- ハイブリッド クラウドとマルチクラウドのデータ ストリームを検査する: オンプレミス サーバー、ETL パイプライン、外部クラウドからペイロードを直接ストリーミングして、 Google Cloudで一元化された検出レポートを生成します。
- 自動隔離とアラート ワークフローをトリガーする: 検出された結果を Pub/Sub にパブリッシュするか、BigQuery テーブルに直接保存して、イベント ドリブンの修復を推進します。
検査を使用すべきでない場合
次の両方の条件に該当する場合、リソースの検査は役に立ちません。検出スキャンは、検査スキャンが必要かどうかを判断するのに役立ちます。
- リソースに構造化データしかない。つまり、ユーザーのコメントやレビューなどの自由形式のデータの列がない。
- そのリソースに保存されている infoType がすでにわかっている。
たとえば、検出スキャンのデータ プロファイルで、ある BigQuery テーブルに非構造化データを含む列はないが、一意のクレジット カード番号の列があることが示されているとします。この場合、デーブルのクレジット カード番号を検査することは役に立ちません。検査では、列の各項目に対して検出結果が生成されます。100 万行があって各行に 1 つのクレジット カード番号が含まれている場合、検査ジョブは CREDIT_CARD_NUMBER infoType に対して 100 万行の検出結果を生成します。この例では、検出スキャンで列に一意のクレジット カード番号が含まれていることがすでに示されているため、検査は必要ありません。
データのレジデンシー、処理、保存
検出と検査はどちらも、データ所在地の要件をサポートしています。
- 検出サービスは、データが存在する場所でデータを処理し、生成されたデータ プロファイルを、プロファイリングされたデータと同じリージョンまたはマルチリージョンに保存します。詳細については、データ所在地に関する検討事項をご覧ください。
- Google Cloud ストレージ システム内のデータを検査する場合、検査サービスは、データが存在するリージョンと同じリージョンでデータを処理し、そのリージョンに検査ジョブを保存します。ハイブリッド ジョブまたは
contentメソッドを使用してデータを検査する場合、検査サービスでは、データを処理する場所を指定できます。詳細については、データの保存方法をご覧ください。
比較の概要: 検出サービスと検査サービス
| 発見 | 検査 | |
|---|---|---|
| 利点 |
|
|
| 費用 |
10 TB の費用は約 US$300/月(消費モードの場合)。 |
10 TB の費用は約 US$10,000/スキャン。 |
| サポートされるデータソース | BigLake BigQuery Cloud Run functions の環境変数 Cloud Run サービス リビジョンの環境変数 Cloud SQL Cloud Storage Vertex AI Amazon S3 Azure Blob Storage |
BigQuery Cloud Storage Datastore ハイブリッド(任意のソース)1 |
| サポートされているスコープ |
|
単一の BigQuery テーブル、Cloud Storage バケット、または Datastore の種類。 |
| 組み込みの検査テンプレート | ○ | ○ |
| 組み込みとカスタムの infoType | ○ | ○ |
| スキャン出力 | サポートされているすべてのデータの概要(データ プロファイル)。 | 検査されたリソース内の機密データの具体的な検出結果。 |
| 結果の BigQuery への保存 | ○ | ○ |
| アスペクトとして Knowledge Catalog に送信する | はい | いいえ |
| 結果を Security Command Center にパブリッシュする | はい | はい |
| Google Security Operations に結果を公開する | はい(組織レベルとフォルダレベルの検出の場合) | × |
| Pub/Sub に公開 | はい | ○ |
| データ所在地のサポート | はい | はい |
1 ハイブリッド検査には異なる料金モデルがあります。詳細については、任意のソースからのデータの検査をご覧ください。
次のステップ
- データリスクを軽減するために推奨される戦略(このシリーズの次のドキュメント)を確認する。