


En esta página, se describen y comparan dos servicios de Sensitive Data Protection que te ayudan a comprender tus datos y habilitar flujos de trabajo de administración de datos: el servicio de descubrimiento y el servicio de inspección.
Descubrimiento de datos sensibles
El servicio de descubrimiento supervisa los datos en toda tu organización. Este servicio se ejecuta de forma continua y descubre, clasifica y genera perfiles de datos automáticamente. El descubrimiento puede ayudarte a comprender la ubicación y la naturaleza de los datos que almacenas, incluidos los recursos de datos que quizás no conozcas. Los datos desconocidos (a veces llamados datos sombra) no suelen someterse al mismo nivel de administración de datos y gestión de riesgos que los datos conocidos.
Configuras el descubrimiento en varios alcances. Puedes establecer diferentes programaciones de generación de perfiles para diferentes subconjuntos de tus datos. También puedes excluir subconjuntos de datos que no necesites para crear el perfil.
Resultados del análisis de descubrimiento: perfiles de datos
El resultado de un análisis de detección es un conjunto de perfiles de datos para cada recurso de datos dentro del alcance. Por ejemplo, un análisis de descubrimiento de datos de BigQuery o Cloud SQL genera perfiles de datos a nivel de proyecto, tabla y columna.
Un perfil de datos contiene métricas y estadísticas sobre el recurso del que se generó el perfil. Incluye las clasificaciones de datos (o infoTypes), los niveles de sensibilidad, los niveles de riesgo de los datos, el tamaño y la forma de los datos, y otros elementos que describen la naturaleza de los datos y su postura de seguridad de los datos (qué tan seguros son los datos). Puedes usar los perfiles de datos para tomar decisiones fundamentadas sobre cómo proteger tus datos, por ejemplo, estableciendo políticas de acceso en la tabla.
Considera una columna de BigQuery llamada ccn, en la que cada fila contiene un número de tarjeta de crédito único y no hay valores nulos. El perfil de datos a nivel de la columna generado tendrá los siguientes detalles:
| Nombre visible | Valor |
|---|---|
Field ID |
ccn |
Data risk |
High |
Sensitivity |
High |
Data type |
TYPE_STRING |
Policy tags |
No |
Free text score |
0 |
Estimated uniqueness |
High |
Estimated null proportion |
Very low |
Last profile generated |
DATE_TIME |
Predicted infoType |
CREDIT_CARD_NUMBER |
Además, este perfil a nivel de la columna forma parte de un perfil a nivel de la tabla, que proporciona estadísticas como la ubicación de los datos, el estado de encriptación y si la tabla se comparte públicamente. En la consola de Google Cloud , también puedes ver las entradas de Cloud Logging para la tabla y las entidades principales de IAM con roles para la tabla.
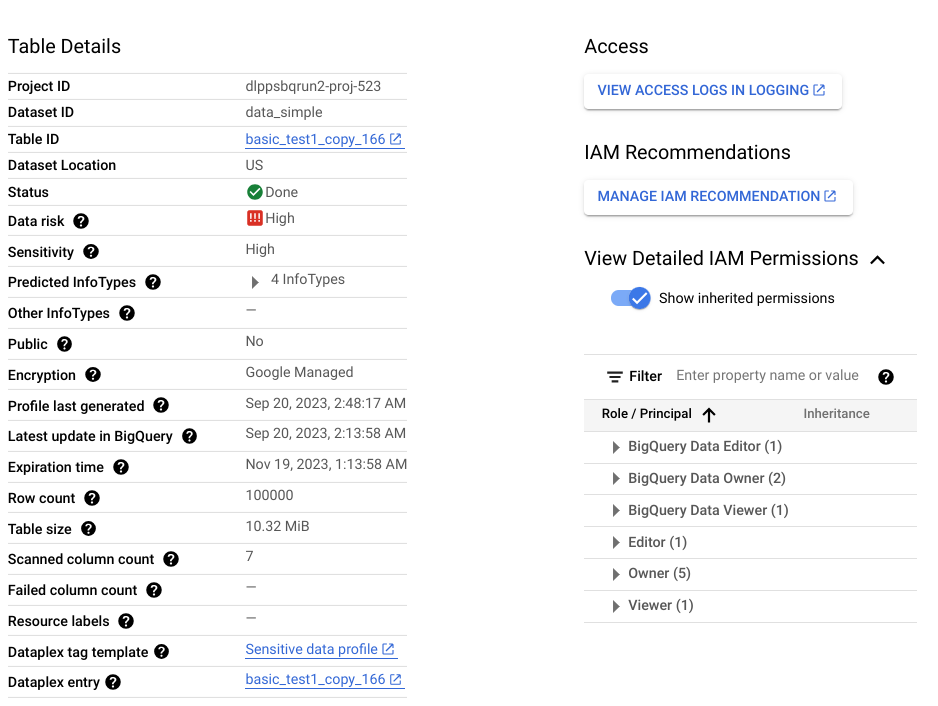
Para obtener una lista completa de las métricas y las estadísticas disponibles en los perfiles de datos, consulta la Referencia de métricas.
Cuándo usar el descubrimiento
Cuando planifiques tu enfoque de administración de riesgos de datos, te recomendamos que comiences con el descubrimiento. El servicio de detección te ayuda a obtener una vista general de tus datos y a habilitar las alertas, los informes y la corrección de problemas.
A continuación, se muestran algunos casos de uso comunes:
- Obtén visibilidad general en todos los entornos de nube: Analiza y genera perfiles de todos los recursos de datos de una organización, carpeta o proyecto de forma continua sin crear trabajos de análisis individuales.
- Descubre datos ocultos y repositorios no administrados: Detecta tablas y buckets creados recientemente o sin clasificar que carecen de la gobernanza o los controles de acceso adecuados.
- Prioriza las iniciativas de seguridad con la puntuación de riesgo: Enfoca los recursos de protección y corrección en los repositorios de datos identificados con alta sensibilidad y puntuaciones de riesgo de datos altas.
- Identifica candidatos para una inspección detallada: Identifica tablas y buckets de almacenamiento con puntuaciones de texto libre altas que contengan comentarios o opiniones no estructurados que requieran un análisis detallado.
Inspección de datos sensibles
El servicio de inspección realiza un análisis exhaustivo de un solo recurso para ubicar cada instancia individual de datos sensibles. Una inspección produce un hallazgo para cada instancia detectada.
Los trabajos de inspección proporcionan un amplio conjunto de opciones de configuración para ayudarte a identificar los datos que deseas inspeccionar. Por ejemplo, puedes activar el muestreo para limitar los datos que se inspeccionarán a una cierta cantidad de filas (para los datos de BigQuery) o a ciertos tipos de archivos (para los datos de Cloud Storage). También puedes segmentar por un período específico en el que se crearon o modificaron los datos.
A diferencia del descubrimiento, que supervisa tus datos de forma continua, la inspección es una operación a pedido. Sin embargo, puedes programar trabajos de inspección recurrentes llamados activadores de trabajo.
Resultado del análisis de inspección: hallazgos
Cada hallazgo incluye detalles como la ubicación de la instancia detectada, su posible Infotipo y la certeza (también llamada probabilidad) de que el hallazgo coincida con el Infotipo. Según tu configuración, también puedes obtener la cadena real a la que se refiere el hallazgo. En Sensitive Data Protection, esta cadena se denomina cita.
Para obtener una lista completa de los detalles incluidos en un hallazgo de inspección, consulta Finding.
Cuándo usar la inspección
A continuación, se muestran algunos casos de uso comunes:
- Analiza texto no estructurado y campos de formato libre: Ubica cada instancia específica de información de identificación personal (PII) en los comentarios de los clientes, los formularios de comentarios, los tickets de asistencia y los repositorios de documentos.
- Realiza auditorías de cumplimiento en un momento determinado en un solo recurso: Genera un informe de hallazgos detallado en el que se registran las ubicaciones exactas de bytes y filas de todos los elementos sensibles dentro de una tabla o un bucket objetivo.
- Inspecciona flujos de datos híbridos y de múltiples nubes: Transmite cargas útiles directamente desde servidores locales, canalizaciones de ETL o nubes externas para generar informes de hallazgos centralizados en Google Cloud.
- Activa flujos de trabajo automatizados de alertas y cuarentena: Publica los hallazgos detectados en Pub/Sub o guárdalos directamente en las tablas de BigQuery para impulsar la corrección basada en eventos.
Cuándo no usar la inspección
La inspección de un recurso no es útil si se cumplen las dos condiciones siguientes. Un análisis de detección puede ayudarte a decidir si se necesita un análisis de inspección.
- Solo tienes datos estructurados en el recurso. Es decir, no hay columnas de datos de formato libre, como comentarios o opiniones de los usuarios.
- Ya conoces los infoTypes almacenados en ese recurso.
Por ejemplo, supongamos que los perfiles de datos de un análisis de descubrimiento indican que una determinada tabla de BigQuery no tiene columnas con datos no estructurados, pero sí tiene una columna de números de tarjetas de crédito únicos. En este caso, no es útil inspeccionar la tabla en busca de números de tarjetas de crédito. Una inspección producirá un hallazgo para cada elemento de la columna. Si tienes 1 millón de filas y cada una contiene 1 número de tarjeta de crédito, un trabajo de inspección producirá 1 millón de resultados para el Infotipo CREDIT_CARD_NUMBER. En este ejemplo, no se necesita la inspección porque el análisis de detección ya indica que la columna contiene números de tarjetas de crédito únicos.
Residencia, procesamiento y almacenamiento de datos
Tanto el descubrimiento como la inspección admiten los requisitos de residencia de datos:
- El servicio de descubrimiento procesa tus datos donde residen y almacena los perfiles de datos generados en la misma región o multirregión que los datos perfilados. Para obtener más información, consulta Consideraciones sobre la residencia de los datos.
- Cuando se inspeccionan datos dentro de un sistema de almacenamiento de Google Cloud , el servicio de inspección procesa tus datos en la misma región en la que residen y almacena el trabajo de inspección en esa región. Cuando inspeccionas datos a través de un trabajo híbrido o un método
content, el servicio de inspección te permite especificar dónde debe procesar tus datos. Para obtener más información, consulta Cómo se almacenan los datos.
Resumen de comparación: servicios de descubrimiento e inspección
| Discovery | Inspección | |
|---|---|---|
| Beneficios |
|
|
| Costo |
10 TB cuestan alrededor de USD 300 por mes en modo de consumo. |
10 TB cuestan alrededor de USD 10,000 por análisis. |
| Fuentes de datos compatibles | BigLake BigQuery Variables de entorno de las funciones de Cloud Run Variables de entorno de la revisión del servicio de Cloud Run Cloud SQL Cloud Storage Vertex AI Amazon S3 Azure Blob Storage |
BigQuery Cloud Storage Datastore Híbrido (cualquier fuente)1 |
| Permisos admitidos |
|
Una sola tabla de BigQuery, un bucket de Cloud Storage o un tipo de Datastore |
| Plantillas de inspección integradas | Sí | Sí |
| Infotipos integrados y personalizados | Sí | Sí |
| Resultado del análisis | Descripción general de alto nivel (perfiles de datos) de todos los datos admitidos. | Son los resultados concretos de datos sensibles en el recurso inspeccionado. |
| Guarda los resultados en BigQuery | Sí | Sí |
| Enviar a Knowledge Catalog como etiquetas (obsoleto) | Yes | Yes |
| Envía a Knowledge Catalog como aspectos | Yes | No |
| Publicar los resultados en Security Command Center | Yes | Yes |
| Publicar resultados en Google Security Operations | Sí para el descubrimiento a nivel de la organización y la carpeta | No |
| Publicar en Pub/Sub | Yes | Sí |
| Compatibilidad con la residencia de datos | Yes | Yes |
1 La inspección híbrida tiene un modelo de precios diferente. Para obtener más información, consulta Inspección de datos de cualquier fuente .
¿Qué sigue?
- Explora las estrategias recomendadas para mitigar el riesgo de los datos (siguiente documento de esta serie).