


Questa pagina descrive e confronta due servizi Sensitive Data Protection che ti aiutano a comprendere i tuoi dati e abilitano i flussi di lavoro di governance dei dati: il servizio di rilevamento e il servizio di ispezione.
Individuazione dei dati sensibili
Il servizio di rilevamento monitora i dati in tutta l'organizzazione. Questo servizio viene eseguito in modo continuo e rileva, classifica e profila automaticamente i dati. Discovery può aiutarti a comprendere la posizione e la natura dei dati che stai archiviando, incluse le risorse di dati di cui potresti non essere a conoscenza. I dati sconosciuti (a volte chiamati dati ombra) in genere non sono soggetti allo stesso livello di governance dei dati e gestione dei rischi dei dati noti.
Configuri il rilevamento in vari ambiti. Puoi impostare pianificazioni di profilazione diverse per sottoinsiemi diversi dei tuoi dati. Puoi anche escludere sottoinsiemi di dati che non devi profilare.
Output scansione di rilevamento: profili di dati
L'output di una scansione di rilevamento è un insieme di profili di dati per ogni risorsa di dati inclusa nell'ambito. Ad esempio, una scansione di rilevamento dei dati BigQuery o Cloud SQL genera profili di dati a livello di progetto, tabella e colonna.
Un profilo dati contiene metriche e approfondimenti sulla risorsa profilata. Include le classificazioni dei dati (o infoType), i livelli di sensibilità, i livelli di rischio dei dati, le dimensioni dei dati, la forma dei dati e altri elementi che descrivono la natura dei dati e la loro postura di sicurezza dei dati (il livello di sicurezza dei dati). Puoi utilizzare i profili dati per prendere decisioni informate su come proteggere i tuoi dati, ad esempio impostando criteri di accesso alla tabella.
Considera una colonna BigQuery denominata ccn, in cui ogni riga contiene un
numero di carta di credito univoco e non sono presenti valori nulli. Il profilo dei dati a livello di colonna generato
conterrà i seguenti dettagli:
| Nome visualizzato | Valore |
|---|---|
Field ID |
ccn |
Data risk |
High |
Sensitivity |
High |
Data type |
TYPE_STRING |
Policy tags |
No |
Free text score |
0 |
Estimated uniqueness |
High |
Estimated null proportion |
Very low |
Last profile generated |
DATE_TIME |
Predicted infoType |
CREDIT_CARD_NUMBER |
Inoltre, questo profilo a livello di colonna fa parte di un profilo a livello di tabella, che fornisce informazioni come la posizione dei dati, lo stato della crittografia e se la tabella è condivisa pubblicamente. Nella console Google Cloud , puoi anche visualizzare le voci di Cloud Logging per la tabella e le entità IAM con ruoli per la tabella.
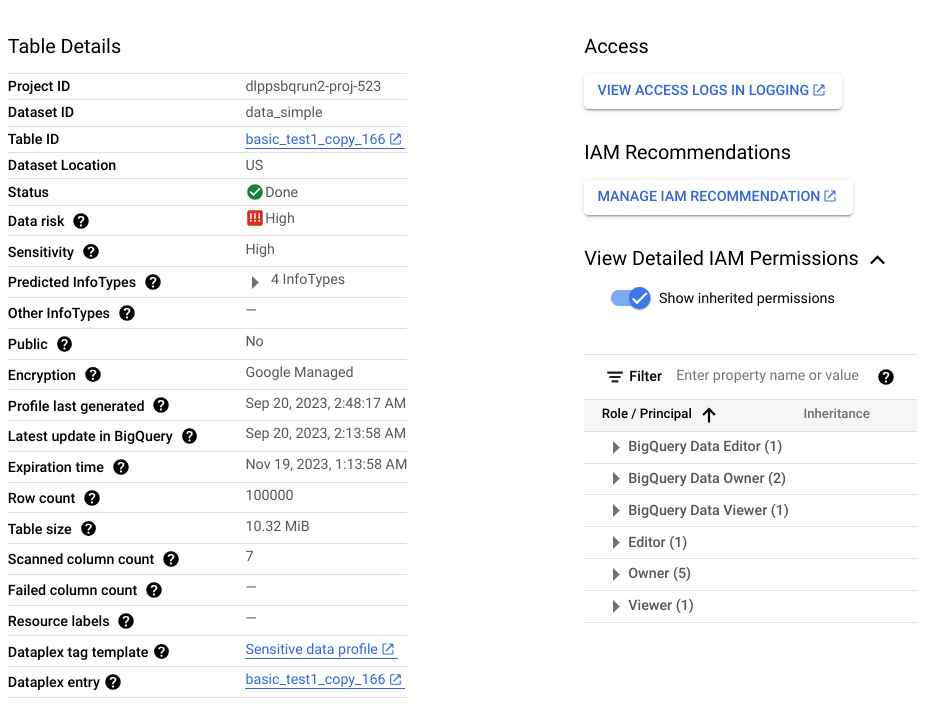
Per un elenco completo delle metriche e degli approfondimenti disponibili nei profili dei dati, consulta Riferimento alle metriche.
Quando utilizzare la scoperta
Quando pianifichi il tuo approccio alla gestione del rischio dei dati, ti consigliamo di iniziare con l'individuazione. Il servizio di rilevamento ti aiuta a ottenere una visione generale dei tuoi dati e a attivare avvisi, report e correzioni dei problemi.
Ecco alcuni casi d'uso comuni:
- Ottieni un'ampia visibilità negli ambienti cloud: esegui la scansione e profila continuamente tutti gli asset di dati in un'organizzazione, una cartella o un progetto senza creare singoli job di scansione.
- Scopri dati ombra e repository non gestiti: rileva tabelle e bucket appena creati o non classificati che non dispongono di controlli di governance o accesso adeguati.
- Dai la priorità alle iniziative di sicurezza con lo scoring del rischio: concentra le risorse di correzione e protezione sui repository di dati identificati con sensibilità elevata e punteggi di rischio elevati.
- Identifica i candidati per l'ispezione approfondita: identifica tabelle e bucket di archiviazione con punteggi di testo libero elevati contenenti commenti o recensioni non strutturati che richiedono una scansione granulare.
Ispezione dei dati sensibili
Il servizio di ispezione esegue una scansione esaustiva di una singola risorsa per individuare ogni singola istanza di dati sensibili. Un'ispezione produce un risultato per ogni istanza rilevata.
I job di ispezione forniscono un ricco insieme di opzioni di configurazione per aiutarti a individuare i dati che vuoi ispezionare. Ad esempio, puoi attivare il campionamento per limitare i dati da esaminare a un determinato numero di righe (per i dati BigQuery) o a determinati tipi di file (per i dati Cloud Storage). Puoi anche scegliere come target un intervallo di tempo specifico in cui i dati sono stati creati o modificati.
A differenza del rilevamento, che monitora continuamente i dati, un'ispezione è un'operazione on demand. Tuttavia, puoi pianificare job di ispezione ricorrenti chiamati trigger di job.
Output della scansione di ispezione: risultati
Ogni risultato include dettagli come la posizione dell'istanza rilevata, il potenziale infoType e la certezza (chiamata anche probabilità) che il risultato corrisponda all'infoType. A seconda delle impostazioni, puoi anche ottenere la stringa effettiva a cui si riferisce il risultato; questa stringa è chiamata citazione in Sensitive Data Protection.
Per un elenco completo dei dettagli inclusi in un risultato dell'ispezione, vedi
Finding.
Quando utilizzare l'ispezione
Ecco alcuni casi d'uso comuni:
- Scansiona testo non strutturato e campi a formato libero: individua ogni istanza specifica di informazioni che consentono l'identificazione personale (PII) all'interno di commenti, moduli di feedback, richieste di assistenza e repository di documenti dei clienti.
- Esegui audit di conformità point-in-time su una singola risorsa: genera un report dettagliato sui risultati che registra la posizione esatta di byte e righe di tutti gli elementi sensibili all'interno di una tabella o di un bucket di destinazione.
- Ispeziona i flussi di dati ibridi e multi-cloud: trasmetti i payload in streaming direttamente da server on-premise, pipeline ETL o cloud esterni per generare report centralizzati sui risultati in Google Cloud.
- Attiva workflow di avviso e quarantena automatizzati: pubblica i risultati rilevati in Pub/Sub o salvali direttamente nelle tabelle BigQuery per favorire la correzione basata sugli eventi.
Quando non utilizzare l'ispezione
L'ispezione di una risorsa non è utile se si verificano entrambe le seguenti condizioni. Una scansione di rilevamento può aiutarti a decidere se è necessaria una scansione di ispezione.
- La risorsa contiene solo dati strutturati. ovvero non ci sono colonne di dati in formato libero, come commenti o recensioni degli utenti.
- Conosci già gli infoType archiviati in questa risorsa.
Ad esempio, supponiamo che i profili di dati di una scansione di rilevamento indichino che una determinata tabella BigQuery non ha colonne con dati non strutturati, ma ha una colonna di numeri di carta di credito univoci. In questo caso, l'ispezione
dei numeri di carte di credito nella tabella non è utile. Un'ispezione produrrà un
risultato per ogni elemento nella colonna. Se hai 1 milione di righe e ogni riga contiene un numero carta di credito, un job di ispezione produrrà 1 milione di risultati per l'infoType CREDIT_CARD_NUMBER. In questo esempio, l'ispezione non è
necessaria perché la scansione di rilevamento indica già che la
colonna contiene numeri di carte di credito univoci.
Residenza, trattamento e archiviazione dei dati
Sia il rilevamento che l'ispezione supportano i requisiti di residenza dei dati:
- Il servizio di rilevamento elabora i tuoi dati nella posizione in cui si trovano e archivia i profili di dati generati nella stessa regione o multi-regione dei dati profilati. Per saperne di più, consulta Considerazioni sulla residenza dei dati.
- Quando ispeziona i dati all'interno di un sistema di archiviazione Google Cloud , il servizio di ispezione elabora i dati nella stessa regione in cui si trovano e archivia il job di ispezione in quella regione. Quando ispezioni i dati tramite un job ibrido o un metodo
content, il servizio di ispezione ti consente di specificare dove deve elaborare i dati. Per maggiori informazioni, consulta la pagina Come vengono archiviati i dati.
Riepilogo del confronto: servizi di individuazione e ispezione
| Discovery | Ispezione | |
|---|---|---|
| Vantaggi |
|
|
| Costo |
10 TB costano circa 300$al mese in modalità a consumo. |
10 TB costano circa 10.000$per scansione. |
| Origini dati supportate | BigLake BigQuery Variabili di ambiente delle funzioni Cloud Run Variabili di ambiente della revisione del servizio Cloud Run Cloud SQL Cloud Storage Vertex AI Amazon S3 Azure Blob Storage |
BigQuery Cloud Storage Datastore Ibrido (qualsiasi origine)1 |
| Ambiti supportati |
|
Una singola tabella BigQuery, un bucket Cloud Storage o un tipo Datastore. |
| Modelli di ispezione integrati | Sì | Sì |
| infoType integrati e personalizzati | Sì | Sì |
| Output scansione | Panoramica generale (profili di dati) di tutti i dati supportati. | Risultati concreti dal rilevamento dei dati sensibili nella risorsa ispezionata. |
| Salva i risultati in BigQuery | Sì | Sì |
| Invia a Knowledge Catalog come tag (deprecato) | Sì | Sì |
| Invia a Knowledge Catalog come aspetti | Sì | No |
| Pubblicare i risultati in Security Command Center | Sì | Sì |
| Pubblica i risultati in Google Security Operations | Sì per l'individuazione a livello di organizzazione e cartella | No |
| Pubblica in Pub/Sub | Sì | Sì |
| Supporto della residenza dei dati | Sì | Sì |
1 L'ispezione ibrida ha un modello di prezzi diverso. Per saperne di più, vedi Ispezione dei dati da qualsiasi origine .
Passaggi successivi
- Esplora le strategie consigliate per mitigare il rischio relativo ai dati (documento successivo di questa serie).