


Halaman ini menjelaskan dan membandingkan dua layanan Sensitive Data Protection yang membantu Anda memahami data dan memungkinkan alur kerja tata kelola data: layanan penemuan dan layanan pemeriksaan.
Penemuan data sensitif
Layanan penemuan memantau data di seluruh organisasi Anda. Layanan ini berjalan secara berkelanjutan dan otomatis menemukan, mengklasifikasikan, dan membuat profil data. Penemuan dapat membantu Anda memahami lokasi dan sifat data yang Anda simpan, termasuk resource data yang mungkin tidak Anda ketahui. Data tidak diketahui (terkadang disebut data bayangan) biasanya tidak menjalani tingkat tata kelola data dan pengelolaan risiko yang sama dengan data yang diketahui.
Anda mengonfigurasi penemuan di berbagai cakupan. Anda dapat menetapkan jadwal pembuatan profil yang berbeda untuk subkumpulan data yang berbeda. Anda juga dapat mengecualikan subset data yang tidak perlu diprofilkan.
Output pemindaian penemuan: profil data
Output pemindaian penemuan adalah serangkaian profil data untuk setiap resource data dalam cakupan. Misalnya, pemindaian penemuan data BigQuery atau Cloud SQL menghasilkan profil data di tingkat project, tabel, dan kolom.
Profil data berisi metrik dan insight tentang resource yang diprofilkan. Hal ini mencakup klasifikasi data (atau infoType), tingkat sensitivitas, tingkat risiko data, ukuran data, bentuk data, dan elemen lain yang menjelaskan sifat data dan postur keamanan data (seberapa aman data tersebut). Anda dapat menggunakan profil data untuk membuat keputusan yang tepat tentang cara melindungi data Anda—misalnya, dengan menetapkan kebijakan akses pada tabel.
Pertimbangkan kolom BigQuery bernama ccn, dengan setiap baris berisi
nomor kartu kredit unik dan tidak ada nilai null. Profil data tingkat kolom yang dihasilkan akan memiliki detail berikut:
| Nama tampilan | Nilai |
|---|---|
Field ID |
ccn |
Data risk |
High |
Sensitivity |
High |
Data type |
TYPE_STRING |
Policy tags |
No |
Free text score |
0 |
Estimated uniqueness |
High |
Estimated null proportion |
Very low |
Last profile generated |
DATE_TIME |
Predicted infoType |
CREDIT_CARD_NUMBER |
Selain itu, profil tingkat kolom ini adalah bagian dari profil tingkat tabel, yang memberikan insight seperti lokasi data, status enkripsi, dan apakah tabel dibagikan secara publik. Di konsol Google Cloud , Anda juga dapat melihat entri Cloud Logging untuk tabel dan akun utama IAM dengan peran untuk tabel.
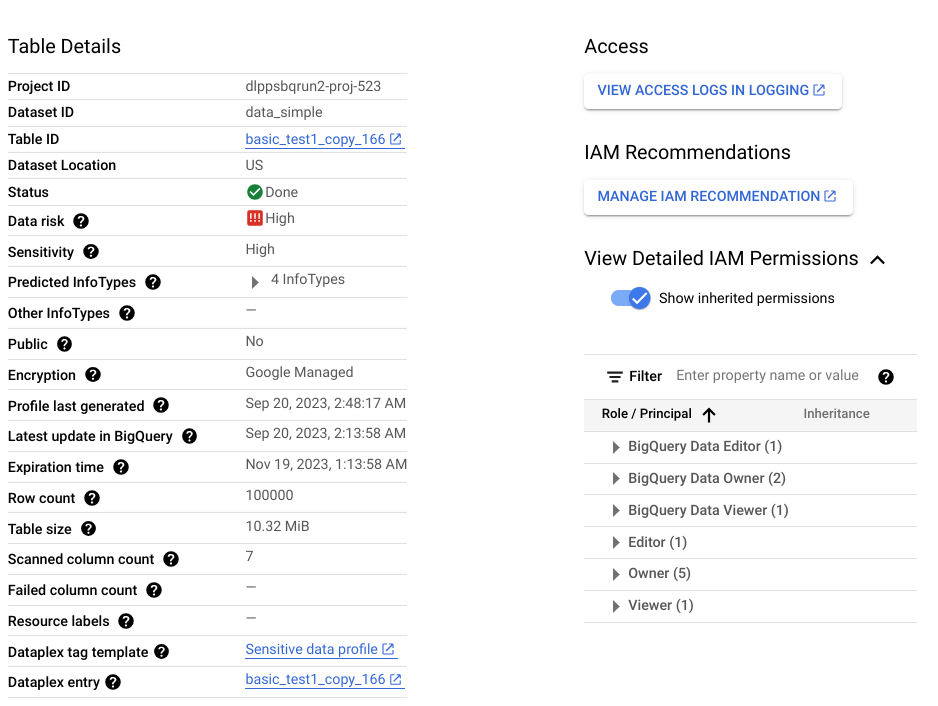
Untuk mengetahui daftar lengkap metrik dan insight yang tersedia di profil data, lihat Referensi metrik.
Kapan harus menggunakan penemuan
Saat merencanakan pendekatan pengelolaan risiko data, sebaiknya Anda mulai dengan penemuan. Layanan penemuan membantu Anda mendapatkan gambaran luas tentang data dan mengaktifkan pemberitahuan, pelaporan, dan perbaikan masalah.
Berikut adalah beberapa kasus penggunaan umum:
- Mendapatkan visibilitas luas di seluruh lingkungan cloud: Terus memindai dan membuat profil semua aset data di seluruh organisasi, folder, atau project tanpa membuat tugas pemindaian individual.
- Menemukan data bayangan dan repositori yang tidak dikelola: Mendeteksi tabel dan bucket yang baru dibuat atau tidak diklasifikasikan yang tidak memiliki tata kelola atau kontrol akses yang tepat.
- Memprioritaskan inisiatif keamanan dengan penilaian risiko: Fokuskan sumber daya perbaikan dan perlindungan pada repositori data yang diidentifikasi dengan skor risiko data tinggi dan sensitivitas tinggi.
- Mengidentifikasi kandidat untuk pemeriksaan mendalam: Mengidentifikasi tabel dan bucket penyimpanan dengan skor teks bebas tinggi yang berisi komentar atau ulasan tidak terstruktur yang memerlukan pemindaian terperinci.
Pemeriksaan data sensitif
Layanan inspeksi melakukan pemindaian menyeluruh pada satu resource untuk menemukan setiap instance data sensitif. Pemeriksaan menghasilkan temuan untuk setiap instance yang terdeteksi.
Tugas pemeriksaan menyediakan serangkaian opsi konfigurasi yang lengkap untuk membantu Anda menentukan data yang ingin diperiksa. Misalnya, Anda dapat mengaktifkan pengambilan sampel untuk membatasi data yang akan diperiksa ke sejumlah baris tertentu (untuk data BigQuery) atau jenis file tertentu (untuk data Cloud Storage). Anda juga dapat menargetkan rentang waktu tertentu saat data dibuat atau diubah.
Tidak seperti penemuan, yang terus memantau data Anda, pemeriksaan adalah operasi sesuai permintaan. Namun, Anda dapat menjadwalkan tugas inspeksi berulang yang disebut pemicu tugas.
Output pemindaian inspeksi: temuan
Setiap temuan mencakup detail seperti lokasi instance yang terdeteksi, potensi infoType-nya, dan kepastian (juga disebut kemungkinan) bahwa temuan tersebut cocok dengan infoType. Bergantung pada setelan Anda, Anda juga bisa mendapatkan string sebenarnya yang terkait dengan temuan; string ini disebut kutipan di Sensitive Data Protection.
Untuk mengetahui daftar lengkap detail yang disertakan dalam temuan pemeriksaan, lihat
Finding.
Kapan harus menggunakan pemeriksaan
Berikut adalah beberapa kasus penggunaan umum:
- Memindai teks tidak terstruktur dan kolom bentuk bebas: Temukan setiap instance spesifik informasi identitas pribadi (PII) dalam komentar pelanggan, formulir masukan, tiket dukungan, dan repositori dokumen.
- Melakukan audit kepatuhan pada satu titik waktu untuk satu resource: Buat laporan temuan mendetail yang mencatat lokasi byte dan baris yang tepat dari semua item sensitif dalam tabel atau bucket yang ditargetkan.
- Memeriksa aliran data hybrid dan multi-cloud: Streaming payload secara langsung dari server lokal, pipeline ETL, atau cloud eksternal untuk membuat laporan temuan terpusat di Google Cloud.
- Memicu alur kerja karantina dan pemberitahuan otomatis: Publikasikan temuan yang terdeteksi ke Pub/Sub atau simpan langsung ke tabel BigQuery untuk mendorong perbaikan berbasis peristiwa.
Kapan sebaiknya tidak menggunakan pemeriksaan
Memeriksa resource tidak berguna jika kedua kondisi berikut berlaku. Pemindaian penemuan dapat membantu Anda memutuskan apakah pemindaian inspeksi diperlukan atau tidak.
- Anda hanya memiliki data terstruktur di resource. Artinya, tidak ada kolom data bentuk bebas, seperti komentar atau ulasan pengguna.
- Anda sudah mengetahui infoType yang disimpan dalam resource tersebut.
Misalnya, anggaplah profil data dari pemindaian penemuan menunjukkan bahwa tabel BigQuery tertentu tidak memiliki kolom dengan data tidak terstruktur, tetapi memiliki kolom nomor kartu kredit unik. Dalam hal ini, memeriksa
nomor kartu kredit dalam tabel tidak berguna. Pemeriksaan akan menghasilkan
temuan untuk setiap item dalam kolom. Jika Anda memiliki 1 juta baris dan setiap baris berisi 1 nomor kartu kredit, tugas inspeksi akan menghasilkan 1 juta temuan untuk jenis info CREDIT_CARD_NUMBER. Dalam contoh ini, pemeriksaan tidak
diperlukan karena pemindaian penemuan sudah menunjukkan bahwa
kolom berisi nomor kartu kredit unik.
Residensi data, pemrosesan, dan penyimpanan
Penemuan dan inspeksi mendukung persyaratan residensi data:
- Layanan penemuan memproses data Anda di tempat data tersebut berada dan menyimpan profil data yang dihasilkan di region atau multi-region yang sama dengan data yang diprofilkan. Untuk mengetahui informasi selengkapnya, lihat Pertimbangan residensi data.
- Saat memeriksa data dalam sistem penyimpanan Google Cloud , layanan pemeriksaan memproses data Anda di region yang sama dengan tempat data berada dan menyimpan tugas pemeriksaan di region tersebut. Saat memeriksa data melalui tugas hybrid atau melalui metode
content, layanan pemeriksaan memungkinkan Anda menentukan tempat data Anda harus diproses. Untuk mengetahui informasi selengkapnya, lihat artikel Cara data disimpan.
Ringkasan perbandingan: layanan penemuan dan pemeriksaan
| Discovery | Inspeksi | |
|---|---|---|
| Manfaat |
|
|
| Biaya |
10 TB berharga sekitar US$300 per bulan dalam mode penggunaan. |
10 TB berbiaya sekitar US$10.000 per pemindaian. |
| Sumber data yang didukung | BigLake BigQuery Variabel lingkungan fungsi Cloud Run Variabel lingkungan revisi layanan Cloud Run Cloud SQL Cloud Storage Vertex AI Amazon S3 Azure Blob Storage |
BigQuery Cloud Storage Datastore Hybrid (sumber apa pun)1 |
| Cakupan yang didukung |
|
Satu tabel BigQuery, bucket Cloud Storage, atau jenis Datastore. |
| Template inspeksi bawaan | Ya | Ya |
| InfoType bawaan dan kustom | Ya | Ya |
| Output pemindaian | Ringkasan umum (profil data) semua data yang didukung. | Temuan konkret data sensitif dalam resource yang diperiksa. |
| Menyimpan hasil ke BigQuery | Ya | Ya |
| Mengirim ke Knowledge Catalog sebagai tag (Tidak digunakan lagi) | Ya | Ya |
| Mengirim ke Knowledge Catalog sebagai aspek | Ya | Tidak |
| Mempublikasikan hasil ke Security Command Center | Ya | Ya |
| Memublikasikan temuan ke Google Security Operations | Ya untuk penemuan tingkat organisasi dan tingkat folder | Tidak |
| Publikasikan ke Pub/Sub | Ya | Ya |
| Dukungan residensi data | Ya | Ya |
1 Inspeksi hybrid memiliki model harga yang berbeda. Untuk mengetahui informasi selengkapnya, lihat Pemeriksaan data dari berbagai sumber .
Langkah berikutnya
- Pelajari strategi yang direkomendasikan untuk memitigasi risiko data (dokumen berikutnya dalam seri ini)