


En esta página, se describen y comparan dos servicios de Sensitive Data Protection que te ayudan a comprender tus datos y habilitar los flujos de trabajo de administración de datos: el servicio de descubrimiento y el servicio de inspección.
Descubrimiento de datos sensibles
El servicio de descubrimiento supervisa los datos en toda tu organización. Este servicio se ejecuta de forma continua y descubre, clasifica y genera perfiles de datos automáticamente. El descubrimiento puede ayudarte a comprender la ubicación y la naturaleza de los datos que almacenas, incluidos los recursos de datos que quizás no conozcas. Los datos desconocidos (a veces llamados datos ocultos) no suelen someterse al mismo nivel de administración de datos y de riesgos que los datos conocidos.
La detección se configura en varios permisos. Puedes establecer diferentes programas de generación de perfiles para distintos subconjuntos de tus datos. También puedes excluir subconjuntos de datos de los que no necesites generar perfiles.
Resultado del análisis de descubrimiento: perfiles de datos
El resultado de un análisis de descubrimiento es un conjunto de perfiles de datos para cada recurso de datos dentro del alcance. Por ejemplo, un análisis de descubrimiento de datos de BigQuery o Cloud SQL genera perfiles de datos a nivel de proyecto, tabla y columna.
Un perfil de datos contiene métricas y estadísticas sobre el recurso del perfil. Incluye las clasificaciones de datos (o infoTypes), los niveles de sensibilidad, los niveles de riesgo de los datos, el tamaño de los datos, la forma de los datos y otros elementos que describen la naturaleza de los datos y su postura de seguridad de los datos (qué tan seguros son los datos). Puedes usar perfiles de datos para tomar decisiones fundamentadas sobre cómo proteger tus datos, por ejemplo, estableciendo políticas de acceso en la tabla.
Considera una columna de BigQuery llamada ccn, en la que cada fila contiene un
número de tarjeta de crédito único y no hay valores nulos. El perfil de datos a nivel de columna generado tendrá los siguientes detalles:
| Nombre visible | Valor |
|---|---|
Field ID |
ccn |
Data risk |
High |
Sensitivity |
High |
Data type |
TYPE_STRING |
Policy tags |
No |
Free text score |
0 |
Estimated uniqueness |
High |
Estimated null proportion |
Very low |
Last profile generated |
DATE_TIME |
Predicted infoType |
CREDIT_CARD_NUMBER |
Además, este perfil a nivel de columna forma parte de un perfil a nivel de tabla, que proporciona información como la ubicación de los datos, el estado de encriptación y si la tabla se comparte de forma pública. En la consola de Google Cloud , también puedes ver las entradas de registro de Cloud Logging de la tabla y las entidades principales de IAM con roles para la tabla.
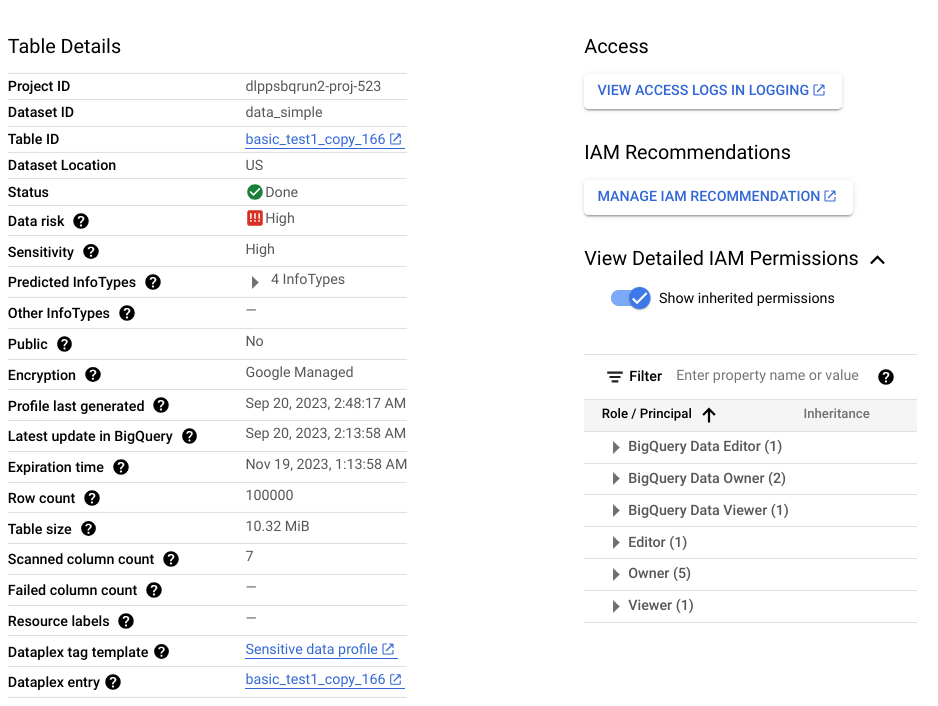
Para obtener una lista completa de las métricas y las estadísticas disponibles en los perfiles de datos, consulta la Referencia de métricas.
Cuándo usar el descubrimiento
Cuando planifiques tu enfoque de administración de riesgos de datos, te recomendamos que comiences con el descubrimiento. El servicio de descubrimiento te ayuda a obtener una vista amplia de tus datos y habilitar las alertas, los informes y la solución de problemas.
A continuación, se muestran algunos casos de uso comunes:
- Obtén una visibilidad amplia en todos los entornos de nube: Analiza y genera perfiles de forma continua para todos los recursos de datos en una organización, carpeta o proyecto sin crear trabajos de análisis individuales.
- Descubre datos ocultos y repositorios no administrados: Detecta tablas y buckets recién creados o sin clasificar que carecen de controles de acceso o administración adecuados.
- Prioriza las iniciativas de seguridad con la puntuación de riesgo: Enfoca los recursos de corrección y protección en los repositorios de datos identificados con puntuaciones altas de sensibilidad y riesgo de datos.
- Identifica candidatos para la inspección profunda: Identifica tablas y buckets de almacenamiento con puntuaciones de texto libre altas que contengan comentarios o opiniones no estructurados que requieran un análisis detallado.
Inspección de datos sensibles
El servicio de inspección realiza un análisis exhaustivo de un solo recurso para ubicar cada instancia individual de datos sensibles. Una inspección produce un hallazgo para cada instancia detectada.
Los trabajos de inspección proporcionan un conjunto enriquecido de opciones de configuración para ayudarte a identificar los datos que deseas inspeccionar. Por ejemplo, puedes activar el muestreo para limitar los datos que se inspeccionarán a una cantidad determinada de filas (para los datos de BigQuery) o a ciertos tipos de archivos (para los datos de Cloud Storage). También puedes segmentar un período específico en el que se crearon o modificaron los datos.
A diferencia del descubrimiento, que supervisa tus datos de forma continua, una inspección es una operación a pedido. Sin embargo, puedes programar trabajos de inspección recurrentes llamados activadores de trabajos.
Resultado del análisis de inspección: hallazgos
Cada hallazgo incluye detalles como la ubicación de la instancia detectada, su posible Infotipo y la certeza (también llamada probabilidad) de que el hallazgo coincida con el Infotipo. Según tu configuración, también puedes obtener la cadena real a la que pertenece el hallazgo. Esta cadena se denomina cita en Sensitive Data Protection.
Para obtener una lista completa de los detalles incluidos en un hallazgo de inspección, consulta
Finding.
Cuándo usar la inspección
A continuación, se muestran algunos casos de uso comunes:
- Analiza texto no estructurado y campos de formato libre: Localiza cada instancia específica de información de identificación personal (PII) en los comentarios de los clientes, los formularios de comentarios, los tickets de asistencia y los repositorios de documentos.
- Realiza auditorías de cumplimiento de un momento determinado en un solo recurso: Genera un informe de hallazgos detallado que registre las ubicaciones exactas de bytes y filas de todos los elementos sensibles dentro de una tabla o un bucket específicos.
- Inspecciona flujos de datos híbridos y de múltiples nubes: Transmite cargas útiles directamente desde servidores locales, canalizaciones de ETL o nubes externas para generar informes de hallazgos centralizados en Google Cloud.
- Activa flujos de trabajo automatizados de cuarentena y alertas: Publica los hallazgos detectados en Pub/Sub o guárdalos directamente en tablas de BigQuery para impulsar la corrección basada en eventos.
Cuándo no usar la inspección
Inspeccionar un recurso no es útil si se cumplen las dos condiciones siguientes. Un análisis de descubrimiento puede ayudarte a decidir si se necesita un análisis de inspección.
- Solo tienes datos estructurados en el recurso. Es decir, no hay columnas de datos de formato libre, como comentarios u opiniones de usuarios.
- Ya conoces los tipos de información almacenados en ese recurso.
Por ejemplo, supongamos que los perfiles de datos de un análisis de descubrimiento indican que una
tabla de BigQuery determinada no tiene columnas con datos no estructurados,
pero tiene una columna de números de tarjetas de crédito únicos. En este caso, no es útil inspeccionar
los números de tarjetas de crédito en la tabla. Una inspección producirá un
hallazgo para cada elemento de la columna. Si tienes 1 millón de filas y cada una
contiene 1 número de tarjeta de crédito, un trabajo de inspección producirá 1 millón de hallazgos
para el infotipo CREDIT_CARD_NUMBER. En este ejemplo, no se necesita la inspección,
ya que el análisis de descubrimiento indica que la
columna contiene números de tarjetas de crédito únicos.
Residencia, procesamiento y almacenamiento de datos
Tanto el descubrimiento como la inspección admiten los requisitos de residencia de datos:
- El servicio de descubrimiento procesa tus datos donde residen y almacena los perfiles de datos generados en la misma región o multirregión que los datos perfilados. Para obtener más información, consulta Consideraciones sobre la residencia de datos.
- Cuando se inspeccionan datos dentro de un sistema de almacenamiento de Google Cloud , el
servicio de inspección procesa tus datos en la misma región en la que
residen y almacena el trabajo de inspección en esa región. Cuando inspeccionas
datos a través de un trabajo híbrido o un
método
content, el servicio de inspección te permite especificar dónde debe procesar tus datos. Para obtener más información, consulta Cómo se almacenan los datos.
Resumen de comparación: servicios de descubrimiento y de inspección
| Discovery | Inspección | |
|---|---|---|
| Beneficios |
|
|
| Costo |
10 TB cuestan alrededor de USD 300 por mes en el modo de consumo. |
10 TB cuestan alrededor de USD 10,000 por análisis. |
| Fuentes de datos compatibles | BigLake BigQuery Variables de entorno de Cloud Run Functions Variables de entorno de revisión del servicio de Cloud Run Cloud SQL Cloud Storage Vertex AI Amazon S3 Azure Blob Storage |
BigQuery Cloud Storage Datastore Híbrido (cualquier fuente)1 |
| Permisos admitidos |
|
Una sola tabla de BigQuery, un bucket de Cloud Storage o un tipo de Datastore. |
| Plantillas de inspección integradas | Sí | Sí |
| Integrados y personalizados | Sí | Sí |
| Resultado del análisis | Descripción general de alto nivel (perfiles de datos) de todos los datos admitidos. | Son los hallazgos concretos de datos sensibles en el recurso inspeccionado. |
| Guarda los resultados en BigQuery | Sí | Sí |
| Enviar a Knowledge Catalog como aspectos | Yes | No |
| Publica los resultados en Security Command Center | Yes | Yes |
| Publicar resultados en Google Security Operations | Sí para el descubrimiento a nivel de organización y de carpeta | No |
| Publicar en Pub/Sub | Yes | Sí |
| Compatibilidad con la residencia de datos | Yes | Yes |
1 La inspección híbrida tiene un modelo de precios diferente. Para obtener más información, consulta Inspección de datos de cualquier fuente .
¿Qué sigue?
- Explora las estrategias recomendadas para mitigar el riesgo de los datos (siguiente documento de esta serie)