


Auf dieser Seite werden zwei Sensitive Data Protection-Dienste beschrieben und verglichen, die Ihnen helfen, Ihre Daten zu verstehen und Data-Governance-Workflows zu ermöglichen: der Erkennungsdienst und der Prüfdienst.
Erkennung sensibler Daten
Der Erkennungsdienst überwacht Daten in Ihrer gesamten Organisation. Dieser Dienst wird kontinuierlich ausgeführt und erkennt, klassifiziert und profiliert Daten automatisch. Mit der Erkennung können Sie den Speicherort und die Art der gespeicherten Daten ermitteln, einschließlich Datenressourcen, die Ihnen möglicherweise nicht bekannt sind. Unbekannte Daten (manchmal auch als Schatten-Daten bezeichnet) werden in der Regel nicht im selben Maße wie bekannte Daten verwaltet und risikobewertet.
Sie konfigurieren die Erkennung in verschiedenen Bereichen. Sie können unterschiedliche Zeitpläne für die Profilerstellung für verschiedene Teilmengen Ihrer Daten festlegen. Sie können auch Teilmengen von Daten ausschließen, für die Sie kein Profil erstellen müssen.
Ausgabe des Erkennungsscans: Datenprofile
Die Ausgabe eines Erkennungsscans ist eine Reihe von Datenprofilen für jede Datenressource im Umfang. Bei einem Erkennungsscan von BigQuery- oder Cloud SQL-Daten werden beispielsweise Datenprofile auf Projekt-, Tabellen- und Spaltenebene generiert.
Ein Datenprofil enthält Messwerte und Statistiken zur Ressource, für die ein Profil erstellt wurde. Dazu gehören die Datenklassifizierungen (oder infoTypes), Vertraulichkeitsstufen, Datenrisikostufen, Datengröße, Datenform und andere Elemente, die die Art der Daten und ihren Datensicherheitsstatus (wie sicher die Daten sind) beschreiben. Mithilfe von Datenprofilen können Sie fundierte Entscheidungen zum Schutz Ihrer Daten treffen, z. B. durch Festlegen von Zugriffsrichtlinien für die Tabelle.
Angenommen, Sie haben eine BigQuery-Spalte namens ccn, in der jede Zeile eine eindeutige Kartennummer enthält und keine Nullwerte vorhanden sind. Das generierte Datenprofil auf Spaltenebene enthält die folgenden Details:
| Anzeigename | Wert |
|---|---|
Field ID |
ccn |
Data risk |
High |
Sensitivity |
High |
Data type |
TYPE_STRING |
Policy tags |
No |
Free text score |
0 |
Estimated uniqueness |
High |
Estimated null proportion |
Very low |
Last profile generated |
DATE_TIME |
Predicted infoType |
CREDIT_CARD_NUMBER |
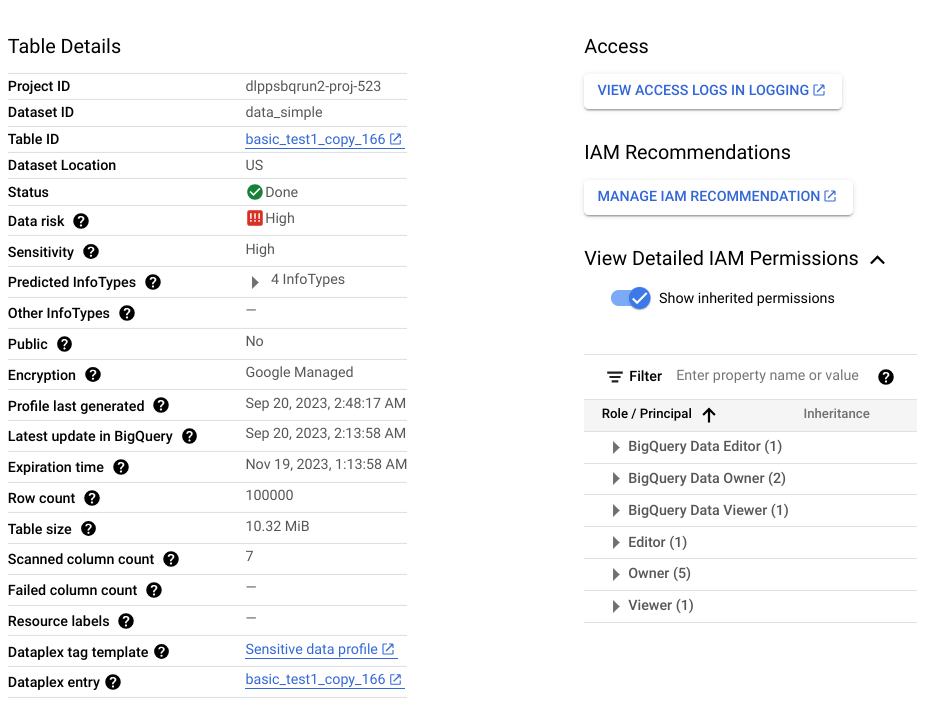
Außerdem ist dieses Profil auf Spaltenebene Teil eines Profils auf Tabellenebene, das Informationen wie den Datenspeicherort, den Verschlüsselungsstatus und die öffentliche Freigabe der Tabelle enthält. In der Google Cloud Console können Sie auch die Cloud Logging-Logeinträge für die Tabelle und die IAM-Prinzipale mit Rollen für die Tabelle aufrufen.
Eine vollständige Liste der in Datenprofilen verfügbaren Messwerte und Statistiken finden Sie in der Messwertreferenz.
Wann Discovery verwendet werden sollte
Wenn Sie Ihren Ansatz für das Datenrisikomanagement planen, empfehlen wir, mit der Erkennung zu beginnen. Der Discovery-Dienst bietet Ihnen einen umfassenden Überblick über Ihre Daten und ermöglicht Benachrichtigungen, Berichte und die Behebung von Problemen.
Im Folgenden sind einige gängige Anwendungsfälle aufgeführt:
- Umfassende Transparenz in Cloud-Umgebungen: Alle Datenbestände in einer Organisation, einem Ordner oder einem Projekt werden kontinuierlich gescannt und profiliert, ohne dass einzelne Scan-Jobs erstellt werden müssen.
- Schatten-Daten und nicht verwaltete Repositories aufdecken: Erkennen Sie neu erstellte oder nicht klassifizierte Tabellen und Buckets, die nicht ordnungsgemäß verwaltet werden oder für die keine Zugriffssteuerung eingerichtet ist.
- Sicherheitsinitiativen mit Risikobewertung priorisieren: Konzentrieren Sie die Ressourcen für die Behebung und den Schutz auf Daten-Repositories, die als hochsensibel und mit hohen Datenrisikowerten identifiziert wurden.
- Kandidaten für eine eingehende Prüfung identifizieren: Identifizieren Sie Tabellen und Storage-Buckets mit hohen Freitextwerten, die unstrukturierte Kommentare oder Rezensionen enthalten, die detailliert gescannt werden müssen.
Prüfung sensibler Daten
Der Inspektionsdienst führt einen umfassenden Scan einer einzelnen Ressource durch, um jede einzelne Instanz sensibler Daten zu finden. Eine Prüfung erzeugt für jede erkannte Instanz ein Ergebnis.
Inspektionsjobs bieten eine Vielzahl von Konfigurationsoptionen, mit denen Sie die zu prüfenden Daten genau bestimmen können. Sie können beispielsweise die Stichprobenerhebung aktivieren, um die zu prüfenden Daten auf eine bestimmte Anzahl von Zeilen (für BigQuery-Daten) oder bestimmte Dateitypen (für Cloud Storage-Daten) zu beschränken. Sie können auch einen bestimmten Zeitraum festlegen, in dem die Daten erstellt oder geändert wurden.
Im Gegensatz zur Erkennung, bei der Ihre Daten kontinuierlich überwacht werden, ist eine Prüfung ein On-Demand-Vorgang. Sie können jedoch wiederkehrende Inspektionsjobs planen, die als Job-Trigger bezeichnet werden.
Ausgabe des Inspektionsscans: Ergebnisse
Jedes Ergebnis enthält Details wie den Speicherort der erkannten Instanz, den potenziellen infoType und die Gewissheit (auch Wahrscheinlichkeit genannt), dass das Ergebnis mit dem infoType übereinstimmt. Je nach Ihren Einstellungen können Sie auch den tatsächlichen String abrufen, auf den sich das Ergebnis bezieht. Dieser String wird in Sensitive Data Protection als Zitat bezeichnet.
Eine vollständige Liste der Details, die in einem Prüfergebnis enthalten sind, finden Sie unter Finding.
Wann sollte die Prüfung verwendet werden?
Im Folgenden sind einige gängige Anwendungsfälle aufgeführt:
- Unstrukturierten Text und Freiformfelder scannen: Finden Sie alle spezifischen Instanzen von personenidentifizierbaren Informationen in Kundenkommentaren, Feedbackformularen, Support-Tickets und Dokument-Repositories.
- Compliance-Audits zu einem bestimmten Zeitpunkt für eine einzelne Ressource durchführen: Erstellen Sie einen detaillierten Ergebnisbericht, in dem die genauen Byte- und Zeilenpositionen aller sensiblen Elemente in einer bestimmten Tabelle oder einem bestimmten Bucket aufgezeichnet werden.
- Hybride und Multi-Cloud-Datenstreams prüfen: Streamen Sie Nutzlasten direkt von lokalen Servern, ETL-Pipelines oder externen Clouds, um zentrale Ergebnisberichte in Google Cloudzu generieren.
- Automatisierte Workflows für Quarantäne und Benachrichtigungen auslösen: Veröffentlichen Sie erkannte Ergebnisse in Pub/Sub oder speichern Sie sie direkt in BigQuery-Tabellen, um ereignisgesteuerte Abhilfemaßnahmen zu ergreifen.
Wann die Prüfung nicht verwendet werden sollte
Die Prüfung einer Ressource ist nicht sinnvoll, wenn beide der folgenden Bedingungen zutreffen. Ein Erkennungsscan kann Ihnen bei der Entscheidung helfen, ob ein Prüfscan erforderlich ist.
- Die Ressource enthält nur strukturierte Daten. Es gibt also keine Spalten mit Freiformdaten wie Nutzerkommentare oder Rezensionen.
- Sie kennen die in dieser Ressource gespeicherten infoTypes bereits.
Angenommen, die Datenprofile eines Erkennungsscans weisen darauf hin, dass eine bestimmte BigQuery-Tabelle keine Spalten mit unstrukturierten Daten, aber eine Spalte mit eindeutigen Kreditkartennummern enthält. In diesem Fall ist die Prüfung auf Kreditkartennummern in der Tabelle nicht sinnvoll. Bei einer Prüfung wird für jedes Element in der Spalte ein Ergebnis generiert. Wenn Sie 1 Million Zeilen haben und jede Zeile 1 Kreditkartennummer enthält, erzeugt ein Inspektionsjob 1 Million Ergebnisse für den infoType CREDIT_CARD_NUMBER. In diesem Beispiel ist die Prüfung nicht erforderlich, da der Erkennungsscan bereits darauf hinweist, dass die Spalte eindeutige Kreditkartennummern enthält.
Datenstandort, ‑verarbeitung und ‑speicherung
Sowohl die Erkennung als auch die Prüfung unterstützen die Anforderungen an den Datenstandort:
- Der Dienst zur Erkennung sensibler Daten verarbeitet Ihre Daten dort, wo sie sich befinden, und speichert die generierten Datenprofile in derselben Region oder Multiregion wie die profilierten Daten. Weitere Informationen finden Sie unter Überlegungen zum Datenstandort.
- Wenn Daten in einem Google Cloud -Speichersystem geprüft werden, verarbeitet der Prüfdienst Ihre Daten in der Region, in der sich die Daten befinden, und speichert den Prüfjob in dieser Region. Wenn Sie Daten über einen Hybridjob oder eine
content-Methode prüfen, können Sie im Prüfdienst angeben, wo Ihre Daten verarbeitet werden sollen. Weitere Informationen finden Sie unter So werden Daten gespeichert.
Vergleichsübersicht: Erkennungs- und Prüfdienste
| Discovery | Prüfung | |
|---|---|---|
| Vorteile |
|
|
| Kosten |
10 TB kosten im Verbrauchsmodus etwa 300 $ pro Monat. |
10 TB kosten ca. 10.000 $ pro Scan. |
| Unterstützte Datenquellen | BigLake BigQuery Umgebungsvariablen für Cloud Run Functions Umgebungsvariablen für Cloud Run-Dienstversionen Cloud SQL Cloud Storage Vertex AI Amazon S3 Azure Blob Storage |
BigQuery Cloud Storage Datastore Hybrid (beliebige Quelle)1 |
| Unterstützte Bereiche |
|
Eine einzelne BigQuery-Tabelle, ein Cloud Storage-Bucket oder eine Datastore-Art. |
| Integrierte Inspektionsvorlagen | Ja | Ja |
| Integrierte und benutzerdefinierte infoTypes | Ja | Ja |
| Scanausgabe | Gesamtübersicht (Datenprofile) über alle unterstützten Daten. | Tatsächlich gefundene sensible Daten in der geprüften Ressource. |
| Ergebnisse in BigQuery speichern | Ja | Ja |
| Als Aspekte an Knowledge Catalog senden | Ja | Nein |
| Ergebnisse in Security Command Center veröffentlichen | Ja | Ja |
| Ergebnisse in Google Security Operations veröffentlichen | Ja für die Erkennung auf Organisations- und Ordnerebene | Nein |
| In Pub/Sub veröffentlichen | Ja | Ja |
| Unterstützung für den Datenstandort | Ja | Ja |
1 Für die Hybridprüfung gilt ein anderes Preismodell. Weitere Informationen finden Sie unter Prüfung von Daten aus beliebigen Quellen .
Nächste Schritte
- Empfohlene Strategien zur Minimierung von Datenrisiken (nächstes Dokument in dieser Reihe)