


Sensitive Data Protection inclut différents types de méthodes permettant d'inspecter, de transformer (anonymiser), de découvrir et de classer des données. Grâce à ces méthodes, vous pouvez analyser les données à la fois sur Google Cloud et en dehors, et optimiser le comportement de Sensitive Data Protection pour différents types de charges de travail.
Sensitive Data Protection fournit les types de méthodes suivants :
Méthodes d'inspection et d'anonymisation
Cette section décrit les méthodes que vous pouvez utiliser pour localiser et, éventuellement, anonymiser chaque élément de données correspondant à un type d'informations listé dans votre configuration d'inspection.
Méthodes de contenu
Les méthodes de contenu sont des méthodes synchrones et sans état. Les données à inspecter ou à transformer sont envoyées directement dans la requête adressée à l'API DLP. Les résultats d'inspection ou les données transformées Sensitive Data Protection sont renvoyés dans la réponse de l'API. Les données de la requête sont chiffrées en transit et ne sont pas stockées.

Quand utiliser les méthodes de contenu
Voici quelques cas d'utilisation courants :
- Inspectez les saisies utilisateur en temps réel : analysez les champs de formulaire, les messages de chat ou les commentaires de manière synchrone dans les applications Web et mobiles avant de stocker les données dans les bases de données.
- Masquer le texte sensible avant le traitement externe : désidentifiez ou masquez les jetons sensibles des chaînes de texte de manière synchrone avant de transmettre le contenu à des API tierces ou à de grands modèles de langage (LLM).
- Masquer les données sensibles dans les images importées : obscurcissez le texte sensible dans les formats d'image (tels que JPEG, PNG ou TIFF) en superposant des rectangles opaques sur les informations permettant d'identifier personnellement l'utilisateur détectées avant d'afficher ou de stocker l'image.
- Désanonymiser les données tokenisées à la demande : détokenisez les jetons pseudonymisés précédemment dans les workflows côté serveur autorisés lorsqu'un utilisateur professionnel authentifié a besoin d'accéder au texte brut d'origine.
- Valider la confidentialité des données dans les applications côté client : exécutez des vérifications de confidentialité sans état sur les points de terminaison sans provisionner de dépôts de stockage cloud ni configurer d'infrastructure de job de backend.
Pour en savoir plus, consultez la documentation de référence de l'API REST concernant les méthodes de contenu :
Méthodes de stockage
Les méthodes de stockage sont conçues pour inspecter les données stockées sur Google Cloud dans des systèmes tels que Cloud Storage, BigQuery et Firestore en mode Datastore (Datastore). Pour activer l'inspection du stockage, vous devez créer un job Sensitive Data Protection à l'aide de la ressource dlpJobs. Chaque job s'exécute en tant que service géré pour inspecter les données, puis effectuer des actions Sensitive Data Protection telles que l'enregistrement ou la publication de résultats. En plus de ces actions facultatives, Sensitive Data Protection crée et stocke des détails sur le job (comme son état, le nombre d'octets analysés et les résultats détaillés par infoType). Vous pouvez gérer les jobs à l'aide de l'API DLP ou de Sensitive Data Protection dans la consoleGoogle Cloud .

Quand utiliser les méthodes de stockage
Voici quelques cas d'utilisation courants :
- Analyser des tables analytiques à grande échelle : inspectez des ensembles de données à l'échelle du pétaoctet dans BigQuery à l'aide de l'analyse par lot distribuée et sans serveur.
- Auditez les dépôts de fichiers non structurés : inspectez les documents, les archives et les fichiers multimédias stockés dans les buckets Cloud Storage pour localiser les données sensibles non chiffrées ou mal placées.
- Suivre l'historique des résultats et des tendances des analyses : conservez les résultats d'inspection détaillés directement dans les tables BigQuery pour suivre les résultats au fil du temps et générer des journaux d'audit de conformité.
- Déclenchez des workflows de correction basés sur des événements : diffusez les événements de fin d'analyse et les alertes de résultats à haut risque sur Pub/Sub pour démarrer des playbooks de réponse de sécurité automatisés.
- Échantillonnez de grands ensembles de données pour réduire les coûts : configurez des limites d'échantillonnage ou des limites de lignes pour estimer le niveau de risque lié aux données dans de grandes bases de données sans analyser l'intégralité des ensembles de données.
Pour en savoir plus, consultez la documentation de référence de l'API REST pour la ressource projects.dlpJobs. Vous spécifiez les détails du stockage dans l'objet StorageConfig.
Méthodes hybrides
Les méthodes hybrides sont un ensemble de méthodes d'API asynchrones qui permettent d'analyser les charges utiles de données envoyées par pratiquement n'importe quelle source à la recherche d'informations sensibles et de stocker les résultats dans Google Cloud. Les méthodes hybrides sont semblables aux méthodes de contenu, car les données que vous souhaitez inspecter sont incluses dans une ou plusieurs requêtes d'inspection. Toutefois, contrairement aux méthodes de contenu, les méthodes hybrides ne renvoient pas les résultats d'inspection dans la réponse de l'API. Au lieu de cela, les résultats d'inspection sont traités côté serveur de manière asynchrone, et les résultats sont formatés en tableau et stockés comme pour les méthodes de stockage.
Pour activer l'inspection hybride, vous devez créer un job Sensitive Data Protection à l'aide de la ressource dlpJobs. Chaque tâche hybride s'exécute en tant que service géré pour écouter les requêtes d'inspection, puis effectuer des actions Sensitive Data Protection, telles que l'enregistrement ou la publication de résultats. En plus de ces actions facultatives, Sensitive Data Protection crée et stocke des détails sur le job (comme son état, le nombre d'octets analysés et les résultats détaillés par infoType). Vous pouvez gérer les jobs à l'aide de l'API DLP ou de Sensitive Data Protection dans la consoleGoogle Cloud .

Quand utiliser les méthodes hybrides ?
Voici quelques cas d'utilisation courants :
- Inspecter les données dans des environnements hybrides et multicloud : diffusez des données provenant de bases de données sur site, de serveurs bare metal ou d'autres fournisseurs de services cloud dans la protection des données sensibles tout en conservant les rapports sur les résultats centralisés dansGoogle Cloud.
- Auditer les pipelines de données d'applications personnalisées : envoyez des données de flux depuis des robots d'exploration, des microservices ou des pipelines ETL personnalisés vers Sensitive Data Protection sans avoir à gérer des parcs de nœuds de calcul de scanner locaux.
- Assainir les charges de travail lors de la migration vers le cloud : inspectez et tokenisez en continu les composants sensibles lors de la réplication de bases de données en direct depuis les anciens systèmes vers Google Cloud.
- Centralisez les rapports de conformité multicloud : regroupez les résultats des inspections dans différents environnements d'exploitation dans un seul ensemble de données BigQuery pour une gouvernance unifiée.
- Traitez les types de fichiers personnalisés et les formats propriétaires : extrayez le texte côté client à partir de formats binaires propriétaires et diffusez les charges utiles extraites vers Sensitive Data Protection pour inspection.
Pour en savoir plus, consultez la documentation de référence de l'API REST pour la ressource projects.dlpJobs. Vous spécifiez la source de données dans le champ hybridOptions de l'objet StorageConfig.
Méthodes de découverte
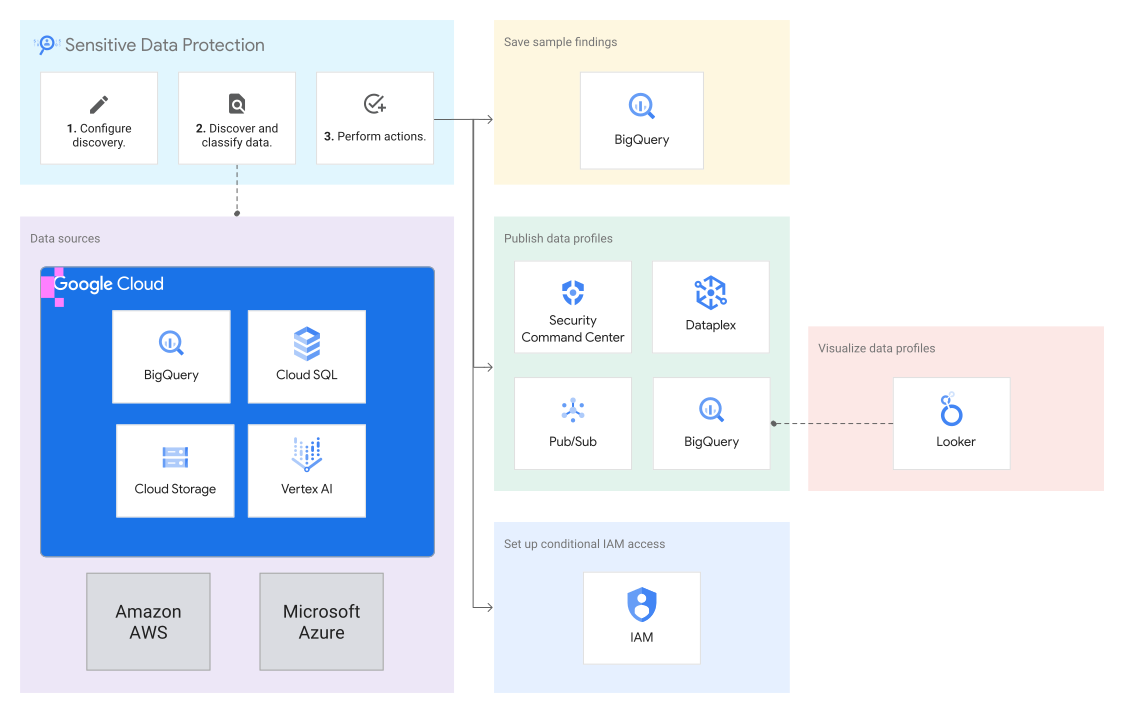
Les méthodes de découverte vous permettent de configurer la découverte des données sensibles pour générer des profils de données. Les profils de données fournissent des insights pour vous aider à déterminer où se trouvent les données sensibles dans votre organisation, le type de données sensibles que vous stockez et si des contrôles d'accès sont en place pour ces données.
Vous pouvez configurer la découverte pour qu'elle analyse les données stockées sur Google Cloud dans des systèmes tels que BigQuery, Cloud SQL, Cloud Storage et Vertex AI. Si vous avez activé Security Command Center Enterprise, vous pouvez également utiliser Sensitive Data Protection pour analyser les données d'autres fournisseurs de services cloud.
Vous pouvez spécifier les actions que vous souhaitez que Sensitive Data Protection effectue après chaque analyse de découverte. Par exemple, vous pouvez envoyer les résultats d'analyse à d'autres servicesGoogle Cloud , comme Security Command Center et Google Security Operations, pour améliorer la visibilité sur la sécurité des données de votre organisation. Vous pouvez configurer le service de découverte pour taguer vos ressources profilées afin d'accorder ou de refuser automatiquement l'accès IAM à ces ressources. Vous pouvez également exporter les profils de données vers BigQuery. Vous pouvez associer les profils exportés à Data Studio pour afficher le rapport prédéfini. Vous pouvez également créer vos propres requêtes et rapports personnalisés.
Pour activer la découverte, vous devez créer une ressource DiscoveryConfig. La découverte s'exécute en fonction du champ d'application et de la fréquence que vous définissez dans la configuration de la découverte. Pour savoir où Sensitive Data Protection stocke les profils générés, consultez Considérations relatives à la résidence des données.
Vous pouvez gérer les configurations de découverte, les profils de données et les connexions Cloud SQL à l'aide de l'API DLP ou de la consoleGoogle Cloud .
Quand utiliser les méthodes de découverte
Voici quelques cas d'utilisation courants :
- Automatisez la découverte des données à l'échelle de l'organisation : analysez et profilez en continu tous les assets de données dans BigQuery, Cloud SQL et Cloud Storage sans avoir à écrire de tâches ou de plannings d'analyse individuels.
- Identifier les dépôts de données à haut risque : générez des scores de risque et de sensibilité des données pour les tables et les buckets afin de prioriser les initiatives de protection et de gouvernance des données.
- Appliquer des contrôles d'accès dynamiques avec des tags de données : taguez automatiquement les ressources profilées en fonction des infoTypes découverts pour accorder ou restreindre l'accès à l'aide de stratégies Identity and Access Management.
- Transmettre les données de gestion de la posture de sécurité des données : envoyez les insights du profil de découverte à Security Command Center et Google Security Operations pour corréler les risques liés aux données avec les menaces d'infrastructure.
- Visualisez votre posture de conformité grâce à des tableaux de bord exécutifs : exportez les profils de données vers BigQuery et connectez des tableaux de bord Data Studio prédéfinis pour surveiller la distribution des données sensibles dans l'ensemble de l'organisation, des dossiers et des projets.
Pour en savoir plus, consultez la documentation de référence de l'API REST pour les éléments suivants :
Configurations de découverte
Connexions
Les connexions ne concernent que la découverte pour Cloud SQL.
Profils de données
organizations.locations.projectDataProfilesprojects.locations.projectDataProfilesorganizations.locations.fileStoreDataProfilesprojects.locations.fileStoreDataProfilesorganizations.locations.tableDataProfilesprojects.locations.tableDataProfilesorganizations.locations.columnDataProfilesprojects.locations.columnDataProfiles
Étapes suivantes
- Consultez les guides d'utilisation pour découvrir comment inspecter du texte et des images, ainsi que masquer les données sensibles détectées.
- Pour en savoir plus sur l'inspection du stockage et l'utilisation des actions, consultez la page Inspecter le stockage et les bases de données pour identifier les données sensibles.
- Pour en savoir plus sur la découverte de données sensibles, consultez Profils de données.
- Consultez les tarifs.